突发!DeepSeek新模型发布,超级性价比斩杀一切
DeepSeek 把 V4.1 Flash 升级到 V4.1-Flash-1017:11 项基准全部上涨,任务耗时与输出长度同时缩短,官方称达成性能—费用帕累托改进,并同步开放每千次 5 元的自研搜索 API、以 MIT 协议放出权重。

本文转载自微信公众号「量子位」2026 年 10 月 17 日推送,作者:一水、鹭羽(发自 凹非寺 量子位 | 公众号 QbitAI)。原文:《突发!DeepSeek 新模型发布,超级性价比斩杀一切》
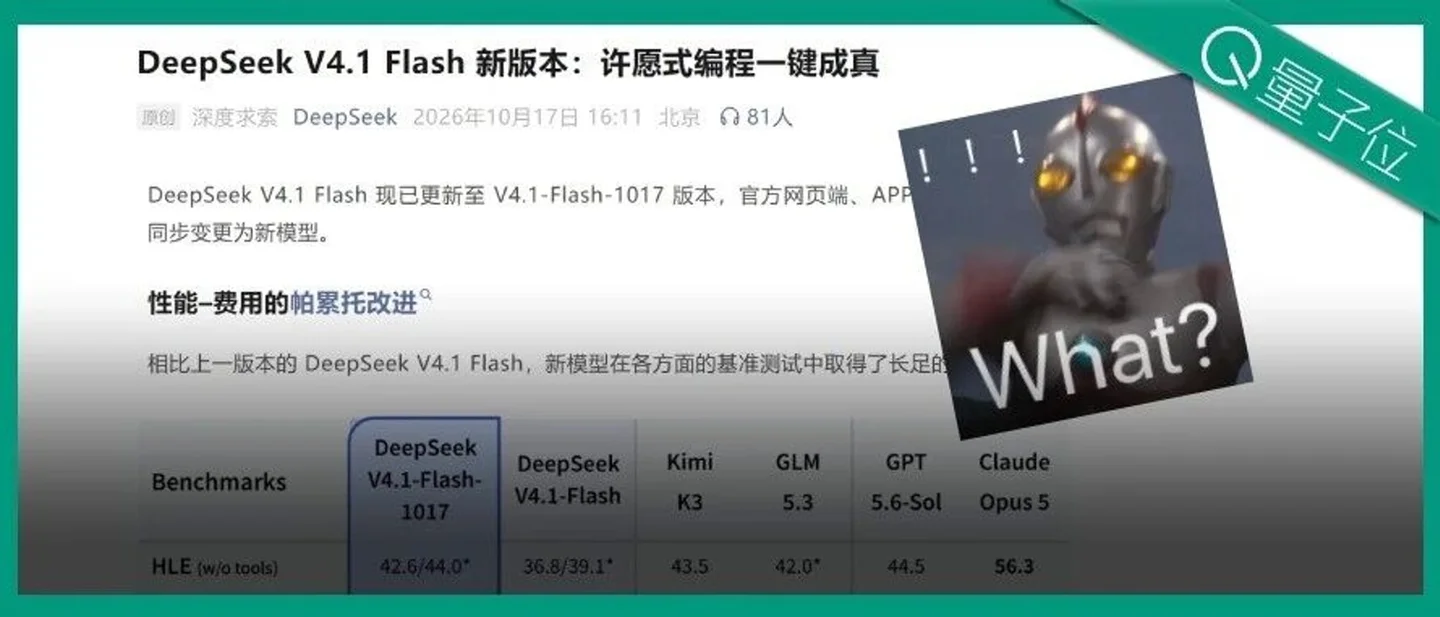
10 月 17 日下午,DeepSeek 把 V4.1 Flash 升级到 V4.1-Flash-1017,官方网页端、App 与 API 的模型同步换成新版1。
和上一版 V4.1 Flash 相比,新版本在各项基准测试上的分数都涨了,任务运行时间与输出长度反而缩短了1。
官方给这个组合起的名字是「性能—费用的帕累托改进」1。
这次更新还顺手放出了两样东西。自研搜索引擎的 Search 与 Fetch 两个接口对外开放,每千次成功请求 5 元;权重按 MIT 协议放出,Hugging Face 与 ModelScope 都能下载1。
跑分普涨,涨得最多的是 Agent 任务
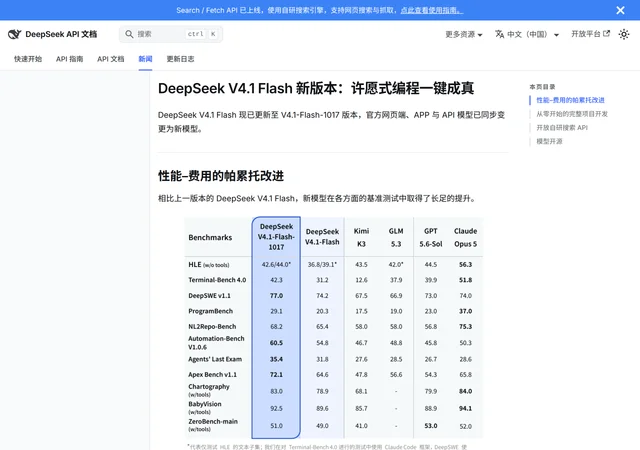
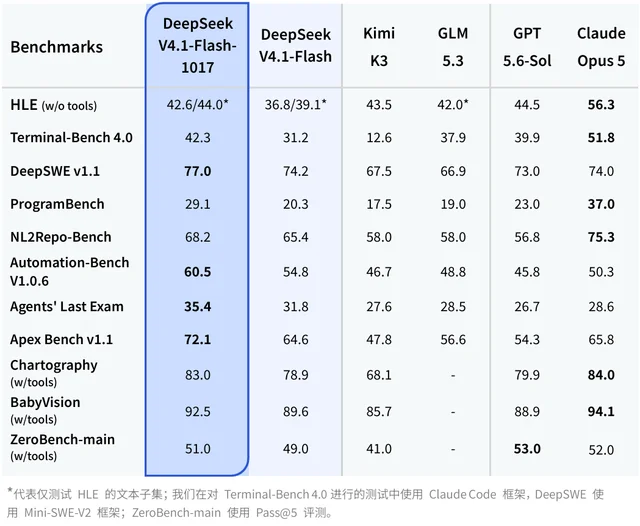
官方对比表横排六个模型,纵列 11 项测试。只跟上一代 V4.1 Flash 比,11 项全部上涨2。
- 编程与终端任务涨得最猛:ProgramBench 从 20.3 升到 29.1,Terminal-Bench 4.0 从 31.2 升到 42.32。
- Agent 类同步抬升:DeepSWE v1.1 从 74.2 到 77.0,Automation-Bench v1.0.6 从 54.8 到 60.5,Agents' Last Exam 从 31.8 到 35.4,Apex Bench v1.1 从 64.6 到 72.12。
- 知识与推理:HLE 从 36.8 到 42.6,NL2Repo-Bench 从 65.4 到 68.22。
- 多模态:Chartography 从 78.9 到 83.0,BabyVision 从 89.6 到 92.5,ZeroBench-main 从 49.0 到 51.02。
换成和外部模型横比,结果有输有赢。DeepSWE v1.1 上它拿 77.0,Claude Opus 5 是 74.0、GPT-5.6 Sol 是 73.02。
Automation-Bench 上是 60.5 对 50.3 和 45.8;Agents' Last Exam 是 35.4 对 28.6 和 26.7;Apex Bench 是 72.1 对 65.8 和 54.32。
换到知识、终端与多模态这几项,领先的是对面。HLE 上它 42.6,Opus 5 是 56.3、GPT-5.6 Sol 是 44.5;Terminal-Bench 4.0 上 42.3 对 51.8 和 39.92。
NL2Repo-Bench 上它 68.2,Opus 5 是 75.3;Chartography 上 83.0 对 84.0;BabyVision 上 92.5 对 94.1;ZeroBench-main 上 51.0,GPT-5.6 Sol 是 53.02。
这张表由 DeepSeek 自己发布。表注写明:HLE 带星号的数字只测了文本子集;Terminal-Bench 4.0 用 Claude Code 框架跑,DeepSWE 用 Mini-SWE-V22。
涨分的同时,时间和输出被压了下来
官方说,这次除了涨分,任务运行时间与输出长度也一起缩短了,在多个 harness 下达成了新的性能—费用最优点1。
被单独点名的框架是 DeepSeek Harness、腾讯 CodeBuddy 与 WorkBuddy。要用上新模型的完整能力,Harness 需升到 0.2.1-rc.1 及以上1。
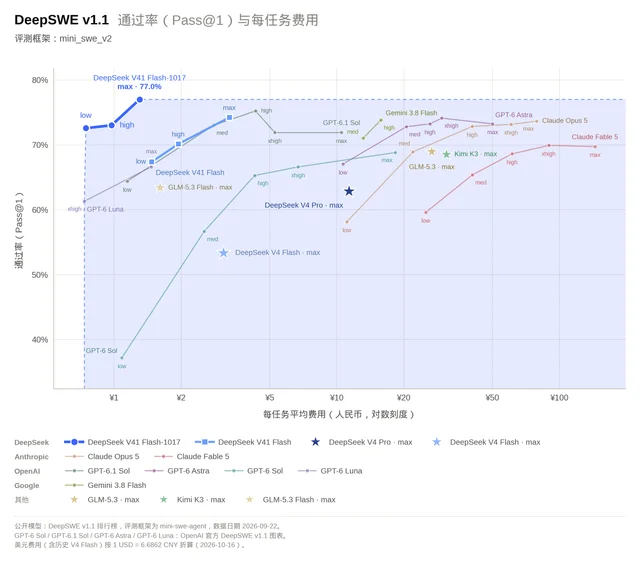
最能说明「省」的是官方那张散点图:横轴是每个任务的平均费用(人民币,对数刻度),纵轴是 DeepSWE v1.1 的通过率1。
图上,V4.1-Flash-1017 的最高点约 77%,对应单任务费用不到 2 元1。
Claude Opus 5 的曲线在 70% 上下,横轴已经走到 100 元附近;Kimi K3 与 GLM-5.3 的最高点都在 69% 左右,单任务费用约 20 元1。
图注交代了口径:DeepSWE v1.1 排行榜、评测框架 mini-swe-agent、数据日期 2026 年 9 月 22 日;美元费用按 1 美元兑 6.6862 元折算(2026 年 10 月 16 日),部分曲线取自各家官方图表1。
价格:缓存和时段决定账单
模型调用按 token 计费。价格页上,
deepseek-flash 对应的模型版本已经是 DeepSeek-V4.1-Flash-10173。高峰时段指北京时间周一至周五(不含法定节假日)的 9:00–12:00 与 14:00–18:00;其余时间,包括周末与节假日全天,都按空闲价,价格正好是一半3。
规格上,上下文 1M,单次输出最长 384K,并发上限 25003。
原文还记了一波福利:符合条件的用户首次登录 DeepSeek Harness 可领 6 元赠金,无需充值,到账后 7 天内有效,数量有限4。
「许愿式编程」:四个从零开始的演示
官方说,这次能力提升背后是一套基于自反馈的强化学习训练技术:模型写完第一版会自己检查,发现哪里不对再回头改1。
四个演示都在 DeepSeek Harness 里完成,提示词与素材参考很少,交互轮次也很短1。
- 故宫:用代码搭出可实时浏览、切换视角的 3D 场景1。
- 赛车游戏:网页版《NEON VELOCITY》,带车辆选择与参数面板1。
- 《传送门 2》:基于 Godot 引擎复刻,关卡可以交互1。
- Valley of Ages:用 3D 场景演示从史前到现代的发展过程1。
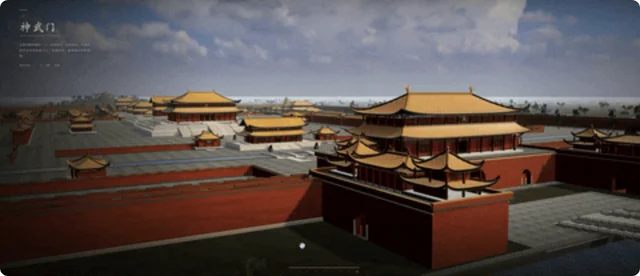
这些是官方挑选的展示案例,效果与提示词写法、Harness 版本都有关。原文当天也收集了网友的试玩,评价集中在更聪明、更快、输出更简洁4。
搜索 API:Search 与 Fetch
Search 按 query 搜网页,Fetch 把单个网页抓成 Markdown,两个接口用同一套 Bearer 鉴权,Base URL 是 api.deepseek.com5。
端点是
POST /v1/tools/search 与 POST /v1/tools/fetch。Search 的 count 可设 1–50,默认 10;need_content 为 true 时一并返回网页正文5。计费按成功请求次数:每 1000 次 5 元,折合单次半分钱;请求失败、搜索无结果或超时都不收费,
count 设多少也不影响单价5。限速按账号计算,Search 与 Fetch 各 5 QPS,互不占用;Fetch 还针对目标域名另有一层限制,超了同样返回 4295。
现在在 DeepSeek Harness、Claude Code 或 Codex 里用 DeepSeek API,已经会通过服务端工具调用碰到这两个接口,这部分暂不计费;北京时间 2026 年 11 月 1 日 00:00 起开始按次收费1。
权重以 MIT 协议开源
权重挂在 Hugging Face 与 ModelScope 的 deepseek-ai/DeepSeek-V4.1-Flash-1017 下,许可为 MIT2。
模型卡给出的规模是 763B 参数,推荐 temperature 与 top_p 都取 1.0,
max_tokens 不小于 256K2。这次没有提供 Jinja 格式的对话模板,改用
encoding 目录里的 Python 参考实现,覆盖多轮对话、工具调用、思考模式、数值化推理强度、会话中途的系统消息与交错图像2。生产环境另有 Rust 库 deepseek-recipe,把 Messages、Chat Completions 与 Responses API 的请求编码成 V4/V4.1 的 prompt 或 token id,再把输出解析回来2。
技术报告指向上一版 V4.1-Flash 的模型卡,标题是《DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression》2。
发布前已经漏了
原文记下了发布前几小时的两次「走漏」。DeepSeek 的模型列表里短暂出现过「DeepSeek V4.1 Flash-1017」一项;
deepseek-flash 接口返回的系统指纹,也从 aeb56401ca74e127821c4f9126dcb669 换成了 e72d3c7f663d3e1383b00b3884cb45014。「1017」对应 10 月 17 日,和 DeepSeek 用日期标记模型快照的做法一致4。
有网友把新旧版本的生成结果并排比较,认为新版画面细节更多、光影更真实,生成时还附带创作过程;也有人觉得它比 Gemini 4 Argon 用起来更顺,并猜这次加强了 3D 生成4。
原文里的话
对上了,都对上了。
好家伙,干活更快、更省,还更能打了!!
模型写完第一版不会立刻下班,它会继续检查自己搓出来的东西,发现哪里不对,再回头修。
References
- 1DeepSeek 官方发布说明:DeepSeek V4.1 Flash 新版本
api-docs.deepseek.com
- 2Hugging Face 模型卡:DeepSeek-V4.1-Flash-1017
huggingface.co
- 3DeepSeek API 文档:模型 & 价格
api-docs.deepseek.com
- 4量子位原文:突发!DeepSeek新模型发布,超级性价比斩杀一切
mp.weixin.qq.com
- 5DeepSeek API 文档:网页搜索与抓取
api-docs.deepseek.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.