OpenAI 公开 722 份数学手稿:写清单的那组数学家,当天回了话
OpenAI 一次公开 722 份数学手稿、372 个结果族,产出它们的是一个没有名字的内部模型;本篇顺着数学与 AI 顾问组七天前那份发布清单逐条核对,并交代到发稿时还没有第三方核过这批结果。

北京时间 10 月 7 日清晨,OpenAI 把一个 GitHub 仓库挂上了网:722 份数学手稿、372 个结果族,绝大部分出自一个没有名字的内部模型。七天前,由它牵线、最终独立成组的那群数学家刚写下一份「怎么发布」的清单,清单第三条的第一项,就是公布模型的名字。123
介绍帖的第一句是这样的:
We're releasing a broad range of new mathematical results produced by an internal frontier model.
(我们正在发布一批新的数学成果,它们由一个内部前沿模型产出。)5
「内部前沿模型」,是这次发布里能拿到的全部身份信息。
Loading content card…
01 仓库里有什么
先看规模。仓库的说明页写着:这批收藏共 722 份手稿,归入 372 个结果族;一个族把相关的论文归在一起,可能包含一个主结果,以及配套论证、推论和替代证明。7
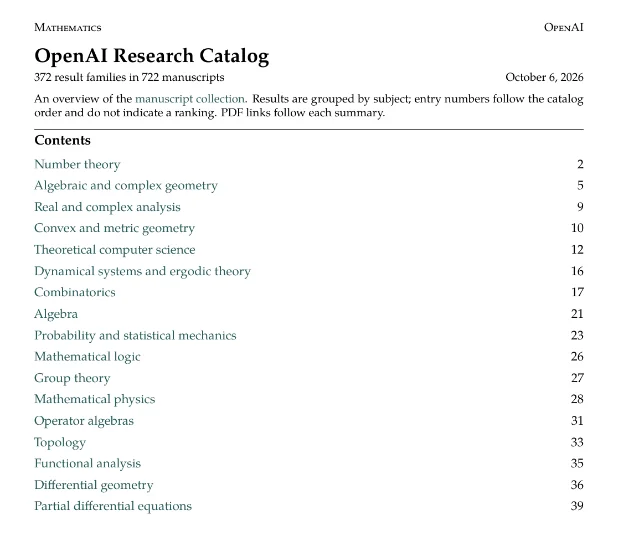
仓库里另有一份 41 页的目录,把 372 个结果按学科分组列出,从数论、代数与复几何、实分析与复分析,一直到偏微分方程,共 17 个学科。8
再看这些结果是怎么来的。README 写着:绝大部分结果由同一套流程产出,用的是 OpenAI 一个未发布的内部模型;平均每个结果消耗的算力,约等于三小时 ChatGPT Pro 的 thinking 用量;整个评估过程中,模型被喂了大约 4000 道题。7
4000 道题最后剩下 722 份手稿、372 个结果族。README 在讲流程的那一段里,把这个中间步骤写成「把输出归并成结果族与手稿,并要求达到恰当的重要性水平」。7
仓库分成三块。
preprints/ 放正文,每篇自带 PDF、源文件和引用说明;lean/ 放 Lean 形式化,配套目录里有给 comparator 用的挑战文件和一个 formalization.yaml 清单;reasoning_traces/ 放十份模型推理摘要。7README 逐条列出了这十份摘要对应哪个结果族,从「乘法函数的普通两点关联」到「自由群因子的同构」。9
有两处不走同一套流程。一处是关于 Riemann zeta 函数无零区的工作,其中实部大于 11/12 的那份写作文本经过人工编辑;另一处是 CM 阿贝尔簇上 Hodge 猜想的证明。7
这处人工编辑在仓库里留下了一个可查的痕迹。准黎曼猜想在 10 月 5 日另有一版论文,给出的正是实部大于 11/12 那个无零区;722 份手稿各自带一份 README,其中只有这一份写着「This paper was written with human assistance」(这篇论文是在人工协助下完成的)。10
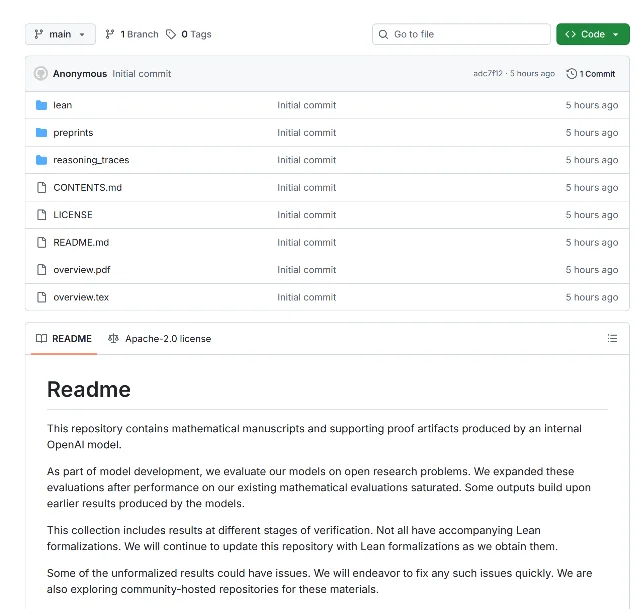
一个不具名的模型、大约 4000 道题、一份承认其中部分结果可能有问题的手稿集——这次发布交出的是一份产量清单。
02 那份清单是怎么写出来的
10 月 7 日清晨回话的那组数学家,叫数学与人工智能顾问组,挂在普林斯顿高等研究院名下。这个组是怎么来的,值得先说清楚:OpenAI 接触了其中几位成员,提出设立一个外部顾问委员会,他们商量之后决定自己成立一个独立小组,再邀请其他人加入。11
那份清单发布于北京时间 9 月 30 日 06:13,标题是《负责任地发布 AI 生成的数学》。3
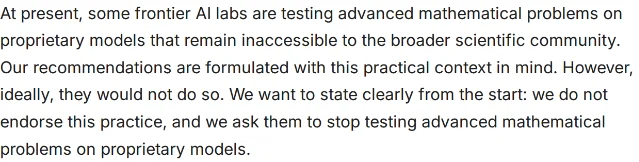
它开头第一段就把立场说完了:
At present, some frontier AI labs are testing advanced mathematical problems on proprietary models that remain inaccessible to the broader scientific community. … We want to state clearly from the start: we do not endorse this practice, and we ask them to stop testing advanced mathematical problems on proprietary models.
(目前,一些前沿 AI 实验室正在专有模型上测试高等数学问题,而那些模型对更广泛的科学界仍然不可访问。……我们要在一开头就说清楚:我们不认可这种做法,并且要求他们停止在专有模型上测试高等数学问题。)3
这份建议来自一次问卷,收到 600 多份回复。问卷问的是一个具体情形:一家实验室宣布存在很多结果,却不给细节。3
那个情形指的是 OpenAI 9 月 21 日那份公告。公告里交代产出量只有一句:从 8 月 28 日开始训练的这个内部模型,「如今已在数学的绝大部分领域解决了 100 多个长期未解问题」;题目清单、核查方式、时间表,一样都没有。12
建议把论文分成两类。有人真正读懂的,按数学界的老规矩走:挂预印本、投期刊、做报告。连把问题交给模型的人也读不懂结果的那一类,走下面这两步。3
第一步叫「初次发布」,一共五条要求。第三条是这次对照的核心:
For each result released, the AI lab should make public the name of the model, the prompts used, a (summarized) chain of thought, the time taken, and the estimated cost of computation.
(每发布一个结果,AI 实验室都应当公开:模型的名字、用到的 prompt、经摘要的思维链、花费的时间,以及算力成本的估算。)3
另外四条分别是:
- 第一条:把相关文献查一遍,凡是模型借鉴过的想法都按数学界的惯例引用;并让模型把证明改写成传统论文的体例,配得上友好的引言和精确的定理陈述与证明。3
- 第二条:结果要及时存入合适的学术仓储,而那个仓储不能由任何 AI 实验室控制。3
- 第四条:证明尽量形式化,形式化产物要符合社区规范,包括版权头、给 comparator 用的挑战文件,和一份
formalization.yaml。3 - 第五条:每个结果都要说明 AI 具体是怎么用上去的;一次放出很多个时,还要另写一份文件,解释模型在多少个难度相当的问题上试过并失败了,以及这些题是怎么挑的。3
同一节里还有一句加粗的话,专门针对发布方式:
We strongly recommend that AI labs refrain from treating the release of mathematical results as marketing vehicles to promote their models.
(我们强烈建议,AI 实验室不要把发布数学成果当作推销自家模型的市场手段。)3
第二步讲的是谁出钱、钱怎么花。顾问组的原则是:放出大批自己都读不懂的数学产出,实验室就有责任出钱帮人类把它读懂;至于支持哪些项目,决定权要交给有成熟资助流程的独立非营利机构。3
建议还单列一节讲访问权:实验室应当让全球数学界广泛、平等地用上它们公开的模型,否则会出现两级体系,把数学界从自己的学科里挤出去。3
03 一条一条对下来
顾问组写下那份清单,用的是北京时间 9 月 30 日;OpenAI 把仓库挂出来,用的是 10 月 7 日清晨。把清单上的要求逐条对到这次发布上,对上几条、差几条,分得很清楚。
文献引用与论文体例:列成了待办。 官方页写明这次发布配了一套论文修订与引用的规则,同时承诺今后会通过引用、数学表述和结果的呈现方式,继续改进这些论文的质量。1 清单第一条要的那两件事——查全相关文献、按论文体例重写——这次被写成了一件以后要做的工作。
完整的 prompt:没有给;片段给了十份。
reasoning_traces/ 里那十份摘要,八份带一个「Original prompt (excerpts)」小节,能看到提示词原文的一部分。14 其中一份抄出了任务是怎么下的:「请对下面这个问题给出一个完整、严格的解答。即使这个问题是『未解的』,也应当把它解出来,并给出完整解答。」15 剩下 362 个结果族,一个字都没有。7经摘要的思维链:给了十份。 对应 372 个结果族里的十个。9
结果存在哪:OpenAI 自己的 GitHub 仓库。 官方页承认这一点,并写明正在继续寻找符合顾问组准则的、由社区托管的替代方案。1
形式化:这一条落实得最实。
lean/ 目录里,挑战文件、formalization.yaml、Apache-2.0 授权都齐了,正是清单第四条点名要的形态。13 覆盖面是另一回事:372 个结果族里,235 个在 lean/docs/ 下有对应的形式化范围说明页。7这些说明页交代的是形式化覆盖到哪里、没覆盖到哪里。比如准黎曼猜想那一页写着,形式化给出了 θ=7/8 的界,而「论文后面的应用没有包含在内」。16
这份
formalization.yaml 自己也交代了状态。status 一栏的 scope 写的是 Partial progress.;review 一栏写的是 unchecked——按这套规范,这一栏的取值依次是未核查、由智能体核查、自评、同行评议、作者核实,OpenAI 填的是最前面那一档。1317试过多少题、怎么挑的:半条。 README 给出了分母——评估期约 4000 道题;多少题试过之后失败了,这 4000 道题是怎么选出来的,既有材料里都找不到。7
出钱支持人类理解:写了一句。 官方页说要资助一系列工作坊、会议和专题项目,围绕如何理解 AI 产出的重大结果,细节稍后公布。1 建议里那句「选择支持哪些项目不由实验室决定」,官方页没有回应。
模型访问:一句将来时。 官方页写的是正在努力「负责任地发布」产出这些结果的那个模型。1
04 它自己上一次是怎么发的
要判断这次的披露算多还是算少,最直接的尺子是同一家公司此前这几个月的几次数学发布。
2026 年 8 月 1 日,OpenAI 发过一份《数学与理论计算机科学的十项进展》。那一次它写明:产出结果的是「Astra 的一个内部版本,我们下一个主要模型」;这批解需要的 token 总量「按 Sol 的 API 价目折算大约是 2000 美元」;十份证明全部做了 Lean 证书并公开在单独的仓库里;每个解都配了一份「模型对自己思考过程的叙述」。18
9 月 8 日的纳维–斯托克斯那一次,口径同样具体:产出解的是一个「能力显著强于 GPT-6 Astra」的内部模型;为这个结果工作的并发智能体「规模在一万个量级」;从开始到拿到结果约 88 小时;光这一个问题,智能体就发出 270 万条消息、用掉约 1300 亿输出 token;形式化另外用掉 17 小时。19
9 月 21 日那次是转折:公告只说模型「解决了 100 多个长期未解问题」,其余一概没给。12
到 10 月 6 日这一次,规模从十项变成 722 份,算力口径从美元变成「ChatGPT Pro 用量」,模型名从「Astra 的内部版本」变成「一个内部前沿模型」。1
产量在往上走,披露的颗粒度在往下走。
还有一处落差值得单独看。8 月那份公告的末尾,OpenAI 主动提到了数学家们写的《莱顿宣言》,说「署名应当如实反映结果是怎么产生的」,并为那十份证明的正确性承担责任。18 那份宣言由国际数学联盟背书,里面写着数学论证应当透明、可被独立验证,并且专门点了一件事:形式化并不能自动消除这个困难,因为「难点在于计算机编码的表述和人类表述之间的转换」。20
而 10 月 6 日这批产出,来自一个未发布、外部无法访问的模型——宣言里那条「透明、可被独立验证」的底线,这次能拿出来的只有 OpenAI 自己给的材料。1
05 有没有人核过
这次发布最缺的一样东西,是外部复核。到本篇发稿时,没有。
仓库自己的纠错入口是空的:issues 页面显示「0 results」,一条纠错记录都没有。21
几位常就这类事发言的数学家都还没接话。陶哲轩的最新一条 Mastodon 帖发在北京时间 10 月 7 日凌晨 2 点,比仓库上线早四个小时,此后到本篇发稿没有新帖。22 Timothy Gowers 的博客最新一篇停在 9 月 17 日。23
发布之后,媒体拿到的说法已经不少。《科学美国人》引一位 OpenAI 发言人称,新模型「几乎每一个结果都是对交给单个 AI 智能体的单条提示词的回应」,按同一篇报道的说法,这与 9 月 8 日那次动用一万个并发智能体、花掉数百万美元算力的做法形成反差;同一位发言人补充说,有些结果可能试了多次。24
这条说法目前没有任何外部验证。麻省理工学院的数学家 Andrew Sutherland 对同一篇报道说:
Until and unless they release the model and people can replicate their results, I think you should treat any claims about one-shotting problems with a single agent as unverified. … We should ask for receipts.
(在他们发布那个模型、别人能复现结果之前,任何「单个智能体一次解决」的说法,你都应当当作未经验证。……我们应该要票据。)24
同一位发言人对该刊说,团队在认真对待顾问组的准则,只是「不受这些建议的约束」。24
同一篇报道里,多伦多大学的 Daniel Litt 给出的是相反的判断:把这些答案公开是好事,「如果我们想知道这些数学问题的答案,我看不出为什么要请公司替我们保密」。24
《纽约时报》同日的稿子(它把批次数成了 377 个)里,纽约大学教授 Tristan Buckmaster 的措辞更重:一次放出这么多结果,「I don't think they've done their sort of due diligence at all」(我不认为他们做过任何尽职调查)。25
顾问组里的哈佛数学家 Melanie Wood 对同一篇说了这个组自己要做的事:「我们要建立标准和惯例,让 AI 实验室发布的结果能被数学家读懂,并且能推动这个领域。」25
这场争论有一半发生在发布之前。《连线》的稿子在仓库上线前四个半小时就发了,里面记着 8 月那场闭门会:OpenAI 约了约 40 位数学家,会上暗示模型已解出数百道长期问题;与会者要求把结果写成论文,而不是像当月早些时候那十道题一样只发博客和推文。西北大学的 Bryna Kra 对《连线》说:「Apparently, that input was ignored.」(显然,那些意见被忽略了。)26
德克萨斯大学奥斯汀分校数学系主任 Francesco Maggi 在发布前一天就把问题提了出来。他当时听到的数字是 400 篇,于是发帖问:「那我真心想问的是:一次发布几百份证明,预期的数学价值是什么?如果愿意读、或者读得过来的人根本不够,会发生什么?」27
他给的理由是数学增长的方式:结果必须先被理解、被连接、被解释、被质疑、被复用,否则就只是一堆没人读的符号。27
讨论热度最高的地方是 Hacker News,主帖有 434 条评论;讨论里最接近「核对」的一条,是有人指出自己 2022 年给 mathlib 加的两条引理被用在了这批代码里。28 Reddit 的 r/math 版面上,到本篇发稿还没有出现相关帖子。29
中文科技媒体当天上午也已经发稿。量子位在北京时间 08:59 的稿子里记下了顾问组声明的时点,也点出组里三位菲尔兹奖得主(Gowers、Hairer、Witten);30 机器之心在北京时间 10:16 的稿子里自己数了一遍仓库目录,结论是 372 个结果族中有 235 族附带了形式化说明页,约占六成三。31
06 那份回话
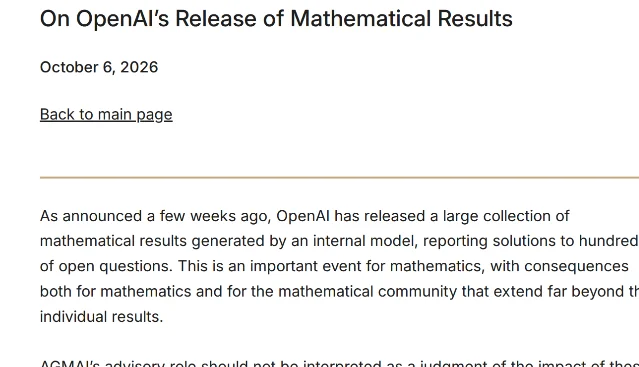
06:25,顾问组的回应上线,标题就叫《关于 OpenAI 发布数学结果》。6
它先把自己摘出来:
AGMAI's advisory role should not be interpreted as a judgment of the impact of these results or an endorsement of the process by which OpenAI obtained them.
(顾问组的建议角色不应被理解为对这些结果影响的判断,也不构成对 OpenAI 获取这些结果的过程的背书。)6
接着它把这次发布定性成开头:
Making this work public is a first step. This release is the beginning, not the completion, of the process of human understanding and the incorporation of the work into mathematical knowledge.
(把这项工作公开只是第一步。这次发布是理解这批结果、把它们纳入数学知识这一过程的开端;这个过程还远没有走完。)
建议有没有被遵守、还需要补哪些建议,最终要由数学界来评估。6
这份回应没有重复 9 月 30 日那条最尖锐的要求。它只说「我们重申已发布的建议」,然后写了两句信息量不小的话:已经和 OpenAI 讨论过这些建议,「并感谢这家公司愿意沟通」;也已经「与多家前沿 AI 实验室有过接触」。6
08:06,Sam Altman 发了帖,一句话加一个链接:
We are entering a new era of discovery now:
(我们现在正进入一个发现的新时代:)32
关于这 722 份手稿意味着什么,对外只有这一句话。
清单上还欠着的那几件事,有一个共同点:它们都是能让别人自己动手核一遍的东西。
References
- 1
- 2openai/math · GitHub
github.com
- 3
- 4
- 5
- 6
- 7openai/math 的 README
github.com
- 8
- 9reasoning_traces/ 目录(共 10 份 PDF)
github.com
- 10
- 11
- 12
- 13formalization.yaml
github.com
- 14
- 15
- 16lean/docs/003.md
github.com
- 17
- 18
- 19
- 20Leiden Declaration on Artificial Intelligence and Mathematics
leidendeclaration.ai
- 21openai/math 的 issues 页面
github.com
- 22陶哲轩的 Mastodon 时间线
mathstodon.xyz
- 23Gowers's Weblog
gowers.wordpress.com
- 24
- 25
- 26
- 27
- 28Hacker News 主帖(434 条评论)
news.ycombinator.com
- 29r/math 版面
reddit.com
- 30
- 31
- 32

This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.