四个决策模型在同一张 4090 上差 13 倍、同一匹马换四副马具账单差 3.6 倍、八张旧卡拼出 256GB 显存
八组实测里,决定读数的往往是模型旁边多出来的那一样东西——一个只给选项打分的小模型、一个先回答「做了会发生什么」的检查器、一副 agent 外壳、一层引擎缓存、几张旧卡;本期把每一组「有它」和「没它」两边的数一起摆出来。

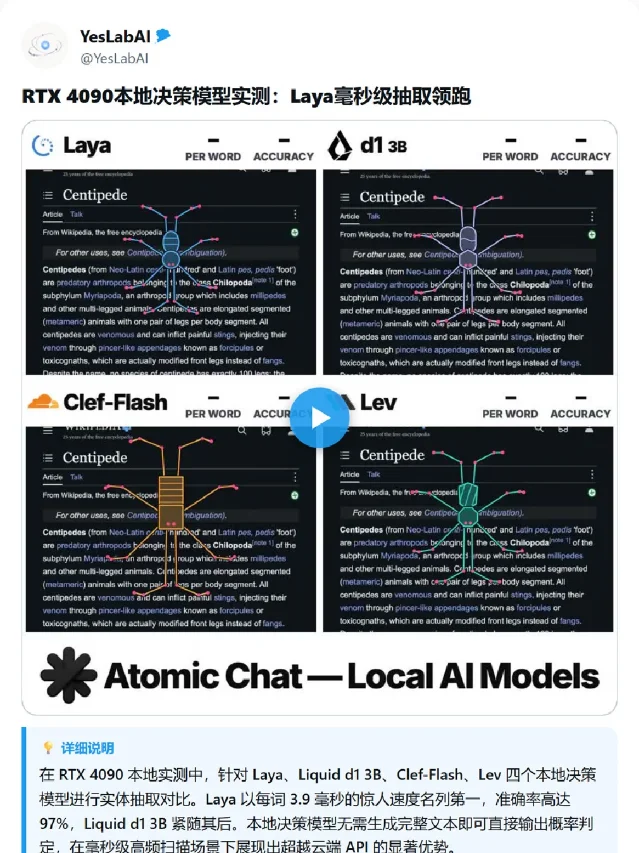
同一张租来的 RTX 4090 上,四个本地决策模型做同一件事:把九篇讲蜈蚣的维基百科文章逐词读一遍,每读到一个词就回答一次「这个词是不是蜈蚣的名字」。最快的是 Laya,每词 3.9 毫秒;最慢的是 Lev,51.0 毫秒,差 13 倍 12。
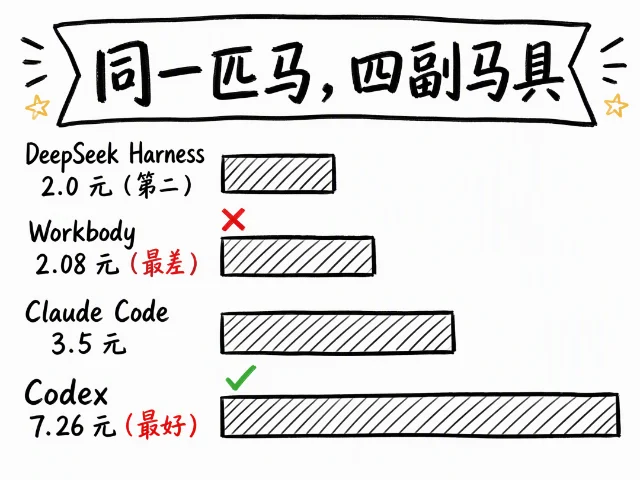
同一个 DeepSeek V4 Pro 接进四副不同的 agent 外壳,做同一道 3D 看房网页。花 2.00 元的那副排第二,房间处理得好,连地板都做了纹理;花 2.08 元的那副把客厅里的电视当成门用,前后移动键还是反的;花 7.26 元的那副完成度最高,也最贵 3。
八张 2020 年出厂的数据中心显卡拼出一台 256GB 显存的机器,买卡加配件约 2,800 美元。同一台机器换掉推理引擎之后,预填充从 llama.cpp 的 350–450 tok/s 变成 3,000 t/s 以上 4。
本期八组材料的每一组都摆着两个数,中间隔的是同一类东西:一个只给选项打分的小模型、一个先回答「做了会发生什么」的检查器、一副 agent 外壳、一层引擎缓存、几张旧卡。本期覆盖 2026 年 10 月 8 日至 10 月 9 日,来源为 Reddit、小红书与公众号,另含一份 Hugging Face 模型卡。
八组材料总览
| 任务 | 测试对象与运行条件 | 关键数字 | 主要限制 |
|---|---|---|---|
| 逐词判断哪个词是蜈蚣名 | 一张租来的 RTX 4090、32 vCPU、驱动 580.119.02,llama.cpp b11495(CUDA 12.8),四个决策模型各读 9 篇维基文章共 9,534 个词,每个词一次 /v1/systemone 调用 1 | 每词中位延迟 3.9 / 6.0 / 24.4 / 51.0 毫秒(Laya、d1 3B、Clef-Flash 9B、Lev 4B);准确率 97.4% / 96.5% / 97.2% / 98.9%;抓到蜈蚣名的比例 70% / 51% / 36% / 83% 1 | 准确率被「答不是也算对」抬高;Lev 跑在自己的 PyTorch 服务里,慢 13 倍有一部分来自这层;一台机器、一道题 1 |
| 训练一个自己的决策模型 | Unsloth 10 月 7 日开源的训练方法,官方口径 4GB 显存、42 分钟、准确率 78%;底座与训练配方的三处口径由作者逐条核对 5 | 起点有三个版本:20.7%、36%、40.37%;训练配方一处写 r=16 加 2 轮、一处写 r=64 加 1 轮;没训过的 0.8B 在四个跨域分类集上 0.411(换一次选项顺序 0.443),2B 是 0.602、4B 是 0.808 5 | 作者本机是 M1 Pro,这篇没有本机实测,全部为官方口径加自己的核对;4GB 是没写明卡型、量化与 batch 的口径 5 |
| 让 agent 动手前先问一句 | Ekbasis-27B:给定当前状态与一个动作,判断会发生什么,一次前向约 0.1 秒、不生成文本;1,273 次 agent 运行 6 | 单独一个 agent 在 20–57% 的伤害路径上造成损失(含 Sonnet 5.5 的 40%);加上后果模型后降到 0–3%,384 次里 3 次(0.8%);Qwen3.5-4B 从 50% 降到 32%、9B 从 45% 降到 12% 6 | 覆盖面只到应用域(余额、队列、待处理授权这类隐藏状态),作者自己写明不是通用推理;一次有害运行来自模型以 0.53 的置信度回答了边界问题 6 |
| 同一匹马换四副马具 | 同一个 DeepSeek V4 Pro 接进四个 agent 做同一道 3D 看房网页,各家自家最强模型加最高智能档,自费、无广 3 | 账单 2.00 / 2.08 / 3.50 / 7.26 元;完成度从高到低是 7.26 元、2.00 元、3.50 元、2.08 元 3 | 自费横评、个人手感、不是盲评;价格与完成度都来自同一套题的一次运行 3 |
| 同一张 5090 换一层引擎 | Infernix 对 Strata,都跑 Qwen3.8-Flash-Next;Infernix 用 NVIDIA NVFP4 版本,Strata 跑 Unsloth 的 UD-Q4_K_XL,显卡走 PCIe Gen5 x8 7 | 首字中位 32.9 秒降到 5.9 秒,P90 67.8 秒降到 13.3 秒;缓存命中 53.8% 到 84.6%;无缓存预填充 1,423 到 5,879 tok/s;单请求解码 86 到 125 tok/s;整轮 22.3 分钟到 7.8 分钟 7 | 作者就是 Infernix 的作者;两边量化档不同;PCIe 只跑到 x8,作者说 x16 可能更快 7 |
| 连着跑满八小时 | Qwen3.8-Flash-Next MoE 的 NVFP4 版本,Strata 的 NVFP4 分支 v0.1.40.3,RTX 5090 32GB 加 136GB DDR5,Windows 11,KV 缓存 INT8 分页、上限 262k 8 | 八小时 2,411 次请求;输入 3.078 亿 token 里 99.31% 命中缓存,真正新预填只占 0.69%;解码 135–153 tok/s,与上下文长度的相关系数 +0.005;MTP 接受率 79.6%;MoE 显存缓存命中 89.9%;0 崩溃 8 | 单机单人一天的记录,Windows 加一个第三方 NVFP4 分支,不是标准件;标题写 128GB 内存、正文写 136GB DDR5 8 |
| 用旧专业卡拼一台大显存机 | 八张 Radeon Pro V620(2020 年的 RDNA2 云游戏卡、每张 32GB),配自制的 vLLM 分支、PP=4,专家层 W4A16、其余 BF16 4 | 整套约 2,800 美元;llama.cpp 预填充只有 350–450 t/s,换自制 vLLM 后 3,000 t/s 以上;开启三 token 草稿后解码 60–100 t/s,关掉是 40–50 t/s 4 | 作者自己说标题有点误导,这类卡已经不是每张 350 美元;改动是他让 Claude 写的;只跑了并发为 1 的 llama-benchy 4 |
| 把 128K 对话压进 800MB | Atomic Agent:本地模型优先的 agent,自带一个 llama.cpp 分支并默认开 TurboQuant 的 turbo3 档 9 | M5 MacBook Pro 上 Qwen 3.5 4B 的 128K 会话从 4GB 降到 800MB;同一台机器上 27B 的首答从 4 分 20 秒降到约 1 秒;每步思考上限约 1,500 token 9 | 压缩是有损的;首答变快来自缓存复用;作者本人就是 Atomic Agent 的作者,数字来自自家集成 9 |
决策模型:同一张卡上,每词 3.9 毫秒到 51.0 毫秒
这位作者注意到最近两周冒出一批开源决策模型——laya、Liquid 的 d1、Cloudflare 的 clef-flash、interfaze 的 lev——于是把它们放在同一张租来的 RTX 4090 上跑同一道题。任务是把九篇讲蜈蚣的维基百科文章逐词读一遍,读到每个词都问一次「这个词是不是一种蜈蚣的名字」,每个词发一次
/v1/systemone 请求,下一个词等上一个词的回答回来才发 1。每词中位延迟是 Laya 3.9 毫秒、d1 3B 6.0 毫秒、Clef-Flash 9B 24.4 毫秒、Lev 4B 51.0 毫秒;32 秒里各自过了 7,980、5,306、1,292、626 个词。准确率排得几乎一样密:97.4%、96.5%、97.2%、98.9% 1。
作者自己把准确率那一栏拆了:这道题里回答「不是」也算对,而绝大多数词都不是蜈蚣名,所以四个模型的准确率都停在 97% 上下。真正分得开的是抓到了多少蜈蚣名——Laya 70%、d1 3B 51%、Clef-Flash 9B 36%、Lev 4B 83% 1。
运行条件写在帖子里:租来的 4090、驱动 580.119.02、32 vCPU;引擎是 llama.cpp b11495(提交 37ac63456,CUDA 12.8 发行版),参数
-ngl 99,其余默认。Laya 与 Clef-Flash 用 ggml-org 的 GGUF,d1 用作者自己做的 AD-Q4_K_M 量化,Lev 是 interfaze 在 Qwen3.5-4B 上的 LoRA、跑在它自己的 lev serve 里,--compile 一直没热起来 1。Lev 排在最后有一半要记在引擎上。它逐词比 Laya 慢 13 倍,因为它跑在自己的 PyTorch 服务里而不是 llama.cpp;作者在另一张 4090 上量到 68 毫秒,说明这个数还对 CPU 敏感。他自己的结论是选 Laya,理由是快,而且好微调 1。
Loading content card…
决策模型的底座,和三个不一样的起点
一篇盘点把公开的决策模型一个个翻过来看底座,结果是 Qwen 包场:Cloudflare 的 Clef 是 Qwen3.8-27B,Clef-flash 是 Qwen3.5-9B,TypeSafe 作者自己复刻的 Kev-0.8B 是 Qwen3.5-0.8B-Base,上海 AI 实验室的 Intern-Decision 三档全是 Qwen3.5,中文作者做的 Jev-Style 2B 也是 Qwen3.5-2B-Base;唯一的例外是 Laya,走的是独立的编码器路线 5。
决策模型和聊天模型不是一回事。它把输入、问题和所有选项读一遍,然后对每个选项给出概率,中间不吐任何字,所以又快又小。Cloudflare 给的中位延迟是 Clef 209.3 毫秒、Clef-flash 38.8 毫秒,Jev 是 524.1 毫秒;上海 AI 实验室的 Intern-Decision-0.8B 在单张 4090 上端到端 33.98 毫秒(P95 为 37.50 毫秒),服务时占 3.8GB 显存 5。
真正值得看的是这篇给出的三处对不上。Unsloth 在 10 月 7 日开源了训练方法,官方门槛是 4GB 显存、42 分钟、准确率 78%;它的推文说把 0.8B 在三个决策基准上的合计准确率从 20.7% 提到 74.3%,同一家的教程表格写起点是 36%,而上海 AI 实验室那份 0.8B 的评测表里 Qwen3.5-0.8B 底座是 40.37 5。
训练配方也有两套。教程界面写「想复现我们的结果,把 epochs 设成 2、LoRA rank 设成 16、学习率 2e-4」,官方推文写的是 r=64 跑一个 epoch,仓库训练脚本里的默认值是
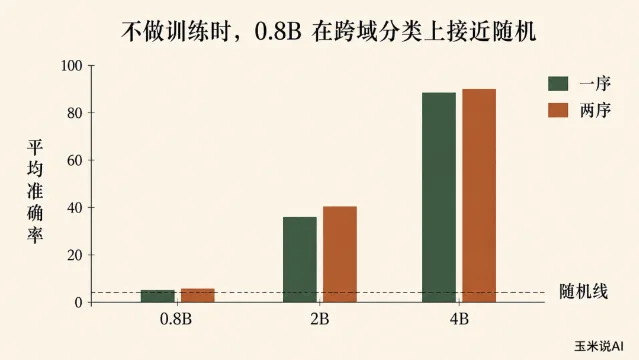
--lora-r 64 与 --epochs 1.0 5。最要紧的一处在不训练的时候。一个叫 reflex 的开源复现项目在四个没训练过的跨域分类集上逐档跑冻结模型,每集 300 题:Qwen3.5-0.8B 平均 0.411,把选项顺序换一遍再问一次是 0.443;2B 是 0.602 与 0.628,4B 是 0.808 与 0.810 5。
这个项目自己写在 README 第一屏的结论是「微调,我们试过的每一种形式,都证明没有帮助」。这是那一个项目的自述,不是定论,但它和另一份材料对得上:Kev 那份 0.8B 决策模型的模型卡直接列了自己的失败项——跨域迁移落后 Jev 21 分,广度指数落后 31 分,MMLU-Pro 只有 0.230,工具调用路由从 0.260 掉到 0.167,而四选一瞎猜是 25% 5。
后果模型:1,273 次运行,破坏率从 20–57% 降到 0–3%
另一位作者跑了 1,273 次 agent 任务,帖子开头写的是七类应用,括号里却列了十二个:银行、旅行、密码管理器、数据库、智能家居、日历、聊天、云服务、云盘、文件、邮件与购物。单独一个 agent 会在 20% 到 57% 的伤害路径上造成损失,性能最好的 Claude Sonnet 5.5 也占到 40% 6。
加上一个后果模型之后,同样的 agent 掉到 0% 到 3%:Sonnet 5.5 从 40% 到 0%,Haiku 从 40% 到 3%,GLM-5.3-flash 从 20% 到 0%;便宜的小模型受益最明显也最不够——Qwen3.5-4B 从 50% 到 32%,9B 从 45% 到 12%。整体是 384 次里 3 次有害运行,占 0.8% 6。
Ekbasis 是一个 27B 的模型,输出的是一个前向里读出来的选项概率,不生成文本。它看得到 agent 看不到的隐藏状态——真实余额、队列、待处理授权、归属关系——对「如果我做这个会发生什么」给出带校准置信度的答案,置信度低于 0.5 就把问题交回用户 6。
它自己承认的限制有两层。作者写明这是应用域的后果预测,不是通用推理;当天唯一一次有害运行,是模型以 0.53 的置信度回答了一个边界问题,而且它把这个置信度如实报了出来 6。
模型卡把这件事量得更细:同样 240 道 git 问题、答案由真实执行给出,Ekbasis 一次前向约 0.09 秒,在见过的命令类型上 95.8%、没见过(rebase、restore)85.8%;Claude Sonnet 5.5 是 95.8% 与 94.2%,Opus 5.5 是 97.5% 与 89.2%,而没做过后果训练的 Eikos-27B 是 80.0% 与 73.3% 10。它追平了 Sonnet 在熟悉的命令上,在没见过的命令上还差 8 个点。
模型卡同时给出四个可下载的档位:bf16 55GB、FP8 30.4GB(吞吐是 bf16 的 1.6 倍)、INT4 18.6GB、MLX 4bit 15GB。作者另外提了一句,它的默认上下文在服务脚本里设成 16,384,而长上下文的评估没有做 10。
Loading content card…
同一匹马,四副马具,账单差 3.6 倍
一篇国内横评把这件事讲得最直接:agent 等于模型加 harness,harness 是界面、工具、权限、记忆、插件那一整套外壳。同一个 DeepSeek V4 Pro 接进四个 agent,做同一道 3D 看房网页,结果与价格正好错开 3。
账单是 DeepSeek Harness 2.00 元、Workbody 2.08 元、Claude Code 3.50 元、Codex 7.26 元。效果是 2.00 元排第二(房间处理得好,连地板纹理都做了),3.50 元整体还行但天花板没做出来,2.08 元最差(把电视当门用,前后移动键还是反的),7.26 元完成度最高也最贵 3。
差距不是每道题都看得出来。第一轮是一组 AI 录音笔的产品资料,分别做 PPT、Excel 报价表和 HTML 官网首页,几家结果都差不多,唯一的小差别是 Codex 用 GPT-6 生成 HTML 时主动做了手机端适配;换成「用 HTML 和 SVG 做一支鹈鹕骑自行车的 2D 动画」,分层才出来,Codex 画面最统一,千问做出动画还加了切换黄昏和傍晚场景的按钮,MiniMax 相对最弱 3。
另有一组同题对照说明模型和外壳的搭配是可以拆开的:同一段提示词发给 Kimi 的 agent 与 Workbody,做一个语音记账 iOS app 的前端 demo,要求四个页面能点能交互。Workbody 做出来按钮点不了,Kimi 的 agent 做出来能点、能交互 3。
这篇的限制写在字里行间:这是博主自费充会员做的横评,花的都是自己的钱,全程无广;效果排序来自作者的个人手感,不是盲评;每一档只跑了一次。作者给的建议也不是排行榜,是按用法选——常用 DeepSeek 模型写代码就接它自家的 harness,什么都要一点选 Codex,办公文档为主选 Workbody 3。
同一个 5090,换一层引擎:首字 32.9 秒到 5.9 秒
一位作者花一周写了自己的推理引擎 Infernix,把 Qwen3.8-Flash-Next 的 NVIDIA NVFP4 版本跑起来,和 Strata 跑 Unsloth UD-Q4_K_XL 的同一份模型对比。这是一组引擎对引擎的读数,两次都跑在同一张 5090 上 7。
平均首字等待从 32.9 秒降到 5.9 秒,P90 从 67.8 秒降到 13.3 秒。缓存命中从 53.8% 升到 84.6%,那些一个缓存也没命中的请求,预填充从 1,423 tok/s 升到 5,879 tok/s。单请求解码从 86 tok/s 升到 125 tok/s,整轮工作从 22.3 分钟压到 7.8 分钟 7。
唯一的负向栏是每轮草案接受量:2.08 个降到 1.97 个,少了 6%。作者的做法是热专家留在显存、其余放在系统内存、内存不够就溢到 SSD,同时把部分专家交给 CPU 处理,并把上一次的专家摆放位置记下来供下次启动使用;他还把 KV 缓存状态存成文件,下次启动直接读回来。作者自己说,带 KV 缓存和系统开销算下来,想要最快速度大概需要 96GiB 内存,64GiB 也能用 7。
这一栏的限制得写清楚:作者就是 Infernix 的作者;两边用的量化档不同,一边是 NVIDIA 的 NVFP4,一边是 Unsloth 的 UD-Q4_K_XL;测试时机器的显卡只跑到 PCIe Gen5 x8,作者说带宽有时就是瓶颈,x16 的机器可能更快 7。
Loading content card…
国内这一侧同一时间有同向的读数。一位小红书作者说自己在 4090 上折腾了一晚上,用 ninfer 稳定跑出 100+ tokens/s,并贴出一块运行面板:解码 154.5 tok/s(本次会话平均 127.8),MTP 接受率 53.4%,提示词命中缓存 95.1%,KV 池用了 120,384 / 262,144 个 token 11。
连着跑满八小时:2,411 次请求、99.31% 命中
同一族模型的另一份记录不是基准,是一整天的电报。一位作者装到 136GB DDR5 内存之后,在 RTX 5090 上用 Strata 的 NVFP4 分支跑了一整天 Qwen3.8-Flash-Next,八小时里完成 2,411 次请求 8。
输入加起来 3.078 亿 token,其中 3.057 亿来自缓存,命中率 99.31%;真正新做的预填充只有 213.7 万 token,占 0.69%。输出 86.5 万 token。解码速度 135 到 153 tok/s,而且和上下文长度几乎没关系——从 5 万到 21.2 万 token,相关系数是 +0.005 8。
首字那一栏区分冷热缓存:5.2 万上下文的冷缓存预填充 4.7 秒,20.5 万上下文热缓存 483 毫秒,21.2 万上下文热缓存 617 毫秒。MTP 投机解码的草案接受率 79.60%,约合每次前向出 4 个 token;MoE 的显存缓存命中平均 89.9%,峰值 93.6%;整段过程 PCIe 平均占用 6.8% 的总线,突发接收到 23 GB/s;核心温度 52 到 53 摄氏度,功耗 230 到 335 瓦,0 崩溃 8。
这是一台机器的记录,配置里几样东西都不是标准件:一个第三方 NVFP4 分支、一个 INT8 动态分页 KV 缓存、8,458 个专家槽位里 22.3GB 常驻显存、其余从 64GB 主机内存里动态换入。帖子里还留着一处对不上的地方——标题写 128GB 内存,正文写的是 136GB DDR5 8。
八张旧卡拼出来的 256GB
一位作者两个月前赌了一把,买下八张 Radeon Pro V620——2020 年出的 RDNA2 企业级云游戏卡,每张 32GB 显存——想把一块大显存拼出来。整套卡加配件大约 2,800 美元;旁边那张 4090 只做图像和视频,不跑语言模型 4。
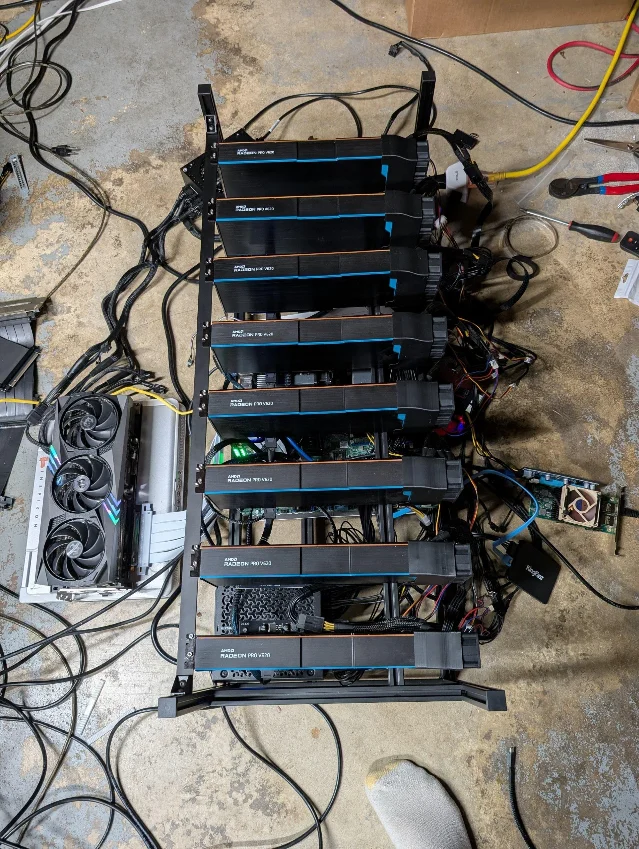
起初这条路走不通。llama.cpp 在这批卡上预填充平均只有 350–450 t/s,vLLM 干脆跑不起来,作者一度准备把卡卖掉。后来他让 Claude 写了一个既认这些卡、又能跑出速度的 vLLM 分支,并针对 RDNA2 反复改自定义内核,预填充到了 3,000 t/s 以上,他自己写的是「比 llama.cpp 那时快约 800%」 4。
配置写在帖子里:vLLM 用 PP=4(没有张量并行),模型是 orcarouter 的无审查版 Qwen3.8-Flash-Next、由作者自己量化,路由专家 W4A16、其余保持 BF16;开三 token 草稿时解码 60 到 100 t/s,关掉 MTP 是 40 到 50 t/s 4。
三处限制是作者自己写的:标题有点误导,这些卡已经不是每张 350 美元;改动是他让 Claude 做的;读数来自并发为 1 的 llama-benchy,还没有并发场景的数字。他接下来要确认 DeepSeek 与 GLM-5.3-Flash 能不能同样跑起来 4。
Loading content card…
把 128K 对话压进 800MB
还有一组材料换掉的是模型外面那套外壳。一位作者在做一个本地模型优先的 agent,刚出第一个桌面版本,他把自己改的几处写了出来 9。
第一处是 KV 缓存压缩。他自带一个 llama.cpp 分支、默认开 TurboQuant 的 turbo3 档,在同一台 M5 MacBook Pro 上,Qwen 3.5 4B 的 128K 会话从 4GB 降到 800MB。这层压缩是有损的,代价是少量质量损失 9。
第二处是让提示词前缀在会话里一个字节都不变:系统提示词、工具目录和技能列表在每一步之间保持完全一致,会变的东西都放到末尾。这样 llama.cpp 可以直接复用已经处理过的那一段缓存。同一台 M5 上,Qwen 27B 的回答从原来 4 分 20 秒才开始,变成大约 1 秒开始——作者自己说明这是缓存复用,不是推理变快了,但在一段长会话里,等待的大头就在这里 9。
后面几处都是给小模型擦屁股的。会话状态、记忆和旧工具结果放在磁盘上,提示词只是其中被截出来的一段,工具的冗长输出在进上下文之前先被裁掉;工具调用被语法约束成一段 JSON 数组,小模型可以挑错工具,但没法吐出坏掉的 JSON;每一步的思考上限默认约 1,500 token,免得它在原地绕十分钟;浏览器那一层读的是无障碍树而不是截图;连续三次一样的调用会被警告,五次没有新结果就被拦住,拦到第三次整个流程停下来告诉你原因 9。
这篇的作者就是 Atomic Agent 的作者,这几处数字来自他自己的集成而不是通用基准,他在同一段里也把这一点写明了 9。
顺带看到的几条
六个决策模型被安排去玩吃豆人,每个模型跑 100 次取平均分并给出 95% 误差范围:jev 1.13 得 2,750、最高分 6,380,GPT-6 Luna 2,568,Clef Flash 2,538,Clef 2,476,Kev 4B 1,506,Laya 639;延迟从 Laya 的 104 毫秒到 Clef 的 398 毫秒。排行榜和仓库都公开,你也可以接自己微调的决策模型上去 12。
一份低比特量化的研究性发布放出了 Qwen3.5-2B 的 IQ1_M、IQ2_M、IQ3_M 三个版本。作者改的是 ISTA 的 RCO 算法,好处是不用把 FP16 教师模型装进显存就能按显存预算量化,在 1 到 2 bit 区间把 KL 散度压下来不少;他自己也说这是概念验证,2B 太小,极端压缩下只能算还能用 1314。
一张 16GB 的 RX 9070(非 XT)上把 Qwen3.8-27B 的 GSQ-RCO-IQ3_S 跑起来了,显存峰值约 15.2GB,预填充起步约 600 t/s,解码从 26 t/s 掉到满上下文时的 22 t/s;MTP 在这套配置里没有帮助还多吃显存,128K 上下文压到 q4_0 15。
Strata 的仓库历史被重写了。一位用户说自己的更新脚本今天跑不动了,git 报没有共同祖先;追下去发现每一条历史提交都被改过,用来抹掉「Co-Authored by Claude」的痕迹 16。
audio.cpp 这一轮更新里,Higgs Audio TTS 的峰值显存降到约 6GB、少了 48%,HTDemucs 在 CUDA 上快 2.21 倍、在 Vulkan 上快 1.95 倍,六轨分轨快 1.99 倍,PocketTTS 在 CPU 上快 2.23 倍;作者说改完之后结果与改之前一致 17。
有人把一块 Radeon AI PRO R9700 装进雷雳外置盒接在 iPad Pro 上,用同一套引擎跑 Qwen3.8-27B 的 Q4 版本加 Q8 草稿:解码基线 / MTP=3 / DFlash2 在 iPadOS 上是 31.2 / 108.7 / 158.5 tok/s,macOS 上是 32.2 / 111.9 / 159.4,Linux 上是 32.0 / 111.0 / 144.6,同一块卡换到 Strix Halo 上是 14.0 / 47.8 / 64.4 18。
X 上一位做水电能源领域大模型落地的作者说,他拿 Jev 和 Qwen3.8、DeepSeek V4.1-Flash、Gemini 3.8 Flash 在同一批实际业务用例上比了一遍,通过率基本持平或更低;他承认 Jev 的成本确实低一些,但他不认为值得为此在系统里多引入一个模型 19。
今天能带走的三句话
第一句,先问旁边那一样加的是什么。同一张 4090 上四个决策模型差 13 倍,一部分差在模型,一部分差在 Lev 跑的是自己的 PyTorch 服务;同一张 5090 上首字从 32.9 秒到 5.9 秒,换掉的只是引擎那一层 17。
第二句,把那一层的代价一起算进来。八张旧卡把预填充从 350–450 t/s 拉到 3,000 t/s 以上,代价是自己维护一个 vLLM 分支;128K 对话从 4GB 压到 800MB 换来一点质量损失;2.00 元的 agent 外壳排第二,7.26 元的那副最好也最贵 349。
References
- 1Reddit:在一张 RTX 4090 上跑本地决策模型,看哪个最快
reddit.com
- 2小红书 AI未眠:RTX 4090 本地决策模型实测
xiaohongshu.com
- 3公众号 龙大聊AI:2块钱的第二名,7 块2毛的第一名
mp.weixin.qq.com
- 4
- 5公众号 玉米说AI:决策模型底座都是 Qwen,端侧 4GB 显存就能训\
mp.weixin.qq.com
- 6
- 7Reddit:Infernix,在 5090 上比 Strata 快得多\
reddit.com
- 8
- 9
- 10Hugging Face:Ekbasis-27B 模型卡
huggingface.co
- 11小红书 momo:本地跑 Qwen3.8 27B 100+tokens/s
xiaohongshu.com
- 12Reddit:决策模型玩吃豆人
reddit.com
- 13Reddit:Qwen-2B-RCOL 动态低比特量化发布
reddit.com
- 14Hugging Face:trubisky/Qwen3.5-2B-RCOL
huggingface.co
- 15
- 16Reddit:Strata 重写了 GitHub 历史以抹掉证据
reddit.com
- 17Reddit:audio.cpp 最近的更新
reddit.com
- 18
- 19
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.