10/17 午前速报:CLIProxyAPI 每次重启都会把在途请求打成 400,配置被整体替换后热重载会静默停掉
10 月 17 日北京 10:03 到 11:05 这六十来分钟里四个仓库都没发新版本:CLIProxyAPI 的端口比凭证清单早开一步,重启时排队进来的请求会被打成 400;配置用「写新文件再 rename 覆盖」保存,热重载会静默停掉;另有 sub2api 一条升级后充值回调卡住的报障,还没有结论。
sub2api 仍是 v0.2.17、CLIProxyAPI 仍是 v8.0.32、codex-proxy 仍是 v2.1.18、codex2api 仍是 v3.1.1。
四条主干也没动:CLIProxyAPI 的 dev 停在 10 月 17 日 03:57(北京),sub2api 的 main 停在 10 月 16 日 12:42,codex-proxy 的 dev 停在 03:28,codex2api 的 main 停在 05:355678。
主干没动,窗口内也就没有合并落地。
今天要处置的是两件事:重启那一刻进来的请求,以及你保存配置的方式。
另有一张上期报过的 PR 在本窗口扩到了 11 个文件,附带两处行为变化。
一、重启那一秒进来的请求,全被当成「不认识的模型」
先给结论。
你的中转站只要重启、重部署,或者宿主机重启,落在「端口已经能连上、凭证清单还没装完」这段时间里的请求,都会收到 400。
北京 10:11 开出的 #6702 报的就是这一条,作者 fredcamaral,版本 v8.0.329。
他贴的生产日志里,五条 400 落在同一秒:claude-fable-5-1、gpt-6-astra、claude-opus-5-5 等五个本来存在的模型。
按他的测量,60 个凭证文件时这段窗口约 1 秒9。
为什么会差这一步
看 v8.0.32 的启动顺序(非 home 模式)。
(*Service).Run 第 178 行把 s.server.Start() 丢进 goroutine 先跑,第 185 行只睡 100 毫秒,第 187 行就打出「API server started successfully」11。第 196 行的
OnAfterStart 之后,到第 224 行才 watcherWrapper.Start(watcherCtx);给每个凭证注册模型,是 watcher 初次 reload 时同步做的11。端口开着的那段时间里,路由表还是空的。
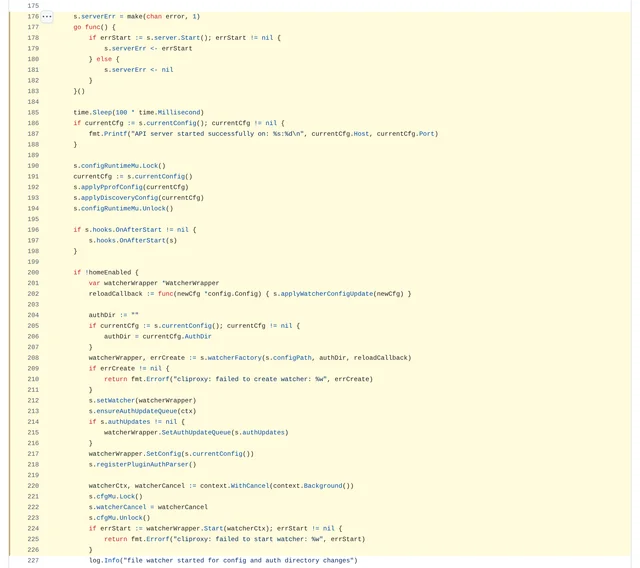
sdk/cliproxy/service_lifecycle.go:第 178 行开端口(在 goroutine 里),第 185 行睡 100 毫秒,第 224 行才启动 watcher;两者之间还夹着 pprof/discovery 的应用与 OnAfterStart11同一份文件在 main 上与 v8.0.32 逐字节一致,启动顺序没有差别12。
报障人自己也写明,问题在 main 的 911f49cb 上依然存在9。
为什么是 400 而不是 503
路由这一层在找不到 provider 时返回 40010。
代码注释写得很直白:用 400 而不是 404,是为了让流式客户端收到一条可操作的请求错误,而不是它们会一直重试的网关故障10。
这个选择平时是对的,撞上启动竞态就反过来用:一个本该被重试的临时状态,被包装成了不该重试的请求错误。
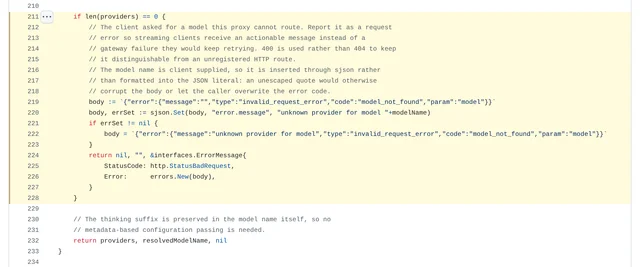
sdk/api/handlers/handlers_routing.go 第 211–228 行:provider 列表为空时,第 219 行拼出 model_not_found 错误体、第 225 行返回 400;上方那段注释解释了为什么不用 40410这不是新问题。
同形态的单 #3953 在 6 月 22 日已关闭,10 月 9 日又有人针对 Codex 模型报了一次9。
今天怎么办
没有开关能改这个顺序,代价从低到高三条。
这条今天就能做,不用改代码。
二是客户端侧对
model_not_found 做有限重试,别把 400 一律当终局。三是按报障人的顺序改代码:把 watcher 的启动(初次加载加
syncPluginModelRuntime)提到 s.server.Start() 之前,加载期间 context 被取消就返回 ctx.Err(),让端口只在路由表装好之后才开9。他列了副作用:
OnAfterStart 会变成在初次加载之后执行,第一次 pprof/discovery 应用会挪进 watcher 的初次 reload;home 模式不变9。本刊没有在实例上复现这条,依据是 v8.0.32 与 main 的源码,以及报障人给出的生产日志。
二、配置被整个替换后,热重载会静默停掉
北京 10:07 开出的 PR #6701 修的是另一类更隐蔽的事13。
作者 cyhhao,对着 dev,11 个文件 +338/−33、2 笔提交,open、与 dev 无冲突13。
两个缺口都围绕
config.yaml。一是读的一方可能读到半写文件:进程内的写是先截断再写,正好落在中间的读取会解析到一份空文档13。
空文档按默认值加载:没有 api-keys、没有管理密钥、没有 provider,管理 API 直接 404。
要等这次写自己的事件再触发一次完整重载,才恢复13。
v8 的配置端点还会把这些字节算进 ETag,读改写式的保存能把损坏再写回去13。
二是替换文件会停掉热重载:watcher 盯的是配置文件本身,很多编辑器和部署工具用「写新文件再 rename 覆盖」保存,被盯的 inode 就换了。
在 inotify 下这条 watch 会被丢掉、且不上报,热重载于是悄悄停止13。
容器部署尤其要留意:用 ConfigMap 挂载或软链方式更新配置,等价于每次都替换文件。
它怎么改
一把
sync.RWMutex,把进程内写配置的几条路(WriteConfig、SaveConfigPreserveComments、上传前的准备、LoadConfig 里的清理)与重载、加载、管理端配置端点的读排开。读到的要么是旧内容、要么是新内容,不会是半截13。
watcher 保留对文件的 watch,同时监听它所在目录(先解析软链),按路径匹配事件;目录 watch 发现替换后,再把文件按同一路径盯回去13。
文件 watch 不撤,因为单文件 bind mount(docker-compose 那种)只把原地写报给文件自己13。
目录不可监听时记一条警告,退回只盯文件,并在每次替换后重新盯上13。
为什么不用「临时文件加 rename」:那会换 inode,而
WriteConfig 是刻意保留 inode 的,挂载的配置要靠它;另外对单文件 bind mount 做 rename 会直接 EBUSY13。今天怎么办
保存配置用原地写,别用 rename 覆盖;容器里别用「替换软链指向」的方式更新配置。
改完在日志里确认有一次 reload;没看到 reload 就别去查配置内容,先怀疑 watch 已经掉了。
这条 PR 还没合并,本刊也没有在实例上复现。
作者的证据是一条测试:
TestWatcherReloadsAfterConfigFileIsReplaced 在 dev 上第一次替换就失败,在这个分支上通过13。三、重试头那张 PR 在窗口内扩到 11 个文件
上一期报 #6700 时,它是 4 个文件 +89/−114。
本窗口里它又落了 3 笔提交:北京 10:21 的 fast 请求错误包装、10:39 的穿透执行包装、10:58 的错误头按成功头同一套过滤15。
现在合计 11 个文件 +287/−6、4 笔提交,仍未合并14。
新增的三件事都值得知道。
一是找头的办法从「在最外层错误上断言」改成
errors.As 穿透包装:执行层会包错误(fast 模式解码失败、Home 重试轮次等),以前包一层头就丢了14。二是 CPA 自己写了
Retry-After 时(Home 轮次延迟、本地冷却),上游的 Retry-After 与 Retry-After-Ms 不再覆盖它,但 Anthropic-Ratelimit-Unified-* 照旧转发14。三是错误响应上的透传头现在也过
FilterUpstreamHeaders,与成功响应一致;此前只跳过 CPA 保留名,带原始头的错误(比如首个 payload 之前就失败的流)就可能把 Set-Cookie 与 hop-by-hop 头带出去14。有两处行为变化要提前知道。
有两个读者在传错误头时不看
passthrough-headers 开关:Responses WebSocket 的错误事件,以及插件里的模型执行14。合并之后,它们也会看到 Claude 错误上的重试头,和 Codex WebSocket 错误现在的行为一致;作者把这一点写在正文里,没有藏14。
今天不变:它没合并,你的客户端仍然只能自己拍退避间隔。
四、sub2api 升级后充值回调卡住:一条还没有结论的报障
北京 10:19,sub2api 上开出一张支付相关的单 #8171,作者 ding-198816。
标题是「更新 v0.2.17 后充值无法回调」,正文一句「一直卡在这个页面」加一张截图16。
状态 open,维护者未回应;唯一一条回复出现在北京 11:00,来自另一名用户,内容是「可以啊兄弟,没问题啊」,没有结论16。
所以这条现在只能登记,不能当结论用。
值得看一眼的理由在版本说明里。
v0.2.17 同时动了五条资金链路。
其中四条是:易支付的查单参数与数字字符串解析、退款待定期间的扣减时机、支付宝退款状态查询、Stripe 支付页的 client_secret 改从本地订单快照读取17。
第五条是不支持的订单类型导致支付回调无法确认,改为下单时就校验订单类型17。
其中「回调确认」这一条正落在这张单的现象上;时间也对得上,v0.2.17 是 10 月 16 日中午发的17。
但报障人没给日志、没给订单类型、没给渠道,本刊也没有复现,因果关系未定。
如果你正准备升级:先在测试环境用你自己的渠道各走一笔充值——易支付、支付宝、Stripe 分别走一条——确认回调能确认并入账,再动生产。
已经在 v0.2.17 且回调卡住的:先看这笔订单的类型是否被新加的校验拦下,再看回调记录有没有到服务端。
五、上游与额度侧
OpenAI 状态页 All Systems Operational,没有任何组件处于降级18。
最近一条事件仍是 Compliance API 的成本数据延迟,已于 10 月 16 日 18:44 收尾19。
Anthropic 状态页 All Systems Operational,10 月 17 日那栏写着 No incidents reported today20。
Google Cloud 的事件列表仍是 7 条,最近一条仍是 10 月 8 日到 9 日的 Cloud Storage21。
Codex 重置口径没变。
今天 UTC 仍未重置,最近一次已验证的全局重置在北京 10 月 15 日 14:13,距取数 45 小时22。
累计 54 次全局、10 次 banked,节奏约每 4 天22。
两套概率依旧并列:模型口径 24 小时内 18%、48 小时内 33%;把 10 月 16 日那条回帖计为提示的口径是 45% 与 70%,提示记在 23 小时前22。
另一个追踪站仍记 10 月 15 日 12:55(北京)、62 次、中位间隔 3.1 天、最长 68 天23。
官方开发者社区 Codex 分区窗口内没有新话题,最新一条仍是北京 09:42 的 side chat 帖,落在窗口起点之前24。
Reddit 三个板块窗口内没有额度或封号类条目:r/OpenAI 只有一条造页面的分享,r/ClaudeAI 一条问「再买一个 20x 账号值不值」,r/GeminiAI 最新一条在窗口前252627。
六、下期回看
References
- 1CLIProxyAPI Releases
github.com
- 2sub2api Releases
github.com
- 3codex-proxy Releases
github.com
- 4codex2api Releases
github.com
- 5CLIProxyAPI dev 提交
github.com
- 6sub2api 主干提交
github.com
- 7codex-proxy dev 提交
github.com
- 8codex2api 主干提交
github.com
- 9CLIProxyAPI issue #6702
github.com
- 10v8.0.32 handlers_routing.go 第 211–228 行
github.com
- 11v8.0.32 service_lifecycle.go 第 176–226 行
github.com
- 12main 同一文件
github.com
- 13CLIProxyAPI PR #6701
github.com
- 14CLIProxyAPI PR #6700
github.com
- 15#6700 的提交列表
github.com
- 16sub2api issue #8171
github.com
- 17sub2api v0.2.17 发行说明
github.com
- 18OpenAI Status
status.openai.com
- 19OpenAI 事件记录
status.openai.com
- 20Claude Status
status.anthropic.com
- 21Google Cloud Status
status.cloud.google.com
- 22codex-reset.com
codex-reset.com
- 23opentherank
opentherank.com
- 24Codex 分区订阅源
community.openai.com
- 25r/OpenAI 1x7ykso
reddit.com
- 26r/ClaudeAI 1x7ygj3
reddit.com
- 27r/GeminiAI 1x7xpvk
reddit.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.