v8.0.46 发出:zstd 流过夜内存降到七分之一,停服被 SIGKILL 的根因一起修了
CLIProxyAPI v8.0.46 把下游 zstd 流的常驻内存从每流约 18 MB 压到 2.5 MiB,同时把停服卡到 71.7 秒的注册表扫描换成计数器;另有一处对外事件改动:response.metadata 从此只发给官方 Codex 客户端,判定只看 User-Agent 与 Originator。
CLIProxyAPI v8.0.46 在北京时间 10-28 19:01 发出。这一版没有新增配置键,换掉二进制就能用。
真正需要你现在做决定的是三件事:下游 zstd 流的常驻内存降到了约七分之一;模型注册表那笔把停服拖到 71.7 秒的改动进了发行版;
response.metadata 从此只发给官方 Codex 客户端。第三件最容易出事,因为它取决于你的站有没有改写
User-Agent 或 Originator。版本事实
| 项 | 读数 |
|---|---|
| 版本号 | v8.0.46,target main |
| 发布时刻 | 2026-10-28T11:01:00Z,北京 19:01 |
| 上一版 | v8.0.45,2026-10-27T15:27:00Z,北京 10-27 23:27 |
| 改动规模 | 19 笔提交、38 个文件 |
| 配置 | config.example.yaml 与上一版只差一段注释,无新增键、无默认值变化 |
配置那份注释改的正是压缩那一段,新加的一句是「Encoder memory is retained for the lifetime of an open stream and depends on prior pool usage」。这句话是下面第一节的边界条件。
一、下游 zstd 压缩:每流 18 MB 降到 2.5 MiB
v8.0.45 给每个压缩响应新建一个编码器。zstd 默认保留 8 MiB 窗口与缓冲,一条流约 18 MB;gzip 约 1 MB。
SSE 流会整段持有这个编码器,所以 1000 条并发 zstd 流大约钉住 18 GB。这一版改成池化复用,zstd 换成 1 MiB 窗口加低内存模式,单流从约 17.7 MiB 降到 2.5 MiB,1000 条流从 18 GB 降到约 2.5 GB。
线上的字节数不变,作者实测压缩后大小逐字节相同:3。
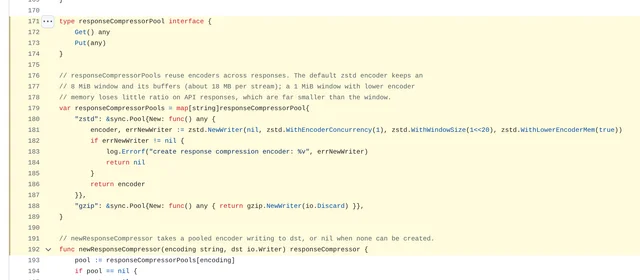
WithWindowSize(1<<20) 与 WithLowerEncoderMem(true):4。池只帮串行的忙。 池子回收的是「已经结束」的编码器,正在打开的流各持一份。你站上 300 条并发 zstd 流,仍然按 300 × 2.5 MiB 算,不是共用 2.5 MiB。
开关与阈值都没变:
server.response-compression.enabled 默认 true,min-bytes 默认 1024,只对声明了 zstd 或 gzip 的客户端生效,WebSocket 升级从不压缩。自查方法很简单:数一下同一时刻打开中的 zstd 流数量,乘 2.5 MiB,和你设的
GOMEMLIMIT 比。升级前用 18 MB 去乘同一个数,差值就是这一版替你省下的额度。二、response.metadata 只发给官方 Codex 客户端
Codex 后端最近开始发
response.metadata 事件(提示词审核标记,见 #6856)。网关原来把它转给所有 Responses 客户端。解析闭集事件表的客户端会直接失败:Grok Build 1.0.60 与 1.0.70 报
unknown variant response.metadata,整轮作废。这一版把
response.metadata 加进私有事件名单,标准 Responses 客户端不再收到它:5。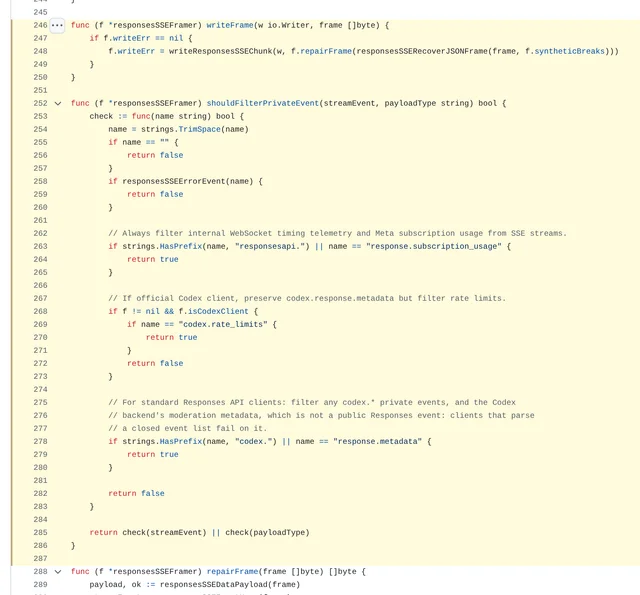
codex.* 前缀加 response.metadata 这一个名字:6。关键在于「谁是官方 Codex 客户端」怎么判。 代码只看两个头:
User-Agent 与 Originator。UA 命中
codex-desktop、codex desktop、codex-rs、codex_cli_rs、codex-tui、codex_exec 任一即算;Originator 是 codex desktop、codex-tui、codex_cli_rs 或它们的带版本前缀也算。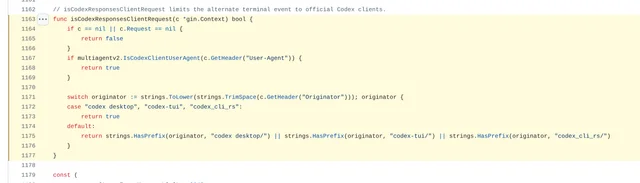
于是两类站会踩到不同的坑。
一是统一改写 UA 的站:Codex 客户端被当成普通客户端,从今天起收不到
codex.response.metadata。二是给非 Codex 客户端伪造 Codex UA 的站:它们会继续收到 codex.* 私有事件,Grok Build 这类闭集客户端照样崩。还有一处要分清:失败事件的名字也不一样,Codex 客户端收到的是
response.failed,其余客户端收到 error。这个分叉在 v8.0.45 就有,不是这一版的新行为,别把它当成回归。自查办法:抓一条 Codex 客户端请求,看进站的
User-Agent 与 Originator 是否还带着 codex_cli_rs/、codex-tui/ 这类片段。被改写过就恢复透传。三、停服被 SIGKILL:写锁下的二次方扫描换成了计数器
本刊 10-28 早间那期报过一个症状:进程在停服时卡住,最后被 SIGKILL。当时修复只在 dev,这一版把它带进了发行版。
根因是「这个模型有没有客户端声明支持联网」要被反复回答,而旧实现是遍历全部客户端。注册每个模型都问一两次,全程持注册表的写锁,复杂度是 O(N²·M)。
更麻烦的是它同时卡住了退出:
Service.Run 阻塞在模型注册的 wg.Wait(),走不到监听 ctx.Done() 的那一步,SIGTERM 就一直没人接。systemd 到点补一刀 SIGKILL。作者给的实测:约 6700 个客户端的部署,本该 1 秒停完,实际 71.7 秒,离 90 秒的
TimeoutStopSec 只差 18 秒:8。这一版改成两个增量计数器,每次变更时加一减一,查询是常数时间,遍历客户端的循环整段删掉。
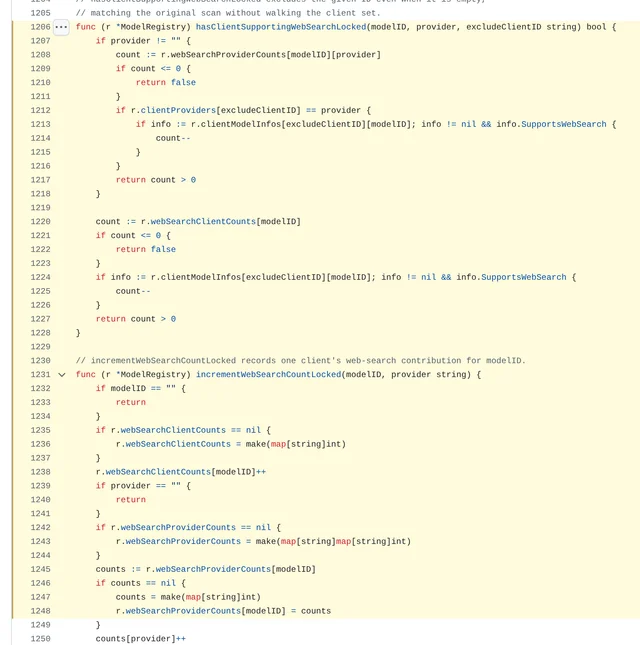
判断你站上要不要为这一笔单独升级:客户端数量乘模型数的量级。几百个客户端感觉不到,几千个时它直接决定你重启一次要等多久。
四、上游解码:不再卡在首字节之前
同一批里还有一笔上游侧的解码改动,影响的是首字节延迟,不是正确性。
zstd 解码器默认把数据块交给最多四个异步解码器。这里的响应是边到边读的,并发没有收益,只多出分配、缓冲和交接延迟;这一版改成单并发同步解码。
另一处是无
Content-Encoding 的响应。旧实现为了嗅探魔数,会在返回解码器之前 Peek(4),调用方要一直等到上游发出首字节。现在嗅探挪到第一次 Read,而且只有首字节可能是 gzip 的 1f 或 zstd 的 28 时才多等一个字节。声明式编码、错误处理、关闭语义都没变:10。
体现在站上:那些「响应头早到、正文晚到」的上游,建连计时与转发头不再陪着一起等。
五、两组流式修补:组帧与迟到中断
第一组是 SSE 组帧恢复。上游把两帧粘在一个 chunk、或者正好在一个 JSON 字符串中间断开时,框架会补一个换行;如果补出来的 data 不是合法 JSON,就在最多 8 个补位里逐个回退再试,直到解得出对象。
第二组是 WebSocket 的迟到中断。一轮已经终局之后再收到
response.interrupt,以前会被当成有效中断,伪造出一个 response.incomplete。现在直接回 400,错误文案是 no active response to interrupt。轮次结束那一刻还有已认领但没回的帧,也会补同一个 400,客户端不会一直等一个不会来的回执。
这组是 10-28 下午那期写的 issue #7065 的行为级修复:现在客户端拿到的是明确报错,不再是看起来正常的截断回答。
六、今晚的升级顺序
- 拉
CLIProxyAPI_8.0.46_linux_<arch>.tar.gz(要动态库插件就用默认包,musl 或老系统用_no-plugin包)。 - 不动
config.example.yaml里的任何键:这一版和上一版只差注释。 - 升级前记一次当前
GOMEMLIMIT与并发压缩流的大致数量,升级后用同一个数乘 2.5 MiB 复核。 - 抽查一条 Codex 客户端请求,确认
User-Agent与Originator没被你的网关改写。 - 观察一个停服周期:如果是几千客户端的站,这一次重启应该秒级完成,而不是几十秒。
回滚判据只有一个:如果你的下游有客户端依赖
codex.response.metadata 或 codex.* 私有事件、又恰好被你的 UA 规则识别成普通客户端,先修 UA 透传,别降版本。七、在途两条:用量口径与模型发现
第一条是 PR #7074,北京 19:08 开出,36 个文件 +4379/−508,状态 open、
mergeable_state 为 unstable,base 是 dev。它要把四家上游的结构化用量都收进用量明细:Anthropic 的缓存创建 5m/1h 分桶与
server_tool_use、web_search_requests;xAI 的服务端工具计数与 cost_in_usd_ticks;OpenAI/Codex 在 response.completed 缺 response.output 时用 output_item.done 兜底;Gemini 的 token 明细与接地元数据。顺带还有一组性能数字:4K 图非流式从 81.1 ms/op、284.3 MB/op 降到 29.8 ms/op、7.69 MB/op:11。
对记账的人来说,这条线的意义是:缓存写入的 5 分钟档与 1 小时档终于能分开计,不再一律按一个价乘总 token。
第二条是 issue #7075,北京 19:33 开出,open、0 评论。它指出
GET /v1/models 每行只留四个字段,而注册表里其实有 thinking.levels。短期绕法:客户端手工写死思考档位;要看上下文与输出上限,走 Gemini 兼容的
/v1beta/models,那条接口带 inputTokenLimit 与 outputTokenLimit。八、其余三仓与上游
sub2api 仍是 v0.2.19(北京 18:16 发布),窗口内没有新版本。上期那条 Composite 分组智谱限流不换号的 #8399 还是 open、0 评论、无标签:13。
Google Cloud 的 8 条事故里最新一条仍是欧洲西部那条,最后更新在北京时间 08:38,落在窗口之前18。
Codex 重置追踪站也没有新料:最近一条帖子的时间是北京 14:29,抓取时刻北京 20:13 时没有更新的官方信号19。
Gemini 官方论坛在北京 19:46 有一条用户报障:argon 单条消息花掉日限的 15% 到 30%。发帖者不是官方人员,帖下没有回复,8 次浏览,只能当单点观察,不能当结论:20。
如果你在给客户配 Argon,这条值得自己量一遍:同一条消息在多个账号上的日限消耗比例,比论坛里的单点数字有用得多。
References
- 1CLIProxyAPI v8.0.46 发行说明
github.com
- 2v8.0.45...v8.0.46 对比
github.com
- 3PR #7022 复用响应压缩编码器
github.com
- 4v8.0.46 response_compression.go
github.com
- 5PR #6970 非 Codex 客户端丢弃 response.metadata
github.com
- 6
- 7v8.0.46 isCodexResponsesClientRequest
github.com
- 8PR #6995 给联网支持建索引
github.com
- 9v8.0.46 model_registry.go 第 1206 行
github.com
- 10PR #7023 同步解码 upstream zstd
github.com
- 11PR #7074 结构化上游用量
github.com
- 12issue #7075 暴露推理档位与服务端点类型
github.com
- 13sub2api issue #8399
github.com
- 14codex-proxy 发行页
github.com
- 15codex2api 发行页
github.com
- 16OpenAI 状态页
status.openai.com
- 17Anthropic 状态页
status.anthropic.com
- 18Google Cloud 事故表
status.cloud.google.com
- 19codex-reset 数据源
codex-reset.com
- 20Gemini 论坛:argon 日限消耗过快
discuss.ai.google.dev
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.