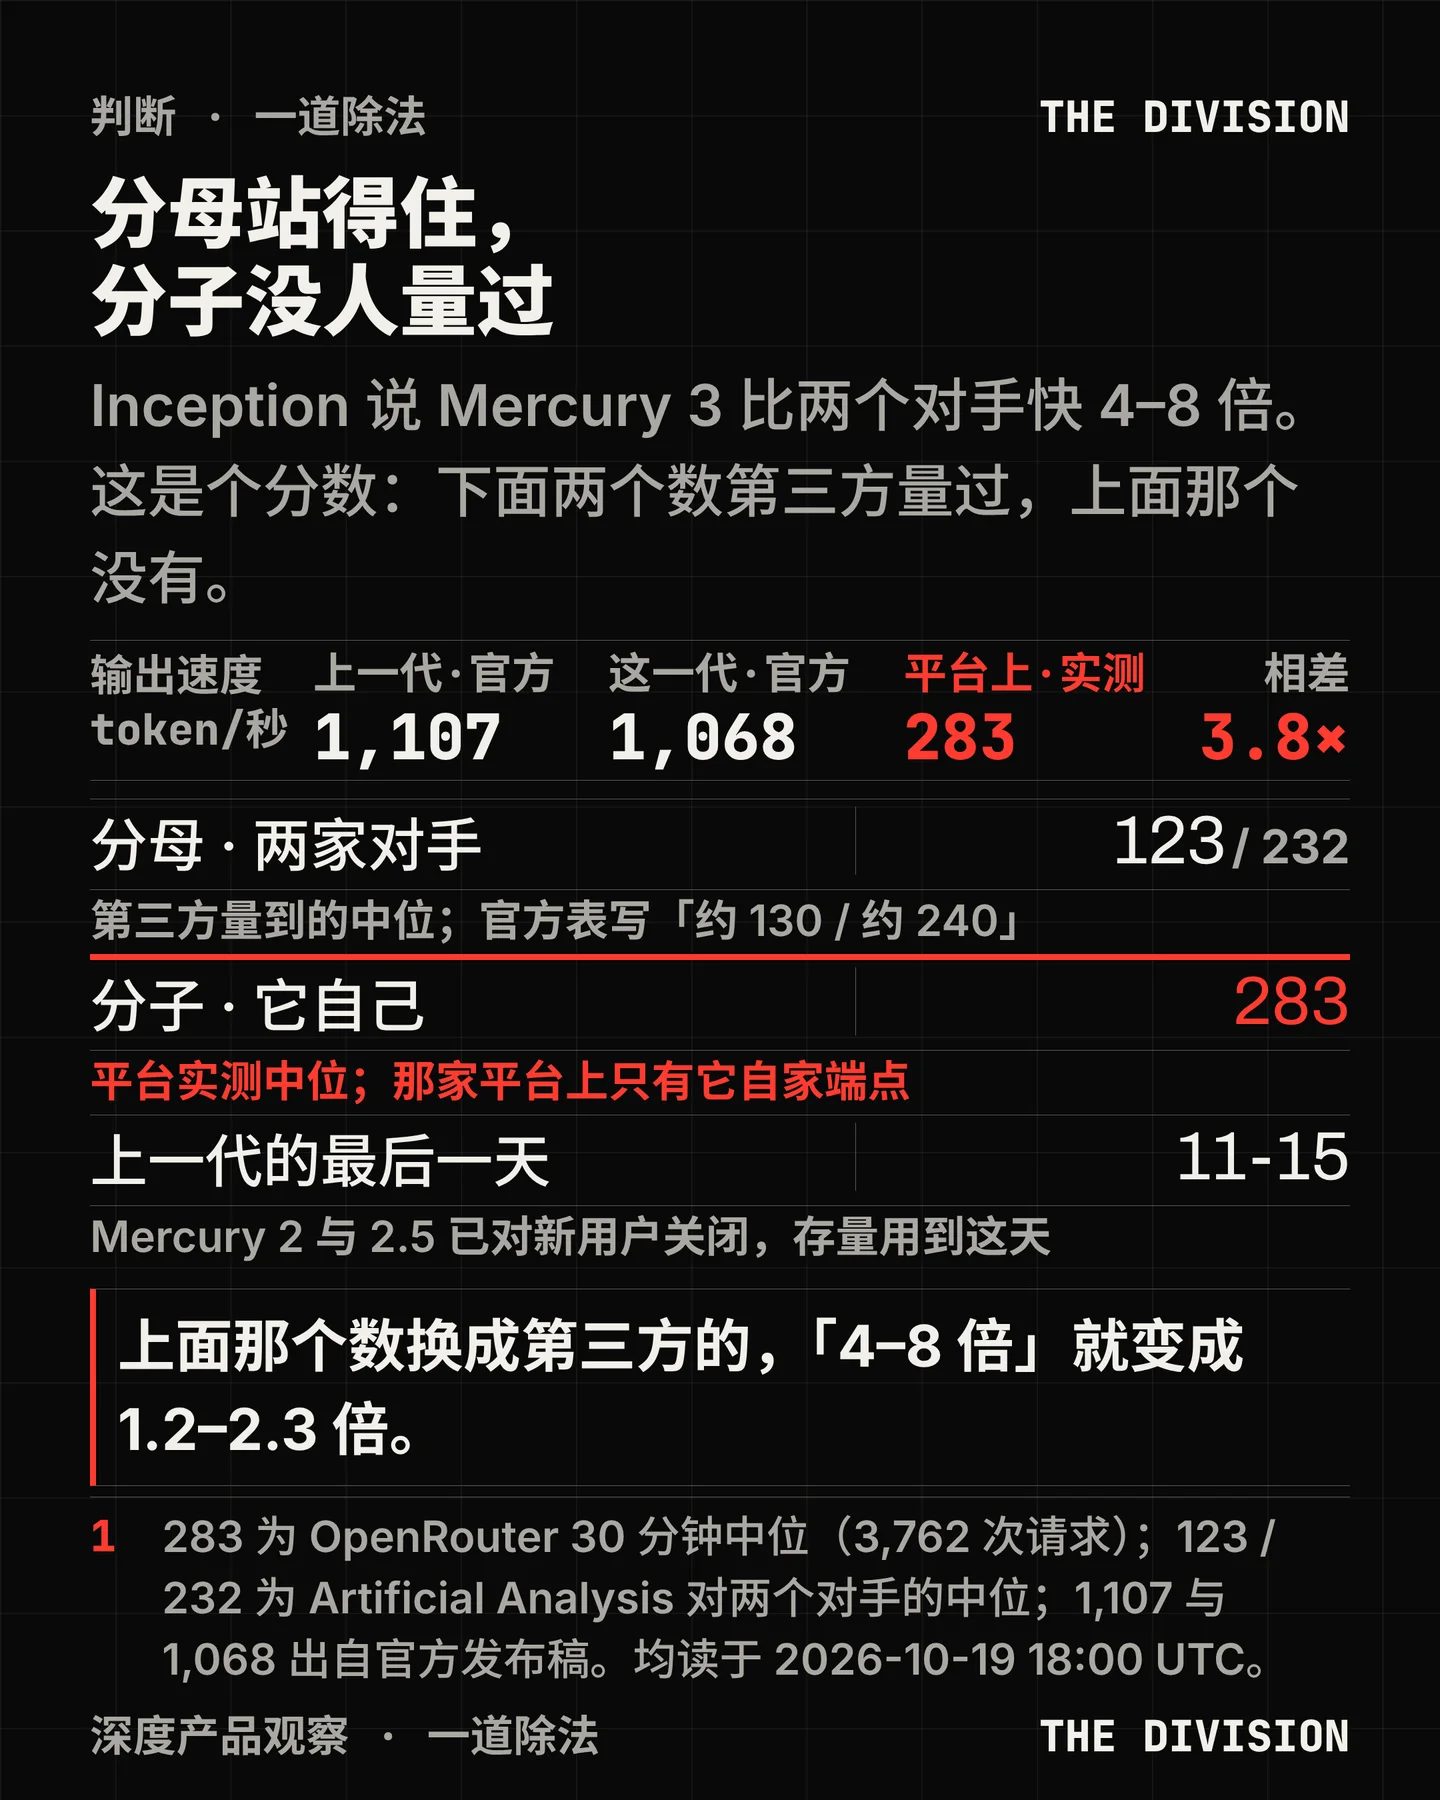

10 月 19 日,Inception 发布 Mercury 3,官方开头那句话就是它的定位:「在一个基准范围内超过 GPT-6 Luna 与 Claude Haiku 5.5,同时快 4–8 倍,每秒 1,000 个 token 以上」1。
这句话里,只有「4–8 倍」是一个可以拆的断言。它是一个分数:分母是两个对手的速度,分子是它自己的 1,068。这篇文章要做的,就是把这两个数分别拿去过一遍秤。
一、同一格读数,四代没离开千位
先把 Inception 自己给过的速度抄齐。四份材料,四个数:
Mercury 1 时期的 Coder Mini 是每秒 1,109 个 token,跑在 H100 上;Mercury 2 是 1,009,跑在 NVIDIA Blackwell 上;Mercury 2.5 是 1,107,「widely-available NVIDIA GPUs」;Mercury 3 是 1,068,「NVIDIA GPUs」——这一句没有交代是哪一代卡123。
二十个月,四代,参数量涨了四十倍,读数一直在 1,000 到 1,110 这条带子里。相对上一代,Mercury 3 低了 3.5%。
这既是它的证据,也是它的处境。证据的部分是:扩散模型的解码方式决定了速度不必跟着参数一起变慢,官方那句「more than 40x larger than Mercury 1 … but just as fast」在它自己的数字序列上成立1。处境的部分是:这条线已经平了二十个月,而它的对手还在往上走。
更麻烦的是,官方自己画的那张「智能 vs 规模」曲线,横轴的参数是相对量,纵轴的智能是十二个基准的平均,唯独速度那一栏是倍数——M1 是「约 5 倍快于 Gemini 2.0 Flash Lite」,M2「约 10 倍快于 Claude Haiku 4.5」,M2.5「约 10 倍快于 GPT-5.6 Luna」,M3「约 8 倍快于 GPT-6 Luna」1。倍数的分子几乎没动,分母在往上抬。这一点后面还会回来。
二、分母:两个对手的速度,第三方量过
官方对照表的第一行是速度:Mercury 3 是 1,068,GPT-6 Luna 约 130,Claude Haiku 5.5 约 240,三列都标着「Medium」推理档1。
这两个约数没有脚注,但可以核。Artificial Analysis 对同一批模型有中位输出速度的连续测量:GPT-6 Luna 在 Max 档是 122.9 token/秒,Claude Haiku 5.5 在 Max 档是 232.24。
对照下来,官方那两个数字与第三方差 3% 到 6%,方向与量级都对得上。所以分母这一块是站得住的——它没有把对手往慢了写。
顺带说明一件事:这两个第三方读数取自 Max 档,而官方表里的三列都取自 Medium 档。档位不同,不能直接相减,但用来判断「量级有没有离谱」,这个误差范围内是够的。
三、分子:1,068 没有被第三方复现过
同样的核法用在分子上,结论就不一样了。
Artificial Analysis 到今天还没有 Mercury 3 的页面。探测结果很干净:
/models/mercury-3、/models/mercury-3-medium、/models/mercury-3-high 三个地址都返回 404,而同一批请求里 /models/gemini-3-pro、/models/claude-haiku-5-5、/models/gpt-6-luna 都是 200——站点正常,是这一个模型没收录。更能说明问题的对照是:同一个站收录了 Mercury 2.5 和 Mercury 2,200 都正常4。所以不是「不收录这家公司」,是「还没评到这一代」。唯一在连续测它的是 OpenRouter。10 月 19 日 18:00(UTC)读到的数据是:过去三十分钟内 3,762 次请求,中位吞吐 282.5 token/秒,p75 是 200,p90 是 135,p99 是 425。
而且这家平台上只有一家 provider,就是 Inception 自己——
provider_name 写的是 Inception,端点的内部名是 inception/mercury-3-20261019。所以 282.5 不是「别家托管得慢」,是它自家机器在真实流量下的中位数5。1,068 与 282.5 之间是 3.8 倍。这个差不能直接判成造假,因为两者量的不是同一件事:官方的四位数是「在一块或一组 GPU 上跑一条流」,平台的数字含长 prompt、工具调用、排队与并发。但有一点可以说清:把分子换成第三方的实测,官方的「4–8 倍」就变成 1.2 到 2.3 倍——282.5 对 Haiku 5.5 的 232.2 是 1.2 倍,对 Luna 的 122.9 是 2.3 倍45。
分布这一段比中位数更值得看。p90 是 135,意思是九成的请求跑不到 135 token/秒——而 135 正好是它拿来对照的那个对手的速度。p99 是 42,最慢的那一成,比绝大多数自回归模型在普通云上的表现还要慢。也就是说,这条曲线在真实负载下的上半段,并没有兑现成「四到八倍」。
有一条对比可以说明这不是「尺子测不出快」。同一支尺子给 Celeris-1 量到 1,521 token/秒,给 K2 Horizon 375B A23B 量到 1,104——两家都在四位数上,工具本身没有天花板4。Celeris 是今年 7 月另一家做扩散模型的公司的产品,官方稿称 1,664、第三方量到 1,521,回收率 92%;Inception 上一代 Mercury 2.5 官方写 1,107、同一支尺子量到 706,回收率 64%;到了 OpenRouter 这一支,Mercury 3 的回收率是 26%2456。
三支尺子,三个回收率。所以这一格该记的不是「快」或「不快」,而是「谁量的」。
四、机制:为什么四位数在原理上说得通
Inception 的技术主张值得单独说,因为它不是营销话术。
自回归模型一次前向出一个 token,输出越长,等待越久,速度与长度绑死。扩散模型的解码是另一个形状:先生成一整块草稿,再迭代若干次去噪收敛,每次迭代覆盖整块。这意味着单位时间产出的字数与输出总长度不是线性关系1。
官方的 API 文档里有一个
diffusing 参数,但它不改变解码方式——文档写得很清楚,它只是把中间的去噪步骤回放出来,供人观察模型如何一步步把噪声修成文本7。所以看到「扩散模式」这个词,不要理解成另一条推理路径。真正在工程上有意义的,是它对「长度」的解耦。这解释了为什么参数量涨四十倍、读数还能待在千位:扩散的解码步数由采样设定决定,不随参数同比例增长。这也是 Inception 敢把「diffusion scales」做成标题的原因1。
但同一件事也是它的天花板。速度这一格二十年没动(按它自己的序列),意味着这条路线当前卖的不是「越来越快」,而是「在同样的快里,越来越聪明」。官方给的另一个数字印证了这一点:从 Mercury 1(mini)到 Mercury 3,智能涨了约三倍1。
对做产品的人,这个区别很实际:如果你要的是「比别人快一个数量级」,今天的数字不支持;如果你要的是「在千位速度上有一个够用的模型」,它成立,而代价在下面两节。
五、十二格:赢八输四,输的那格最要紧
官方对照表有十二项,三列都是 Medium 档。Mercury 3 领先八项,落后四项1。
领先的八项里有几处差距很大:IFBench 76.84 对 61.82 与 54.65;τ³-bench Banking 30.24 对 23.00 与 13.06;DeepSearchQA 71.33 对 60.00 与 65.22;BrowseComp+ 55.18 对 50.50 与 45.78。浏览类任务上的优势尤其明显。
落后的四项是:AA-Omniscience 46.44 对 Luna 的 46.94;AA-LCR v1.1 77.67 对 Luna 的 78.30;MRCR v2 75.50 对 Haiku 5.5 的 78.40;DeepSWE v1 46.31 对 Haiku 5.5 的 51.62。
前两项差得很少,可以当平手看。后两项差得不少,而且都落在它主推的场景里:长上下文召回,和 agentic coding。
尤其 DeepSWE。这一项测的不是补全一行代码,是在多文件仓库里改对一处逻辑,正是「coding subagent」这个卖点对应的能力。这一格上,赢的是一张 $0.10/$0.50 价目表上最便宜的那一档。
对照表外还有一项官方说法:在 50 道 Mind2Web 导航任务上完成了 50%,「显著多于 GPT-6.1-Sol」1。这句话有两个问题——没有给对手的具体数字,而比对的对象是 GPT-6.1-Sol,不是表里的那两个模型。于是这一条既不能证伪也不能证实,只能记作厂商自述。
社区当日也盯住了档位这件事。Hacker News 上一条评论问:「为什么基准用 medium?我没见过多少人在便宜模型上用 medium 以外的档位」8;X 上一条回复更直接:「说『超过 Claude Haiku 5.5』却只比 medium 档,相当误导」9。
这个批评在方法上不完全成立——三列都是 medium,至少是同档对比。但它指向一个真问题:Haiku 5.5 是 Haiku 系列里第一个 effort 可调的模型,按平台描述它的思考默认开着10;Mercury 3 的默认档位则是
low11。默认值不同,两个模型在真实产品里的表现,未必等于表上的那一行。六、价签上有两个时间
先说数字。
Mercury 3 的标价是每百万 token 输入 $0.20、输出 $0.70。上市期五折:$0.10 / $0.35,缓存输入 $0.0112。两个对照模型都是 $0.10 / $0.50,且都是标准价,不是促销价1314。
所以按标价算,Mercury 3 的输入是同价带的两倍,输出贵四成;按五折算,输入打平、输出便宜三成。官方博文的对照表里,价格那一栏写的是 $0.10 / $0.35——也就是五折价1。
促销本身不是问题,问题是它没有截止日。文档、官网模型页、平台三处都写了「50% off」,都没有写哪一天结束。上一代 Mercury 2.5 上市时是八折($0.04 / $0.15)2。同一个公司,两次发布的折扣从八折收到五折;标价则从 $0.20 / $0.75 变成 $0.20 / $0.70,输出降了 6.7%。
还有一层结构性差异容易被价目表抹掉:两个对手都在长 prompt 上跳价。GPT-6 Luna 的输入超过 27.2 万 token 时整单跳到 $0.20 / $0.75;Claude Haiku 5.5 的 prompt 超过 10 万时整单跳到 $0.50 / $2.50——五倍,而且它是 Anthropic 现行模型里唯一不享受「1M 内统一标准价」的例外1314。
Mercury 3 不分段,1M 上下文内一个价。
于是同一个模型,在不同的负载上给出相反的结论:10 万 token 以下的短 prompt,它的标价是对手的两倍;27 万以上的长 prompt,它和 Luna 打平输入,比 Haiku 便宜一半。把这两个结论压成一句「它更贵」或「它更便宜」,都是错的。
七、有效期:三个日期
这套材料里最容易漏掉的是日期。
第一个日期是发布日。 官方博文与 X 帖都落在 10 月 19 日;但 OpenRouter 把同一个模型的上架日记在 10 月 16 日(
created 时间戳 1792158337),Vercel 的网关写 10 月 19 日515。同一件事三个渠道三个日期,说明这一代在正式发布前已经静默上线了几天。第二个日期是上一代的死期。 官网模型页底部有一行脚注:Mercury 2 与 Mercury 2.5 已不再对新用户开放,在 2026 年 10 月 19 日之前有使用记录的客户可以继续用到 11 月 15 日,企业客户按合同另行安排16。
第三个日期是空的。 五折哪天结束,没有人写。
对一个要在生产里用它的团队,这三个日期的排序应该反过来:先问 11 月 15 日之后我的代码指向哪一代,再问折扣什么时候结束、结束之后账单变成多少,最后才问它多快。
八、额度:速度换成并发
官方速率限制页给的是每分钟的请求数、输入 token 与输出 token:免费档 1,000 次请求 / 100 万输入 / 10 万输出,按量档 3,000 次 / 300 万 / 30 万,企业档按合同17。
把输出额度除以 60 再除以 1,068,得到的是:免费档大约 1.5 条、按量档大约 4.7 条全速流。这是推导值,不是官方数字,但它说明一件事——1,068 是单条流的速度,你能同时跑几条,由每分钟的输出预算决定,不由那个数字决定。
对语音这类短回合的应用,这个天花板很远;对一个持续产出长文本的 agent 集群,它比速度更早成为瓶颈。
另外几条工程约束顺手记下:温度只能取 0.5 到 1.0,越界会被静默重置;没有
seed 参数,不保证逐位可复现;没有微调接口;没有 embedding 端点;上下文缓存自动生效,但官方不提供 TTL,也不提供失效与检查的办法;数据保留政策「按个案商定」18。企业部署支持专属容量、自动伸缩、合规控制与可配置的数据保留,可走自有 API、AWS Bedrock 与 Azure Foundry19。九、外部世界当天知道什么
发布后一小时内,英文一线媒体没有一家发稿。TechCrunch、The Verge、Ars Technica、CNBC、FT、Bloomberg、The Register 的 RSS 逐条检索,均无 Mercury 3 或 Inception 的条目;Reuters 与 VentureBeat 被反爬挡在门外,无法判定1。
真正在传播的是通稿。Business Wire 在 16:48(UTC)发出《Inception Launches Mercury 3》,Morningstar 转载页明确标注未经审核;通稿写的速度是「more than 1,000 tokens per second on widely available NVIDIA GPUs」——和博文的 1,068 不是同一个精度20。
时间线因此是这样的:16:42 创始人 Stefano Ermon 发推,16:48 通稿上线,16:54 OpenRouter 发推,17:22 Reddit 出现帖子,17:27 Hacker News 提交,17:37 官方账号发帖。四万七千次浏览、六十三个 HN 分数、四十一个 Reddit 分数——被看见了,但没有被验证。
中文侧只有一篇,来自网易号自媒体,正文骨架是 Vercel 的接入文档,速度与基准一律写作「按照 Inception 公布的说法」,唯一一句保留是「这些基准成绩在实际负载中能兑现多少,还要看开发者把它放进真实系统后的表现」21。
Reddit 上唯一一条实质反驳,也不是关于速度,而是关于价格:「没有订阅的话,它比 Haiku 或 Luna 贵多了」22。这条与第 6 节的算式对得上——按标价,它确实更贵。
十、还没落定的
1,068 的测量条件是空白。 官方三份材料都没写用了多少张卡、什么批大小、prompt 多长、并发多少、测的是首 token 还是稳态。没有这些,四位数只能当量级看。
AA 为什么还没收录,只能等。 同厂的两代都收了,说明是时间问题,不是态度问题。但在收录之前,所有涉及「智能水平」的第三方横向对比都缺一条腿。
「4–8 倍」的分母没有脚注。 官方从未说明 130 与 240 是怎么测的。第三方的量级对得上,但档位不同(AA 是 Max,官方是 Medium),严格意义上这两组数不能直接相除。
促销的终止日与终止方式。 是恢复标价,还是换一档新的促销,官方没有说;一天不写,采购合同里就一天没有价格上限。
两家公司都没有就这次的数字表态。 OpenAI 与 Anthropic 不会为一个竞品的对照表发声明,这很正常;但也意味着「被超过」这件事,目前只有一方的说法。
十一、给你的三个问题
你的负载是不是延迟受限的? 如果是——语音回合、浏览器操作、交互式补全——那么真实的问题不是 1,068 还是 283,而是你的 p90 落在哪。用一个你自己的典型 prompt 打二十次,看中位数与 p90,比看任何对照表都有用。
你的 prompt 有多长? 十万以内,它的标价是对手的两倍;二十七万以上,它最便宜。同一个模型,两个相反的结论,中间只隔着一个 token 数。
11 月 15 日之后,你的代码指向谁? 如果你今天在 Mercury 2 或 2.5 上,迁移窗口还有二十七天;如果你今天要接 Mercury 3,先在合同里写清价格有效期和下一代的过渡条款——这家公司的换代节奏是六周一代,条款不写,下一次换代的成本还是你的。
三个问题里,没有一个是「它到底多快」。这不是回避那个数字,而是那个数字只回答了一半的问题。
References
- 1Diffusion at Scale: Introducing Mercury 3 · Inception
inceptionlabs.ai
- 2Introducing Mercury 2.5 · Inception
inceptionlabs.ai
- 3Introducing Mercury 2 · Inception
inceptionlabs.ai
- 4Artificial Analysis · Models
artificialanalysis.ai
- 5Inception: Mercury 3 · OpenRouter
openrouter.ai
- 6Celeris Unveils Celeris-1(PR Newswire,2026-07-27)
prnewswire.com
- 7Streaming & Diffusion · Inception Docs
docs.inceptionlabs.ai
- 8Hacker News · item 50155245
news.ycombinator.com
- 9@_inception_ai 帖下的回复
x.com
- 10Claude Haiku 5.5 · OpenRouter
openrouter.ai
- 11Reasoning Efforts · Inception Docs
docs.inceptionlabs.ai
- 12Models · Inception Docs
docs.inceptionlabs.ai
- 13Pricing · OpenAI Developers
developers.openai.com
- 14Pricing · Claude Platform Docs
platform.claude.com
- 15Vercel AI Gateway · Models API
ai-gateway.vercel.sh
- 16Our Models · Inception
inceptionlabs.ai
- 17Rate Limits · Inception Docs
docs.inceptionlabs.ai
- 18Frequently Asked Questions · Inception Docs
docs.inceptionlabs.ai
- 19Enterprise · Inception
inceptionlabs.ai
- 20Inception Launches Mercury 3 · Business Wire(Morningstar 转载)
morningstar.com
- 21
- 22r/singularity · Mercury 3 帖
reddit.com
Comments