上游报错 11 分钟、508 条记录首字全为 0:事故单还没关,修复只在 dev
四个仓库整夜没有发新版本:上游付费计划报错 11 分钟、事故单仍在观察;插件执行器那条路的首字时间一直是 0,修复只进了 dev。
北京时间今天凌晨,上游先出了 11 分钟的事,本地代码里也有一处一直在少记一个数。两件事要分开处理:前者的单子还没关,后者已经有修复、但只进了 dev。
四个仓库从昨晚 22:33 到现在都没有发新版本,所以今天早上没有「升一版就好」这个选项。
先说结论。上游那 11 分钟只影响付费计划用户发消息,06:49 已上缓解,事故单仍是 monitoring;插件执行器那条路的首字时间缺失是本地缺陷,修复落在 dev,等下一版。
上游那 11 分钟,事故单还没关
事故编号
01M6MBCX427A7113A3T4FJ1N6Y,标题是「Elevated error rates across paid ChatGPT plans」,影响级别 minor。官方第一次说明写得很直接:付费计划的用户发消息可能报错,正在做缓解。1时间点只有两个:北京 06:38:12 判定为 identified,06:49:34 转 monitoring,原话是「已应用缓解,正在观察受影响服务以确认恢复」。抓取时刻是 07:34,
resolved_at 仍是空。1最容易误判的一处:同一时刻状态页顶部的整体状态是全绿的。页面级指标和单个事故单是两套东西,看绿条就认为「已经好了」,会让你把一个仍在观察中的事故当成结案。2
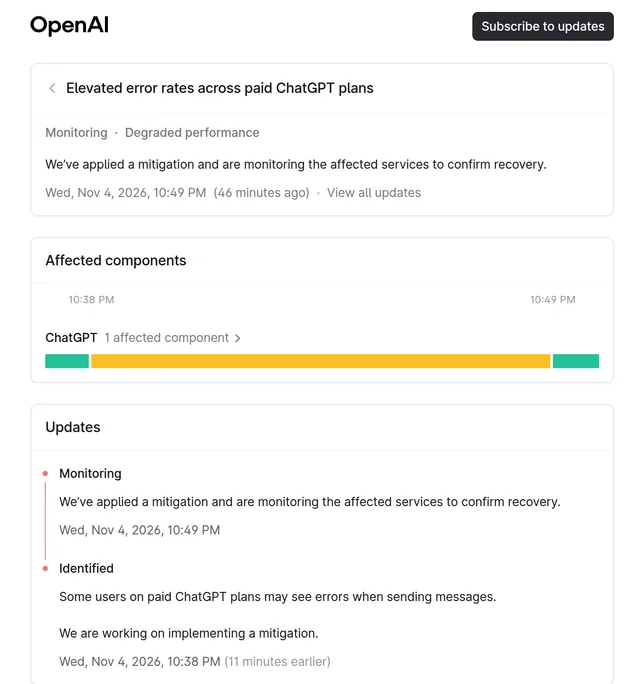
resolved_at 仍为空,页面级整体状态却是全绿。来源:https://status.openai.com/incidents/01M6MBCX427A7113A3T4FJ1N6Y1对中转来说,这 11 分钟会留下三个后遗症,都不会随上游恢复自己消失。
第一,凭证会被记错。这期间上游回的 5xx 与超时,在本地看来和「这个号坏了」没有区别,一批正常账号被写进错误态或冷却里。3
第二,冷却会叠。多个号在同一分钟被扣,池子宽度当场变窄,后面的请求排队等冷却,看起来像「额度用完了」,其实只是没人可选。
第三,换号预算被吃掉。一次请求连续换号,预算是有限的,全花在这一段里,业务侧看到的就成了「服务不可用」。
处置顺序建议这样走,别一步跳到全量清。
先圈时间窗:只看北京 06:38 到 06:50 之间失败的凭证。再只清这一段里的冷却——CLIProxyAPI 用
POST /v8/management/routing/cooldown/reset,请求体带 auth_index,值从 GET /v8/management/credentials 的返回里取;sub2api 用 POST /api/v1/admin/accounts/:id/clear-rate-limit 清限速与过载,DELETE /api/v1/admin/accounts/:id/temp-unschedulable 清临时不可调度。4最后一句提醒:不要用
batch-clear-error 一键全清。它会把真正被封、真欠费的号一起放回池子,下一次请求再撞一次,日志上就分不清哪次是上游抖动、哪次是号本身的问题。508 条记录,首字全是 0
报障单是
#7253,昨天 19:03 提的,今天 07:23 被打上 Fixed 标签。作者给的是自己现网的统计:usage.handle 事件 508 条,latency_ms 有值 508 条,ttft_ms 有值 0 条。5同一个人的另外两组计数更能说明范围:
model.route 604 条、executor.convert 88 条,两组都不带这两个字段。也就是说,只有 usage.handle 这一列本该有首字,而它一条都没有。他用的是 v8.0.51(
7cad1cb),换到 v8.0.54(78a9cc9)复核仍在。样本里一条流式请求 latency_ms 是 71484、output_tokens 是 114,首字那格空着。代码上原因很干脆:流式与非流式两条 handler 都建了 reporter,但都没开机。6
v8.0.55 的
streamWithPluginExecutor 里,第 68 行 NewUsageReporter、第 69 行设置思考档位,第 71 行就直接 host.ExecutePluginExecutorStream(...) 了,中间没有 StartResponseTTFT。整个文件里这个函数一次都没出现。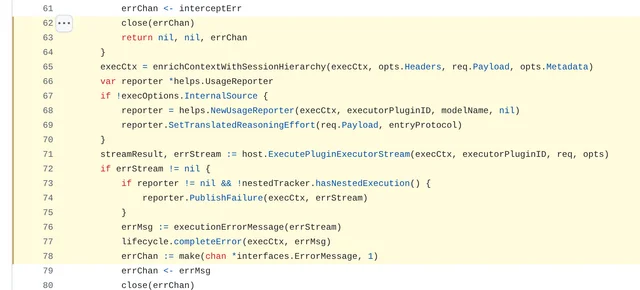
sdk/api/handlers/handlers_stream.go 第 61–80 行(v8.0.55)6非流式那条同样缺,而且还多缺一处。第 223 行建 reporter、226 行调执行器,235 到 238 行拿到响应直接
Publish,中间没有 RecordFirstPacket——连「整包首包到达」都没记。7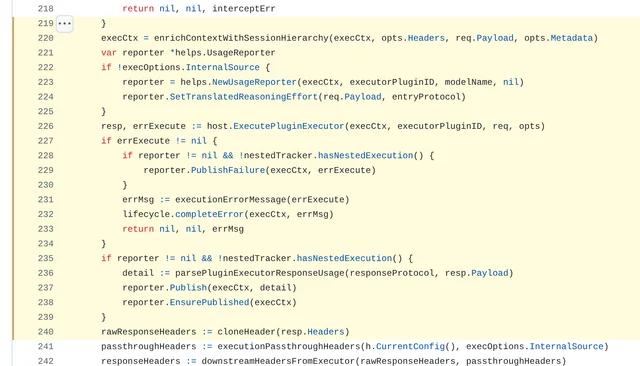
ExecutePluginExecutor、第 235–238 行直接 Publish 与 EnsurePublished,中间没有 RecordFirstPacket。来源:sdk/api/handlers/handlers_execution.go 第 218–242 行(v8.0.55)7流式中途其实有观测,但观测的东西不对。第 209 行每块调用的是
observePluginExecutorStreamUsage,只累计用量,不碰首字。8adapter 层为什么没兜住?因为它拿到的是空账号。
executor_route.go 调 adapter.ExecuteStream(ctx, (*coreauth.Auth)(nil), ...),而 adapter 里建 reporter 的条件是 if auth != nil,条件为假,reporter 一直是 nil,那两行正确写法永远不会执行。9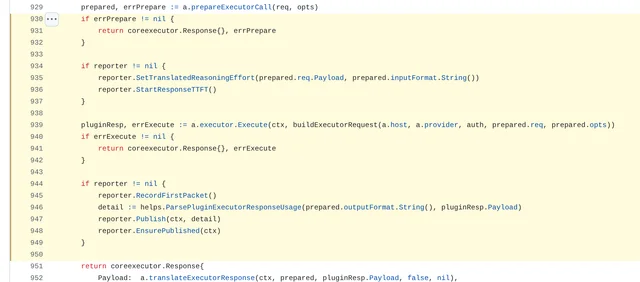
StartResponseTTFT 在调用之前,第 945 行 RecordFirstPacket 在返回之后,第 946–948 行才 Publish。这四行在插件执行器路径上从未被执行。来源:internal/pluginhost/adapters_executors.go 第 929–952 行(v8.0.55)10兜底也没救回来。
StartResponseTTFT 只是把起点置为当前时刻;观测侧 ObserveTokenEvent 开头有一句「起点为零就直接返回」,而 ttftDuration() 在没 set 过的时候返回 0。起点没人设,后面每一步都合法地算出 0。111213顺带说清一件容易误报的事:库里其实早就有现成的观测函数。
plugin_executor_usage.go 第 100 行的 ObservePluginExecutorStreamTTFT 会先 RecordFirstPacket(),再按协议分派到 Claude、Gemini、Responses 三种分块解析。缺的只是有人去调它。14影响面按这条链路算:所有经
model_router 走到插件执行器的请求,流式与非流式都算。只看面板首字列、按首字做告警、或用首字算「体感延迟」的,从这条路上来的数据一直是 0。计费金额不受影响,受影响的是统计口径,与具体装了哪个插件无关。修复在 dev,还没进 v8.0.55
维护者自己写了修复,直接提到 dev,没有走 PR。提交是
f208c90824f265f3bc61c74544aac29918a2f7a3,标题「fix(handlers): record TTFT for direct plugin executor routes」,提交说明末尾一行 Closes: #7253。15改动很小,4 个文件 +164/−0:流式与非流式各加 2 行,新增一个 4 行的包装函数,剩下 156 行是测试。三条测试用例的名字直接写了要证明什么——非流式发布非零首字、流式发布非零首字、以及流式的首包兜底路径。
流式那两行的位置就是前面那张图的空档:第 70 行插入
reporter.StartResponseTTFT();再在每块观测用量之前插一行 observePluginExecutorStreamTTFT(responseProtocol, reporter, chunk.Payload)。非流式那两行同理,Publish 之前先 RecordFirstPacket()。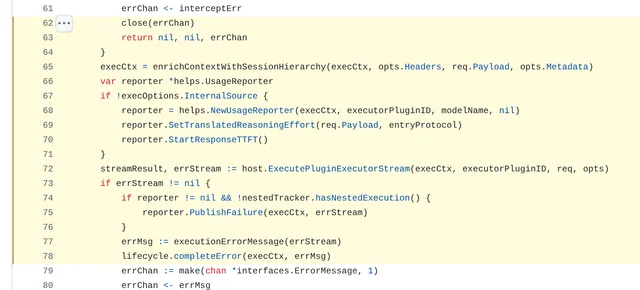
reporter.StartResponseTTFT(),第 72 行才是 ExecutePluginExecutorStream——与上一张逐行对齐,只多这一行。来源:sdk/api/handlers/handlers_stream.go 第 61–80 行(dev,提交 f208c90824)16版本位上要留个心眼:
git ls-remote 显示 HEAD、main、refs/tags/v8.0.55 三者同为 e6e5708e,dev 是 f208c90824——dev 恰好领先一笔,就是这次修复。15所以这块的结论只有一句:升级到含这笔提交的版本之前,首字列不可用;没有配置项可以打开或关闭这件事,也没有环境变量能绕过。
社区里另有人提了同题补丁
#7258,改同样两处,4 个文件 +74,仍在 open、状态 clean。作者在正文里给了红绿对照:修之前 record.TTFT = 0s, want > 0,修之后两条都过。17对运维来说不用赌这两个谁被合:维护者那份更完整,已经进 dev;
#7258 的价值是给了一个独立复现,证明这不是某个插件的锅。升级前先改口径:面板上这条链路的首字按「无数据」处理,不要按 0 参与均值——0 会把均值往下拽,让你误以为变快了。
升级后怎么验:挑一条走
model_router 的流式请求,看 usage.handle 记录里 ttft_ms 是否大于 0;非流式记录的是整包首包时间,量级比流式大得多,别把两类混在一张图里比。一个客户端侧的坑:Codex 应用按会话记 provider
#7257 是昨晚 22:34 提的单,目前零评论、零标签,先把现象和边界写清楚。18用户把 Codex 应用更新后,续聊报错:「Failed to resume chat — This chat uses openai, but your current provider is cpa-gui. Switch to openai to continue.」把
~/.codex/config.toml 的 model_provider 改回 openai,只有那一个会话恢复正常,其他会话反过来要求他切回 cpa-gui。这条是单条用户报告,没有维护者回应,所以不下结论说这是 Codex 应用的哪个机制。能确定的部分:报错是按会话比对的,改全局配置不会迁移已存在的会话。
对中转的含义:这是客户端行为,不是中转故障。用户把 provider 名改来改去之后,老会话续不上,别去动服务端配置。
版本位与在跟
四个仓库这一晚都没有新版本,最新分别是:CLIProxyAPI v8.0.55(北京 11-05 02:03)19、sub2api v0.2.19(10-28 18:16)20、codex-proxy v2.1.23(11-03 19:35)21、codex2api v3.1.3(11-04 10:22)22。
在跟的一条:sub2api 的
#8512 加了 BytePlus 预付费资金池与只读账单查询,64 个文件 +6165,作者昨晚 23:19 在评论里求评审,仍 open、未合并。23 v0.2.19 的平台常量表里没有 byteplus,所以现在还建不了这个平台的号。额度那边没有变化:今天 UTC 到现在没有重置,最近一次已验证的全局重置在 10-28 06:35(北京 14:35),累计 61 次、可结转 10 次。24
Anthropic 侧窗口内没有新事故,最新一条仍是 10-28 的连接器问题;Google Cloud 的
incidents.json 最新一次修改是北京 11-05 05:15,早于本窗口起点,内容仍是 10-20 那次事故的最终复盘。2526今早按这三步走
先看事故单的
resolved_at 有没有落,别看绿条。再按时间窗清冷却,只清 06:38–06:50 那一段,不要全量清错误。
首字那一列先按无数据处理,等含
f208c90824 的版本上来再验 ttft_ms > 0;中间不要为它改任何配置。References
- 1Elevated error rates across paid ChatGPT plans
status.openai.com
- 2OpenAI Status summary
status.openai.com
- 3sub2api v0.2.19 管理端账号路由
github.com
- 4CLIProxyAPI v8.0.55 管理端 v8 路由
github.com
- 5#7253 model_router 直连插件执行器的请求 TTFT 恒为 0
github.com
- 6v8.0.55 handlers_stream.go 第 64–72 行
github.com
- 7
- 8v8.0.55 handlers_stream.go 第 203–212 行
github.com
- 9v8.0.55 executor_route.go 第 94–101 行
github.com
- 10
- 11usage_helpers.go 第 436–450 行
github.com
- 12usage_helpers.go 第 474–500 行
github.com
- 13usage_helpers.go 第 768–784 行
github.com
- 14
- 15commit f208c90824
github.com
- 16dev 分支 handlers_stream.go 第 64–72 行
github.com
- 17
- 18#7257 Failed to resume chat:provider 不匹配
github.com
- 19CLIProxyAPI v8.0.55
github.com
- 20sub2api v0.2.19
github.com
- 21codex-proxy v2.1.23
github.com
- 22codex2api v3.1.3
github.com
- 23PR #8512 BytePlus prepaid pools
github.com
- 24codex-reset 追踪
codex-reset.com
- 25Anthropic 状态 incidents
status.anthropic.com
- 26Google Cloud incidents
status.cloud.google.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.