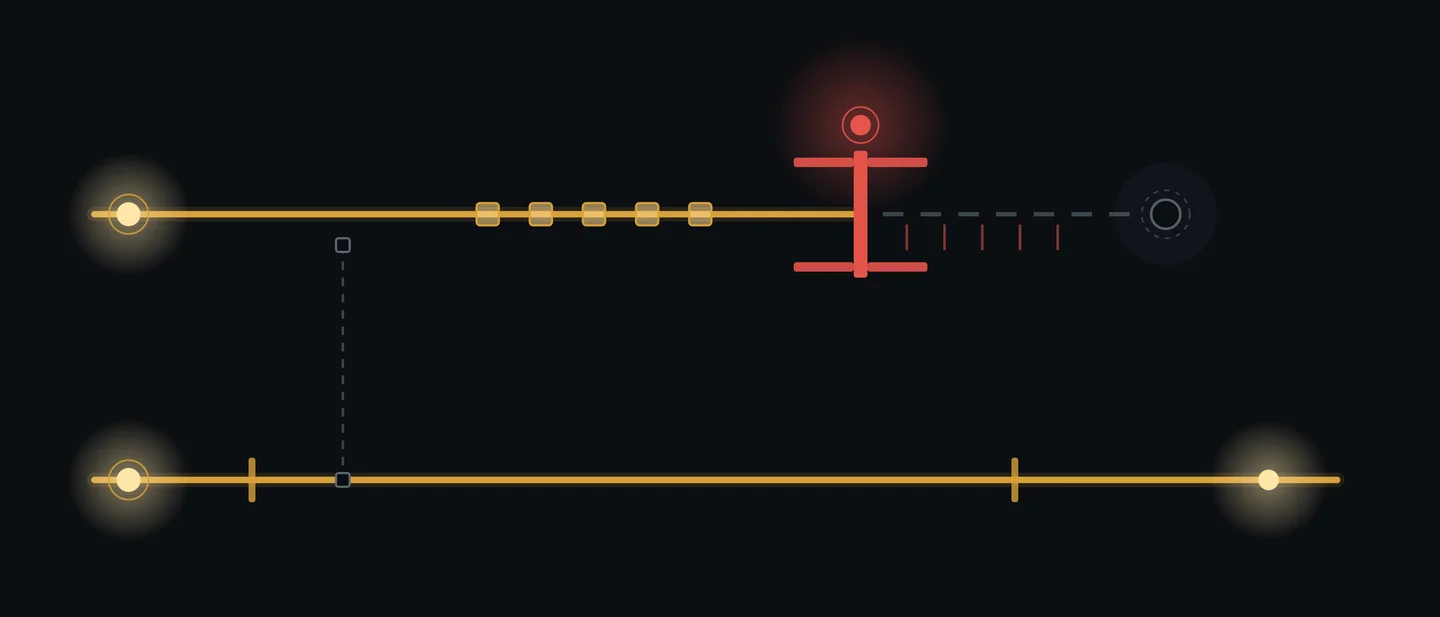
反代把所有人变成 127.0.0.1:管理密钥错 5 次,全站面板一起封 30 分钟
CLIProxyAPI 反代下 trusted-proxies 留空时,五个人共用一个 127.0.0.1 计数器,谁连续输错 5 次管理密钥,全站面板与本机采集就一起封 30 分钟——源码三处定位、三种处置与代价,以及为什么升级解决不了。
11 月 4 日 13:44,一位运维把一份完整的 30 分钟封禁日志贴进了 CLIProxyAPI 仓库。他的部署很常见:Caddy 把 443 转到
https://127.0.0.1:8317,管理面板与本机采集也走这个域名,CPA 的 trusted-proxies 留空1。结果是一句话:经反代进来的每一个管理请求,在 CPA 眼里都来自
127.0.0.1。谁连续输错 5 次管理密钥,这个共享地址就被封 30 分钟,所有人的面板与本机统计采集一起收 403,同一时间模型接口照常返回 200。这段判定从 v8.0.42 留到现在。v8.0.53 的
handler.go 与 dev 分支逐字节相同,升级改不了这里的任何一步2。维护者对这个形态表过三次态,最近一次是 10 月 5 日:内存封禁是「the most secure approach」,重启服务即可清掉所有生效中的封禁,不打算新增解封端点3。本轮这张单到发稿仍然是 0 回复、无标签。
先花十秒确认你中不中招
三条同时成立,你就在这个形态里:
- 面板、采集器或脚本访问的是反代域名(比如
https://cpa.example.com),管理面没有直连 CPA 的 8317。 server段的trusted-proxies是空列表——默认就是空。- 至少一个客户端会周期性拉
/v0/management/*或/v8/management/*,它的密钥可能没配好。
一条命令就能看出前两条:
grep -n "trusted-proxies" config.yaml报障人记下的那 30 分钟
他自己摘的日志,时间是 UTC,我按原样保留状态、时刻与路径1:
[2026-11-04 03:40:42] [info ] 200 | 79ms | 127.0.0.1 | GET "/v0/management/usage-queue?count=100"
[2026-11-04 03:40:42] [warn ] 401 |  0s  | 127.0.0.1 | GET "/v0/management/config"
[2026-11-04 03:40:42] [warn ] 401 |  0s  | 127.0.0.1 | GET "/v0/management/config"
[2026-11-04 03:40:42] [warn ] 401 | 77ms | 127.0.0.1 | GET "/v0/management/config"
[2026-11-04 03:40:43] [warn ] 401 | 79ms | 127.0.0.1 | GET "/v0/management/config"
[2026-11-04 03:40:43] [warn ] 401 | 80ms | 127.0.0.1 | GET "/v0/management/config"
[2026-11-04 03:40:43] [warn ] 403 |  0s  | 127.0.0.1 | GET "/v0/management/config"
[2026-11-04 03:40:43] [warn ] 403 |  0s  | 127.0.0.1 | GET "/v0/management/config"
[2026-11-04 03:40:44] [warn ] 403 |  0s  | 127.0.0.1 | GET "/v0/management/usage-queue?count=100"
...
[2026-11-04 04:10:14] [warn ] 403 |  0s  | 127.0.0.1 | GET "/v0/management/usage-queue?count=100"
[2026-11-04 04:10:44] [info ] 200 | 77ms | 127.0.0.1 | GET "/v0/management/usage-queue?count=100"
[2026-11-04 04:10:44] [info ] 200 | 93ms | 127.0.0.1 | GET "/v0/management/auth-files"
时间线读起来很清楚:03:40:42 队列采集还是 200;同一秒里开始出现 401,五条挤在两秒内;03:40:43 起变成 403,一直持续到 04:10:14;04:10:44 自己恢复。
全程没有重启,也没有人手动解封。恢复这件事本身就是 30 分钟到期的证据。
封禁期内采集端大约每 30 秒重试一次。封禁分支在计数之前就返回,这些重试既不累加计数,也不延长封禁(下面图 B)。
作者另外写明:当时没有 Caddy access log,CPA 日志又只留了回环地址,所以那五次失败到底来自哪台机器、是缺密钥还是错密钥,事后核不出来。
三个原因,都在同一份文件里
第一处是地址来源。中间件用
clientIP := c.ClientIP() 取地址,再用两个字符串字面量判定「本机」:127.0.0.1 与 ::1。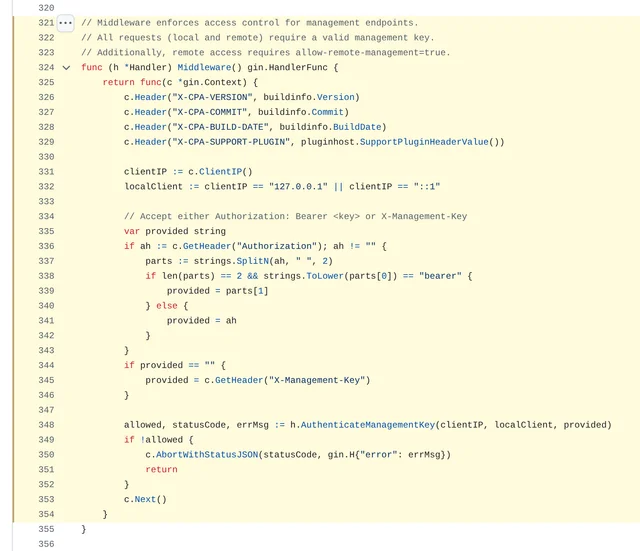
internal/api/handlers/management/handler.go 第 321–354 行:第 331 行取 c.ClientIP(),第 332 行的「本机」判定只有 127.0.0.1 与 ::1 两个字面量,第 348 行把这个地址交去认证。2gin 只有在信任代理时才会采用
X-Forwarded-For。trusted-proxies 为空,ClientIP() 退回 TCP 对端;Caddy 与 CPA 同机,对端恒为 127.0.0.1。于是每个经反代进来的管理请求都被当成「本机」,也都挂在
failedAttempts["127.0.0.1"] 这一格计数上。一个人输错,所有人一起付账。第二处是顺序。封禁检查排在读配置之后、校验密钥之前。
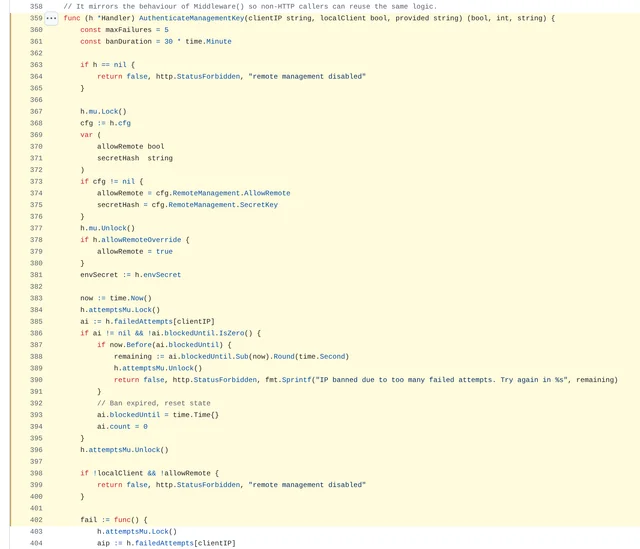
同一文件第 359–403 行:第 360–361 行是
maxFailures = 5 与 banDuration = 30 * time.Minute;第 385–396 行的封禁检查在 !localClient && !allowRemote 判断与密钥校验之前;第 398–400 行才是远程访问开关。5命中封禁就直接 403 返回,正确密钥走不到 bcrypt 那一步。这就是日志里那条 200 出现在 30 分钟之后、而不是出现在有人换对密钥之后的原因。
第三处是什么算失败。缺密钥走
fail() 再返回 401,错密钥也走 fail();只有验证通过才 reset() 清零。计数是连续的,中间任何一次成功都会重新从零开始。反过来说也成立:一个配置错、每次空手请求的采集器,五次就能把整台机器的管理面锁死。
还有两个细节值得记住。
secret-key 留空时整组管理路由返回 404,所以能看到 401/403 的人一定配了密钥。计数存在进程内存的 map 里,重启进程即清空。一个容易踩到的联动:加了 trusted-proxies,反而 403
改这一项之前先看清结果。把 Caddy 所在地址写进
server.trusted-proxies 之后,ClientIP() 拿到的就是真实来源,localClient 随之变成 false。紧接着的判定是:
!localClient && !allowRemote 成立就返回 403 remote management disabled。也就是说,只改 trusted-proxies、不动 allow-remote,会立刻把所有人挡在门外,比原来的共享封禁更彻底。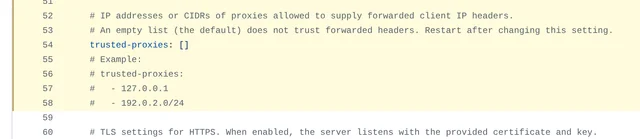
config.example.yaml 第 52–58 行:空列表是默认值,注释写明「does not trust forwarded headers」,改完这个设置要重启服务。4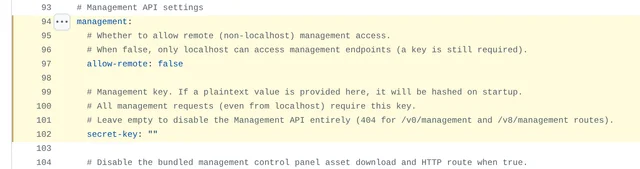
allow-remote 默认 false;secret-key 留空会让 /v0/management 与 /v8/management 整组返回 404。6还有一种省事的写法:用环境变量
MANAGEMENT_PASSWORD 启动。代码在读到非空的这个变量时会把 allowRemote 直接置真,绕过配置里的 allow-remote。这条很关键:若反代不覆盖转发头,信任代理就等于把封禁计数交给客户端随便填。
三种处置,按代价排
- 把面板与采集的上游改成直连 8317。 作者把
cpaBaseUrl从https://cpa.example.com改成https://cpa.example.com:8317之后,连接验证与转发读取都返回 200,采集恢复 running、deadLetters为 01。代价是最小,覆盖面也最小:只隔离了这一个客户端,别人经同一 Caddy 进来照样撞同一个计数器。 - 让 CPA 认得出真实来源。 反代侧确认在传
X-Forwarded-For,CPA 侧写server.trusted-proxies: ["127.0.0.1"],同时打开management.allow-remote(或用MANAGEMENT_PASSWORD启动),改完重启。此后计数挂在真实来源上,一个人输错只封他自己。代价是管理面从此按远程访问走,密钥必须有效,反向代理本身的安全性也要担起来。 - 什么都不改,接受这个形态。 记住两条运维事实:封禁期内正确密钥同样进不去,只能等 30 分钟到期;要立刻恢复就重启进程,计数在内存里。维护者一向的建议是把管理面放在内网或 VPN 后面3。
三条路可以叠着用。第 1 条今晚就能做,第 2 条适合排进下一次变更窗口。
这不是新 bug
六月就有一张单提过同一件事:反代后面缺密钥的请求会触发封禁7。维护者在 7 月 7 日答复后按 not planned 关闭,理由是两条:
Allowing a correct key to immediately clear an active IP ban would weaken the purpose of the ban. … after the configured failure threshold is exceeded, all management key attempts from that IP should remain blocked for the ban duration, regardless of whether a later attempt contains the correct key. This is the
第二段原话到 "This is the" 就截在这里,后半句是对方回复里带出来的延伸;引用时按「超过阈值后,该 IP 在封禁期内一律保持封锁,即使后续带上正确密钥」理解即可。
九月又有一张:CPA Manager Plus 反复出现 IP banned。维护者让面板作者带复现来开新单,随后关闭8。
十月那张是请求加一个清封禁的管理端点,也被判 not planned3。
这次的 #7240 把诉求收窄了两步:他接受 5 次失败、30 分钟封禁的现有规则,只问能否把代理透传的身份用于独立计数,以及能否在诊断日志里区分 TCP 对端、最终采用的 client IP、未被采信的 forwarded IP。
这两条都属于可实现的排障改进,到发稿还没有人回。
本窗口没有版本可升
四个仓库在这一期的时间窗内都没发新版。CLIProxyAPI 的 dev 分支最后一次提交也停在上期发稿之前。
| 仓库 | 当前版本 | 发行时间(北京) | 主干头(北京) |
|---|---|---|---|
| router-for-me/CLIProxyAPI | v8.0.53 | 11-03 20:279 | main 11-03 20:24,dev 11-04 11:18 |
| Wei-Shaw/sub2api | v0.2.19 | 10-28 18:1610 | main 11-02 11:17 |
| icebear0828/codex-proxy | v2.1.23 | 11-03 19:3511 | main 11-03 19:26,dev 11-03 19:35 |
| james-6-23/codex2api | v3.1.3 | 11-04 10:2212 | main 11-04 10:08 |
队列
上期那条「号池耗尽的拒绝」还在走流程。PR 仍是 open、base 是 dev、可合并状态 clean,已经攒到 10 笔提交、51 个文件、新增 1764 行删 61 行,头分支推进到
8663608;自动评审在最新提交上仍有未解决意见13。sub2api 那张旧单今天收尾了。10 月 5 日开的「Anthropic 客户端断连后结算用量」,11 月 4 日 13:35 由作者自己关掉、未合并,头分支被重推后剩 0 提交 0 文件14。
同一件事更早的 #8210 已在 10 月 21 日合并,13 个文件、新增 1728 行删 206 行15。所以这一张算重复单的清理,不用等它。
上游
Google Cloud 最新一条还是 europe-west2 的机房供电事件:10 月 20 日结案,10 月 28 日补了事故报告,本窗口没有新事件18。
Codex 额度这边,今天 UTC 日内还没有重置。最近一次已验证的全局重置在 10 月 28 日 14:35(北京),累计 61 次、仓位里还存着 10 次重置19。
References
- 1CLIProxyAPI 议题 7240:反代下管理认证共享回环 IP
github.com
- 2v8.0.53 的管理认证中间件源码
github.com
- 3议题 6379:请求增加清除管理 IP 封禁的端点
github.com
- 4v8.0.53 的 config.example.yaml 默认配置
github.com
- 5v8.0.53 的 AuthenticateManagementKey
github.com
- 6v8.0.53 的 management 配置段
github.com
- 7议题 4013:反代后缺密钥请求可触发管理 IP 封禁
github.com
- 8
- 9CLIProxyAPI v8.0.53
github.com
- 10sub2api v0.2.19
github.com
- 11codex-proxy v2.1.23
github.com
- 12codex2api v3.1.3
github.com
- 13CLIProxyAPI PR 7239
github.com
- 14sub2api PR 7862
github.com
- 15sub2api PR 8210
github.com
- 16OpenAI 状态
status.openai.com
- 17Claude 状态
status.claude.com
- 18Google Cloud 状态
status.cloud.google.com
- 19codex-reset 追踪
codex-reset.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.