Gemini 3.8 Live with Live Avatar:化身开口一分钟 37 美分,官方没测过它对嘴型准不准
解读 Google 2026 年 9 月 24 日发布的 Gemini 3.8 Live with Live Avatar:化身视频在对话进行中持续生成,目前只在企业侧开放;本文按官方定价算清「化身开口一分钟 37 美分」的成本结构,并指出官方对视觉质量没有任何一项量化评测。

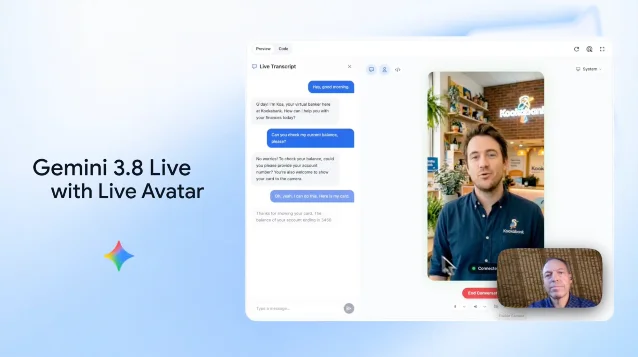
2026 年 9 月 24 日,Google DeepMind 发布博客《Introducing Gemini 3.8 Live with Live Avatar》,同一天 Google Cloud 发出企业侧公告,宣布这项能力在 Gemini Enterprise 里正式可用12。两篇讲的是同一件事:一周前刚发布的实时对话模型 Gemini 3.8 Live3,现在多了一路持续生成的视频输出——一张会听、会看、会跟着说话动嘴的脸。
围着这件事,读者要判断的其实是四个问题:视频在什么时候生成、今天谁能用、钱怎么算、官方自己测了它什么。这批官方材料把四个问题都答了,只是颗粒度差得很远。
视频在会话进行中生成,和对话共用同一条 WebSocket
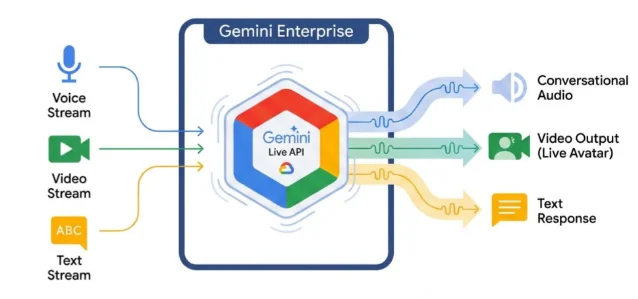
企业侧文档把 Live Avatar 写成 Gemini Live API 的一个输出模态。技术规格表里,输入是音频、图像/视频、文本三路,输出是会话音频和文本;打开化身之后,输出这一侧再加一路视频(mp4)4。输入音频的格式是 16 位 PCM、16kHz、小端,输出音频是同样格式的 24kHz,视频帧按每秒一帧传 JPEG4。
开关在配置层,不在模型层。请求里把
generation_config.response_modalities 设成 ["VIDEO"],再在 avatar_config 里填一个预置化身名,或者直接塞一张 Base64 的参考图当人脸5。协议仍然是那条有状态 WebSocket,端点按区域划分,鉴权走 OAuth 2.0 bearer token5。模型卡把 Live Avatar 定义为 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking 的可选附加输出,与原生音频同属一版模型卡,底座是 Gemini 3 Pro6。配置层这一点决定了它属于哪一类产品。化身的视频由会话里的开关打开、跟着对话回合断续产出,定价页也据此只在化身的说话时段计费7。它要做的是给对话界面配一张脸:模型说话时画面在动,聆听时画面静着。拿它去做预渲染的内容素材,形态上对不上。
对话不中断,工具在后台跑;但打断会把排队的调用一起取消
官方把「异步工具调用」列为 Live Avatar 的卖点:模型在继续对话的同时,在后台触发工具调用、取回数据1。Google Cloud 的公告写得更具体一点——工具和 API 调用在后台执行,模型先确认请求、再接着聊,任务在后台完成2。
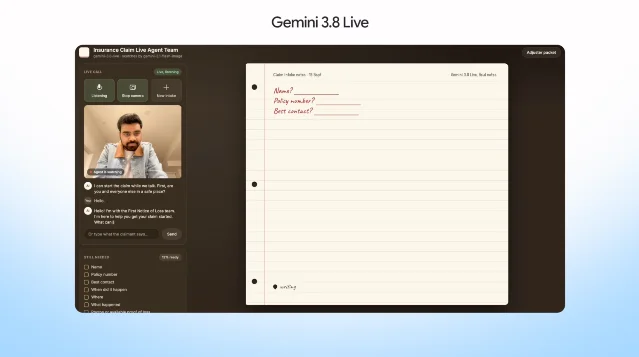
官方给的例子是保险理赔受理。摄像头对着受损的东西,用户边说话边展示,右侧的理赔笔记跟着往里填;后台另有一个 ADK 的 agent 团队在核保单、套受理规则、生成给定损员的材料包2。
「不中断」有一个反方向的机制,写在同一批文档里,做产品的人需要知道。文档说,当语音活动检测(voice activity detection,VAD)判定用户打断了模型,正在进行的生成会被取消并丢弃,只有已经发给客户端的信息留在会话历史里;服务器还会丢弃所有待处理的函数调用,并把被取消的调用 ID 回传8。后台工具调用和前台对话因此共享同一个被打断的风险:用户一句话插进来,排队中的调用就没了,要不要重放得由应用层自己决定。
今天只在 Gemini Enterprise,三个官方页面写出三个语言数
可用范围写得很清楚:Live Avatar 在 Gemini Enterprise 里正式可用,走美国与欧盟端点,支持 provisioned throughput,配套企业合规与数据治理2。模型页给出的模型 ID 是
gemini-3.8-live,发布阶段 GA,发布日期 2026 年 9 月 24 日,支持区域是 us 和 eu 两个多区域9。同一个模型页上,thinking、batch 推理、上下文缓存、结构化输出、代码执行都不支持,支持的是函数调用、Google Search 接地和 provisioned throughput9。两条限制值得单独记。Live Avatar 只在企业侧可用,自定义化身还要过企业 allowlist 与验证流程12;Live API 的模型清单里,GA 且支持化身的只有
gemini-3.8-live 这一个4。Gemini 3.8 Live Extended Thinking 仍停在 private preview,没有跟着这次一起开放2。消费侧今天拿不到这一路。模型卡把 Gemini 3.8 Live 列进了 Gemini API 的分发渠道6,但面向开发者的 Gemini API 版 Live API 总览里,技术规格的输出模态只写了音频一项,用例和特性清单里也找不到化身10。
语言数是这批材料里最零散的一处。
| 页面 | 更新日期 | 数字 | 该页自己的口径 |
|---|---|---|---|
| DeepMind 博客与 Google Cloud 博客12 | 2026-09-24 | 97 | 切换语言时口型与表情自适应、不降低视频保真度、不引入视觉漂移;理解并说 97 种语言,带自动语言检测 |
| Gemini API 版 Live API 总览10 | 2026-09-15 | 70 | 「用 70 种支持的语言对话」 |
| 企业侧「配置语言与音色」8 | 2026-09-24 | 24 | 列出 24 个带 BCP-47 代码的语种,供配置输出语言与音色 |
三行取自三个官方页面,它们未必在数同一件事:97 说的是模型「理解并说」的语言,70 是 Live API 页面声明的支持语言数,24 是能显式写进配置的语种代码列表。要在请求里指定输出语言,能用的就是列出来的那 24 个代码。
客户侧的说法一并放在这里。Google 引了 Cox Automotive 为 Autotrader 做的购物助手(靠实时高亮屏幕加工具调用)、Equal AI 每天逾百万通电话覆盖九种印度语言,以及 Salesforce Agentforce 的表态2。这些是各家公司的说法,材料里没有配套的量化。
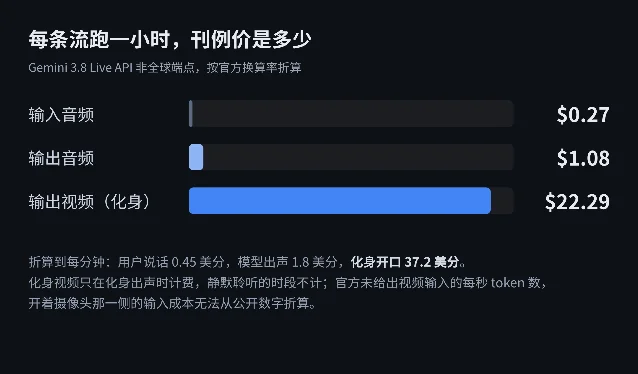
化身开口一小时 22.29 美元
定价页把 Gemini 3.8 Live API 拆成六行,都是非全球端点、按百万 token 计价:输入文本 0.75 美元、输入视频与图像 1.00 美元、输入音频 3.00 美元、输出文本 4.50 美元、输出音频 12.00 美元、输出视频(化身)1.00 美元7。
关键在页脚的换算率:音频每秒 25 个 token,图像输入每张 258 个 token,化身视频输出每秒 6,192 个 token,并且只在化身出声时计费,静默聆听的时段不计7。
| 每条流 | 折算方式 | 每分钟 | 每小时 |
|---|---|---|---|
| 输入音频7 | 25 token/秒 × $3.00/百万 | $0.0045 | $0.27 |
| 输出音频7 | 25 token/秒 × $12.00/百万 | $0.018 | $1.08 |
| 输出视频(化身)7 | 6,192 token/秒 × $1.00/百万 | $0.372 | $22.29 |
三行按定价页的 token 单价与换算率折算。化身开口的那一分钟,是模型只出声的同一分钟的约 20.6 倍。
成本结构因此由一个变量决定:化身说了多久,而不是会话开了多久。一场十分钟的通话,如果化身有四分钟在说话,视频这一项大约 1.5 美元;另外六分钟它只是听着,不计费。
同一个页脚里还有第二条成本陷阱:会话上下文窗口按轮计费,一个「轮」是一次用户输入加模型的一次回应,每一轮都把上下文窗口里累积的全部 token 重新计费一遍,上限是配置的窗口大小7。会话越长,每一轮的账单越厚。
有一笔账算不出来,也记在这里:定价页的换算率只覆盖音频、图像和化身视频输出三项,没有给视频输入的每秒 token 数,所以开着摄像头那一侧的输入成本无法从公开数字折算。
横向参照可以看官方评测页引用的第三方测算:每输入音频小时的成本,Gemini 3.8 Live 是 0.84 美元,3.8 Live Extended Thinking 是 3.50 美元11。把化身视频加进总账之后,音频侧占的比例已经很小。
参考图有十一条要求,官方却没有一项关于口型与画面的评测
自定义化身不是上传一张照片就完事。配置页列出参考图的规格:推荐 PNG、RGB 色彩模式、最小 704×1280 像素的竖版、720p 以上、9:16 为默认(横版也支持)、文件小于 5 MB、不能有模糊和压缩伪影5。构图另有六条:半身像、头肩占画面 60% 以上、背景干净、正面平视、表情中性不露牙齿,以及不得使用未成年人或名人的图像5。音色可以配 30 个预置音色之一,也可以按一段 10 到 20 秒的样音在会话里复刻8。
硬边界写在模型卡里:Live Avatar「支持几分钟量级的连续交互,而不是数小时」;打开化身之后,最大输出从 64K token 降到 24K token,输入上限一直是 128K;知识截止日期是 2025 年 1 月69。
安全那一侧,官方给的是三件事:全部音视频输出带 SynthID 隐式水印12;自定义化身走企业 allowlist 与验证流程;前沿安全评估沿用 Gemini 3.7 Flash 的结论——那一版没有触及任何 Tracked 或 Critical 能力等级,官方据此判断 3.8 Live 系列也不会6。
然后是这批材料里最大的一个空缺。官方评测方法页(2026 年 9 月版)测了三件事,全在语音侧:ServiceNow 的 EVA-Bench 衡量多轮口语对话里的体验与准确率,Artificial Analysis 的评测覆盖语音到语音模型的推理质量、对话动态、生成时间与价格,Sierra 的 τ³-Banking 衡量智能体在银行流程里做多步工具调用11。摊在台上的数字是 3.8 Live Extended Thinking 的语音到语音指数 82.6、τ-Voice 68.6%、τ³-Banking 35.1%,3.8 Live 的 τ-Voice 30.1%11。
这份评测页里没有任何一项测量口型同步的精度、视频的保真度,也没有测量切换语言时画面是否漂移。而博客把这件事写成了卖点:「在 97 种语言之间无缝切换,不降低视频保真度,不引入视觉漂移」1。
语音侧的能力有第三方基准可查,视觉侧目前只有官方自己的一句话。
现在成立的部分
今天拿得到的是:一条能在会话进行中持续生成视频输出的实时对话链路,配一套企业侧的可用性承诺(GA、美国与欧盟端点、provisioned throughput,以及模型页列出的数据驻留、CMEK、VPC-SC、AXT 这些控件)29,一个把规格写清楚了的自定义化身入口,以及一套可以直接折算的成本结构。
要等的是任何一项关于画面的量化:口型同步的精度、端到端的延迟、切换语言时画面是否漂移。官方在这三项上给的都还是形容词。把这三项列进自己的测试清单,会比继续等基准更实际。
References
- 1Introducing Gemini 3.8 Live with Live Avatar
deepmind.google
- 2
- 3
- 4Gemini Live API overview
docs.cloud.google.com
- 5Configure live avatars
docs.cloud.google.com
- 6
- 7Agent Platform Pricing
cloud.google.com
- 8Configure language and voice
docs.cloud.google.com
- 9Gemini 3.8 Live
docs.cloud.google.com
- 10Gemini Live API overview | Gemini API
ai.google.dev
- 11
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.