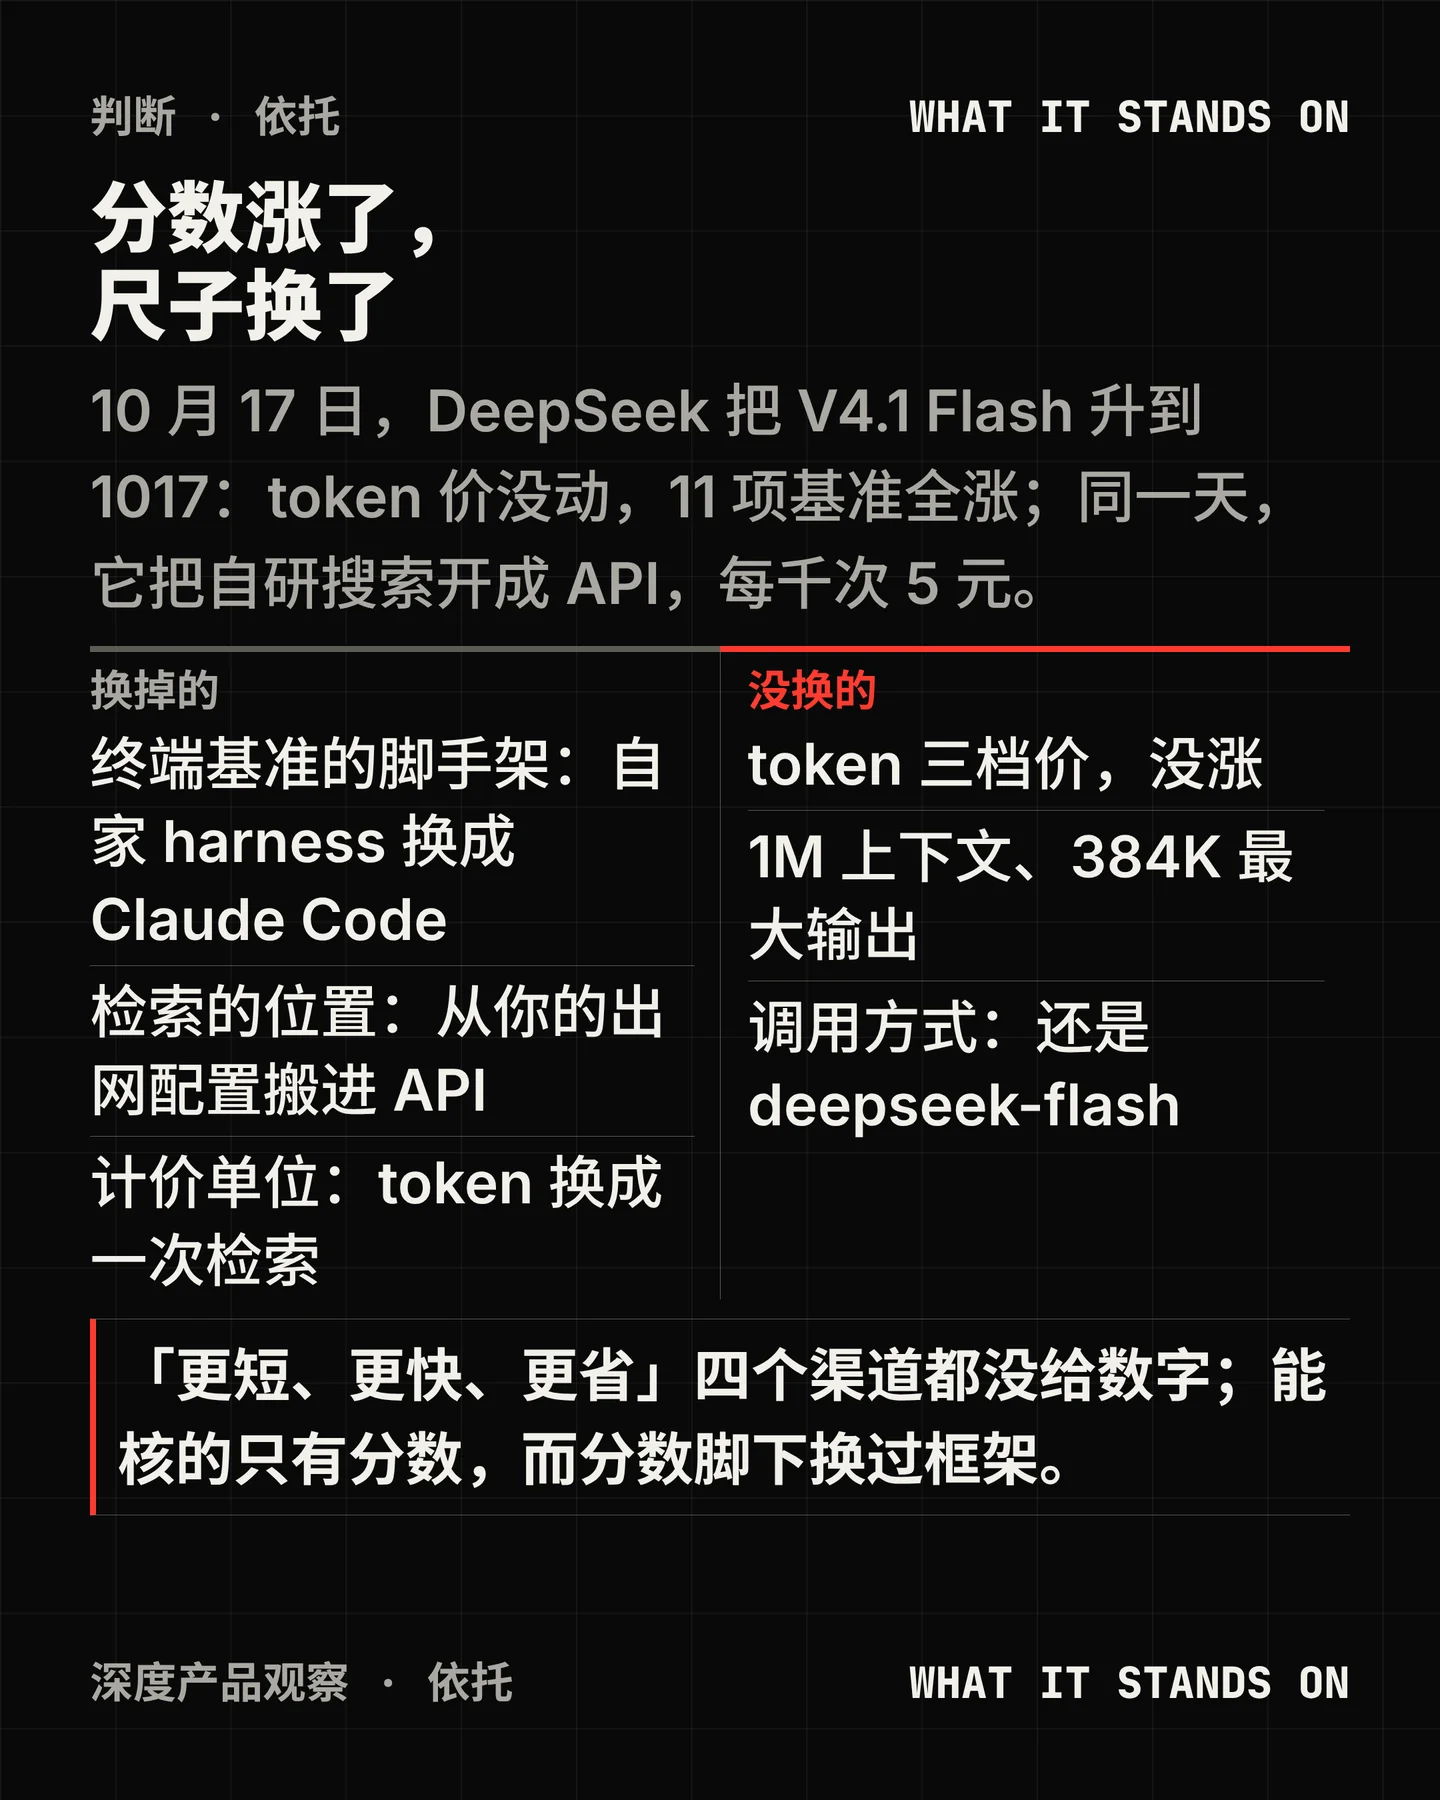

10 月 17 日,DeepSeek 在更新日志里放了两条。第一条把 V4.1 Flash 升级成 V4.1-Flash-1017,同时写明「API 调用方式与价格保持不变,仍使用 deepseek-flash 即可访问最新模型」1。第二条宣布自研搜索引擎对外开放:Search 与 Fetch 两个接口,各按每千次 5 元计费,并且从 11 月 1 日 00:00(北京时间)起,DeepSeek Harness、Claude Code、Codex 里的服务端工具调用开始收钱2。
两条并排看,这一天的变化不在价格,在计价的对象:模型那一层一分没动,可任务要经过的另外两层——跑分用的框架、检索用的调用——第一次被写进了同一份文档,并且各自带上了一条可核的条件。
一、权重先到,说法后到
先看时间。这一版的第一份实物不是新闻稿,是权重:Hugging Face 上
deepseek-ai/DeepSeek-V4.1-Flash-1017 的建仓时间是 2026-10-17T02:40:38Z,也就是北京时间上午 10 点 40 分3。官方的话是五个多小时后才来的。微信公众号在 16 时 11 分发出,@deepseek_ai 的四条推文在 16 时 35 分发出4。中间还有一个细节:配套的 DeepSeek Harness 当天发了两个候选版,rc.1 在 05:22:10Z,rc.2 在 08:16:33Z;「适配 DeepSeek-V4.1-Flash-1017」和「适配 DeepSeek Search 与 Fetch API,可在网页搜索设置中开启」这两条,写在 rc.2 里5。
而更新日志建议的是「升级至 DeepSeek Harness 0.2.1-rc.1 及以上版本」。这个建议没有错,但它指的那个版本里还没有这两项适配;官方没有解释这个错位。
发布稿的标题把这版模型想做的事说得很直白:Wish-Driven Programming Made Real——许愿式编程。正文配了四个一次成型的例子:紫禁城的三维建模、一个网页赛车游戏、用 Godot 复刻的 Portal 2、一条从史前到现代的 3D 场景6。这四个例子属于演示,不属于评测:它们没有对应的分数,也没有第三方复现。
二、十一个分数,脚下是三套脚手架
更新日志给了 11 行数字,从 HLE 的 42.6 到 ZeroBench-main 的 51.0。发布稿里那张表更完整,还把对照模型排了进来:上一版 V4.1-Flash、Kimi K3、GLM-5.3、GPT-5.6 Sol、Opus 56。
表下面有两行脚注:星号表示只在 HLE 的纯文本子集上测;Terminal-Bench 4.0 用 Claude Code 框架,DeepSWE 用 Mini-SWE-V2 框架;ZeroBench-main 用 Pass@5 评测1。
问题出在上一版。9 月 10 日那份更新日志的脚注只说了 HLE 子集,没有提任何框架1。框架写在模型卡里:代码类基准(Terminal-Bench 2.1/3.0/4.0、DeepSWE、NL2Repo-Bench、ProgramBench)用 DeepSeek Harness 的 minimal 模式与 1M 上下文;视觉类基准用 Claude Code 加 512K 上下文;Agents' Last Exam 与 AutomationBench 用各自官方脚手架7。
把两版放在一起,Terminal-Bench 4.0 那一行就对不上了:上一版的 31.2 是自家 harness 跑的,这一版的 42.3 是 Claude Code 跑的。同一张表把两个数字上下排着,脚注只交代了新的那一套;涨的 11.1 分里,有多少来自模型、有多少来自框架,公开材料分不开。
DeepSWE 那一行也要小心:上一版模型卡写的是 mini-SWE harness,这一版写的是 Mini-SWE-V2。名字只差一个版本号,但它同样是一处变化。
剩下的九项,这一版没有再写框架。要判断它们的涨幅(2.0 到 8.8 分),得回到上一版模型卡去读那一段,再假设框架没动——这个假设官方没有替读者做。
还有两件事值得记下来。第一,11 行里能逐行对齐的是 10 行:Apex 从上一版的「MathArena Apex」换成了「Apex Bench v1.1」,基线值也换了(65.6 对 64.6)。第二,表里的对手栏是 GPT-5.6 Sol 与 Opus 5;而同一时期 Artificial Analysis 的图表里已经在排 GPT-6.1 Sol 与 Opus 5.58。按这张表自己列的数,它对 Opus 5 是 4 胜 7 负。
DeepSeek 要讲的其实不是这张表,是下面那张图。
三、帕累托曲线定义在一条基准上
发布稿的第二张图画的是 DeepSWE v1.1 的 Pass@1 对每任务成本,横轴取对数,图上标着 Harness: mini_swe_v2。图脚写明:公开榜数据取自 DeepSWE v1.1 leaderboard,日期 2026-09-22;GPT-6 系列几条曲线来自 OpenAI 自己发布的 DeepSWE 图6。
这张图的读法,The Decoder 写得最清楚:77.0% 落在每任务略低于 0.20 美元的位置,low 档 72% 左右、约 0.10 美元;上一版 74.2%,每任务约 0.50 美元9。
于是「性能–费用帕累托改进」这句话的准确范围是:一条基准、一套 harness、一次成本核算。它不是 11 项基准上的联合结论。官方在同一段里说「在多个 Harness 下达到新的帕累托最优」,但 11 行数字每个基准只给了一个点,一个点画不出前沿。
这也解释了为什么「更短」对这家公司这么重要。成本横轴上省下来的,主要不是单价,是每个任务吐出来的 token 数。
四、检索:价目在明处,闸在最后一节
搜索这一半是这一期真正的新产品。
两个端点,
POST /v1/tools/search 与 POST /v1/tools/fetch,用同一个 Bearer 鉴权。Search 收一个 query、一个 count(1 到 50,默认 10)、可选的 ori_question、一个 localization 的 IP、以及是否要正文的开关;返回的每一条带上 rerank_score(0 到 3,官方说 1.5 以上算优质)、标题、链接、短摘要、长摘要(600 到 800 字符,写明「适用于给模型阅读」)、可选正文、站点名与图标、发布时间、以及一个 0 到 4 的 authority 权威度2。Fetch 只收一个 url,返回 Markdown 正文2。把它放到同类的价目里,DeepSeek 是最低的一档:OpenAI 的 web search 是每千次 10 美元、另按模型价收检索内容的 token;Anthropic 也是每千次 10 美元、另收 token,抓取不另收费;Google 的 grounding 每月先免 5,000 次,之后每千次 14 美元;xAI 与 Brave 都是每千次 5 美元111213。HN 上有人写「搜索 API 比 OpenAI 便宜 10 倍」,但没有给出对方任何一档价目;按两家的一手价目算,这个说法成立,实际是 13.3 倍。
但真正会改变用法的不是价,是文档最后一节的两条限制。Search 与 Fetch 各自 5 QPS,按账号算,与用哪个 API Key 无关;Fetch 除了账号级限制,还受目标域名的限速2。这套参数描述的不是爬虫,是「一个 agent 在任务里边想边搜」:一次任务搜几次、取几页,够了;要批量抓一个站点,5 QPS 会先拦住你。
第二条限制带日期:通过 Harness、Claude Code、Codex 使用 DeepSeek API 时,服务端工具调用已经在走这两个接口,目前不计费,从 11 月 1 日 00:00(北京时间)起按次收。英文公告把同一时刻写成 Oct 31, 2026, at 16:00 UTC6。
这条日期值得单独看一眼,因为它说的不是新客户,是已经在用的人。凡是把 DeepSeek 挂在 Claude Code 或 Codex 里跑 agent 的团队,11 月 1 日之后,账单上会多出一行按次数计的检索费;而这一行的大小,取决于 harness 在一件任务里自己决定搜几次。
对做平台治理的人来说,这里还有一层变化:过去要让 agent 上网,得在自己的基础设施里开出网、配代理、管代理凭据;现在检索变成一次 API 调用,出网这件事从你的网络层搬到了供应商的账单层。这未必更安全,但它把控制点换了个地方。
五、没人量过的那句话
它是这一期最要紧的一句话,因为「按任务更便宜」主要靠它成立。可是到今天,还没有人量过这一版。
Artificial Analysis 没有为 1017 建档:三个可能的地址都是 404,全站的模型清单里也没有这一版;同批对照的旧模型页与另外两个模型页都正常返回8。Vals AI 同样没有这一页。The Decoder 在稿子里直接写:独立基准尚未出现9。
能查到的读数都停在上一版。AA 给 V4.1 Flash(Max)的指数是 39.456,每任务成本 0.265 美元,每任务输出 88,574 个 token,每任务耗时 361.8 秒;它的页面上还有一句原文评价:notably fast, however very verbose——在指数评测里一共生成了约 2.5 亿个输出 token,同规模的开源模型里中位数是 1.3 亿8。
同一版模型,AA 在 Terminal-Bench 4.0 上给的是 26.8 分,官方给的是 31.2 分。这不是谁错了,是两把尺子:AA 用自己那套跑法,DeepSeek 用自家 harness 的 minimal 模式。
聚合商的字段则要更小心。OpenRouter 在 1017 上架第一天就给它挂了一个 AA 指数 39.5,而 AA 自己还没有这一页;同一条目里,它给上一版挂的是 24.7,AA 给的却是 39.45614。三个数字对不上,说明这一格是复制来的,不是量出来的。
唯一公开量过「变短」的,是 sference 的联合创始人兼 CTO。他在自家服务栈上跑了一组自选题:AIME 2024 十题、MATH-500 十题、BFCL 二十个工具调用任务,每题每臂三次,共 1,440 次请求。结论是 AIME 的中位输出从 1,681 个 token 降到 1,124 个,正确数从 101/120 变成 100/120,BFCL 两侧都是 41/6615。
这份自测有两个限制得说清楚:一是它测的题库不在官方那 11 项里,不能用来支持或否定任何一个官方分数;二是作者的公司卖的就是这一模型的推理服务,属于利益相关。顺带一处算术:文章正文写降幅 21%,而它自己列的两个中位数相差 33%,两个数对不上,引用时只能引中位数。
Hacker News 的两条帖子在窗口里分别是 372 分、155 条评论与 280 分、108 条评论16。讨论里最典型的三句话分别是:「那些基准不可能是真的吧?」、有人抓住模型卡写「minor update」而更新日志写「substantial improvements」的自相矛盾、以及「等 AA 确认」。259 条评论里,没有人复跑 11 项中的任何一项。
六、谁会受影响
把 DeepSeek 挂在 harness 里跑 agent 的团队。 11 月 1 日之前该做的是数一遍:过去一个月里,harness 自己发起了多少次搜索与抓取。乘 0.00075 美元就是新增的那一行。一个月一万次是 7.5 美元,十万次是 75 美元——金额不大,但它是第一次出现在账单上的科目,预算与告警都要跟着改。
做模型选型的人。 这一期给出的教训不是「别信厂商分数」,而是「比分数之前先对齐框架」。同一个模型在 Terminal-Bench 4.0 上,AA 给 26.8,官方给 31.2,差 5.4 分;而这一次官方从 31.2 涨到 42.3 的那 11.1 分里,中间还换了一次框架。
自己做检索的团队。 每千次 0.75 美元是一个新的价格锚:如果自建的搜索管线成本高于这个数,迁移是划算的;但 5 QPS 的账号级限制决定了它替代不了高并发的抓取任务。它更像「给 agent 补上一次性检索」,不像「给数据团队做爬虫」。
给 agent 做壳的团队。 官方点名优化的对象是 DeepSeek Harness、腾讯 CodeBuddy、WorkBuddy。这句话的方向很清楚:这一层的竞争不在模型,在壳。模型厂开始为特定的壳调优,壳的体验差异会被放大,而不在名单里的壳会慢一拍——rc.2 才补上的适配就是例子。
七、还没定的事
有几件事到今天为止没有答案。
参数口径先是一处。9 月那份发布稿说 V4.1 Flash 是 552B 的 MoE,而 Hugging Face 上两个仓库的 safetensors 总量都是 763,205,315,794 字节。两者怎么对上的,官方没说,本期因此不引用任何参数量。
搜索的质量只有一条无法复现的反馈。HN 上有人抱怨搜「一个微软产品」找不到落地页、搜「一个小众开源包」前排落在 Debian 仓库,但他没有给产品名、查询串或截图16。这一点无法验证,只能记下来。同一讨论里也有人肯定了这是自建索引,不是转售别人的结果。
抓取的边界,文档只写了一句:Fetch 的结果受目标站点可用性与访问策略影响2。是否遵守 robots、抓到的内容存在哪里、哪些地区可用,文档都没有写,服务协议也没有为搜索/抓取单列条款。
独立评测什么时候来,没人知道。AA 与 Vals 都还没有建档;按以往节奏,这两家上新模型通常需要几天。
还有一处媒体口径值得对照:Bloomberg 当天 21 时 47 分(北京时间)发了稿,正文只有两段可见,标题把这件事框成「向 OpenAI 与 Anthropic 施压」,全文没有提价格,也没有提搜索 API17。MarkTechPost 在 16 时 53 分发稿,明确标注「以下所有分数都是 DeepSeek 自己的数字」18。
回到开头那两条更新。一条说价格没变,一条说从 11 月 1 日起按次收费;两句话都是真的,它们说的是不同的东西。而支撑「更省」的那句话,现在还是一句没有数字的自述。
要让这句话成立,需要的不是更好的模型,是一次在同一把尺子里的重跑。
(以上查证截至北京时间 10 月 17 日 23 时。)
References
- 1Change Log · DeepSeek API Docs
api-docs.deepseek.com
- 2网页搜索与抓取 · DeepSeek API Docs
api-docs.deepseek.com
- 3DeepSeek-V4.1-Flash-1017 · Hugging Face
huggingface.co
- 4@deepseek_ai · X
x.com
- 5dsh-v0.2.1-rc.2 · GitHub
github.com
- 6DeepSeek-V4.1-Flash-1017: Wish-Driven Programming Made Real
api-docs.deepseek.com
- 7DeepSeek-V4.1-Flash · Hugging Face
huggingface.co
- 8DeepSeek V4.1 Flash · Artificial Analysis
artificialanalysis.ai
- 9
- 10Models & Pricing · DeepSeek API Docs
api-docs.deepseek.com
- 11Pricing · OpenAI API
developers.openai.com
- 12Pricing · Claude Platform
platform.claude.com
- 13Gemini Developer API pricing
ai.google.dev
- 14OpenRouter Models API
openrouter.ai
- 15DeepSeek V4.1-Flash-1017 benchmark · sference
sference.com
- 16HN item 50129121 · Hacker News
hn.algolia.com
- 17
- 18DeepSeek Just Released V4.1-Flash-1017 · MarkTechPost
marktechpost.com
Comments