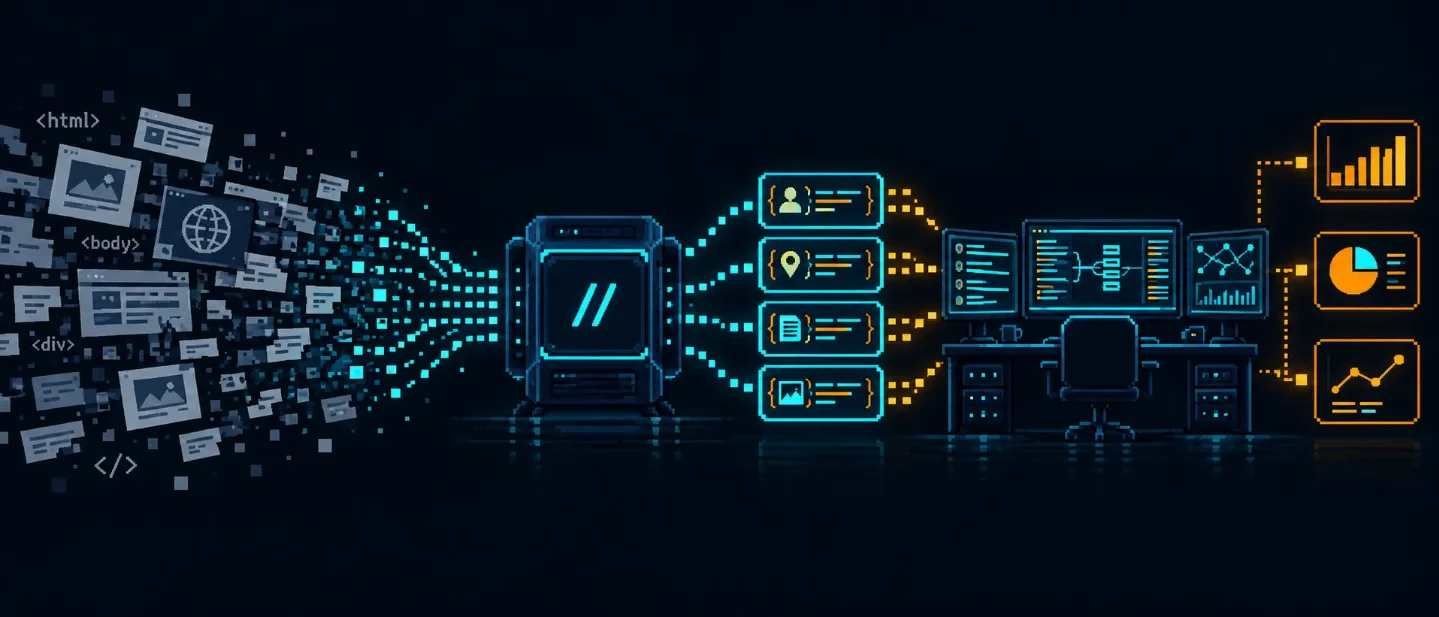
Anysite.io:把网页解析留在服务端,给 Agent 喂类型化实体
Anysite.io 将网页抓取与解析全部收敛在服务端,通过 MCP 协议向智能体直接交付类型化实体,并坚持由 Agent 自主掌控调度与分发,为 AI Agent 的外部数据摄入提供了轻量解法。

Anysite.io 是一款面向 AI Agent 与 RAG(检索增强生成)系统开发者的实时网络数据层工具,支持通过 Anthropic 提出的 MCP(Model Context Protocol)协议与标准 REST API 进行接入。在当前生成式 AI 应用的实际研发中,开发者经常需要让大模型或自主智能体获取最新的外部公开网络信息,例如分析目标企业的最新员工规模、监控竞品官网的价格微调、或者抓取指定行业高管的最新动态。传统的接入方案通常让智能体调用浏览器或网页爬虫,将整页的原始 HTML 或 Markdown 文本塞回大模型的上下文窗口,再由模型自行提取关键字段。Anysite.io 在服务端持续维护了覆盖商业情报、社交平台、招聘网站和垂直目录等 650 多个数据源的 3,500 多个端点,让开发者只需在 Claude Code、Cursor、OpenCode 或自定义智能体中配置一条 MCP 连接,就能通过自然语言向智能体发起数据请求,实时获取结构化的结果。12
当 AI 系统从单次对话走向端到端自主执行任务时,外部数据的摄入方式直接决定了智能体的稳定性与计算开销。如果直接把未清洗的网页标记推给大模型,庞大的网页导航栏、脚本代码和修饰性文本会迅速吞噬宝贵的上下文 token 预算;一旦目标网站调整前端排版,模型在长文本中提取字段的准确率也会出现明显波动。此外,许多商业数据工具试图将自身设计为全功能的自动化流转平台,要求用户开放下游系统的写入权限,反而增加了企业在权限管控与系统集成上的阻力。Anysite.io 在数据供给方式与系统权责划分上采取了克制的设计。
亮点一:给 Agent 喂类型化实体,而非原始网页标记
传统网页阅读类 AI 工具的核心交付物通常是整页文本。当智能体想要查询某家软件公司的团队规模与融资轮次时,传统的爬取工具会抓取整个目标页面,将数万字符的 HTML 标记推入模型。模型必须在运行中分配推理注意力,逐行过滤掉页面底部的版权信息、推荐链接和样式代码,再尝试拼装出结构化信息。这种交互模式使模型极易受到无关文本的干扰,甚至因为前端改版而产生幻觉。
Anysite.io 改变了智能体与外部数据交互的数据粒度。该工具将网页抓取、字段解析、多源去重和数据清洗完全收敛在服务端基础设施内部,向智能体直接输出具有固定契约的“类型化实体”(Typed Entities)。1
这一决策改变了智能体处理外部数据的几个关键环节:
- 消除运行时的模型解析步骤:当用户在 Claude Code 或 Cursor 中询问“获取这 200 个域名的公司员工规模与融资轮次”时,Anysite.io 的服务端会自动匹配对应端点,并直接返回包含 company、headcount、funding 等明确字段的紧凑 JSON 格式。智能体的推理过程无需再包含“从 HTML 中解析字段”的中间步骤,拿到数据即可直接执行筛选或比对逻辑。1
- 屏蔽前端改版的破坏性冲击:公开网站的页面布局与反爬策略往往频繁变动。Anysite.io 将布局适配与反爬对抗的维护工作隔离在服务端;只要底层字段映射完成适配,暴露给智能体的 JSON 数据模型就保持不变,保障了长期运行脚本的确定性。1
- 计费与 Token 消耗解耦:传统的网页检索模式按消耗的上下文 token 产生成本,抓取一个结构冗余的复杂网页往往烧掉数万 token。Anysite.io 在服务端将数据过滤汇聚,智能体接收到的是极高信息密度的纯粹记录,数据调用的成本与返回的具体数据条数挂钩,避免了由于网页前端代码膨胀而意外拉高模型的推理开销。1
这种预设实体的机制存在明确的使用前提。Anysite.io 依赖服务端提前建立的 3,500 多个端点规范;如果用户需要采集非常小众、且缺乏通用结构映射的偏门网页,系统仍需提供让智能体读取网页原始 URL 的备用通道。此外,在 MCP 客户端中一次性挂载过多工具描述也会占用智能体的初始上下文空间,实际使用中需要根据具体任务按需开启对应分类的端点。1
亮点二:坚持做被动数据层,把调度与动作执行交还给 Agent
许多数据工具在拓展 AI 功能时,倾向于把自己重构为全流程自动化平台:在产品内部内置定时器、邮件发送器以及针对各类 CRM 系统的原生集成面板,试图接管从数据采集到业务落地的整条链路。这类设计常常导致产品形态极其臃肿,而且要求企业为该平台赋予深度的外部系统写权限,引入了额外的合规审查风险。
Anysite.io 在产品定位上做出了明确的收敛:坚持作为纯粹的被动数据供给层,将任务调度与下游动作执行的控制权全部交还给智能体宿主环境。3
在这一交互模式下,各组件的职责边界得到了清晰切分:
- 调度留在 Agent 侧:Anysite.io 内部没有内置定时任务调度引擎。如果团队需要实现“每个工作日早晨监控 5 家竞品官网的价格变动”,这一调度逻辑由 Claude 的计划任务、系统的 CRON 脚本或宿主智能体自身的定时器来管理。触发时刻到达后,由智能体主动调用 Anysite.io 的 MCP 工具获取数据。3
- 分发动作由 Agent 闭环:当智能体取得结构化变更数据后,如何消费这些数据完全取决于用户的指令。用户可以让智能体将新增客户名单写入企业的 Google Sheets,也可以调用企业内部已有的 Slack MCP 发出警报,或者同步到 CRM 系统中。Anysite.io 本身完全不接触用户的下游业务系统,无需获取任何外部写入凭证。3
- 降低安全暴露面:由于数据层只提供只读检索能力,企业在为智能体引入外部数据时,不需要向第三方数据服务商开放内部数据库或通信频道的权限。所有关于“何时抓取”与“抓取后写入何处”的安全审计,都集中在用户本地或私有受控的智能体编排层。3
这种设计的代价是提高了初始运行的门槛。用户必须在一个具备完整工具调用能力和调度环境的智能体中工作。如果用户的环境本身缺少写入 Slack 或 CRM 的集成扩展,单纯使用 Anysite.io 只能在对话窗口中查看 JSON 记录,无法由数据工具直接代劳后续的流转操作。3
让数据基础设施回归清晰的协议边界
面向智能体的数据产品展现了一种不同的设计取向。在人机交互时代,工具软件往往通过复杂的表单、筛选器和导出引导来辅助人类决策;而在 Agent 时代,数据基础设施更需要关注机器消费的便利性。通过服务端实体化抹平格式噪声,并主动放弃对调度与执行环节的越权包办,工具能够在保持极简架构的同时,更稳固地嵌入到现代智能体的组合式工作流中。
References
- 1
- 2
- 3Go-To-Market on Live Web Data — Anysite
anysite.io
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.