Claude 主导 26% 的 Anthropic 研发任务,这个评分也是 Claude 做的
Anthropic Institute 公开三组内部研发指标:Claude 主导 26% 的模型研发任务、3 万个内部 agent 的 0.002% 动作被拦下、安全研究拿到 AI 研发算力的 6%;这篇把三个数字各自的分母、观察窗口与自评校验拆开。

Anthropic Institute 在 9 月 17 日公开了一组测量指标,用来描述前沿实验室内部研发的节奏。正文给读数,附录给做法。1
这份页面上没有机器可读的发布时间,9 月 17 日取自 Anthropic 研究页的精选卡片。
正文有三组读数,数据截至 2026 年 8 月。
Claude 主导了 26% 的模型研发任务;内部约 3 万个 agent 的动作里,0.002% 在执行前被拦下。
流向 AI 研发的算力里,约 6% 给了安全。1
三个数字看着可以并排,分母却各不相同。第一个的分母是一棵树。
「主导」是「协作」再往上走一档
Anthropic 借用 Epoch AI 的自动化量表,从 AL0 到 AL5 共六档。2
AL3 叫协作:人在旁边盯着,Claude 能做大块工作。AL4 叫主导:给一句高层提示,Claude 把任务基本做到尾,人只做监督。1
官方脚注给了一个能对上的场景。夜间数据管道坏了,第二天早上要跑。
AL3 下,工程师带着日志和猜想去找 Claude,中途冒出问题由工程师决定怎么绕过去。
AL4 下,工程师把告警丢给 Claude 就去忙别的。Claude 自己查日志、定位、写补丁、测完,再写一份改动说明交回来;部署这一步仍由人按。
26% 是跨过 AL3 与 AL4 之间那道线的部分。
同一次测量还给了两个数:协作档及以上超过 90%,全自主档一个都没有。1
26% 与 90% 是同一张图上的两段。90% 里的大半仍停在协作档,26% 是已经交出去、人只做监督的那一段。
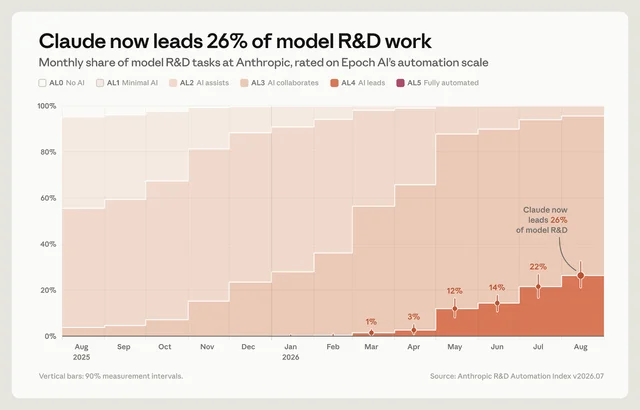
官方图。橙色是「主导」档的月度份额,图上标了 3 月 1%、4 月 3%、5 月 12%、6 月 14%、7 月 22%、8 月 26%;竖线是 90% 测量区间。
图上的区间值得读一遍。相邻两个月的区间互相重叠,单月的涨落读不出信号。
2 月的不到 1% 与 8 月的 26% 之间,区间够不着。趋势成立;逐月的台阶落在区间里,读不出独立信号。
这个评分由 Claude 完成
任务树是自下而上搭的。2026 年 7 月,每周从模型研发各部门抽 20% 员工。
一个 Claude 研究 agent 读这些人的 Slack 与内部文档,列出当周做过的任务。1
四周下来约 15,000 条任务。再用 Claude 归成一棵树,542 个节点,其中 378 个叶子。
叶子的名字很具体,比如「评估平台缺陷诊断与修复」「RL 沙箱出口与网络策略」。1
这棵树被冻结。以后每期都对同一篮任务打分,指数才可比。
权重按人时算:每人每周 1 单位,按当周任务数均分。做四个任务,每项 0.25;做十个,每项 0.10。1
打分分两步。一个 Claude agent 先深挖每个节点「谁在做、用什么工具、AI 占多少」,另一个 Claude 判官读完证据再给档。1
校验靠人。模型与人的精确一致率是 59%,人与人之间是 35%,97% 的评分落在同一档或相邻一档。1
官方把 59% 与 35% 概括成「差不多」;两个数之间隔了 24 个百分点,量级的意思要读者自己拿捏。
59% 还意味着,在约四成的节点上,模型给出的档位与某位人类有出入。分歧集中在协作与主导的交界。
冻结的代价官方也写了:指数上升说明 2026 年 7 月那批工作正在被自动化,人有没有把新冒出来的工作接过去,指数答不了。1
他们拿 2026 年 1 月的树做了对照,比对 2 月到 7 月每月新增的「新任务」,数量没有上升。1
三万个 agent,0.002% 的分母是决策
2026 年 8 月,Anthropic 最常用的一个内部平台上,任一时刻约有 30,000 个 agent 在做研发与工程工作。1
这些动作走两条通道,一条在事前,一条在事后。
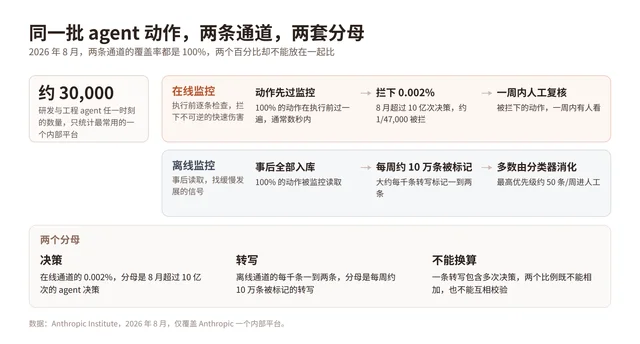
在线监控在执行前逐条检查,管的是不可逆的快速伤害,比如把模型权重拷出系统。1
2026 年 8 月,这套监控看了超过 10 亿次决策,拦下 0.002%,约 1/47,000。被拦下的动作一周内有人复核。1
离线监控在事后读取,找的是慢慢发展、还能挽回的行为,比如失准的迹象。1
全部动作都进库。每周约 10 万条转写被标记,量级是每千条一到两条,多数由分类器消化,最高优先级的约 50 条/周进人工。1
两条通道靠两个设计撑住。每个 agent 有独立身份,身份不随底层模型更换而中断,每条数据都能追回具体 agent。1
agent 之间的通信走公开消息系统,每条消息带发送者身份、可引用原始材料,也能和转写对上。1
官方把监督读数的出处指向 8 月的风险报告。那份报告的覆盖日期是 2026 年 7 月 15 日。3
这里的三万 agent 与 0.002% 是 2026 年 8 月、一个内部平台的读数,对象与窗口都另算。
一周算力里 6% 给了安全
算力那组的窗口短得多:2026 年 7 月 13 日至 20 日,一周。1
全部算力先按用途分桶,再看流向 AI 研发的那部分里,安全占多少。两个读数:6% 与 12%。1
前者读作「安全占 AI 研发算力」,后者读作「安全占 AI 驱动的 AI 研发算力」。分母小了一截,比例就翻倍。
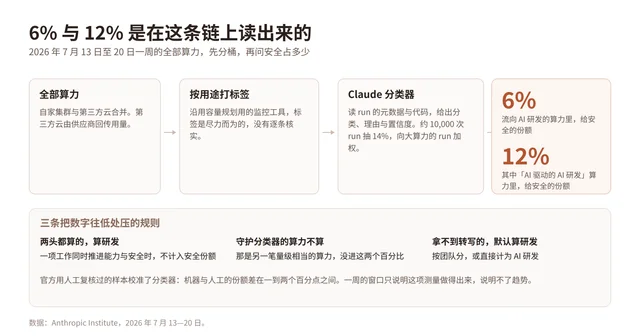
这套口径刻意偏保守。同时推进能力与安全的工作,按 AI 研发计。1
守护分类器吃掉的那笔算力量级相当,没有进这两个百分比。1
方法上是拼装。沿用容量规划用的监控工具,标签尽力而为;第三方云的用量由供应商回传。1
约 10,000 次 run 抽了 14%,并向大算力的 run 加权,让结果跟着算力走,而非跟着 run 数量走。1
拿不到 agent 会话语料的,按用户所在团队分类,或者直接计为 AI 研发。1
最难的一步是划线。官方举了可扩展监督:这类研究既让未来的模型更对齐,也让当前的模型更好用。1
他们写了一份带边界案例的定义,把分类器与人工的份额差压到一到两个百分点。仍有案例几个人工审了几小时也定不下来。1
激励问题官方自己也点了:安全与能力的界线由开发者画,每个开发者都会想画得宽松。1
对策是把举证责任放到开发者身上,并先就定义达成共识。裁决机制没有给出。
这三组数字在政策线里的位置
同一个 9 月,Dario Amodei 写了《We Must Pace the Frontier》,主张放慢能力提升,让风险防范跟上。4
三步走的第一步是嵌入式第三方评估者:给出接近员工权限的访问,核实安全实践、报告事件、评估训练流程。Anthropic 说这一步它单方面先做。4
官方这篇把评估者的活儿写得更具体:核实安全实践、报告事件、监测这里的关键指标。1
两处表述逐项对得上:这组指标就是那次承诺里要监测的东西。
再往前一步是 6 月的《Advanced AI Framework》提案。它给的透明度义务是安全框架、系统卡、至少每半年一份风险报告。5
那三样讲的是模型能做什么、风险怎么管。这组指标补的是模型怎么被造出来。
第三方核验现在走到哪一步?公开的是意图与口径。15,000 条任务和 10 亿次决策,还没有外部机构复跑过。
已有的独立工作是 METR 对离线监控平台做过红队。1
红队测的是这套平台能不能被绕过;这里的读数测的是平台看到了什么。
三项指标的口径对照
| 指标 | 读数 | 分母 | 窗口 | 谁分类 | 复跑要什么 |
|---|---|---|---|---|---|
| 研发自动化 | 主导 26%,协作及以上超 90%,全自主 0 1 | 按人时加权的冻结任务树,约 15,000 条、542 节点 | 2026 年 8 月;序列自 2025 年 8 月 | Claude agent 取证,Claude 判官给档,人类校准 | 同一棵树与同一批档位判定 |
| agent 监督 | 覆盖率 100%;在线拦下 0.002%;离线每周约 10 万条标记、约 50 条进人工 1 | 在线以决策计,8 月超过 10 亿次;离线以转写计 | 2026 年 8 月 | 在线分类器、离线分类器、人工复核 | 接入同一平台的动作日志 |
| 算力去向 | 安全占 AI 研发算力 6%,占 AI 驱动研发算力 12% 1 | GPU 时间,按用途分桶 | 2026 年 7 月 13 至 20 日 | Claude 分类器,抽 14% 并向大算力加权 | 重跑分类器与抽样 |
缺口
缺口有四处。任务树冻结在 2026 年 7 月,三组数据都来自一家公司。
监督与算力各只有一个窗口,算力那组只有一周。
判官与分类器用的都是自家的 Claude。1
其中最硬的一条官方自己写出来了:用自家模型评自家系统,判官可能犯与被评系统同类的错。1
跨实验室对照要等两样东西:一份共用方法,一次由第三方或别家模型做的判定。1
在此之前,26%、0.002%、6% 都只是 Anthropic 一家的自述。它们的分量在口径:写到了别人可以照着做的程度。
往后要看的是同一件事:嵌入式评估者进驻之后,这三项能不能从自述变成别人能复跑的读数,别家实验室愿不愿跟着报同一组。
对正在部署 agent 的团队,这套量法可以直接搬。动作的监控覆盖率、标记到复核的延迟、拦截与升级的比例,三项都带上分母。
References
- 1
- 2Toward an O*NET for AI R&D
epochai.substack.com
- 3Redacted Risk Report August 2026
www-cdn.anthropic.com
- 4We Must Pace the Frontier
darioamodei.com
- 5Advanced AI Framework
www-cdn.anthropic.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.