Genie 4 的世界由三个模型分工,而分辨率、帧率、时长一个数都没给
Genie 4 把外观、判断和画面分给了三个模型,发布材料里却第一次没给分辨率、帧率、时长任何一个数;本篇把两代官方页面逐栏对照,指出真正翻倍的只是产品会话长度,模型那句「几分钟」十四个月没有动。

Genie 这一代真正加的是声音和人的动作;「记得住多久」这一条,和上一代几乎一字不差。
10 月 27 日 16:13 UTC,北京时间 10 月 28 日 00:13,Google DeepMind 发布 Genie 4。1
一句话说清它是什么:给一段文字或一张图,实时生成一个能走进去、能改、这一代还能出声的世界。
比发布早两分多钟,@GoogleDeepMind 先发了预告帖。2
近八小时后,Demis Hassabis 转发并写下一句:「Simulations within simulations, makes you wonder just how deep the rabbit hole goes...」3
又过两分钟,他补了一条:已经开始向受信测试者开放,更广的访问「coming soon」。4
这份发布材料最反常的地方,是一个规格数字都没有。
一年多前 Genie 3 的发布页,第二段就把话说满了:实时导航、每秒 24 帧、720p、一致性维持几分钟。5
同行的发布页都在给数。
Runway 的 GWM Worlds 2:连续 720p、24 fps、48000 Hz 音频。7
Decart 的 Oasis 3:22 fps、512×768×3、延迟 200 毫秒以内。8
Genie 这一线自己上次也给过数。今年 1 月 Project Genie 上线时,公告写得很具体:单段生成限制 60 秒。9
所以得先把这件事记下来:Genie 这一线,第一次一个数都不给。
01 三个模型,各管一段
官方对架构的交代,核心是两句。
第一句:「Genie 4 模型吸收并建立在 Gemini 家族的能力之上:Gemini Omni 把模拟锚定在真实世界的外观与行为上,其他 Gemini 模型提供维持模拟连贯与连续所需的复杂推理。」1
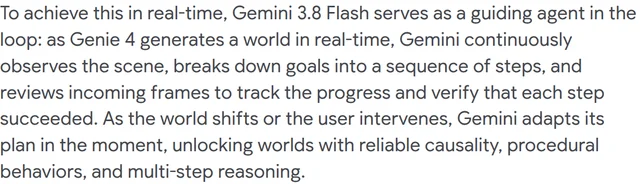
第二句点了名:「为了实现实时,Gemini 3.8 Flash 在回路里充当引导代理:Genie 4 实时生成世界的同时,Gemini 持续观察画面,把目标拆成一系列步骤,并检查进来的帧,追踪进度、确认每一步是否成功。」1
Gemini Omni 是什么,官方页面写得很直白:把 Gemini 的推理接到生成上,从任何输入生成内容,先做视频。10
Gemini 3.8 Flash 是 9 月 2 日发布的模型,离这次发布不到两个月。11
把这两句放在一起看,跑起来的不止 Genie 4 一个:Omni 管「像不像真的」,3.8 Flash 管「这一步对不对」,Genie 管「画面和声音」。
有一处官方没说清:Omni 是在生成世界的那一刻起作用,还是每帧都在起作用。
「锚定」这个词可以指开局定一张参考帧,也可以指全程约束外观。发布材料没有交代。
能确定的是那个引导代理:它盯着进来的帧看。
这个安排在简报会上被说得更直接。据 TechCrunch 记录,研究负责人 Tejas Kulkarni 的原话是:「未来我们会越来越多地看到混合世界模型,Gemini 写代码和文字,Genie 实时接收,在不同抽象层次上模拟现实。」12
官方博客的「未来工作」一节写的是同一件事:把代码和语言模型的逻辑推理,与像素级模拟的感官表征合起来。1
这条路的出发点是像素,恰好是 Yann LeCun 反对的那个出发点。
2024 年 2 月,他写过:「从提示生成看起来逼真的视频,并不表示系统理解了物理世界。生成与世界模型的因果预测,是两件很不同的事。」13
而 Genie 4 这篇发布稿排在最前面的署名者,是他的学生。
Raia Hadsell 是 Google DeepMind 的研究副总裁,2014 年加入,现在共同领导 Frontier AI 团队。
她在 NYU 的博士由 LeCun 指导,论文做的是越野机器人的长距离视觉。14
DeepMind 的答案是各让一步:像素交给 Genie,判断交给 Gemini。
这一代承认了一件事:像素里的物理,需要另一个模型来把关。
02 两代页面,写了什么、没写什么
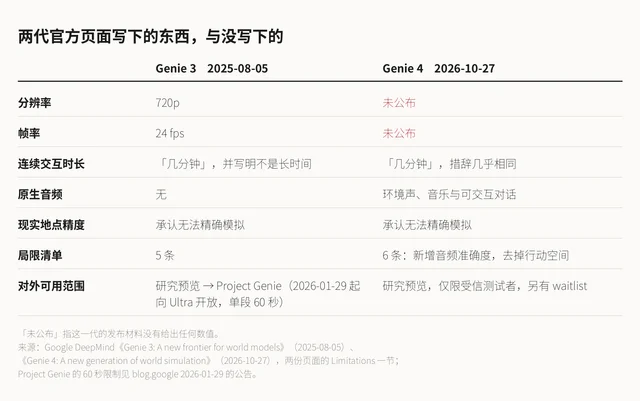
上一代把三项指标写进了正文:24 帧、720p、几分钟。5
这一代一个数没写。
不给数,但给了说法:官方称这一代最明显的一处进步是模拟人——人物动得自然、对环境有反应、能实时被操控。1
模型页写的时长,和产品给的时长,从来不是一个数。
Genie 3 的发布页写的是:「几分钟的连续交互,而不是数小时之久。」5
Genie 4 的模型页写的是:「几分钟的连续交互,而不是长时间会话。」6
两句只差一个词。
所以真正翻倍的是产品那一栏,从 60 秒到两分钟。Ars Technica 报道里的说法是「两分钟」,并加了一句:跑过两分钟,世界就忘了自己开头是什么样。17
产品那一栏翻了一倍;模型那一栏,那一句「几分钟」十四个月没有动。
03 官方自己列出的六条
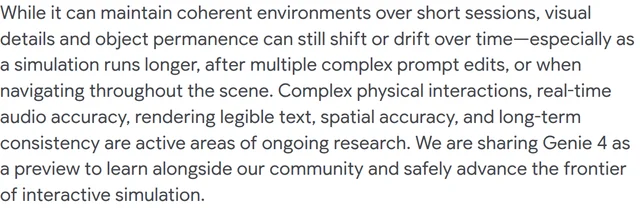
模型页的局限清单列了六条。6
视觉细节与物体恒存会随时间漂移;多智能体与共享环境的交互仍是研究难题;无法精确还原真实地点;可读文字通常只在输入描述里出现过才生成;只能撑几分钟;实时音频准确度仍在改进。6
这份清单和上一代几乎重合。
Genie 3 列了五条:行动空间受限、多智能体交互、真实地点、文字渲染、交互时长。5
Genie 4 拿掉了「行动空间受限」,补上「漂移」与「音频准确度」,变成六条。6
其余四条,措辞几乎没变。
六条里,有两条与官方的用例直接相撞。
撞上的第一处是新闻场景。测试者案例写着:摄影记者在试,把一张二维档案照片,几秒钟内变成那个环境的「有根据的模拟」。1
而模型页写着:Genie 4 目前无法精确模拟真实地点。6
这一条不是新加的。上一代的原话是「无法以完全精确的地理精度模拟真实地点」。5
一条历史新闻的现场,恰恰是最不能「大致像」的那种画面。
这两条正是机器人训练环境最需要的部分。
还有一处官方写得很实:所有由 Genie 4 生成的视频与音频都会带 SynthID。1
SynthID 覆盖图像、音频、文本、视频四类;音频那一段原先限定在 Lyria 与 Notebook LM 的播客功能。18
视频从 2024 年 5 月起开始加水印,方法是逐帧标记。19
实时生成的音轨也进了水印范围,这段世界是不是生成的,因此多了一条可查的线索。
这条值得记,因为它对付的正是档案照片那一处相撞:对一个要把档案照片变成现场的系统来说,能被认出是生成的,比更像更要紧。
04 四个用例里,机器人那条还在实验台上
受信测试者的四类场景,官方列得很具体。1
影视与创意:把它当「草稿模式」,导演走进一个场景,实时换机位、换光、换台词,连跑几条。
新闻与历史场景:一张档案照片变成可走进去的环境。
游戏:在写第一行引擎代码之前,先用自然语言试视觉风格与交互机制。
企业仿真:零到一的场景生成,顺便找出模型的缺口。
四类里,影视和游戏要「快」,新闻要「准」,企业仿真要的是能替掉真机的那部分——那是另一套标准。
DeepMind 工程师 Diego Rivas 在简报会上说的也是这个:实时最值钱的地方,是创意工作里保持心流的那一段,构思、画分镜。12
机器人那条线还在实验阶段,例子里规划交给了另一个模型:Gemini 4 Argon 把任务拆成多步计划,作为文字提示喂给正在渲染的 Genie 4。
模拟的对象是 Apptronik 的 Apollo 人形机器人下跳棋。1
模型页把这个前景写作「一个无限的机器人仿真游乐场」。6
官方用的词是 playground:可以随便试,不必对结果负责。它没有被写成训练管线,也没有被写成验证工具。
上一代的产品体验,有人替我们试过。
The Verge 的记者在 Project Genie 上线当天拿到权限,60 秒里就遇到路面变草地、涂痕消失。
他写:「我开始不相信 Genie 记得住我亲眼看过的东西。」15
连贯这一条,正是这一代说要改的。1
同一篇里,操作延迟比他有时在云游戏里遇到的还差。15
对一个卖「实时构思」的东西,延迟比画面更致命。
延迟和音频准确度,这次都没有给指标,也没人能验证改到了什么程度。
官方没有给任何基准分数。1
第三方也测不了。
交互式世界模型的学术基准 WorldMark 在论文里明写:排除 Genie 3 这类闭源商业系统,因为它们只允许网页手动操作,无法被可复现地驱动。20
The Verge 的记者这次也没上手:「我没能自己试 Genie 4。」16
关于这一代,现在唯一能核的是它做不到什么;能做到什么,只有演示。
05 同行不在做同一件事,而且正在被买走
世界模型这条线上,各家的活不一样,给的数也不一样。
Runway 卖可玩、带音频、参数写清的实时世界,9 月 3 日上线。7
Odyssey 5 月 17 日就自称「世界上第一个多模态世界模型」,实时同步生成音频与视频。
Decart 的 Oasis 3 直接对准物理 AI 与自动驾驶,宣称可以无界长时闭环交互,从第一天起就卖 API。8
NVIDIA 走开放权重:Cosmos 3 分 64B、16B、4B 三档,明确服务物理 AI。23
Google 的位置很清楚:可探索、能对话、被 Gemini 盯着,但现在只给受信测试者。1
更值得看的是另一条线:这个行业正在被买走——一笔已签,一笔已交割,一笔在谈。
9 月 28 日,World Labs 宣布签署最终协议加入 AMD,理由是「更靠近硬件」。李飞飞将出任 AMD 执行副总裁兼首席科学家,直接向苏姿丰汇报。26
据 TechCrunch,这笔交易的价格是 82 亿美元。27
10 月 22 日,Rivian 收购英国公司 Third Dimension,条款未披露,15 人团队并入自驾 AI 团队。28
Rivian 的自驾负责人 James Philbin 说,他们要的是「把真实场景变成可仿真的场景」,因为验证阶段先得搞清楚 sim-to-real 的差距。28
同一批报道里还提到,据《华尔街日报》,亚马逊正在洽谈收购 Decart,价格约 70 亿美元。12
三类买家:芯片公司、车企、云与电商。
世界模型这条线上,决定去向的正在从模型变成买家。
06 十四个月,从预览走到预览
2025 年 8 月 5 日,Genie 3 以研究预览发布,只给一小批学者与创作者。5
2026 年 1 月 29 日,Project Genie 向美国 18 岁以上的 Google AI Ultra 订阅者开放。
它由 Genie 3、Nano Banana Pro 与 Gemini 组成。9
同一份公告里还有一句更值得记:Genie 3 发布时说过的「用提示词改变世界」,这个原型里还没有。9
也就是说,今年 1 月用户拿到的那个版本,比 2025 年 8 月演示的那个版本少一样东西。
2026 年 10 月 27 日,Genie 4 回到起点:研究预览、受信测试者、waitlist,「未来几周」向 Ultra 订阅者和 API 早鸟开放。1
两次都从外部测试者开始。
上一代从预览走到订阅者手里,隔了近半年;这一代刚走到第一步。
官方的战略说法也没变。
Genie 3 的页面写,世界模型是通往 AGI 的关键垫脚石,因为它能给智能体提供无限的训练环境。5
Genie 4 的页面写,理解和模拟世界是构建 AGI 的关键一环。1
两句话是同一个意思。
变的是实现方式:从「一个模型学会世界」,变成「几个模型拼出一个世界」。
对 Genie 这一线来说,答案不在演示里,在模型页那句没改过的「几分钟」里。
References
- 1
- 2
- 3
- 4
- 5
- 6Google DeepMind:Genie 4 模型页(含局限清单)
deepmind.google
- 7
- 8
- 9Google:Project Genie 介绍,2026 年 1 月 29 日
blog.google
- 10
- 11
- 12
- 13
- 14Raia Hadsell 个人主页
raiahadsell.com
- 15
- 16
- 17
- 18Google DeepMind:SynthID 概览页
deepmind.google
- 19
- 20WorldMark 论文 v2 全文(2026 年 8 月 5 日修订)
arxiv.org
- 21Odyssey:Introducing Starchild-1,2026 年 5 月 17 日
odyssey.systems
- 22Odyssey:Meet Odyssey-3,2026 年 10 月 8 日
odyssey.systems
- 23
- 24
- 25
- 26
- 27
- 28
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.