
2026 年 9 月 22 日,OpenAI 在产品栏目发了一篇《Better prompt caching for GPT-6》,署名是机构本身。开头一句就把主张说满了:「With the GPT-6 family, we launched an improved prompt caching system that delivers higher cache hit rates by default.」1 我把它当成一次成本模型的变更来读,结果发现最要紧的几件事和价格无关。
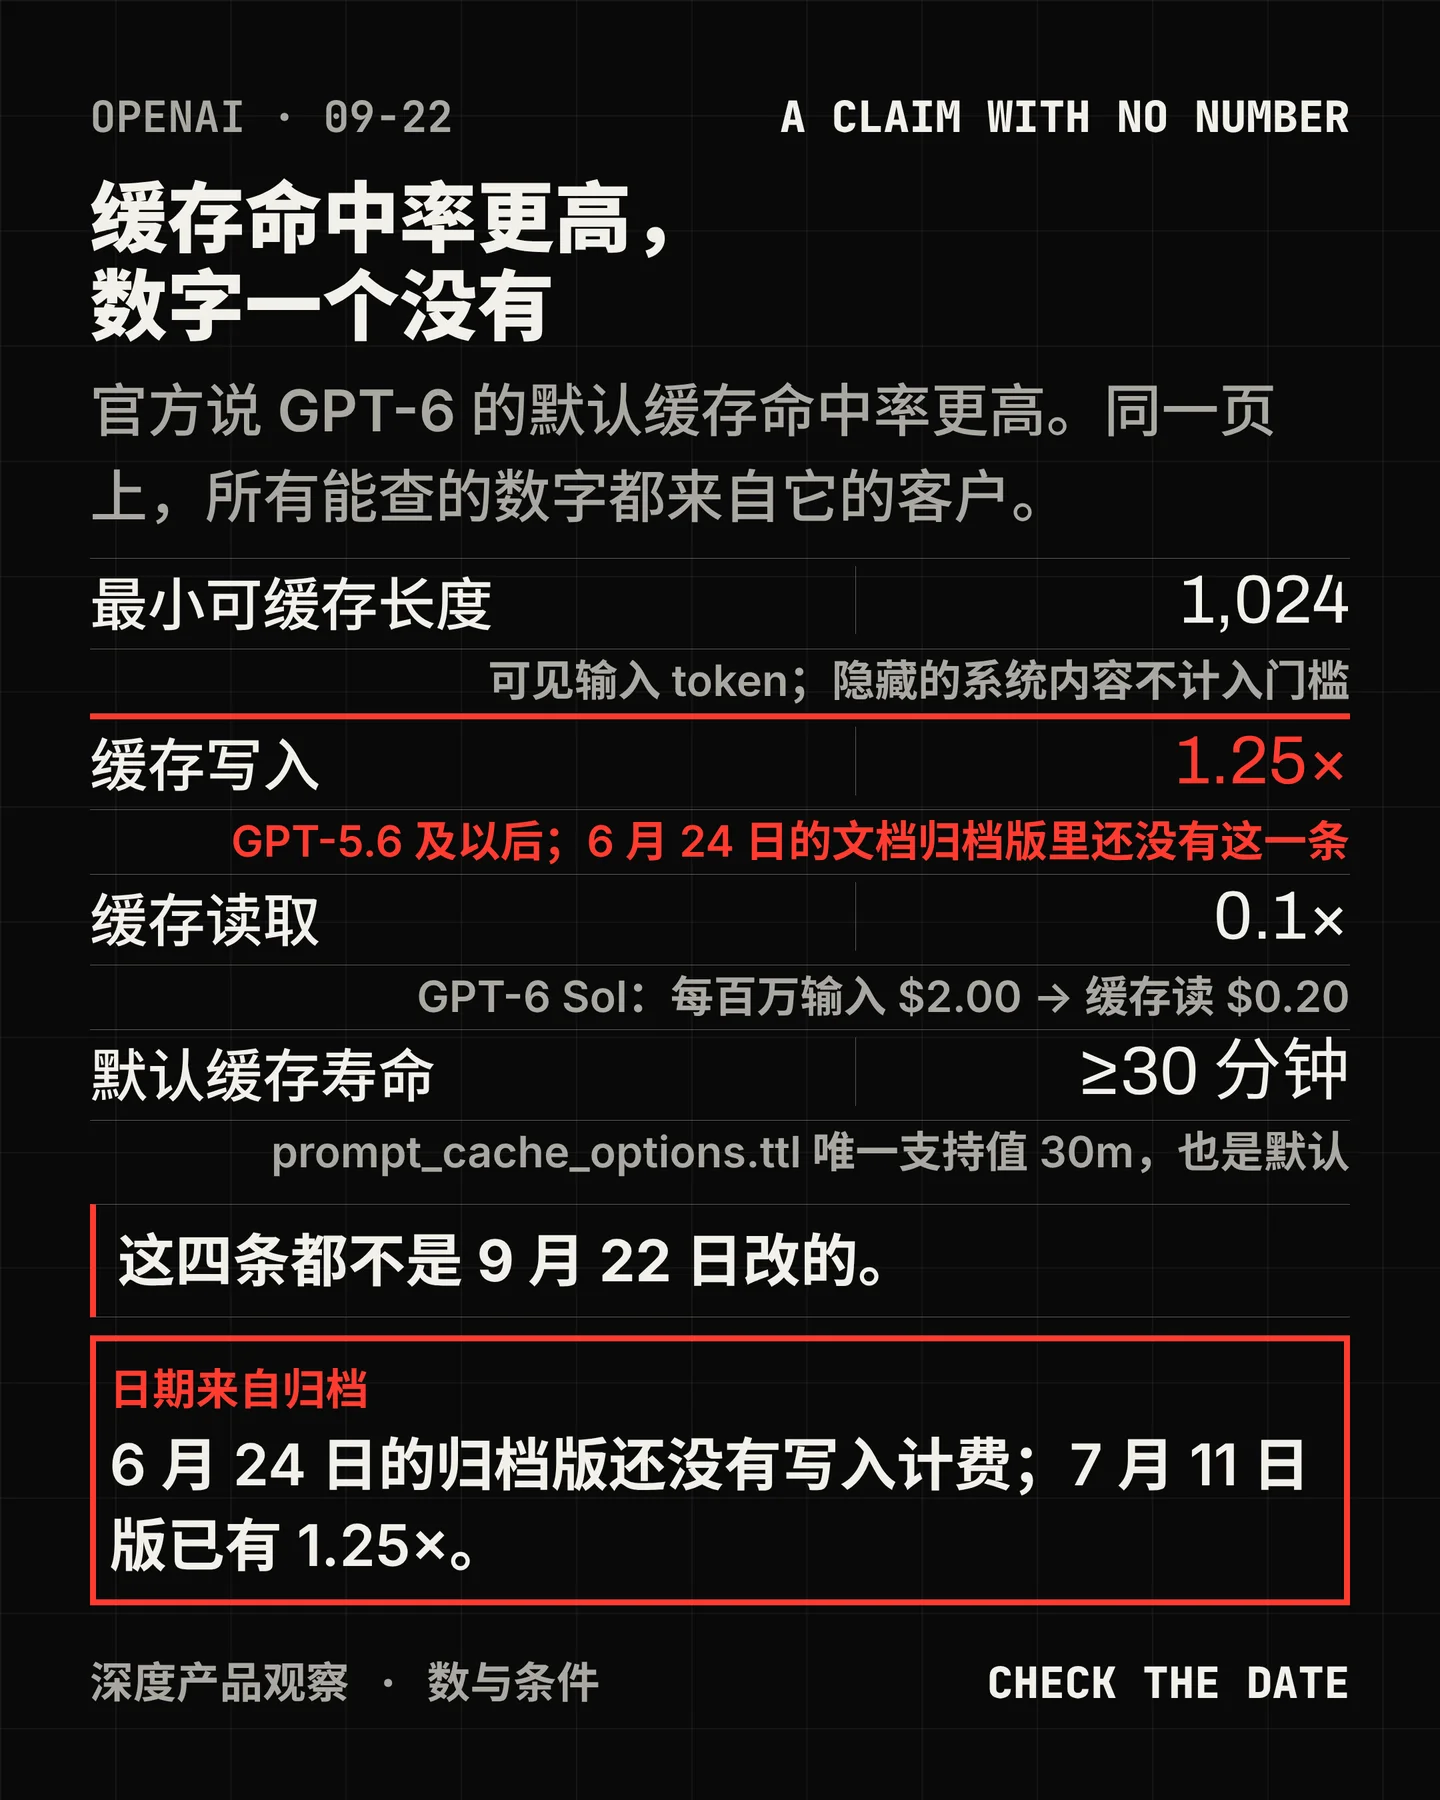
先说那个承诺本身:它没有数字。 全文关于命中率的量化表述只有「higher … by default」这半句,没有百分比、没有倍率、也没有测法。可以查的数字都在页面下方的四段客户证言里:GitHub 的首席产品官 Mario Rodriguez 说,相对此前基线,数十亿次请求里需要全新处理的 prompt token 占比减少了 50% 以上;Strawberry Browser 的首席技术官 Arian Hanifi 说命中率提高了「几个百分点」、成本降低 20%;Manus 的 Agent Team Lead Bin Fan 说不到一周命中率从大约 85% 升到稳定高于 90%;Wordsmith 的 AI 工程师 Eugene Mikhantyev 说评测集命中率从 83% 升到 91%、缓存写入降了约三分之二、推理成本降 36%。1 它们是同一页上的客户自述。不假,但也不是独立测量。
再看时间:这篇文章里大部分「now」比它自己早。 公告写「We now give cache discounts for eligible shared prefixes reused within a 30-minute window.」1 而文档归档给出的顺序是另一个样子:2026 年 6 月 24 日的指南归档版里,缓存写入还不单独计费,只写「Prompt cache pricing is the same for both retention policies.」;7 月 11 日的版本已经写明 GPT-5.6 及以后写入按 1.25× 未缓存输入价计费、读取 0.1×;9 月 21 日的版本——公告前一天——已经含 30 分钟寿命与 1,024 token 的最小可缓存长度。234 这一点有第三方旁证:一家做 LLM 网关的公司在 7 月 24 日的分析里写「cache writes are now billed for the first time, at 1.25x the normal input rate」,并把 7 月 9 日那次发布认定为写入计费的起点。5
那 9 月 22 日新增的是什么? 从官方文本里只能读出两件。一是把 GPT-6 家族纳入同一套缓存机制。二是「在会话里改推理档位不破缓存」——原文写「you can now change reasoning effort between responses without breaking cache」,做法是往 input 数组追加一条 configuration_update,同时让顶层的 reasoning.effort 保持不动;文档解释得很直白,改顶层设置会重写隐藏系统指令里的内容。6 其余被讲成新功能的东西——30 分钟窗口、写入与读取的倍率、1,024 token 门槛——都能在公告之前的归档里找到。
真正能拿来算账的是文档里那几条算术。 写入按 1.25× 未缓存输入价计费,读取按 0.1×;写一次、读回一次的总成本是普通输入成本的 1.35 倍,而不缓存地把同一段前缀处理两次是 2 倍;写一次、读回九次是 2.15 倍,对照 10 倍。缓存寿命是「最近一次写入或复用之后至少 30 分钟」,复用本身会把寿命刷新、不再产生新的写入费用;每个请求最多四次缓存写入。6 最有用的一条在门槛那一侧:最小可缓存长度是 1,024 个可见输入 token,隐藏的系统内容不计入;官方示例给出的结论是——102 个 token 或更短的前缀,永远不划算;103 个 token 的前缀要至少 1,963 次请求才回本。这不是营销话术里的「更省」,而是一道你能自己代入参数的分界线。
命中率由什么决定,文档其实答得很直白:由请求的形状决定,不由前缀的内容决定。 两处陷阱值得抄下来。第一,把新内容追加进同一条消息会毁掉上一次的断点:第一条请求以「内容 A」结尾、断点留在那里,第二条把这条消息改成「内容 A + 内容 B」,旧端点就落进了消息内部,不再是查找候选;正确做法是保留原消息、另追加一条。第二,从隐式缓存切到 explicit-only 会丢掉已经付过钱的隐式前缀,因为第二条请求只在自己的显式断点里找。6 另外,缓存查找只走有限的边界:explicit-only 模式只看前 2 个与最近 50 个显式断点,隐式模式再多看隐式断点、最多 20 个更早的消息结尾,以及初始 developer 块的整体结尾。你改的是结构,账单改的是数字。
新增的诊断工具给你一个原因,但只给第一个。 prompt_cache_diagnostics 会回一个 reason,官方列的九类是 model_changed、prompt_cache_key_changed、service_tier_changed、tools_changed、text_format_changed、reasoning_effort_changed、verbosity_changed、context_compacted、input_changed。文档同时写明三件事:诊断只报第一个被归类的原因;它是 best effort,可能分不出每一处未命中;诊断记录会过期。诊断不额外收费,也不改变请求本身的行为。7 顺带记下入口:看板在 platform.openai.com 的用量页 prompt-caching 一节,用量侧要读的是 usage.input_tokens_details 里的 cached_tokens 与 cache_write_tokens 两个字段。8
还有几件官方没写的事,我按没写处理。 命中率不作任何保证;Zero Data Retention 与 30 分钟寿命的关系、temperature 是否影响命中、ChatGPT 侧是否同样适用,公告与文档都没有回答。关于「默认命中率更高」这一条,我没有找到任何第三方实测或账单对比:这篇文章在 Hacker News 上的条目是 3 分、2 条评论。9 一个月前那次写入计费倒是引来了开发者的疑问,官方社区里有一条 7 月 10 日的帖子在问缓存读写 token 的计费口径。10 这不是说这次发布不成立,它只说明目前只有一方在说这件事。
落到你这周能做的,四件。 第一,重排提示结构:系统指令、工具定义、参考材料放最前,时间戳、请求 ID、本轮输入全部放到最后一个显式断点之后。第二,按两个字段算账:用 cached_tokens 与 cache_write_tokens 还原真实输入成本(普通 + 缓存读 ×0.1 + 写入 ×1.25),不要拿价格表上的单价估。第三,别动工具数组:要收窄可用范围用 allowed_tools,要停用就用 tool_choice:"none",不要增删或重排工具定义。第四,改推理档位写在会话里,用 configuration_update 追加一条更新,顶层的 reasoning.effort 不动。
最后压三句。第一,这次发布里真正新增的只有两件:GPT-6 纳入同一套机制,以及在会话里改档位不破缓存;写入 1.25×、读取 0.1×、寿命 30 分钟、门槛 1,024 token 都是公告之前就在的规则。第二,唯一说「更高」的那句没有数字,能引用的数字全部来自同一页上的客户自述——把这两类分开记,比记住任何一个百分比都有用。第三,缓存给你的折扣是固定的,账单不是:它由你的前缀有多稳、可变内容放在哪里、工具定义动没动决定。
References
- 1Better prompt caching for GPT-6
openai.com
- 2指南归档版(2026-06-24)
web.archive.org
- 3指南归档版(2026-07-11)
web.archive.org
- 4指南归档版(2026-09-21)
web.archive.org
- 5TrueFoundry:GPT-5.6 新缓存定价的收支平衡点(2026-07-24)
truefoundry.com
- 6Prompt caching 指南
developers.openai.com
- 7Prompt cache diagnostics
developers.openai.com
- 8Pricing
developers.openai.com
- 9Hacker News 条目
news.ycombinator.com
- 10OpenAI 开发者社区(2026-07-10)
community.openai.com
Comments