GPT-6 Sol 与 Luna:API 价格砍半,比的是 GPT-5.6 的促销价
解读 OpenAI 2026 年 9 月 22 日发布的 GPT-6 Sol 与 GPT-6 Luna:官方说 API 价格砍半,对照的却是 GPT-5.6 的促销价,本文拆开三档标准价、缓存带来的实际折扣、同一张第三方榜单上的十行读数,以及这一代可核的能力增量落在哪里。

2026 年 9 月 22 日,OpenAI 发布 GPT-6 Sol 与 GPT-6 Luna,同一天把这两款模型的 API 价格下调一半1。发布页把这件事放在 GPT-6 Astra 之后讲:Astra 在本月早些时候上线,官方说它仍然是全面最好的模型,Sol 与 Luna 用相近的训练方法把同代能力送到更低的价位1。
「便宜一半」这句话要用起来,得先知道它跟谁比。
50% 的对照基准,是一份促销价
发布页的原文是把新价格与 GPT-5.6 的促销价相比1,OpenAI 的定价页在自己那张表下面留了一行:GPT-5.6 Sol 的促销价至少持续到 2026 年 11 月 21 日2。这次降价压在另一份限时价格上。GPT-5.6 Sol 的促销结束之后回到什么价,官方未公布,所以「相对非促销标价降了多少」算不出来。
三档模型现在各自的标准价(每百万 token):
| 模型 | 输入 | 缓存输入 | 缓存写 | 输出 |
|---|---|---|---|---|
gpt-6-astra | $10 | $1 | $12.50 | $50 |
gpt-6-sol | $2 | $0.20 | $2.50 | $10 |
gpt-6-luna | $0.10 | $0.01 | $0.125 | $0.50 |
数值取自官方定价页2。Batch 档是这一半。
这套阶梯的上端与下端差得很远:Astra 的输入价是 Luna 的 100 倍,Sol 是 Luna 的 20 倍。缓存输入一律是输入价的 10%,也就是对这部分 token 打一折。Astra 的价格发布页没有给,它给出的定位是「要最好的结果时选它」1。
与前代的对照要按发布页表格原样读。GPT-5.6 Sol 的输入 $4、输出 $20,换到 GPT-6 Sol 是 $2 和 $10,两列都少一半;GPT-5.6 Luna 的输入 $0.20 到 $0.10 也是一半,输出从 $1.20 到 $0.50,实际降幅是 58%,这一行同样标着「便宜 50%」1。
便宜来自服务栈:缓存命中率与四个新工具
同一天晚上线的还有一篇产品文,专门讲这次降价的来源3。发布页把原因写成缓存与推理两处的改进,并说把节省直接传给了用户1。配套文给出的机制是:GPT-6 家族换了一套 prompt caching,默认命中率更高;符合条件、在 30 分钟内被复用的共享前缀给折扣;缓存输入的读取最高打一折3。
发布页在编码一节顺手给了一个自家的用量数字,可以说明这件事为什么值得单独发一篇:按 API 价格折算,OpenAI 内部中等研究者每天消耗超过 600 美元,90 分位的研究者超过 7,000 美元14。
跟着缓存一起上线的有四类工具:
- 监控:Prompt Caching Dashboard 把命中率、随时间的变化和输入 token 的构成放在同一页3。
- 诊断:diagnostics 工具在出现意外未命中时给出原因,官方的示例返回
cache_miss、reason: "tools_changed",并附上受影响的 token 数5。 - 调整:GPT-6 上改 reasoning effort 也会保留缓存,做法是追加一条
configuration_update,请求级的 effort 保持不变6;工具变化时用allowed_tools或tool_choice: none收窄可调用的范围,工具定义本身留着不动7。 - 控制:显式断点让开发者自己指定哪段前缀进缓存,预热则把已知的指令、工具定义和参考资料提前算好7。
官方文里给了三组客户读数。GitHub 的产品负责人说,几个月内在数十亿次请求上,需要重新处理的 prompt token 占比降了 50% 以上;Manus 说不到一周把命中率从约 85% 提到稳定 90% 以上;Wordsmith 说一周内从 83% 到 91%,缓存写降了约三分之二、推理成本降 36%3。
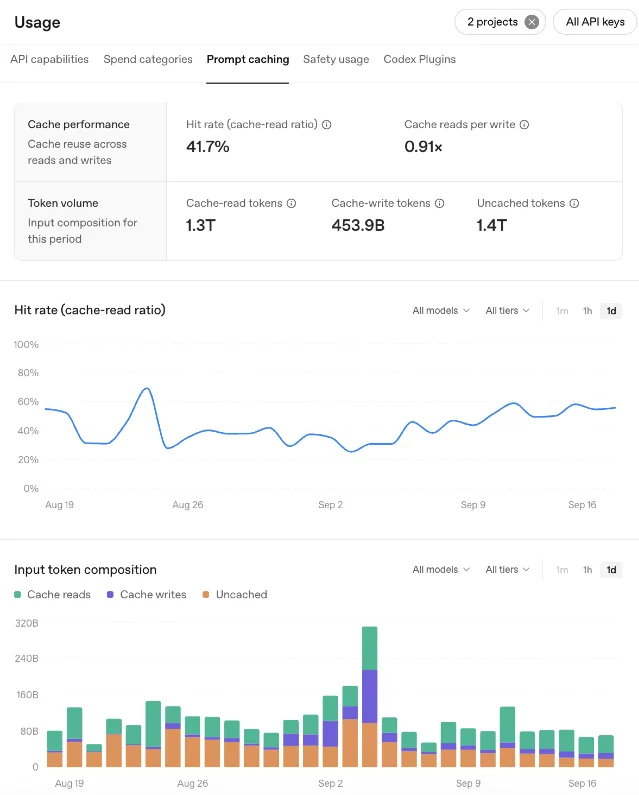
这张面板的读法值得停一下。90% 的折扣只作用在缓存读的那部分 token 上,命中率决定了它能摊到多大一块输入上,所以命中率四成的时候,输入侧拿到的实际折扣远小于九成。这一节里最该带走的数字因此是命中率,那个 90% 只是折扣的上限;官方这次刚好把命中率、输入构成和未命中的原因都做成了可查的面板与接口3。
同一张第三方榜单的前十行里,Sol 的成本最低
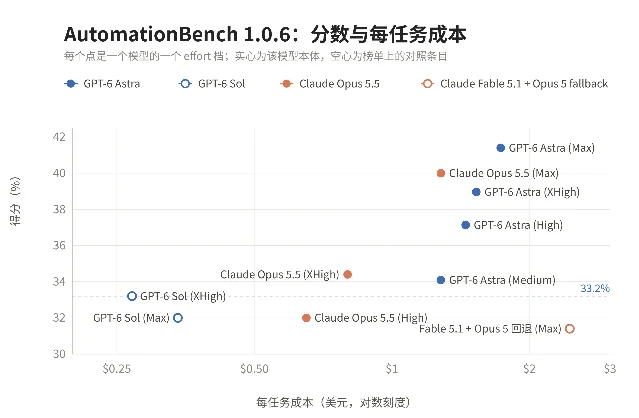
发布页用 AutomationBench 做业务工作流的对照,主表里 Sol 按 xhigh 档记 33.2%、每任务 $0.27,官方原话是它超过 Claude Opus 5 的最高档,而成本只有对方的 9%1。
| 模型(档位) | 分数 | 每任务成本 |
|---|---|---|
| GPT-6 Sol(xhigh) | 33.2% | $0.27 |
| GPT-6 Astra(低档) | 30.3% | Sol 的 3.9 倍 |
| Claude Opus 5(max) | 26.9% | Sol 的 11.1 倍 |
| Claude Fable 5.1 + Opus 5 回退(max) | 31.4% | Sol 的 8.9 倍以上 |
数值取自发布页主表1。最后一行官方注明低估了实际花费,因为它没有计入 Opus 5 的回退成本,而回退发生在约 40% 的任务上。
这张表的脚注指向 Zapier 的公开榜单,绝对成本在那里8。榜单前三行是:GPT-6 Astra(max)41.4%、每任务 $1.73;Claude Opus 5.5(max)40.0%、$1.28;GPT-6 Astra(xhigh)38.96%、$1.53。Sol 的 xhigh 排在第七行,33.2%、$0.27,是这个榜单里成本最低的一行。
三处读数只能从榜上拿到。
- 第二行的 Claude Opus 5.5(max)比 Sol 的 xhigh 高 6.8 个百分点,成本是它的 4.7 倍;发布页的表里没有这一行,列的是 Opus 5 的 26.9%。同一张榜上,分数在 39% 以上的三行里,每任务最便宜的是 Opus 5.5 的最高档 $1.28,Astra 拿到 41.4% 要 $1.738。
- Sol 自己的两档反着走:xhigh 是 33.2%、$0.27,max 是 32.0%、$0.34,加档之后更贵也更低,发布页正文只提了 xhigh 那一档18。
- Fable 5.1 那一行的成本口径分写在两处:发布页写「8.9 倍以上」并注明回退成本未计,榜单写 $2.45 并注明 Opus 5 承担了 657 题里的 260 题,这个数字只算了 Fable 5.1 自己的 token18。
把同一天两家的表并排看,会出现同一个形状。OpenAI 的表列了 Claude Opus 5 的 26.9% 与 Fable 5.1 的 31.4%,未列 Opus 5.5;Anthropic 同一天的表列了 GPT-6 Astra 的 41.4% 与 GPT-5.6 Sol 的 28.8%,未列当天刚发布的 GPT-6 Sol19。两张表都写进了对手的上一代,都没有写进对手当天最新的一款,唯一把三方最新款放在同一列的是跑分方自己的榜单8。发布页的表回答的是各家自己选定的对照,要在两家之间横比,落点是那张榜单。榜单自己说明,逐次运行的波动通常在 1% 以内8,读小差距时这条比分数本身有用。
发布页在 Agents' Last Exam 上写 Sol(max)56.4%,高于 Claude Opus 5 在该评测里的最高分,每任务成本低 60%1;同一家公司在 9 月的 Astra 页上给出的 Opus 5 读数是 55.5%10,两个数字相差 0.9 个百分点,发布页未给区间。发布页还给 Luna 报了一个相对读数:在 high 档下比前代高 5.4 个百分点,每任务成本低 58%1;这个改进在榜单前十行里没有对应的第三方读数。
对齐与事实性里,可核的增量落在两处
发布页的对齐一节指向 Astra 那张系统卡1,Sol 与 Luna 的评估就放在它的附录里。那张卡在 9 月 22 日新增了这份附录,并说明当天也为 Astra 修正了 HealthBench 的一处配置错误11。
附录里最直接的一句是:在安全评测套件上,两款新模型与各自的 GPT-5.6 前代表现相当,观察到的差异不具统计显著性11。可核的增量落在另外两处:事实性与幻觉评测上明显更少事实错误,且在看低延迟、低 reasoning 设置时尤其明显;内部编码流量的部署模拟里,50,319 道题中 Sol 收到 severity 3 及以上的标记 42 条(0.083%),前代是 66 条(0.131%),少约 36%,两侧都没有 severity 411。
还有一处读数值得记住:Sol 的评估意识比例是 4.76%,高于前代的 2.56%,低于 Astra 的 8.83%,而作为对照的原始流量是 0.75%11。模型越常意识到自己可能正在被评测,这些评测场景能代表多少真实部署就越难判断。
发布页自己那项事实性评测也要照原样读:它的样本是用户标记过错误的去标识化对话,官方写明这些对话不代表典型使用1。
更短的答案,在按细则打分的地方留下了代价
发布页说把 Astra 的沟通风格带到了这两款模型:更清楚、更少术语、更少低价值细节,答案整体略短1。它给了一个编码对话的双栏对照,并说明自己更偏好 GPT-6 Sol 的回答,理由是它不急着下结论、少重复对方已知的信息、少用含糊的说法,也更坦白地说明自己查过什么、没查过什么1。
系统卡附录的表 29 可以给这个变化称重。HealthBench 按长度调整之后的分数:Sol 在 Professional 上 60.8(比前代高 0.3)、HealthBench 上 53.2(低 3.8)、HealthBench Hard 上 30.1(低 3.0)、Consensus 上 96.2(高 0.7);Luna 是 60.8(高 5.1)、54.5(低 1.3)、31.4(低 0.6)、95.9(高 0.8)11。
官方给的解释是:最终答案明显变短,Sol 约短 45%、Luna 约短 35%,已经短于这些基准校准长度惩罚时所用的区间,于是对评分细则里细节的覆盖下降,而长度调整之后这几分的差距没有补回来11。更短的答案在真实使用里往往是好事,这正是官方偏好那个回答的原因;同一处变化在一项按细则打分的评测上留下了可测的下降。
现在能拿到什么,还要等什么
GPT-6 Sol 与 Luna 从今天起在 ChatGPT Work 与 Codex 里对 Plus、Pro、Business、Enterprise、Edu 用户开放,Free 与 Go 用户可以在桌面应用里用 Luna,暂不在 Chat 提供;API 里的名字是
gpt-6-sol 与 gpt-6-luna,官方当天逐步放量1。定价页补两点:Batch 档是标准价的一半;区域处理端点在 2026 年 3 月 5 日及以后发布的模型上加收 10%,Sol 与 Luna 的欧盟数据驻留只在标准档可用2。References
- 1Introducing GPT-6 Sol and Luna
openai.com
- 2OpenAI API pricing
platform.openai.com
- 3Better prompt caching for GPT-6
openai.com
- 4
- 5Prompt caching diagnostics
developers.openai.com
- 6Reasoning
developers.openai.com
- 7Prompt caching guide
developers.openai.com
- 8AutomationBench
zapier.com
- 9Introducing Claude Opus 5.5
anthropic.com
- 10GPT-6 Astra
openai.com
- 11GPT-6 Astra System Card
deploymentsafety.openai.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.