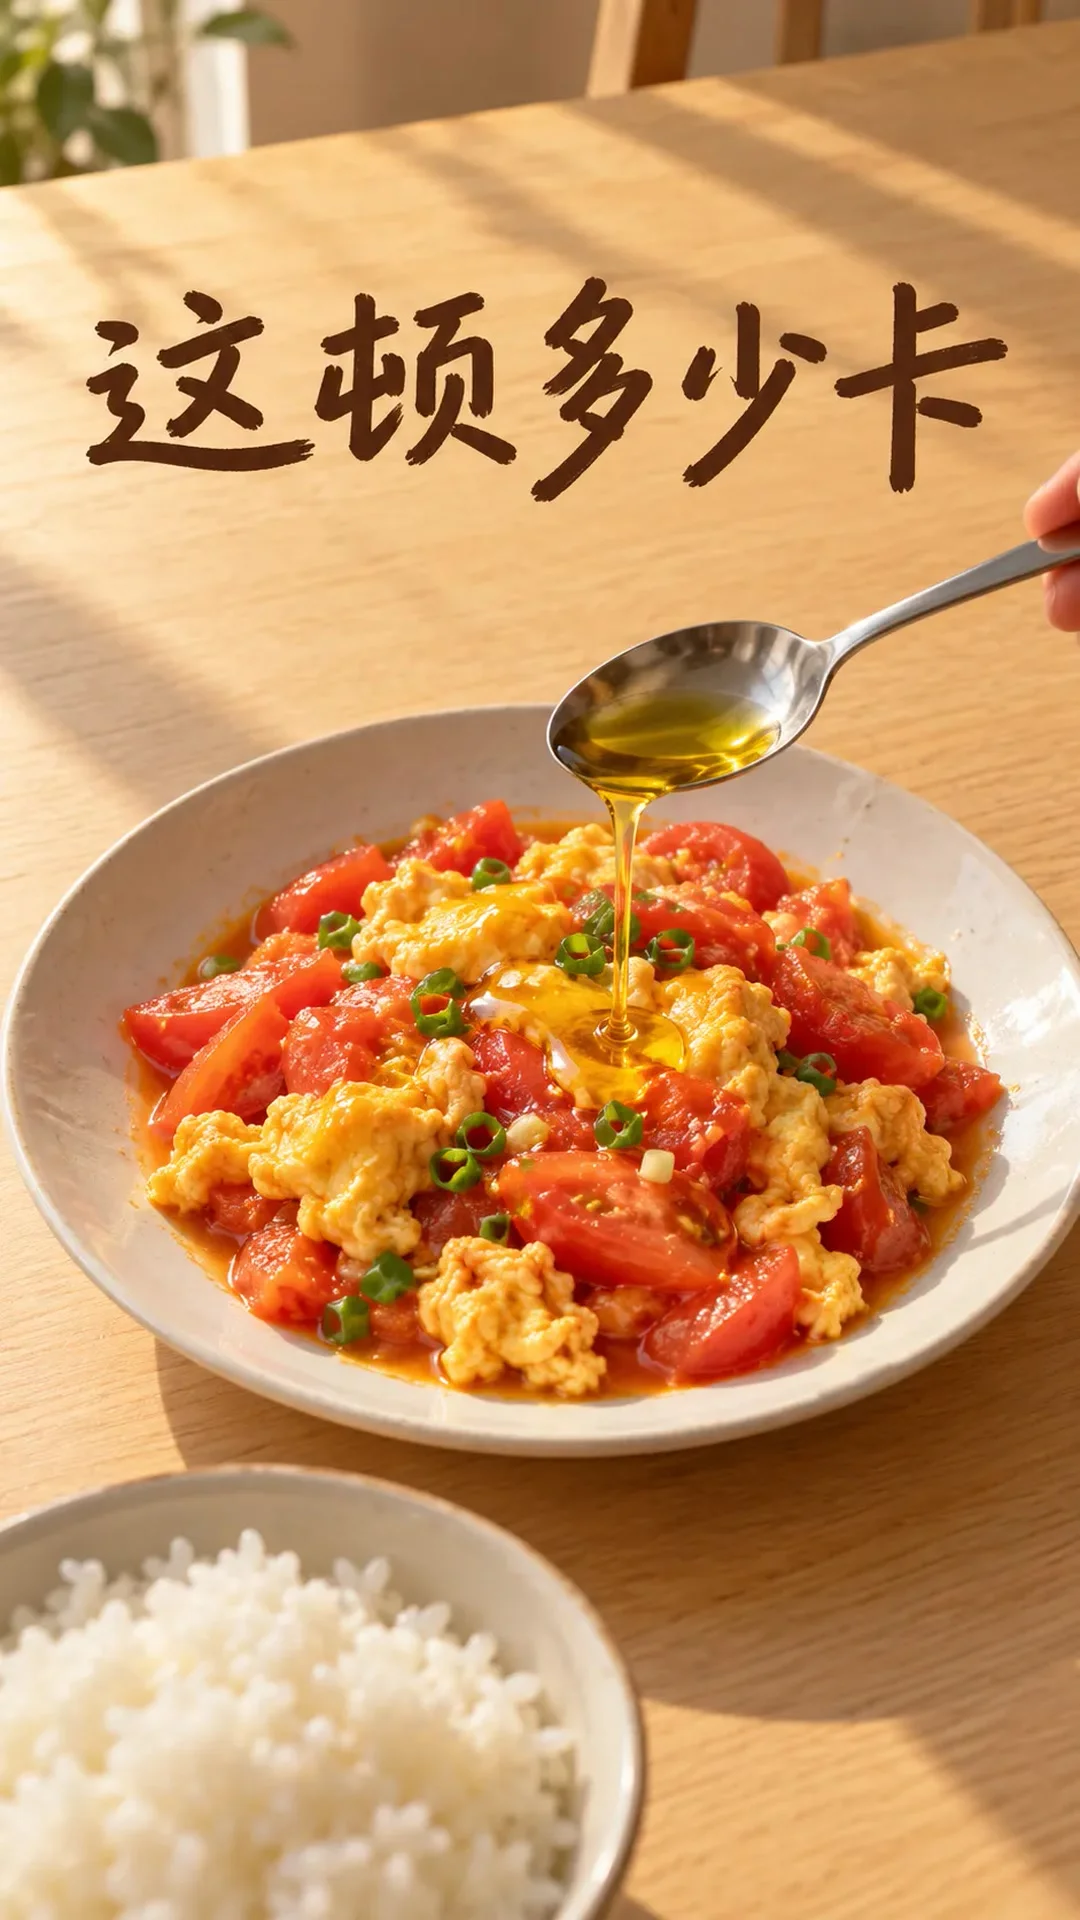
拍三张照片,让 AI 算出这顿饭到底吃了多少卡

做好饭、坐下来之前那半分钟,我会先给这一餐拍三张照片。不是为了发出去,是想知道自己这一顿大概吃了多少。
试过几次才发现:AI 认得出一盘是什么菜,认不出里面放了多少油,也看不出这碗饭压得有多实。所以拍的时候要帮它一把——菜分开摆、俯拍;最容易说不清的那盘凑近再来一张;喝的单独一张。
照抄这句提问
按照片里看得见的每样分开列,份量写清楚;看不见的我自己说:放了一汤匙油、清炒、加了半勺糖;每项给区间别给精确数,看不清的写看不清。
关键是中间那半句:看不见的东西要你自己说。照片把它送到了模型面前,但油、糖、做法这些看不见的量,只有做饭的人知道。
会拿到什么
一张表,一行一样东西:这盘菜的份量与能量区间、主食、喝的,最下面是一餐合计的区间,再加一句这个估算靠不靠谱。它说不清的(比如油和糖到底放了多少),会按你告诉它的算,而不是自己猜。
三个最容易翻车的地方
一是油。 一克脂肪 9 千卡,一汤匙油就是一百来千卡 1,而照片里油只是一层反光。在一项针对图像营养估算的研究里,一道加了很多油的菜,单张图的热量估计误差达到 52.5%、脂肪误差 68.3% 2。不说放了多少油,这一餐能被少算一大截。顺便有个参照:膳食指南给成年人的烹调油额度是每天 25–30 克 3,一餐用掉一汤匙,这个额度就去掉一大块。
二是份量。 同样一碗饭,压得实和盛得松能差小半碗,而图像估算的精度瓶颈也正在份量上——有研究团队专门加上深度预测模块,就是为了把份量估准一点 2。旁边放个参照物(筷子、一枚硬币都行),或者干脆称一次,比让模型看三遍都管用。
三是那个看起来精确的数字。 在公开的餐盘图像数据集上,最好的模型只看一张图估总热量,平均绝对误差也在 26% 左右,差一些的模型在 46%–56% 4。所以它给的那几百几十几千卡,是估算出来的,不是称出来的——要它给区间,别拿那个个数当刻度。
拍这一组加起来半分钟,比吃完饭再凭感觉猜自己吃了多少实在。
References
- 1
- 2
- 3中国营养学会《中国居民膳食指南(2022)》平衡膳食八准则
dg.cnsoc.org
- 4
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.