OpenStoryline:18 个工具节点串成一条剪辑产线,你的剪法还能存成技能
今天拆的是 FireRed-OpenStoryline:一条自带 Agent 的成片产线,18 个工具节点串起从素材到渲染的全流程,剪法还能存成可复用的技能。文章给全它在链条上的位置、三条上手入口、六处已知阻塞,以及今天该不该动手的判断。
今天这一个叫 FireRed-OpenStoryline,挂在 GitHub 的 FireRedTeam 账号下,Apache-2.0 许可1。团队在 2026 年 2 月 10 日宣布它开源,仓库创建于 2 月 7 日2。截至今早,首页写着 3,427 star、401 fork、15 人 watching,主分支 51 次提交1。
它是一条自带 Agent 的成片产线。你把素材丢进去、用中文说出想要什么,它自己决定先切镜头、再理解画面、再排时间线、最后渲染,中间每一步都能被你打断、改口、重跑3。它也给外部 Agent 留了接口:内部能力全部用 MCP 暴露出来,Claude Code、Codex、OpenClaw 都能反过来驱动它。
前 5 期讲的是镜头卡(video-shotcraft)、产线编排(OpenMontage)、剪辑手艺(video-use)、贴着 FFmpeg 的执行层(kinocut)和一台浏览器剪辑器(FableCut)。OpenStoryline 和 OpenMontage 站在同一层,区别在谁来当编排器:OpenMontage 把这件事交给你的编码 Agent,OpenStoryline 自己带着大模型循环、中间件和记忆,再把同一批能力用 MCP 交出去。
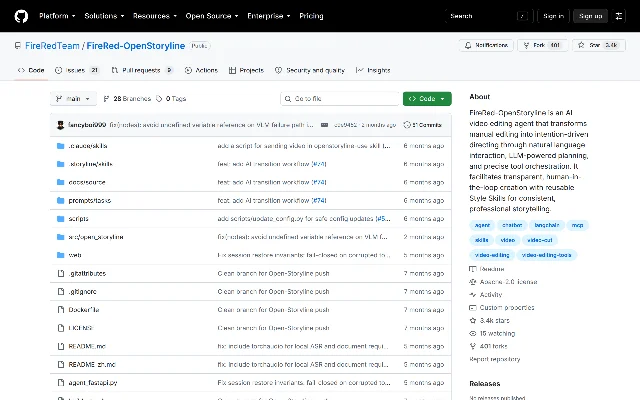
c9e9452,右端标着「2 months ago」——主分支最后一次提交停在 2026 年 7 月 31 日,那一次合入的是 PR #102。1418 个工具节点,加一张可以存下来的技能卡
它的 MCP 服务端只做一件事:把内部节点逐个注册成工具。
config.toml 的 available_nodes 里列着 18 个5,注册后对外的名字是 load_media、search_media、split_shots、local_asr、speech_rough_cut、understand_clips、filter_clips、group_clips、generate_script、script_template_rec、elementrec_text、elementrec_transition、generate_voiceover、select_bgm、plan_timeline_pro、plan_timeline_ai_transition、generate_ai_transition、render_video。注册代码另外挂了两个工具:read_node_history 凭一个 artifact_id 回读任意节点跑出来的结果,write_skills 把一段 Markdown 技能写进 .storyline/skills/6。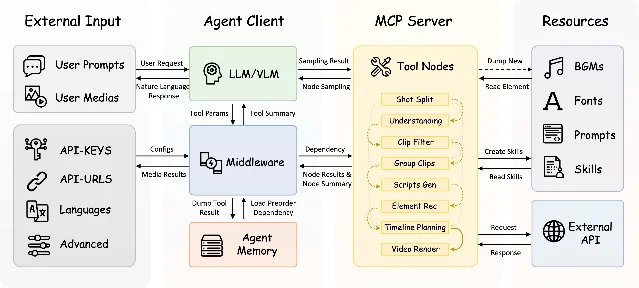
这套编排的另一半写在技能里。
.storyline/skills/ 下躺着 5 个 Markdown 技能:default_editing_workflow_skill 是通用流程,speech_rough_cut_skill 管口播粗剪,subtitle_imitation_skill 管文风仿写,另有 create_profile_style_skill 和 ai_transition_editing_skill8。每个技能开头是一段 name 加 description 的 frontmatter,后面写清这个角色要调哪几个工具、按什么顺序调、输出成什么形状。口播粗剪这个技能最能说明它的做法。技能把顺序写死了:读素材,跳过镜头切分,用
local_asr 做文字识别与时间戳打标,再交给 speech_rough_cut 切分出值得留的片段,然后推荐花字,用 is_speech_rough_cut=True 生成时间线,渲染时保留素材原声;这一步不需要配音、背景音乐、转场和文案9。技能里还写了一条自查要求:粗剪完要调 read_node_history 回头看切出来的文案是否通顺,句子不完整就把诉求写成 user_request 重新跑一遍粗剪。沿着同一套机制往前一步,就是项目主推的那个卖点。README 把「剪辑技能归档」列为主要功能之一:一条片子打磨满意之后,让 Agent 把其中的剪辑逻辑——节奏、色调、转场习惯——总结成一个技能存下来,下次换一批素材调同一个技能,就能复刻同一套风格2。
你要给什么,它交回什么
六个字段必须先有值:
[llm] 和 [vlm] 各自的 model、base_url、api_key。项目给编码 Agent 写的使用技能把话说得很直白——这六项空着,模型调用就会失败10。官方文档给的搭子是 DeepSeek 的 deepseek-chat 配 GLM-4.6V 或者 qwen3-vl-8b-instruct,两边的 key 都要自己去平台申请11。再往下还有三条按需配的:想让它在网上自己找素材,填一个 Pexels 的 API key;要配音,在 MiniMax、字节、302.ai 三家 TTS 里挑一家;要用 AI 转场,配通义万相或 Minimax 海螺其中一家11。
交回来的是一整串东西:一条按配音或音乐节拍排好的时间线、一支 MP4 成片、一张可以自己接着改的技能卡,以及一套现成的素材库。素材库分三类,扩充方式都是往目录里丢文件、改对应的 JSON、重启服务——BGM 按场景、曲风、情绪、语言四个维度打标签,字体按分类和语言打标签,文案模板按题材打标签3。
从零到第一个成片
三条入口,挑一条走。
- 本地装:
conda create -n storyline python=3.11建环境,Linux 或 macOS 上跑bash build_env.sh,或者手动./download.sh下载模型与资源、再pip install -r requirements.txt,然后去config.toml填那六个字段,两个终端分别起 MCP 服务端和 Web 界面2。README 里这一步写的是sh build_env.sh,照抄会报错,原因见下面第二条阻塞。 - Docker:
docker pull openstoryline/openstoryline:v1.0.1,把config.toml、outputs、run.sh三个路径挂进去,开 7860 端口;国内有阿里云的镜像地址换用2。 - 让编码 Agent 自己装、自己跑:仓库自带两个 Claude Code 技能,
openstoryline-install管安装、配置和首跑验证,openstoryline-use管起服务、建会话、发剪辑指令和验收产物;从仓库根目录启动 Claude Code 就能直接用,也可以复制到全局。OpenClaw 走openclaw skills install或 ClawHub,Codex 走npx skills add FireRedTeam/FireRed-OpenStoryline --skill openstoryline-use --agent codex2。
走第一条路之前,先知道要花多少时间和磁盘。使用技能里写着 MCP 服务端启动可能需要几分钟,别急着把进程杀掉10。下载脚本要拉两个包,2026 年 9 月 20 日读到的字节数是
models.zip 111,418,236、resource.zip 446,806,43112。Docker 那条路的镜像是 amd64 5.5 GB,最后一次推送在 2026 年 3 月 17 日13。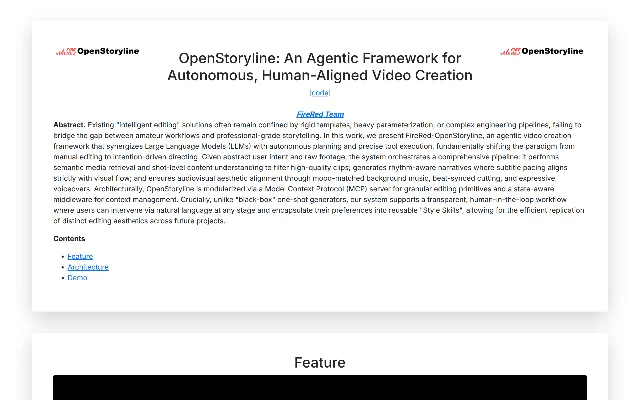
会卡住的地方
装它先要腾出几十 GB
症状:装完一看磁盘,几十个 GB 没了。
触发条件:走本地源码那条路,完整下载模型和资源。
现状:issue #80 在 2026 年 4 月 10 日开单,正文只有三个字「太大了!」,到今天没有回复15。数字对得上:
models.zip 与 resource.zip 加起来 533 MB 只是起步,requirements.txt 里有 torchaudio、funasr、sentence-transformers、faiss-cpu、transnetv2、moviepy 这一串常驻几百 MB 到数 GB 的包16,Docker 那个 amd64 镜像自身就有 5.5 GB13。你能怎么办:给 conda 环境单独留一块盘,或者直接用官方镜像,把环境成本换成镜像层;只是先看看效果的话,镜像那条路更快。
README 第三步给出的命令会直接报错
症状:照 README 的 3.1 节敲
sh build_env.sh,脚本报语法错误。触发条件:在 macOS 或 Linux 上用
sh 跑这个安装脚本。现状:issue #89 于 2026 年 4 月 30 日提交,指出这个脚本是 bash 脚本、里面用了
[[ 这类 bash 才有的语法,作者给的改法是 chmod +x build_env.sh 之后用 bash build_env.sh 或者 ./build_env.sh17。同一天有一条 PR #90 专门修这个 shell 兼容问题,到现在还开在队列里没有合18。你能怎么办:命令换成
bash build_env.sh。这是文档与脚本对不上,脚本本身能跑。配置写进 config.toml,启动还是说 key 不存在
症状:
config.toml 里 [llm]、[vlm] 都填好了,启动日志照样打印 DEEPSEEK_API_KEY exists: False,第一次对话抛 ExceptionGroup。触发条件:第一次安装完就跑最简单的对话。
现状:issue #30 在 2026 年 3 月 3 日开单,楼里 14 条回复。维护者 minipuding 一路问
developer_mode 打开后有没有更细的报错、是 bash run.sh 起了服务还是两个终端分别起、在界面侧栏直接填 key 是否一样,提问者三项都试过并把系统和 pip list 贴了出来,问题到今天仍然 open19。你能怎么办:按 issue 里的顺序自己排——先开
developer_mode 看日志,确认服务是哪种方式起的,再试在 Web 界面侧栏填一遍 key;三条都走完还报错,就去看 config.py 里这份配置是怎么读的。Docker 那条路装到的是 3 月的版本
症状:容器里的
config.toml 没有 AI 转场那一段;照着仓库的格式手动补上,服务启动直接失败。触发条件:用官方镜像部署,又想要 AI 转场。
现状:issue #93 于 2026 年 5 月 10 日开单,贴出的报错是 pydantic 抛
ValidationError: generate_ai_transition Extra inputs are not permitted,服务打印 Application startup failed. Exiting. 就退出20。时间线能解释这处差异:镜像 v1.0.1 是 3 月 17 日推的,而 AI 转场那份配置由 PR #74 在 3 月 30 日提出、4 月 2 日合入21,镜像里自然没有这一段。你能怎么办:不要 AI 转场就先用镜像跑;要的话换源码部署,或者等镜像重推。
换一批素材,它可能给你同一条片子
症状:拿多段素材、想剪出几条不同的视频,出来的是同一条;输出路径不能自己选;素材之间用哪两段相接也不能自己指定。
触发条件:素材多,且一次想要多条产出。
现状:issue #83 在 2026 年 4 月 16 日开单,四条问题一次列完,至今没有回复22。更早还有一条相邻的反馈:4K 图片放进去、出来的是 608×1080,维护者在楼里的答复是在对话框里直接说「我要 4K 视频」23——分辨率这条走的是对话,不是配置项。
你能怎么办:一次会话当成一条片子来用,换主题就新建会话、把风格和主题在指令里说清楚,让它在片段分组和文案生成这两步上真正分叉;输出位置跟着会话目录走,第一次跑完先去看产物落在哪里。
从 7 月 31 日起,它没有再进过一行代码
症状:你踩到的坑可能已经没人接手,也可能已经有人写好补丁挂在队列里。
触发条件:你把问题提上去,等回复。
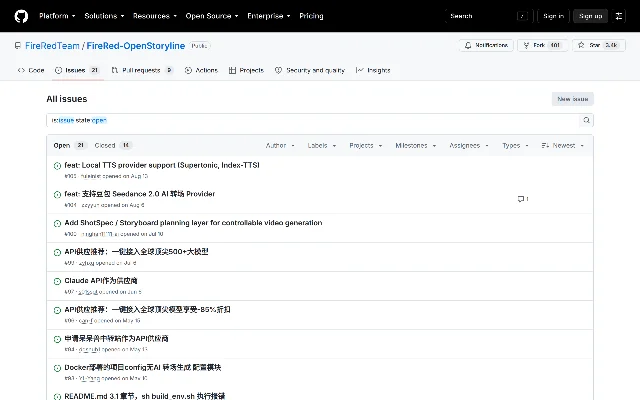
现状:主分支最后一次提交是 2026 年 7 月 31 日4。在那之后新开的 PR #107(2026 年 9 月 10 日)、#103(7 月 28 日)、#92 与 #91(5 月 7 日)、#90(4 月 30 日)、#87(4 月 24 日)全都还开着,最老的一条已经躺了将近五个月24。21 条 open issue 里,多数没有维护者的回复。
你能怎么办:把它当成一个能跑但停更的版本来看。要动手就先接受「出了问题自己读代码」这条前提,好在修法在 issue 和 PR 里大多有人写过——比如 #89 的 shell 兼容、#93 的配置缺段——挑着打补丁就行。
许可与真实成本
许可是 Apache-2.0,仓库里的 LICENSE 是标准的 Apache License 2.0 全文,商用免费1。
软件本身不收费,没有账号、没有订阅、没有按次计费的闸门。钱落在你自己接上去的模型服务上,一次完整剪辑至少打两类模型:LLM 写文案、做规划、组织时间线,VLM 逐个片段看画面、判断内容。要配音再加一家 TTS,要 AI 转场再加一家的视频生成。项目对 AI 转场这条路的原话是「资源消耗通常显著高于常规文案或配音流程」,因为转场在相邻片段之间逐段生成、片段切得越细调用次数越多,它给的建议是先用少量片段试跑、确认效果与成本之后再批量生成,并且提前盯住账户余额11。几家服务商各自的单价,项目没有给数字,得去它们自己的计费页看。
素材这一侧,自动检索走 Pexels,用了就要遵守 Pexels 的许可协议;文档里写明素材的合法性、生成视频的版权与肖像权纠纷都由用户自己承担3。仓库自带的开源字体和音乐只够把流程跑通——README 直接写着,受版权和分发协议限制,开源的资源不足以满足普遍用户的剪辑需求,要商用级效果得照教程自己搭私有元素库2。
和已经在用的几套方案放在一起
| 方案 | 你给它什么 | 它给你什么 | 它在这一层 | 许可与公开体量 |
|---|---|---|---|---|
| OpenStoryline(本期) | 一批素材或一句主题,加 LLM/VLM 两把 key | 对话推进出来的成片、可保存复用的剪辑技能、一套能扩充的素材库 | 自带 Agent 的成片产线:底下用 MoviePy 与 FFmpeg 渲染,能力对内外都用 MCP 暴露 | Apache-2.0;3,427 star、401 fork、51 次提交1 |
| OpenMontage(第 2 期) | 一句需求,加你的素材 | 走完工序的成片,带审批门、决策日志和预算上限 | 流程与方法层,安排哪个阶段谁做什么 | AGPL-3.0;60,157 star、7,610 fork25 |
| video-use(第 3 期) | 一个装原始素材的文件夹,加一把 ElevenLabs key | 按词边界剪出的成片,连转写稿、剪辑决定和字幕一起交回 | 方法论与资产层里的剪辑手艺 | MIT;25,134 star、3,057 fork26 |
| kinocut(第 4 期) | 一个本地媒体文件,加 PATH 上的 FFmpeg | 有类型的工具调用和一张回执:成片、每步的哈希、质量分、待人工确认项 | Agent 与 FFmpeg 之间的执行与验证层 | Apache-2.0;158 star、40 fork27 |
| video-shotcraft(第 1 期) | 一句需求,加你产品的截图 | 一支还能继续改的 Remotion 宣传片工程 | 站在 Remotion 之上的镜头与动效资产库 | Apache-2.0;9,024 star、812 fork28 |
| HyperFrames | 用 HTML、CSS 和 JavaScript 写的合成 | 确定性渲染出的 MP4 | 渲染底座;kinocut 可以把 HyperFrames 当可选后端调起来 | Apache-2.0;51,646 star、4,706 fork29 |
| hypit | 一支参考视频,或者一句描述 | 一套以词为锚点的工作流,换宿主、换语言、换比例都能重跑 | 视频工作流的描述语言 | 自订许可;10,919 star、1,321 fork30 |
这七样各站一段,能叠着用。OpenStoryline 是里面唯一一条自带 Agent 的完整产线:对话进来,工具节点一路跑完,成片出去,偏好还能存成技能带走。往下一层,kinocut 那类东西把 FFmpeg 包成有类型的工具,HyperFrames 管确定性渲染;往上,OpenMontage 用你的编码 Agent 排流程、定预算;素材进来之后怎么下刀归 video-use 那种手艺;hypit 那门语言管的是换一台机器之后还能不能重跑25272930。
今天装还是不装
今天就该动手的:你手上有素材,想让机器先把切镜头、筛片段、排时间线、配 BGM 这一串跑一遍,你在旁边用中文改。你也已经不介意装完占掉一块盘。第一条片子建议用口播视频跑粗剪技能——它只依赖 ASR,不需要配音、BGM 和转场,是这套东西里最短的一条闭环,跑通它再决定要不要接 TTS 和视频模型。已经用 Claude Code 或 Codex 的人可以先走第三条入口,让 Agent 照着
openstoryline-install 和 openstoryline-use 两个技能自己装、自己起服务,跑不通的时候看它卡在哪一步。先收藏的:你要的是一条无人值守的产线,素材进去、成片出来、自动发走——这套按设计是对话式的,每一步都在等你回话,你不在它就不会往下走。你的机器盘不宽裕,或者你只肯用官方镜像又想要 AI 转场。你打算拿它剪多条同素材的片子,还指望每条都不一样。你的模型预算还没着落——LLM、VLM 两把 key 是启动前提,缺一项第一次对话就会失败。
可以跳过的:你要的是从一句话生成画面——它的画面来自你放进来的素材或 Pexels 的检索结果,只有 AI 转场那一步会调视频模型补画面。你要的是一个嵌进自己服务里的渲染后端,那往下走一层,kinocut 或 HyperFrames 更合手。你等的是一个还在活跃迭代的项目,希望提了 issue 有人接——主分支停在 7 月 31 日,21 条 issue 开着,修法大多躺在没合的 PR 里。你不能接受自己读代码、自己打补丁,就先别装。
References
- 1
- 2README — FireRed-OpenStoryline
github.com
- 3OpenStoryline 使用教程
github.com
- 4Commits — FireRed-OpenStoryline
github.com
- 5config.toml — FireRed-OpenStoryline
github.com
- 6
- 7FireRed-OpenStoryline 项目页
fireredteam.github.io
- 8
- 9
- 10
- 11API-Key 配置指南 — FireRed-OpenStoryline
github.com
- 12download.sh — FireRed-OpenStoryline
github.com
- 13openstoryline/openstoryline — Docker Hub
hub.docker.com
- 14Issues — FireRed-OpenStoryline
github.com
- 15Issue #80 — FireRed-OpenStoryline
github.com
- 16requirements.txt — FireRed-OpenStoryline
github.com
- 17Issue #89 — FireRed-OpenStoryline
github.com
- 18PR #90 — FireRed-OpenStoryline
github.com
- 19Issue #30 — FireRed-OpenStoryline
github.com
- 20Issue #93 — FireRed-OpenStoryline
github.com
- 21PR #74 — FireRed-OpenStoryline
github.com
- 22Issue #83 — FireRed-OpenStoryline
github.com
- 23Issue #31 — FireRed-OpenStoryline
github.com
- 24Pull requests — FireRed-OpenStoryline
github.com
- 25calesthio/OpenMontage — GitHub
github.com
- 26browser-use/video-use — GitHub
github.com
- 27KyaniteLabs/kinocut — GitHub
github.com
- 28Vincentwei1021/video-shotcraft — GitHub
github.com
- 29heygen-com/hyperframes — GitHub
github.com
- 30hypit-ai/hypit — GitHub
github.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.