搬回家只掉 1.5 分、一条 5 秒片 62 秒到 17 分钟、658 个字错 41 个
七组来自 Reddit、X、小红书与公众号的实测,单位各不相同——一次七轮的代码审查、一条 5 秒的片子、一段 222 秒的录音、一句该不该写进记忆的话——每组都把机器、软件那一层和条件写在读数旁边。

昨晚十一点,Fabio Akita 挂出了基准 v4 的最后一张总表:67 次完整运行,近 60 个模型,账面花费超过 6000 美元1。
今天凌晨五点四十四分,他在 X 上补了自己的一笔账:一张 5090 平均 150 tok/s,用上几个小时就开始不耐烦2。
今天下午四点零一分,小红书上有人用一张 32GB 的 Intel 卡给出了另一个单位:MiniMax H3 能跑,5 秒的片子要等 5 到 8 分钟3。
这些材料量的东西各不相同:一次七轮的代码审查、一条 5 秒的片子、一段 222 秒的录音、一句该不该写进记忆的话。每一组给出一个数,也在数旁边标好了机器、软件那一层和条件。
| 材料 | 量的是什么 | 主读数 | 旁边那个数 |
|---|---|---|---|
| Fabio Akita 基准 v4,67 次运行 | 七轮里注入 14 个缺陷,模型自己发现多少 | 开源三家 92.5 分,与 Sonnet 5 的 91.0 同档 1 | 同一份 Flash-Next 在 5090 上 91.0 分,每次 0 美元 1 |
| 同一篇里的硬件账 | 一整天写代码的等待 | 5090 实测 159.2 tok/s 1 | 作者自己说 150 也嫌慢,再快只有 16,000 美元的卡 1 |
| 小红书 我是那只狐狸,RTX 5080 | 27B 的 Q3 在这张卡上的解码 | 104 tok/s 4 | 没调之前 56.8,显存吃到 15.2/16 GB 4 |
| FastH3 Omni,四台机器 | 一条 5 秒 480p 有声片 | 5090 61.9 秒 5 | 3090 约 16.9 分钟;加一张参考图从 14 秒变 62 秒 5 |
| 小红书 我是那只狐狸,MiniMax H3 | 同一条片换分辨率与步数 | 864×480 的 5 秒片 36 秒 6 | 原生 20 步的 15 秒片 22.1 分钟 6 |
| 小红书 Steven,本地 Whisper | 658 个字的转写 | 错 41 个,6.23% 7 | 222 秒音频用 118 秒转完,分不清谁在说话 7 |
| Reddit 记忆测试,四个模型 | 该记的记下、不该写的别写 | Hy-Memory 52/52 全召回 8 | 44 个空例 0 个正确;Qwen3.5 9B 是 37/52 与 40/44 8 |
一、同一份权重,三个地方,三个分数
v4 的题目一直是同一套流程:模型用七个 sprint 搭一个 Rails 聊天应用,sprint 之间往仓库里注入 14 个安全与正确性缺陷1。
有的很响:某个 gem 里的 CVE、写在代码里的密钥、敞开的 CORS。有的很静:跨租户泄漏、算错的聚合、被改过用来掩盖后门的测试1。
自己发现并修好的记全分,被提示之后才修记 40%,始终没修记 0 分;83 分以上是 A 档1。
| 模型 | 在哪跑 | 分数 | 每次成本 | tok/s |
|---|---|---|---|---|
| GPT-6 Astra | 云端 Codex | 100.0 | 30.55 美元 1 | — |
| Claude Opus 5.5 | 云端 Claude Code | 100.0 | 16.63 美元(按订阅折算) 1 | — |
| Claude Sonnet 5 | 云端 Claude Code | 91.0 | 约 27 美元 1 | — |
| DeepSeek V4.1 Flash | 云端 OpenCode | 92.5 | 1.21 美元 1 | — |
| GLM 5.3 Flash(NVFP4) | 1×B300 | 92.5 | 21.96 美元(只算推理时间) 1 | 142.0 |
| Qwen3.8 Flash-Next(NVFP4) | 1×B300 | 92.5 | 12.04 美元(只算推理时间) 1 | 195.0 |
| Qwen3.8 Flash-Next(IQ3_S) | RTX 5090 + Strata | 91.0 | 0 美元(本地) 1 | 159.2 |
42 次运行进了 A 档,闭源 24 次、开源 18 次;7 个模型打满 100 分,23 次运行在 90 分以上1。
顶部已经挤在一起,量尺本身先到头。同一个 GPT 5.5 重跑一次拿 91 分,官方那次是 100 分,几分的差就是噪声1。
真正有用的是同一份权重换地方的那几行。
Qwen3.8 Flash-Next 从 B300 上 NVFP4 的 92.5,到 5090 上 IQ3_S 的 91.0,掉 1.5 分1。
Ornith 1.5 35B 从 BF16 的 81.0 掉到 5090 上 Q8_0 的 64.5,掉 16.5 分;GLM 4.7 Flash 从 33.5 掉到 24.01。
Q8 常被当成近乎无损的一档,这 16.5 分里有引擎和卡的份1。
另一栏更能说明软件那一层有多重:同一个 checkpoint,自己服务和云端服务差多远。
GLM 5.3 Flash 云端 84.25,他自己在 B300 上 92.5,高 8 分;Nex N2.5 Pro 云端 94.0,自己服务 27.0,低 67 分1。
DeepSeek V4 Flash 的 0731 版从 85.0 掉到 44.5,DeepSeek V4.1 Flash 两次都是 92.51。
作者的原话是:比特数没有宣传里那么要紧,整套服务方式更要紧1。
体量也换不来警觉。Kimi K2 Thinking 一万亿参数拿 46 分,GLM 5.3 满血 700B 拿 76 分,同门的 Flash 是 92.51。
代码、提示词、日志与报告都放在仓库里9。
Loading content card…
二、他把「够用」画在 150 tok/s 以上
同一篇里,Akita 把自己硬件的账也算了一遍。他要回答的问题是:一天写下来,等待能不能忍。
159.2 tok/s 放在表里够看,放到一整天的编码、跑测试、读日志里,他说几个小时后就开始烦1。
150 tok/s 以下就不在考虑范围;再往上,价格先到服务器那一档2。
| 机器 | 显存或内存 | 带宽 | 实测速度 | 参考价 |
|---|---|---|---|---|
| RTX 5090 | 32GB GDDR7 | 1,792 GB/s | 159.2 tok/s(他实测) 1 | 建议价 1,999 美元 |
| 2× RTX 5090 | 64GB,分属两张卡 | 2×1,792 GB/s,合不成一个池 | 社区测解码几何均值 +22%、编码 +40% 1 | 建议价 3,998 美元 |
| Mac Studio M5 Ultra | 96 或 256GB 统一内存 | 1,200 GB/s | Strata 上还没有公开成绩 1 | 5,499 美元起 |
| DGX Spark | 128GB 统一内存 | 273 GB/s | 公开配方每会话 22–75 tok/s 1 | 6,950 美元 |
| RTX PRO 6000 Blackwell | 96GB GDDR7 ECC | 1,792 GB/s | 短聊 187.4、agent 会话 174.3 1 | 16,000 美元 |
两卡这条路他先说过一次,又在文章里推翻了自己。X 上那句写的是 Strata 不拆卡、只起两个实例;文章里更正的版本是,现在的 Strata 会按层切到多张卡上,走 pipeline parallel1。
社区在两张 5090 上的实测是解码几何均值 +22%、编码那一臂 +40%1。
M5 Ultra 的带宽是 1.2 TB/s,起步 5,499 美元;他只拿到 128GB M5 Max 的 97–119.5 tok/s,就把先前「Ultra 会低于 100」的估计撤回了1。
RTX PRO 6000 Blackwell 有 96GB 和同样的 1,792 GB/s,短聊 187.4、agent 会话 174.3 tok/s,价格 16,000 美元;巴西的 Pix 价是 123,299.99 雷亚尔1。
他自己的结论是:今天没有一个家庭选项,能同时给出好模型、真快的响应和能接受的价格1。
如果是团队,账换一套算法。4×B300 一小时 36 美元,能同时服务 32 个舒适会话,按每天 8 小时、每月 22 天算约 6,300 美元,折合每个开发者约 200 美元1。
同样算法下,4×H200 只服务 8 个会话,每人约 316 美元;买一台约 13 万美元的 DGX Station GB300,对着只开工作时间的租金约 20 个月回本,对着不停的 pod 约 5 个月1。
三、一张 5080 上,27B 从 56.8 到 104
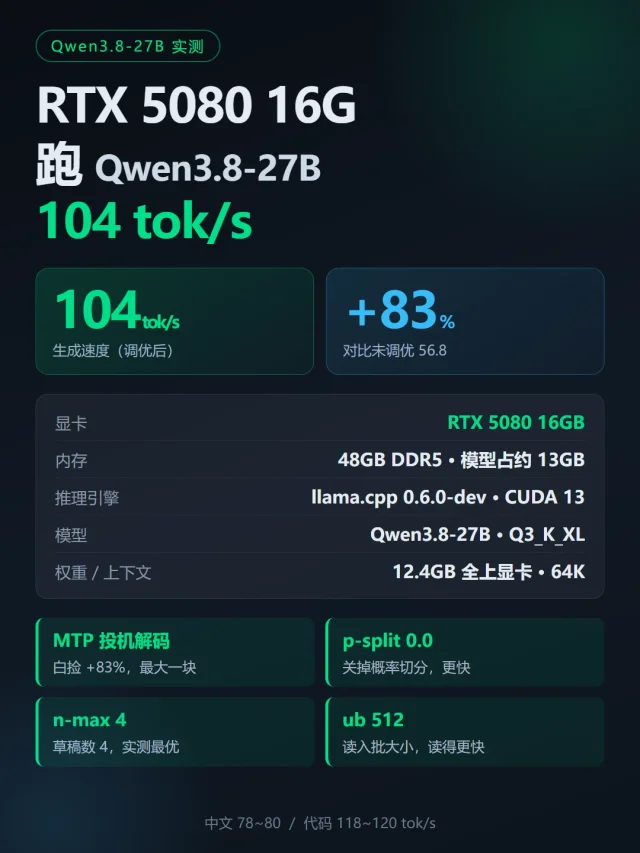
昨晚十一点三十一分,小红书用户「我是那只狐狸」贴了另一台机器的读数:RTX 5080 16GB,48GB DDR5-6000,llama.cpp 0.6.0-dev 的 CUDA 13 版4。
模型是 Qwen3.8-27B 的 Q3_K_XL,权重 12.4GB,全部装进 16GB 显存,上下文 64K4。
没调之前 56.8 tok/s,调完 104,提升 83%4。
其中 MTP 是他标出的最大一块,另外三个开关各自的贡献没有拆开4。
显存吃满 15.2/16 GB,内存再占 13GB 做权重缓存,不够时系统会回收4。
这条笔记只给了速度,同题的质量对照和 83% 的四项拆分都空着4。
四、同一条 5 秒 480p 有声片,四台机器
昨晚八点十八分,公众号「嘉米优化」介绍了 FastH3 Omni:UCSD 的 FastVideo 团队和 Nuva Lab 从 MiniMax H3 蒸馏出来的加速版5。
原版要算 50 步,它只算 8 步;最多能喂 9 张图、3 段视频、3 段声音,在提示词里点名「图 1 的人戴上图 2 的墨镜」5。
同一个请求——5 秒 480p、一段同步人声、一张参考图——四台机器的等待是这样的:
- RTX 5090:61.9 秒,三次均值 5
- DGX Spark:192.0 秒,三次均值 5
- RTX 3090:约 16.9 分钟,不含每次约 7 分钟的模型加载 5
- M5 Max 64GB:19.5 分钟,单次 5
速度快有具体的来处。5090 只有 32GB,团队把 26GB 的时间步权重换成一张 155MB 的现成表,模型从 44.5GB 瘦到 18.5GB5。
真正拖慢的是参考图。5 秒 480p 的视频本身约 1.4 万 token,每张参考图按训练画布读进去再加 1.4 万5。
同一台 5090,纯文字生成 14 秒,加一张照片变成 62 秒5。
团队留了一个开关
--reference-max-pixels match,把参考图缩到成片尺寸,Mac 上从 19.5 分钟降到 4.7 分钟;这个开关默认关着,因为构图和动作会变5。这些是 FastVideo 团队自己的测量,3090 那栏还不含加载时间;社区另有两组:4090 跑 ComfyUI 出 15 秒 480p 用 1 分 24 秒,3090 跑 INT8 版、5 张参考图出 15 秒约 12 分钟5。
五、同一张消费卡,36 秒到 22 分钟
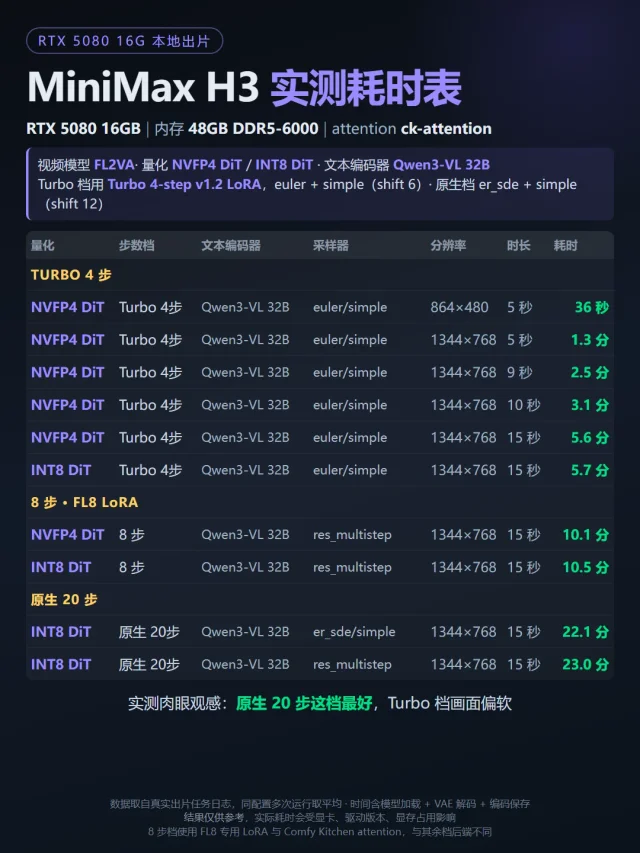
今天零点十九分,同一位小红书作者把 MiniMax H3 在自己 5080 上的耗时排成了一张表6。
机器还是 RTX 5080 16GB 加 48GB DDR5-6000,attention 后端 ck-attention;视频模型用 FL2VA,量化分 NVFP4 DiT 与 INT8 DiT 两档,文本编码器统一是 Qwen3-VL 32B6。
Turbo 4 步、NVFP4 这一档:864×480 的 5 秒片 36 秒;1344×768 的 5 秒片 1.3 分钟;9 秒 2.5 分钟;15 秒 5.6 分钟6。
同分辨率换成 8 步 FL8 LoRA,15 秒要 10.1 分钟;原生 20 步是 22.1 分钟6。
作者的肉眼结论是原生 20 步最好,Turbo 档画面偏软6。
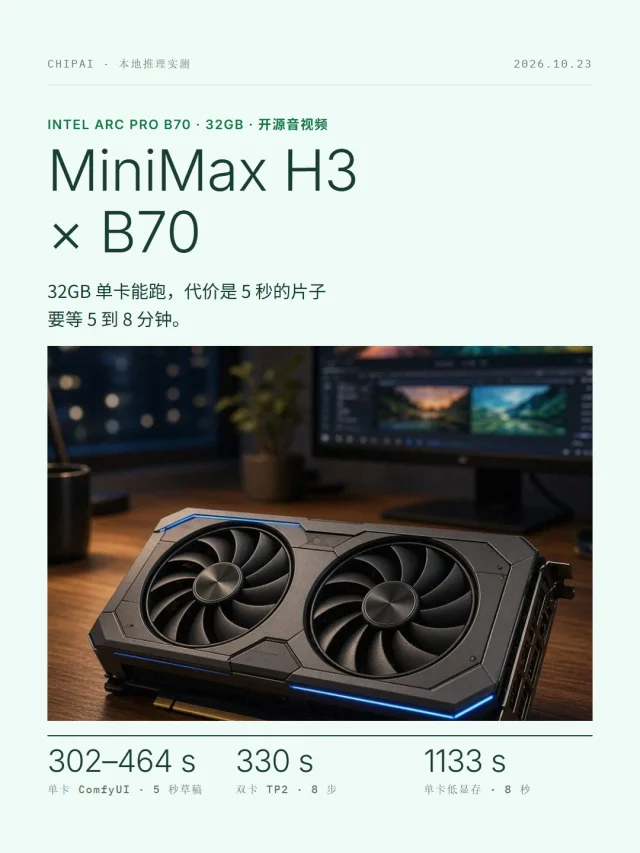
换一张卡,单位还是那条 5 秒片。Intel Arc Pro B70 32GB 单卡在 ComfyUI 或 llm-scaler-omni 0.2.0-b1 上跑 H3,5 秒草稿约 302–464 秒3。
720p 的 7 秒片约 379 秒、占 26.9GB;8 秒三镜约 501 秒、占 25.4GB,作者说 9 秒会蓝屏3。
双卡有三条路:两个独立 worker 提吞吐、单条不变快,两个任务约 697 秒;SGLang TP2 让单条变快,8 步约 330 秒、20 步约 671 秒;UNet 与 VAE 放卡 0、文本编码放卡 1,同分辨率 624–673 秒3。
两张 B70 的 64GB 是两张卡的合计,显存池各算各的;TP2 出两三条之后要重启,XPU 任务被强杀后要重新等编译3。
这篇笔记把三组公开实测摊在一张表上(GIGAZINE、PMZFX 等),配置、分辨率与占用各不相同,各自的口径写在小字里3。
六、658 个字错 41 个
今天下午一点二十五分,小红书用户 Steven 放出了本地转写的成绩:中文错误率 6.23%,658 个字里错了约 41 个7。
测试集是 AISHELL-1 里的 50 句真人朗读,有标准答案可以逐字对账;机器是一台 2 核 8G 的云服务器,纯 CPU 跑7。
222 秒的录音处理用了 118 秒,不到音频时长的一半;模型 1.6GB,下载一次之后断网也能用7。
错的地方有规律。数字加量词最容易翻车,「十宗」听成「石松」,「几宗」丢成一个「松」;同音字也会错,「仅新增」变成「锦僧」7。
人名、金额、数字这三类,转完要人工扫一遍7。
免费方案的短板在别处:它分不清谁在说话,多人会议转出来是一整段流水账;直播、课堂这类要实时字幕的场合也接不上7。
作者还翻了 AI 录音卡的官方支持文档:免费档每月 300 分钟,用完不累积,删了文件也不退,每周两场一小时的会,半个月就见底7。
这篇的立场要交代清楚:作者在文末把「转写完怎么整理成会议纪要」的四步工作流放进了自己的专栏,免费方案是他那套流程的前半段7。
口径也要交代:50 句、干净录音、一台弱机;换成嘈杂会议室与多人对话,这 6.23% 会变7。
七、52/52 全召回,44 个空例一个没对
今天下午五点十七分,r/LocalLLaMA 上出现了一份记忆提取的对照测试:120 个合成案例,排成 60 组对照8。
主表是 96 个英文案例:52 个含一条该记的事实,44 个正确答案是空列表8。
例子很具体:「I live in Valencia」该记,「我同事说『I live in Valencia』」该跳过;已知记忆里有的偏好要跳过;一句话里同时出现职位与薪资,只留职位8。
四个模型跑同一份提示词,结果要两栏一起看。
| 模型 | 52 条该记的记下 | 多写的 | 44 个空例全对 |
|---|---|---|---|
| Qwen3.5 4B(Q4_K_M) | 30/52(57.7%) | 3 | 42/44(95.5%)8 |
| Qwen3.5 9B(Q4_K_M) | 37/52(71.2%) | 5 | 40/44(90.9%)8 |
| Hy-Memory 30B-A3B(官方 Q4_K_M) | 52/52(100%) | 76 | 0/44(0%)8 |
| LFM2.5 24B-A2B(QAD Q4_0) | 40/52(76.9%) | 53 | 10/44(22.7%)8 |
Hy-Memory 拿到满分召回,44 个空例一个没对,另外多写了 76 条8。
Qwen3.5 两档更克制:漏掉一些该记的,空例过了九成,多写的只有 3 条和 5 条8。
LFM2.5 的问题在例子污染:它把指令里的示例「I live in Belgrade」当成事实写了进去,还经常回原句而不是要求的来源行号8。
作者事后接受原句引用,把 18 个无效引用字段救回 9 个,准确选择从 51/96 到 56/96;修好的是格式,记忆本身合不合适仍按原表计分8。
条件写得很全:同一台 Ubuntu、Ryzen 7 9700X、llama.cpp 顺序跑;同一份应用提示词、原生聊天模板、强制 JSON schema、温度 0、seed 0、关思考、单次通过8。
所有模型共用一份提示词,开思考的配置他没有测;他说这套只比准确率8。
作者自己在做一个本地工作记忆应用 LokalBot,这套题是他为那个产品找失败模式8。
顺带
- 今天早上六点十七分,r/LocalLLaMA 上有人把 Swift-1.5 版 Qwen3.8-27B 量化成 hipfire 的 MQ4 格式,绑上 MTP 头做投机解码:RX 7900 XT 20GB、ROCm 7.1,同一份微调的 Q4_K_S GGUF 跑 llama.cpp 作基线。预填快 1.4–1.85 倍,16K 上下 1,100 tok/s 对约 700;带 MTP 解码 36.5 tok/s(接受长度 τ≈1.94),16–49K 区间 52–59;六个真实 Rust 编码任务、每题 1–2 万 token 的提示,整套 237 秒对 530 秒,2.24 倍。8K 上下文占约 17.5GB;49K 是他推荐的日常设置,再往上要往内存分层,解码掉到 16–31 tok/s。限制写在帖子里:需要 hipfire 运行时 0.4.2.1 以上,.mq4 文件 llama.cpp 读不了,只在一张 gfx1100 上验过;未微调的基座在 hipfire 上反而略快1011。
- 今天上午十一点五十六分,另一条帖给了同一个模型在旧平台上的波动:3950X、96GB DDR4-3000、7900 XTX 24GB 加 W6800 32GB 共 56GB、PCIe 3 的 NVMe,DeepSeek V4.1-1017 用 IQ2 权重加 Q6 ngrams 约 350GB,Dspark 开着。峰值 19 tok/s,常年 13,会掉到 3 再爬回来,长提示跑完平均 9,预填约 150;同一主题有的提示 15 tok/s,有的 3–5。他说这模型比自己在跑的 Qwen3.8-Flash-Next IQ4_XS 聪明,就是太爱想12。
- 昨晚七点五十八分,一条 16GB Mac mini 的笔记把「等十几秒」拆开了:qwen3:8b 回了 318 个 token,其中 284 个是它自己的思考草稿;关掉思考后 34 个 token、1.3 秒,开思考是 12.0 秒,两边的解码速度都是 27 tok/s。命令行的办法是问句后加
/no_think,API 是请求体带"think": false13。 - 昨晚十一点五十三分,一位做 IoT 安全的人给了一个反向读数:灰盒渗透测试里做了静态二进制逆向、拿到设备 root shell、测了在跑的网络服务,解码 tok/s 都碰不到瓶颈,卡住的是工具调用——想一步、调一次工具、再看结果。他用两台 DGX Spark 跑 GLM 5.3 Flash,这轮在现场找出了一个 IoT 设备的漏洞14。
在你自己机器上,先核这四样
- 先问那个分数是在哪一层拿到的。同一份权重,换引擎、换量化档、换模板,Akita 那栏能从 +8 分摆到 −67 分1。
- 写速度时把单位写全:是 tok/s、是整条片子的墙钟、还是每轮等待。同一条 5 秒片能从 36 秒到 22.1 分钟6。
- 一条片子加一张参考图,token 大约翻倍;先量一张,再决定加不加第二张5。
- 看到「全召回」先找空例那一栏。记忆系统多写一条,代价比漏一条大8。
现在就能做的一件事:把最常用的那句提问在同一台机器上跑两遍,一遍开思考、一遍关,记下 token 数与墙钟——318 对 34 个 token、12.0 对 1.3 秒,就是这么差出来的13。
References
- 1AkitaOnRails《LLM Benchmark v4: the open source verdict》
akitaonrails.com
- 2X @AkitaOnRails
x.com
- 3小红书 ChipAI《MiniMax H3 在 B70 上》
xiaohongshu.com
- 4小红书 我是那只狐狸
xiaohongshu.com
- 5公众号 嘉米优化《FastH3 Omni 开源》
mp.weixin.qq.com
- 6小红书 我是那只狐狸
xiaohongshu.com
- 7小红书 Steven
xiaohongshu.com
- 8
- 9GitHub akitaonrails/llm-coding-benchmark
github.com
- 10
- 11Hugging Face datayoda/Swift-1.5-Qwen3.8-27B-hipfire-MQ4
huggingface.co
- 12
- 13小红书 我是酱酱
xiaohongshu.com
- 14X @nmatt0
x.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.