Google 的 AI 视频联合导演:四个项目组成一套框架,成片从 12 秒到 10 分钟
解读 Google Research 2026 年 9 月 24 日的官方博客:Co-Director、CANVAS、A²RD 与 VQQA 四个项目各自处理长视频的哪一段难点,81.4 分里有多少来自多跑几遍再挑。

2026 年 9 月 24 日,Google Research 发布博客《Automating coherent long-form video generation》,把四项工作并列成四根支柱:Co-Director、CANVAS、A²RD 与 VQQA1。四篇论文的投出时间跨了两个月:VQQA 在 3 月 12 日、CANVAS 在 4 月 15 日、Co-Director 在 4 月 27 日、A²RD 在 5 月 7 日2345,其中 Co-Director 与 CANVAS 已分别被 COLM 2026 和 EMNLP 2026 接收1。写这篇博客的 Yale Song 在四篇里都有署名,另一位作者 Yiwen Song 署名其中三篇2345。
博客把四者称作 "a unified multi-agent framework",读到论文才发现,这是一套共享思路下的四个独立项目,改动的都是生成器之外的那一层。四篇放在一起看,长视频一致性被推进到哪一步,取决于一件事:分数是从哪里买来的。
长视频的一致性在哪一步崩掉
博客对失败方式的分类很清楚:跨镜头之间的语义漂移,是人物的服装或场景在不知不觉间换了;级联失败,是上游素材的一个瑕疵污染了下游的合成;此外还有特征漂移,让实体与环境逐渐走样,以及内容塌缩,让叙事不再往前推进1。用 Co-Director 论文的话说,这是一个信用分配问题——成片失败之后,很难回溯到是哪一个提示词写坏了4。
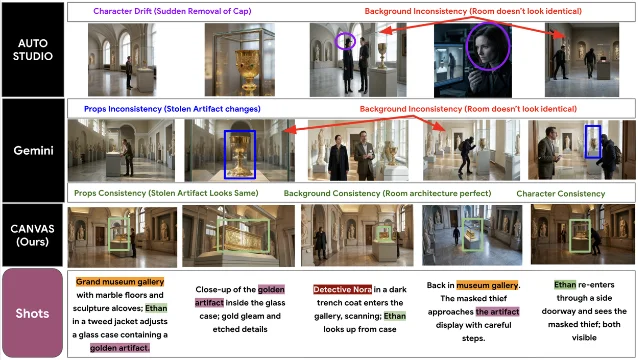
官方那张博物馆盗窃分镜对照图把这几种失败摆在了画面上:同一组提示词下,直接用 Gemini-3.1-Pro 生成时,被盗的金器在两个镜头之间换了样子、展厅布局发生位移;换成另一套多智能体框架 AutoStudio,盗贼的帽子在切镜之后消失1。
四个项目各修一段
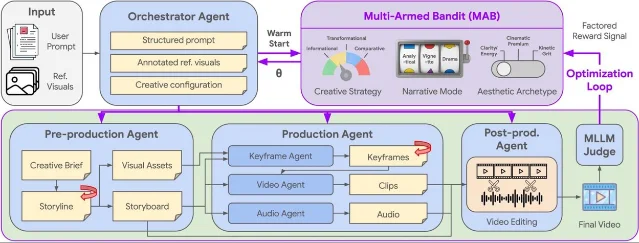
Co-Director 把整件事当成一个全局优化问题4。指挥层用多臂老虎机在三个正交维度上抽样一套"创作配置":创作策略(信息型、转化型、对比型)、叙事模式(分析型、小品型、戏剧型)、美学原型(明亮能量、电影质感、极简聚焦、粗粝动能)4。配置选中之后,指挥层把它翻译成每个子智能体系统提示里的具体指令,再走一条四段流水线:预制作层产出创意简报、剧情与视觉资产,合成分镜;制作层分关键帧、视频、音频三个子智能体;后期把片段与音轨拼成成片14。成片交回多模态裁判打分,分数按三个维度拆成因子化奖励回灌老虎机,用 UCB1 更新策略4。除全局搜索之外,剧情与关键帧还各有一条局部自细化回路,低于阈值就重写或重生成,每处重试上限三次4。
CANVAS 换的是另一件事:让系统记住世界。它把角色、地点、道具的状态维护成结构化表示,并保留一份持续视觉记忆——回到同一场景时从记忆里取回原来的视觉锚点,确实缺素材才新建;场景规划带位置感知,保证再次进入同一地点时空间结构不变13。
A²RD 动的是生成过程本身。它逐段生成,每段走一圈"取回—合成—精炼—更新",多模态视频记忆把每段拆成文本状态、关键帧与视频三份5。每段开始前,系统自适应选择生成模式:推进新剧情用外推,锚回已经出场过的角色与环境用插值15。帧级与段级还各有一层测试时自改,用来截断错误传播,整套方法不需要训练6。
VQQA 是四个里最轻的一个,也最像工程手段。它不问一条视频几分,而是按当前提示词动态生成视觉问题,把视觉语言模型的评语当作语义梯度,逐步改写文本提示词2。为了不让局部修改压过整体,它用一层全局挑选,在整条优化轨迹里挑出相对原始提示词得分最高的候选12。改动落在文本提示词这一层1。
涨了多少,和谁比
Co-Director 的分数出在自建的 GenAd-Bench 上:50 个虚构品牌、200 个产品、400 个场景,素材由 Gemini 3 Pro 与 Nano Banana Pro 合成,其中 15% 被人工判为不合格而重做47。
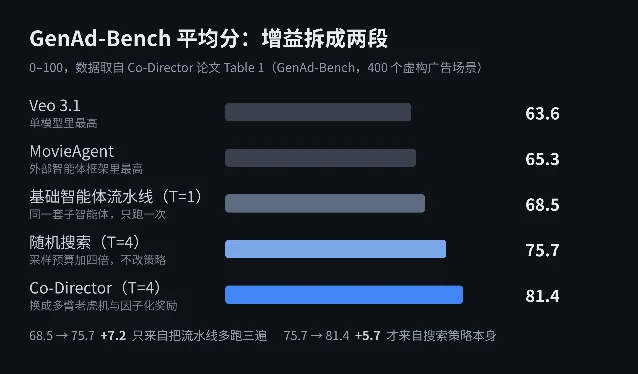
同一张表里,商业平台 Creatify 得 22.1、HeyGen 46.7,Kling 3.0 Omni 58.4,单模型里最高的 Veo 3.1 拿到 63.6,外部多智能体框架里最高的 MovieAgent 是 65.3,而表里最高的一格是 Co-Director 的 81.47。人类评分给出同样的方向:5 名评分者、50 个场景,Co-Director 平均 3.96 分(满分 5),Veo 3.1 是 3.717。
另外三篇给的是百分比。CANVAS 相对最强基线,把背景连续性提高 21.6%、角色一致性提高 9.6%、道具一致性提高 7.6%3。A²RD 相对此前的自回归方法,一致性最多提高 30%、叙事连贯最多提高 20%,覆盖 1 到 10 分钟的连续生成5,博客里配了一部 10 分钟的成片1。VQQA 相对原始生成,在 T2V-CompBench 上绝对提升 11.57 分、在 VBench2 上提升 8.43 分2。
增益从哪来
Co-Director 论文的实现细节写明:搜索预算 T=4,局部细化每处最多重试三次,最后的成片是 4 个镜头、一共 12 秒7。
把这些尺度放回分数里,增益的来源就清楚了。81.4 比最强外部基线 MovieAgent 的 65.3 高出 16.1 分;真正能拆开的是它自家那三格:基础智能体流水线(T=1,只跑一次)68.5,随机搜索(T=4,多跑几遍、不对策略做任何优化)75.7,Co-Director(T=4)81.47。前一段 68.5 到 75.7 的 7.2 分,只来自把同一条流水线多跑几遍再挑一个;后一段 75.7 到 81.4 的 5.7 分,才是多臂老虎机与因子化奖励的贡献7。论文自己的消融指向同一处:去掉关键帧细化,视觉资产保真度掉 9.8 分;去掉全部局部细化与全局优化、只跑一次,平均分降到 67.27。
一致性因此主要买在测试时的"评判—重生成"上:多跑、多看,把有问题的关键帧挑出来重做。这些增益的来源都在生成器之外——Co-Director 的底座仍是 Gemini 3 Pro、Nano Banana Pro、Veo 3.1、Gemini 2.5 Pro TTS 与 Lyria 24,VQQA 自称黑盒、只改提示词2,CANVAS 改的是喂进模型的视觉记忆与场景规划3。例外是 A²RD:它把段间记忆与段间模式切换做进了生成过程,也是唯一把尺度推到 10 分钟的一篇5。
三项新基准都由被打分的团队自己建
博客的综合评测用了三项新基准,三项都出自被打分的团队:GenAD-Bench 由 Co-Director 团队建,HardContinuityBench 由 CANVAS 团队建,LVBench-C 由 A²RD 团队建1。三条线各建各的、各评各的,评分者就是各自的作者团队。
裁判也是自家的。GenAd-Bench 用 Gemini 3 Pro 当多模态裁判4,而 Gemini 3 Pro 同时是 Co-Director 的底座模型4。论文为此补了一次人类评测来校准:50 个场景、5 名评分者,并列给出人类之间的一致性与模型对人类的贴合度7。四个维度里最弱的一列是视觉质量:模型与人类的 Pearson 相关 0.345、Spearman 0.317,人类彼此之间的对应值是 0.705 与 0.6757。论文的解释是,人按实时播放看,一闪而过的扩散瑕疵并不刺眼,模型逐帧分析则会严格扣分,于是这一列更像一道严格的画质闸门7。其余三维(视觉资产保真度、人群匹配、营销说服力)与人类上限接近7。
还有两处口径值得留意。博客的汇总表把 Co-Director 的提升写成"81.4 对 68.5、+18.8%",这个对照点是它自家只跑一次的 T=1 基础流水线,架构差异与采样预算差异被放进了同一格1;同一张表还把 VQQA 简写成了 VQA1。按论文 Table 1 的完整对照报数,读者才能自己判断哪一部分算得上新方法。
现在能跟进的部分
References
- 1Automating coherent long-form video generation
research.google
- 2
- 3
- 4
- 5
- 6
- 7
- 8GenAD-Bench Hub
co-director-agent.github.io
- 9Co-Director Project Page
co-director-agent.github.io
- 10CANVAS Project Page
ishani-mondal.github.io
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.