5125 万 token 里只有 162.8 万重新算过、189 组量化对照里最划算是先加模型档、8GB 显存解得开河题却数不清 BANANA
八组来自 Reddit、X、小红书与公众号的最新实测,每组在速度读数旁边并排给出一个校验读数——缓存复用率、草稿接受率、KLD、无损一致性,以及题目答对没有;原帖与作者自陈的限制都写在正文里。

10 月 14 日到 15 日这批实测里,速度读数已经不难拿到。
难的是证明快出来的东西还是原来那个。四张 RTX 4090 干完 5125 万 token 的活,其中真正重新算过的只有 162.8 万。同一张 RTX 5090 上,草稿接受率更高的那个解码模式反而更慢。一张 8GB 显卡上的 27B 解得开农夫过河的题,却数不清 BANANA 里有几个元音。
八组材料各自给出了一个能把自己那个速度数字证伪的读数。
| 材料 | 跑出来的那一栏 | 旁边那一栏 |
|---|---|---|
| 四张 4090 跑 380 步 agent 长任务 1 | 5125 万 token、192 tok/s | 缓存命中 97%;单轮 162,292 个 prompt 里复用 162,268 个 |
| 21 个 Qwen3.8-27B 量化档 × 9 种 KV 组合 2 | 189 组全部装进 16GB 显存 | 换模型档带来的 KLD 差,比换 KV 档大一个量级 |
| 5090 上 180 次请求的解码模式对照 3 | 概率接受 191.35、默认 187.8 tok/s | Gumbel 耦合起草接受的草稿更多,跑得却更慢 |
| RTX 3090 上的 273 tok/s 4 | 32K 上下文、温度 0、5 次中位数 | 贪婪输出逐 token 与普通解码一致,质量另有 KLD 与 GSM8K |
| 一道明渠题上的八个本地模型 5 | 两个小模型答得又快又对 | 出错的地方集中在同一个位置:过水断面 |
| 8GB 显存上的 27B IQ1_S 6 | 约 16 tok/s、8K 上下文 | 解得出河题,数不对 BANANA 的元音 |
| LFM2.5-24B-A2B 顶掉原先常驻的 Ornith 7 | 持续约 95 tok/s | 作者把机械活与「洞察」分开,后者还要再测 |
| 魔改 3080 20G 跑 27B 加 200K 上下文 8 | 生成稳定 40+、峰值 67.1 tok/s | 选它图的是给 KV、视觉与运行时留出的余量 |
380 步、5125 万 token,只有 162.8 万要重算
公众号 寂寞的熊猫 在一台四卡 RTX 4090 的机器上跑了 Swift-1.5-Qwen3.8-Flash-Next,这是一份 125B 级别的混合专家模型 1。
任务是一个标准 agent 文件处理流程:模型自己扫描项目、读代码、写工具调用、循环更新交付物。整轮跑完 7 次交互、连续 380 步工具调用,上下文从 13 万 token 推到 16 万。
客户端统计给出的总数是 51,257,679 token。模型纯计算用时 41 分 58 秒,本地工具调用 19 分 50 秒,平均输出速度 192 tok/s,首 token 平均响应 3 秒。
这 5125 万里真正重算的只有一小截。未缓存的新输入是 1,628,974 个 token,来自缓存读取的 49,362,752 个,命中率 97%;模型自己生成 265,953 个。输入与输出的比例接近 190 比 1。
引擎日志里连续四条真实请求,把这层意思说得更清楚。
| 请求总 prompt | 缓存复用 | 新输入 | 新读耗时 | 输出 | 解码速度 | MTP 采纳 |
|---|---|---|---|---|---|---|
| 152,317 | 99.6% | 578 | 677 毫秒 | 1206 token | 189.1 tok/s | 836/1086(77%) |
| 153,763 | 99.8% | 240 | 482 毫秒 | 104 token | 173.7 tok/s | 70/97(72%) |
| 161,732 | 95.1% | 7,864 | 3.4 秒 | 535 token | 159.9 tok/s | 326/493(66%) |
| 162,292 | 99.99% | 24 | 142 毫秒 | 1841 token | 174.3 tok/s | 1229/1749(70%) |
最后一行是这批材料里最干净的一个数。16.2 万 token 的上下文里,系统复用掉其中 162,268 个,只剩 24 个要重新计算,142 毫秒算完,模型几乎立刻开始出字。
第三行记的是 agent 新读一个 7,864 token 的文件,预填充速度 2326 tok/s,3.4 秒读完,随后继续以 159.9 tok/s 出字。
MTP 那一栏记的是草稿命中。输出 1206 token 那次,草稿头起了 1086 个、被采纳 836 个;输出 1841 token 那次,起了 1749 个、被采纳 1229 个。作者的读法是每 4 个 token 里约 3 个由草稿头猜中,主模型一次前向传播验证通过,实际吞吐因此翻倍。
硬件那栏同样平稳。四张 24GB 卡划出 81.5GB 显存,其中 46.8GB 把 24576 个专家权重全部装进显存,运行期间整机功耗 481 到 489 瓦,GPU 温度最高 50 度,CPU 占用 1%。
限制:一次任务、一个模型,没有对照基线。作者自己补了一层,投机解码的收益与任务类型绑得很紧——写小说或高发散话题时接受率会掉到 50% 以下,猜错回退反而增加计算耗时。
189 组对照之后,先加模型档、再加 KV
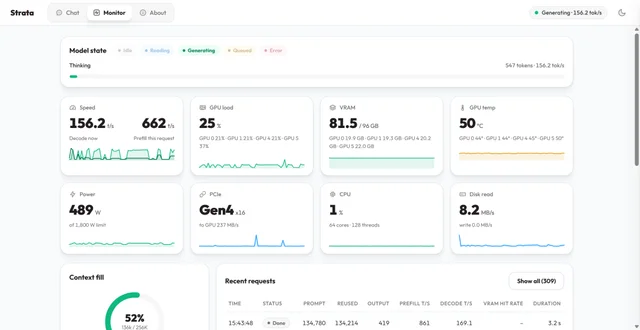
Reddit 上一位用户在 16GB 显存装得下的范围内,把 Qwen3.8-27B 的各档量化都跑了一遍 KLD(与原始模型输出分布的偏离程度,越小越接近)和困惑度 2。
组合一共 21 个权重文件 × 9 种 KV 量化档,合计 189 组。完整表格他贴在了帖子外的一条链接里 9。
| 权重档(体积) | KV 量化 | 平均 KLD | 同 top-1 比例 |
|---|---|---|---|
| UD-Q4_K_M(15.3GB) | q8_0/q8_0 | 0.008847 | 95.873% |
| UD-Q4_K_M(15.3GB) | q5_1/q5_1 | 0.009371 | 95.839% |
| UD-Q4_K_M(15.3GB) | q4_0/q4_0 | 0.010928 | 95.196% |
| UD-IQ4_XS(13.3GB) | f16/f16 | 0.016597 | 94.265% |
| UD-IQ4_XS(13.3GB) | q4_0/q4_0 | 0.018690 | 93.854% |
| UD-Q3_K_XL(12.2GB) | f16/f16 | 0.024517 | 93.116% |
| UD-IQ3_S(11.2GB) | q8_0/q8_0 | 0.036577 | 91.572% |
同一份权重里,把 KV 从 f16 压到 q4_0/q4_0,KLD 只从 0.0088 涨到 0.0109。换一份权重档,KLD 能从 0.0088 一路涨到 0.0366,差了一个量级。
所以他的三条建议很直接:KV 首选 q5_1/q5_1 这一对,它几乎总比 q8_0/q4_0 与 q4_0/q8_0 好;显存有限时先把模型档升到能升的最高一档、KV 用 q4_0/q4_0,再考虑加 KV;模型档从 6 往 8 走收益递减,那时加 KV 更划算。
前两条在表里互相印证:UD-IQ4_XS 用 q4_0/q4_0(0.018690)优于体积更大的 UD-Q3_K_XL 用 f16/f16(0.024517)。
限制:这套结论只覆盖低量化档,作者没有外推;像 Gemma 那类必须跑 f16 KV 的模型不适用;Bonsai 与 swift 是微调版本,与底座的 KLD 本来就不同,放进同一张表里比较没有意义。
评论区留下了一处不同意见。一位用户说,KV 缓存的损伤与权重量化的损伤性质不同,长上下文下最疼的是 KV,他宁愿缩短上下文做压缩也不上 q4/q4。作者回复说这次没有测长上下文,手里没有那份显存,但从别人已有的基准看,长上下文下 KLD 的数值会变,名次不变。
Loading content card…
接受率更高的那档,跑得更慢
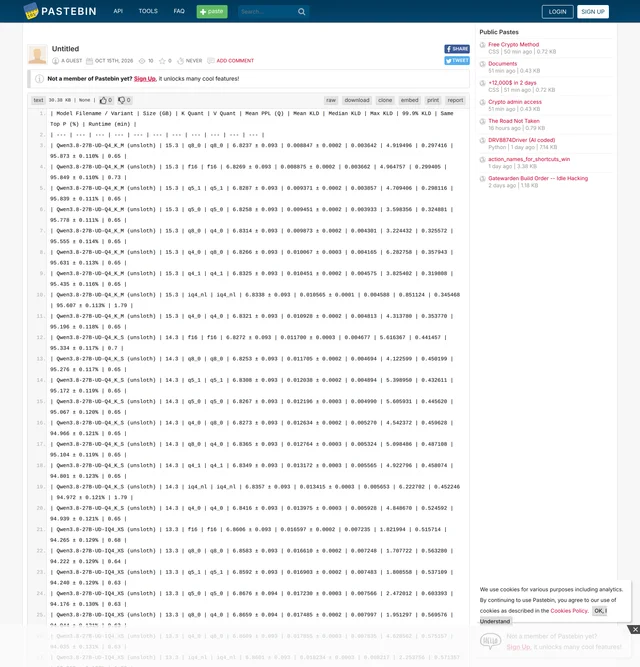
X 用户 @MarcelHolter 把自己的 agent 后端切到 Strata 0.1.41,机器是一张 RTX 5090、Ryzen 7 9800X3D 与 64GB 内存,跑 Qwen3.8-Flash-Next 的 IQ3_S 权重,配置里写着 262,144 token 上下文、INT8 KV、MTP 投机解码
--spec 4、专家常驻系统内存 3。他做了一次只换解码模式的对照:默认解码、Gumbel 耦合起草、概率接受三种,分三轮轮换跑,合计 180 次测量请求,另加预热。
概率接受的成绩是代码 191.35 对默认 187.8 tok/s,散文 186.0 对 183.1;中位请求耗时从 2.767 秒降到 2.708 秒(代码)、2.827 秒降到 2.782 秒(散文)。
他自己给这套数字定了性:小赢,值得测,不值得包装成突破。
同一批数据里的另一栏更有意思:Gumbel 耦合起草采纳的代码草稿比概率接受更多,跑得却更慢。他在这一节的末尾写了一句,接受率只是一个中间量,他真正要优化的是每个请求的耗时。
这批测量还做了一次交叉核对:180 条汇总与引擎日志里的生成记录逐条对上,重复是真的。
限制:工作负载很窄,两个短提示、每个 10 个种子、重复三轮,关思考、输出 512 token,冷缓存与缓存前缀混合;按种子合并后,概率接受只在代码上赢 7/10、散文上赢 4/10。它离 262K 上下文基准与任务质量评测都还隔得很远。
Loading content card…
273 tok/s 旁边写着「逐 token 一致」
X 用户 @coffeecup2020 给出的读数是一张 RTX 3090 上 273 tok/s,每一栏都写了条件:权重是 Qwen3.8-27B 的 TQ3_4S-v2、BF16 KV、32K 上下文、温度 0、5 次中位数 4。
这套数字跑的是 DFlash2 草稿的投机解码,他的说法是无损:主模型逐个校验草稿 token,只保留它自己本来会生成的那些,贪婪输出与普通解码逐 token 相同,这一条在最长 51K 的提示上做过测试。
质量另算一栏:对 BF16 模型的 KLD,加上 GSM8K 与任务检查。
他自己就是这套权重 TQ3_4S 的作者,帖子里直接写了这一层身份。
限制:单张卡、单一配置,数字由作者自报,没有第三方在同一台机器上复现。
一道明渠题,八个模型,错都在同一步
Reddit r/LocalLLM 上一位做水力学与流体力学的用户拿自己的真实问题去试了一批本地模型 5。
题干是两个大湖由一个宽 b 的窄口连通,上游湖水位恒定、下游湖体积有限、水流无粘、底高不变。
要问的是两件事:通过窄口的流量是多少,下游水位随时间怎么变。他先问过 ChatGPT 的 Pro 模式,答案不满意,于是想看看本地模型能不能更好,顺便给不确定的解法找点参照。
多数模型的解法停在同一条路上:用伯努利方程求窄口流速,说过水断面是什么,用流速乘断面得到流量,再写出微分方程求解。出错的地方几乎都在第二步。
| 模型 | 结果 |
|---|---|
| Gemma 4 26B-A4B | 很快做对,作者标为赢家 |
| Ministral 3 3B | 极快做对,作者标为赢家 |
| Qwen 3.6 35B-A3B | 做对,但慢 |
| Qwen 3.8 27B | 做对,很慢 |
| Ministral 3 12B | 第二步没写清水位,追问之后做对 |
| Gemma 4 e2b | 第二步出问题 |
| LFM2.5-20B-A2B | 第二步出问题,给过提示之后仍有问题 |
| LFM2.5-8B-A1B | 第一步就出问题 |
| ZAYA1-8B | 迷路 |
| ChatGPT | 第二步失败,用一个任意的参考水位去定过水断面 |
作者的结论是,这类任务上小模型能干活,但最小的那几档混合专家模型还不行。
限制:这是他个人的一道题与自己的判定,他给出的解同样只是一个近似,他也没在同一套条件下跑第二遍。
8GB 显存上的 27B:河题与 BANANA
同一天另一位用户贴的是一张 RTX 2070 8GB、i5-13600、Ollama 加 Open WebUI 的配置,跑的是一份从 Claude 4.6 Opus 推理蒸馏来的 Qwen3.5-27B,量化档 IQ1_S,速度约 16 tok/s,上下文只开 8192 6。
他把温度 0.75、Top-P 0.90、Top-K 40、Min-P 0.05、重复惩罚 1.05 这一整套采样参数也一并贴了出来。
两道题。第一道是农夫与两条鸡过河,船一次只能带一条,答案是分开送,模型答对了。第二道是 BANANA 里有几个元音,模型的推理一路数到「位置 2、4、6 是元音,一共 3 个」,最后落在的答案却是 2,中途还冒出过「BANANA 里其实只有一个 A」这样的句子。
标题里那句「8GB 显卡好过第二笔房贷」,说的就是这种落差。
限制:一个人、一次记录、两道题,作者自称是凑合着在用。
刚发布就被派去上班的 LFM2.5-24B-A2B
Reddit r/LocalLLM 上一位用户把刚发布的 LFM2.5-24B-A2B 换进自己几套工作流 7。
这台机器是一张 AMD W7900,走 ROCm 上的 llama.cpp 最新构建,Q8 权重占约 30GB 显存并开满 128K 上下文,持续速度约 95 tok/s。它顶掉的是这位用户原本常驻的 Ornith 1.5-35B。
他给出的是使用感受:机械性任务没失败过,长跑型递归任务也稳,作为「小一点的模型」跟更大的模型并排跑正合适。另一位 X 用户在发布当天给出的读数是 M5 Max 上 184 tok/s,并写明这个 24B 总参数、约 2.45B 激活的模型长于工具调用、短于编码 10。
评论区在这件事上分成了两路。一路认同速度,有人复述了那组 95 tok/s、Q8 全开 128K 且长跑稳定的数。
另一路质疑它是否比 Ornith 更好。一位回帖者说它只是更快;另一位说「在每天都开 Ornith 之后,什么都像是升级」,而在科学编码这类他自己常做的领域,Ornith 很难被替掉。工具调用的可靠性也被点名:一位用户拿编码实现任务去试,说 LFM 的工具调用失败很多;另一位建议把提示词固定下来跑 20 遍,再分开数格式错误的调用、重试与错参数,一次干净的演示说明不了模板修完之后 agent 是否真的可靠。这些争议都留在同一帖的回复里 7。
限制:作者没有给题目清单与对照基线,他自己也把「机械活」与「洞察」分开——后者要等他在多模型会诊的工作流里再跑一段时间才知道。
20GB 显存的妥协清单
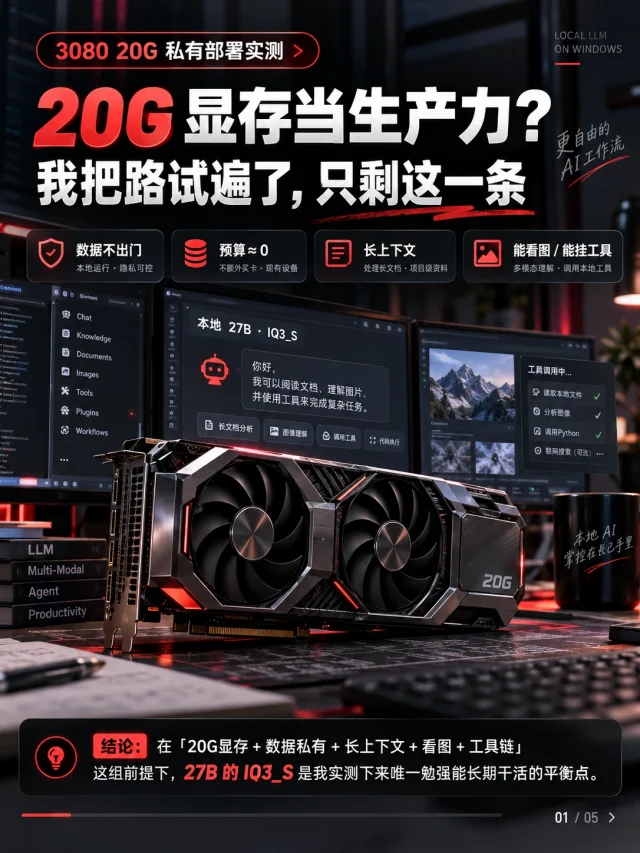
小红书上一位用户想让一张魔改的 RTX 3080 20G 真正干活,条件有四条:数据不出本地、不额外买卡、能看图、能调用工具,还要 200K 上下文 8。
他最后留下的组合是 Qwen3.8-27B-GSQ-RCO-IQ3_S-mtp(约 11.3G)配一份 Q4_K_S 的视觉 mmproj;上下文开 200K,MTP 开到 2,统一 KV,K 量化到 q5、V 量化到 q4——K 也压到 q4 的话,上下文能拉满到 256K。
实测速度是预填充 800 到 900 tok/s、峰值约 1100;生成稳定在 40+ tok/s、峰值 67.1;堆到 200K 的长上下文下部分测试仍有 30+ tok/s。
他选它的理由是留给 KV 缓存、视觉模块、MTP 与运行时开销的余量,而 Q4_K_M 在 20GB 里同时兼顾超长上下文和视觉时,余量太紧。
限制:这些数字来自不同负载,作者写明每一项只对应它当时的那组设置;IQ3_S 确有能力损失,复杂推理与细节稳定性不如更高精度档,他说这张卡上只有不断妥协后的平衡。
顺带几条
X 用户 @VectorCrossProd 用一台新机器把速度又推高了一档:RTX 5060 Ti 16GB 加一张 RTX 3070 8GB、只有 32GB 内存,Strata 0.1.44 跑 Qwen3.8 Flash Next Coder 的 IQ1_M。
在装载 154K 上下文的情况下解码 127 tok/s、峰值 154,整机 219 瓦,MTP 采纳 97%、每步 3.72 个 token。他顺手给了个对照:同一批活在他那台 R730 加 V100 上是 58 11。
X 用户 @BizTripper 在两张 RTX PRO 6000 Blackwell 96GB(无 NVLink、PCIe Gen5)、双 Xeon 6730P 与 504GB 内存上跑 Qwen3.8-Flash-Next NVFP4、256K 设置,自带基准的 Batch4/Clients4 五轮读数是 149.88 到 163.28、中位 157.37 tok/s 12。
Reddit r/LocalLLM 上有人把 27B 与 Flash-Next 各喂同一批活,用的是 5060 Ti 16GB 加 110GB 内存:非编码任务 27B 的回答更好、排版更整齐,编码任务 Flash-Next 更好也更快,同一句提示词生成 SVG 时 27B 明显赢。
他的结论按显存分档:有充足系统内存可以上 Flash-Next,16GB 以上显存就留住 Q8 KV,卡不到 16GB 的话质量只是「够用」 13。同一篇里他也记下了几个翻车档:Gemma4 12B 一次在「写五个笑话」上烧掉 32K token,一个去审查微调版的质量明显不如原版。
一家精酿厂把自己的后台整条搬到了本地:原先跑在 Claude Cowork 上的排程与 PDF 抽取,因为 Anthropic 把计划任务迁往云端而改成本地 Qwen3.8-Next-Flash 加 Gufo 引擎,用 Hermes 挂多个 bot 14。
一位买了 M5 Max Mac Studio 128GB 的用户在帖子里列了他踩过的坑,其中三条与本期同题。
判断一台机器要看总任务时间与输出质量,速度只是其中一栏;模型装得下只是一半,会话装不装得下要另算,内存还要留给对话、系统与工具;把上下文设得更大只是一行设置,长会话可靠不可靠要单独测 15。
看完可以先查四件事
这批材料里,出问题的位置几乎都落在速度之外的那几栏。
- 那条速度是在多长的上下文下测的,从 8K 到 150K,同一个模型可以差出一大截。
- 缓存复用率是多少;如果每轮都要重算历史,长任务的价格就落在预填充上。
- 草稿的接受率是多少,以及这件事是否无损——接受率高的那个模式不一定更快。
- 量化档与 KV 档各是哪一档,这两笔账要分开算。
References
- 1公众号 寂寞的熊猫:Swift-1.5-Qwen3.8-Flash-Next 长任务实测\
mp.weixin.qq.com
- 2Reddit r/LocalLLaMA:16GB 显存上的 KLD 扫描\
reddit.com
- 3
- 4
- 5Reddit r/LocalLLM:本地模型跑水力学题\
reddit.com
- 6Reddit r/LocalLLM:8GB 显卡上的 27B\
reddit.com
- 7
- 8小红书:3080 20G 跑 27B 加 200K\
xiaohongshu.com
- 9Pastebin:189 组 KLD 与困惑度原始表
pastebin.com
- 10
- 11
- 12
- 13
- 14Reddit r/LocalLLM:一家精酿厂的全本地后端
reddit.com
- 15Reddit r/LocalLLM:M5 Max 128GB 的十条教训
reddit.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.