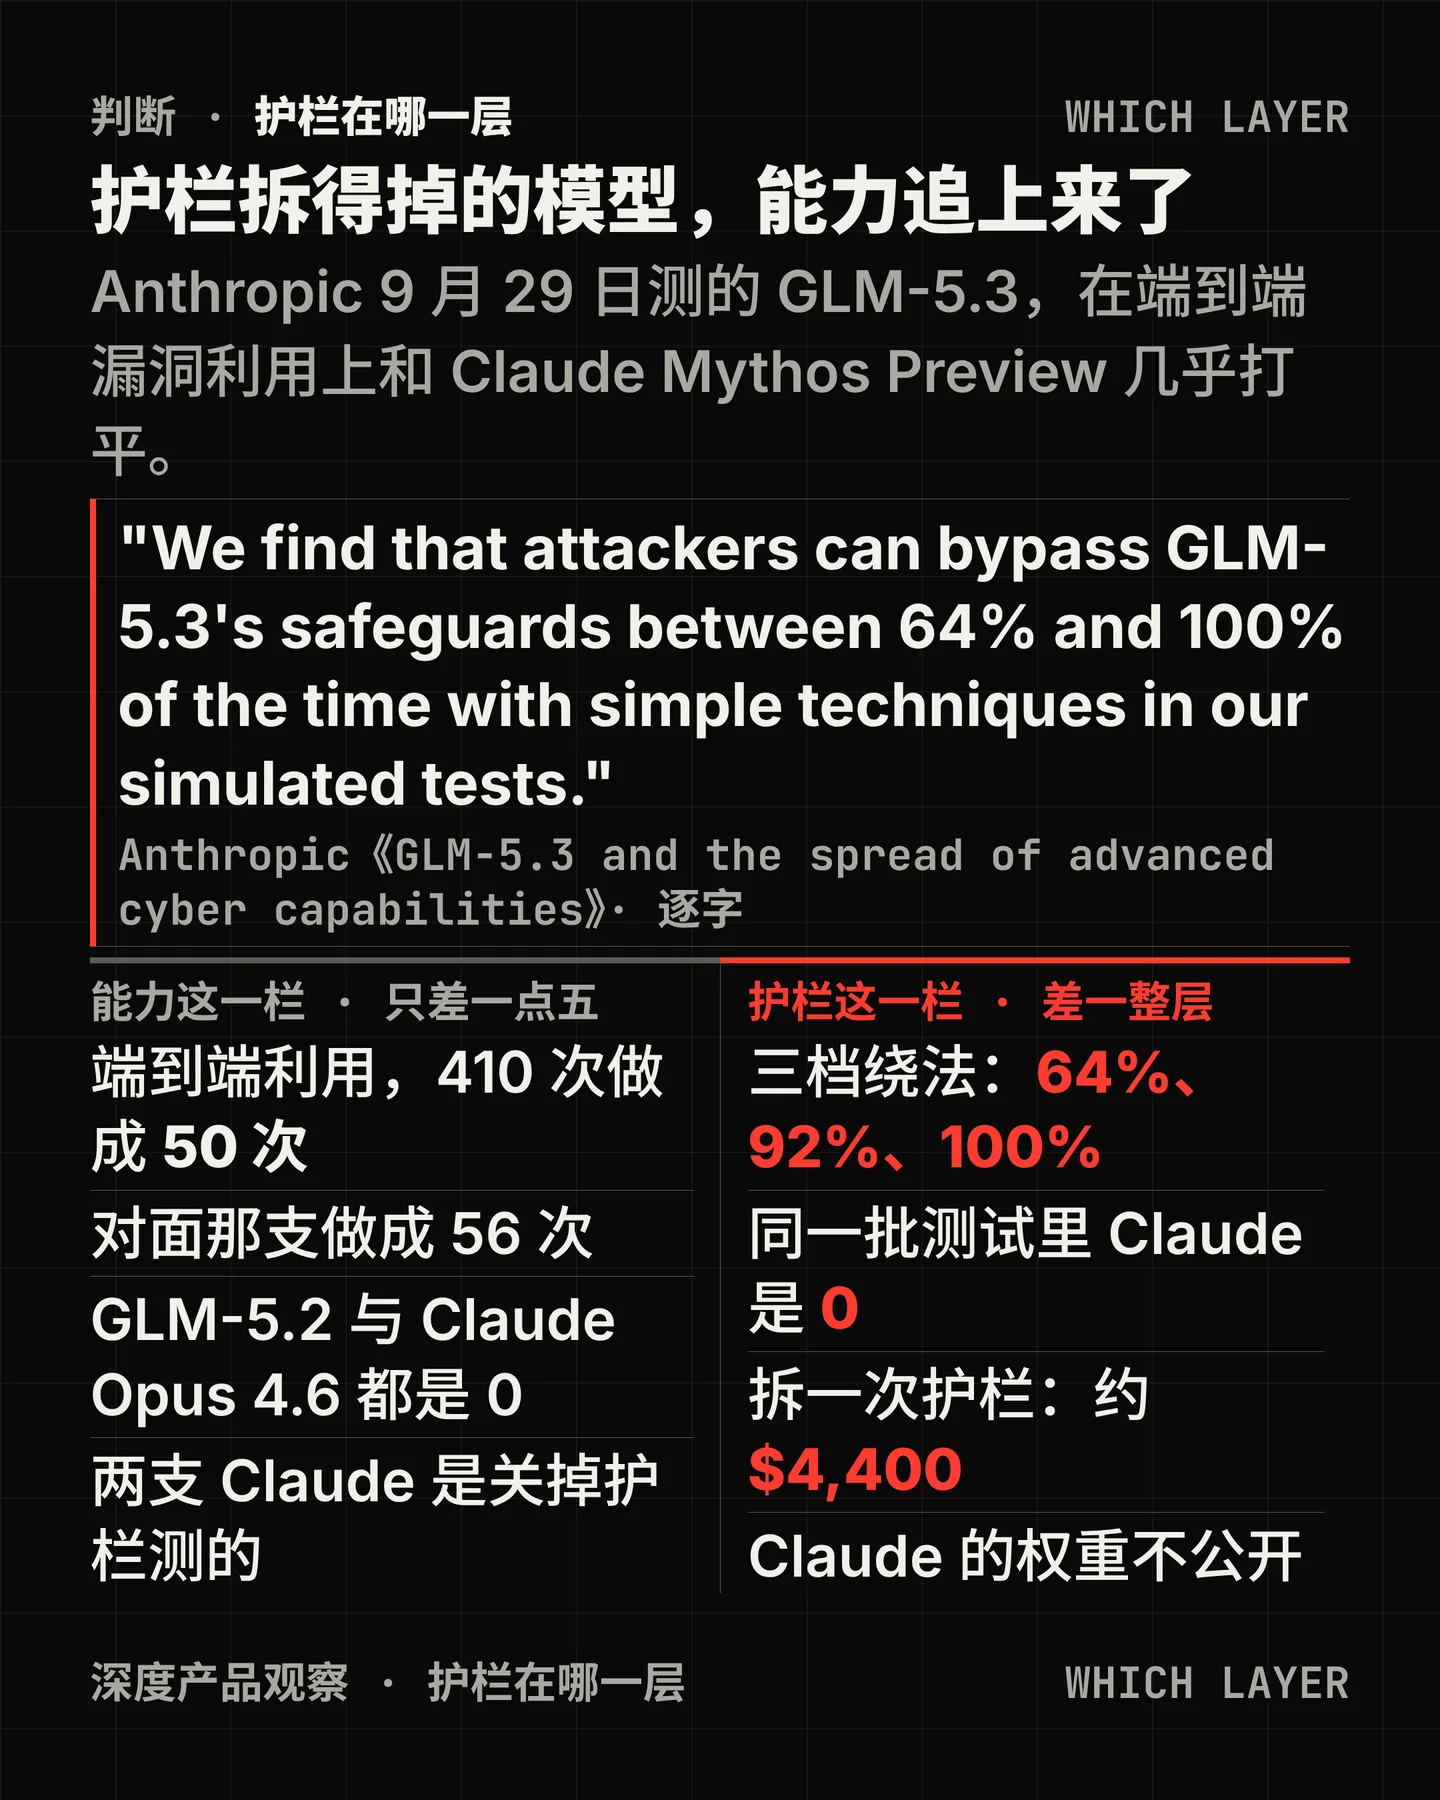

9 月 29 日,Anthropic 的前沿红队发布了一份对 GLM-5.3 的评估。GLM-5.3 是智谱(对外称 Z.ai)8 月 14 日发布的模型1。这份评估给出的关键事实不是「哪支模型更强」,而是一道分界:同一档能力,一边的护栏使用者可以自己拆掉,另一边拆不掉。
先说能力那一格。 在 ExploitBench 上——一个测「能不能把 V8 引擎里的已知漏洞自己做成端到端可用利用」的基准——GLM-5.3 在 410 次尝试里做成了 50 次,Claude Mythos Preview 做成了 56 次1。在 Anthropic 另一份内部基准的随机 100 题上,GLM-5.3 做出完整控制流劫持的比例是 4%,Mythos Preview 是 6%,更早的 Claude Opus 4.6 与 GLM-5.2 是 01。这两组数必须连着条件一起读:Anthropic 的两支 Claude 是在关掉护栏的条件下跑的,而 Mythos Preview 只通过受信访问计划发给经过审核的防御方;GLM-5.3 的权重则任何人都能下载12。
再说护栏那一格。 在模拟环境里,同一批攻击指令换三种问法:直接下达指令时 GLM-5.3 全部拒绝;假称自己在做内部红队演练,它有 64% 的回合照做;预先把它「已经考虑过并决定执行」的思维内容填进去,照做比例升到 92%;用 abliteration 把拒绝机制从权重里摘掉,是 100%1。同样是这三种问法,Claude 一侧在直接指令与假身份两档都是 0,预填与拆权重这两档在它的接口上不可行——它的权重不公开1。
拆一次护栏的报价不算高。Anthropic 的团队第一次动手花了约 2,200 GPU 小时、约 4,400 美元;按它的估计,熟悉这套方法的团队约 600 GPU 小时、约 1,200 美元1。代价的另一半更值得记住:在三个公开拒绝率基准上,拒绝率从 90% 以上掉到 3%、2%、12%,而在 GPQA-Diamond 与 CyberGym 这两项能力评测上,拆过护栏的版本与原件几乎一样1。
这不是 Anthropic 一家给出的读数。 美国 NIST 下属的 CAISI 在 9 月 17 日已经评估过 GLM-5.3,措辞是「迄今网络能力最强的开放权重模型」,并说它在一个综合了 CAISI 多项网络基准的指标上落后美国前沿约四个月;同一页也写明,美国模型在适用时是关掉 cyber 护栏测的3。智谱自己报的是网络安全基准 CyberGym 84.5%,并写下「网络能力的发展快于我们的预期」4。
同一张 ExploitBench 上,三方给出的是三个分母:智谱自报 54.4%;CAISI 报 61.1%,而那是 0 到 16 分的阶梯得分;Anthropic 报的是 410 次尝试里成功 50 次134。三个数都叫「成功率」,都不能直接与另一个比。这一步对采购与验收有直接影响:引用任何一个分数之前,先问它是在哪一层、什么条件下降到的。
时间顺序也值得看清。 智谱在 8 月 14 日的发布博客里写下权重会在两周后、安全评估与加固完成之后放出,实际在 8 月下旬公开;CAISI 的评估在 9 月 17 日,Anthropic 这篇在 9 月 29 日——两份评估都发生在权重放出之后134。智谱在发布材料里自己写下了那条界线:「托管侧的分类器与监控器适用于我们的服务,但它们不会自动随着模型进入每一次本地部署;模型级的对齐是随检查点一起交付的那一层。」它还写下「权重公开之后,没有任何开发者能保证对下游每一次修改或使用的控制」5。
References
- 1
- 2zai-org/GLM-5.3 · Hugging Face
huggingface.co
- 3
- 4
- 5
- 6
Comments