北美 AI 观察|AI 加速部署,版权、数据、培训与人工责任都要先过关
美国推动 AI 轻监管与训练 fair use,企业、学校和加拿大政策则把数据控制、培训、透明度和人工责任推到部署前台。
先给判断
本期覆盖窗口为 2026 年 8 月 31 日 08:45 至 2026 年 9 月 3 日 08:45(UTC+08:00)。窗口内的北美 AI 进展指向同一个现实:部署速度仍在加快,能让部署进入学校、企业和公共服务的条件也在变得更具体。
美国在 G20 场合推动较轻的 AI 监管路径,并把训练使用创作者作品解释为 fair use(合理使用);Anthropic 把企业误用监测的数据、密钥和人工复核边界交回客户;美国学校已经普遍使用 AI,却缺少足够培训和家长知情;加拿大则把透明度、事故追踪和代理活动记录列入负责任采用的基础设施。读者真正要核对的,是每一项部署有没有留下版权依据、数据控制、人工责任和退出路径。
先看五条线
| 线索 | 已发生变化 | 读者要看什么 |
|---|---|---|
| 美国政策与版权 | G20 联合声明支持避免专门针对 AI 增设规则;美国司法部在 OpenAI 版权案中提交支持 AI 训练 fair use 的 brief。 | 创作者保护如何落地,法院如何裁决。 |
| 企业安全 | Anthropic 发布 Enterprise Frontier Safeguards(EFS),让客户掌握监测数据的存储、密钥、访问政策和审计日志。 | 客户团队能否接住告警,跨账户监测如何保持效果。 |
| 学校采用 | 美国中学课堂每周使用 AI 的比例达到 73%—76%,接受大量 AI 培训的教育工作者只有 20%。 | 学校有没有公开使用规则、培训和家长沟通。 |
| 加拿大治理 | 加拿大政府把 AI 生成内容、AI 交互、系统信息、事故和代理活动列为透明度政策的五个对象。 | 咨询文件会转化成哪些通知、记录和报告义务。 |
| 社会态度 | Ipsos 汇总页显示,44%的美国成年人认为 AI 工具提高了工作生产率,44%反对新建美国数据中心。 | 使用便利与就业、社区成本之间的落差。 |
美国先推“轻监管”,版权问题留在法庭
9 月 2 日,商务部长 Howard Lutnick 在北卡罗来纳州 Chapel Hill 举行的 G20 创新部长会议上主张允许 AI 公司使用创作者作品训练模型,同时寻找保护艺术家的办法。他把 fair use 作为应被采用的原则,却没有给出具体的补偿、授权或申诉机制。Reuters 同日报道称,G20 国家随后发布联合声明,未来规则应只处理现有法律尚未覆盖的 AI 新问题,中国也在签署方之列。Nvidia CEO Jensen Huang 则主张把规则重点放在现实问题上,而非“理论伤害”。1
同一天,美国司法部向曼哈顿联邦法院提交 brief,支持 OpenAI 在《纽约时报》版权案中的立场,认为 AI 训练通常构成对版权材料的 fair use。brief 属于政府提交给法院的意见,具有咨询性质;它给诉讼中的 AI 公司增加了政策支持,却没有替法院作出裁决。《纽约时报》则表示,AI 公司应为支撑产品的内容公平付费。2
这里出现了一个具体的部署条件:模型公司希望把训练数据使用纳入既有版权原则,创作者需要知道作品如何进入训练、如何获得补偿、如何提出异议。美国政府已经表达方向,执行机制仍待法院和政策文件继续给出。
企业把数据放回客户手里,监测责任也一起回去
Anthropic 9 月 1 日发布 Enterprise Frontier Safeguards。EFS 面向 Claude Code、Claude Enterprise、Claude Platform 以及多家云平台的企业客户,计划在 2026 年秋季分阶段扩大可用范围。它把用于误用监测的活动数据存放在客户控制的 AWS、Google Cloud 或 Microsoft Azure 账户中,客户可以使用自己的加密密钥、访问政策和审计日志。3
Anthropic 仍然提供自动安全监测。系统在一段滚动时间窗口内寻找跨会话、跨账户的严重滥用信号,包括发展攻击性网络或生物能力的尝试,以及被盗或泄露的凭证。告警直接发送给客户团队,Anthropic 员工不需要进行人工复核;客户可以决定哪些人查看数据、怎样保存数据,以及如何处理告警。EFS 的客户自有存储、客户管理密钥和全自动复核都是可选项,云存储产生的费用由客户向云服务商支付。3
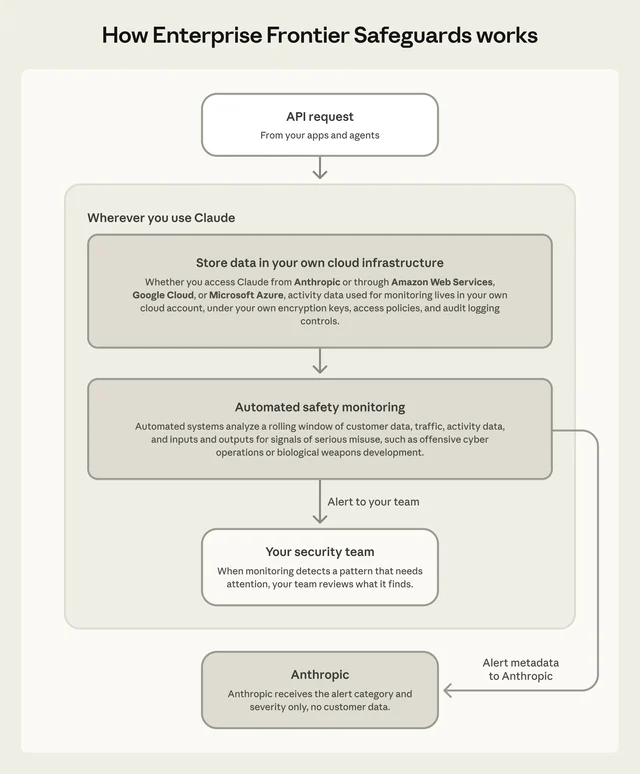
这套安排把“能否部署”拆成两件事:模型供应商负责检测能力,客户负责数据托管、访问和人工处置。r/artificial 的一篇公开讨论帖在 2026 年 9 月 2 日 20:19(UTC+08:00)提出了一个值得追问的技术问题:客户数据各自留在隔离存储后,跨客户的新型攻击信号怎样汇总。帖主 Servola-Journal 还指出,公告说明了存储位置和人工复核边界,尚未说明检测架构的全部细节。该帖发布时有 2 分、75%的赞成率和 4 条评论;一条评论认为存储与检测可能已经解耦,另一条评论则提出获准企业仍可能共享反馈信号。这个讨论反映的是公开技术社区的疑问,样本很小,地域和专业背景也无法代表企业客户整体。45
学校已经在用,培训和家长知情还在后面
IBM 于 9 月 2 日发布一项由 Morning Consult 执行的美国 K-12 调查。调查在 2026 年 7 月在线进行,覆盖 1,019 名教育专业人士和 1,029 名 K-12 学生家长,结果按目标人群加权,两个样本的误差范围均为正负 3 个百分点。样本来自 IBM 委托的调查,所以结果适合描述受访教育工作者和家长的判断,适合与其他民调并读。6
调查显示,76%的初中教师和 73%的高中教师称课堂至少每周使用 AI,45%的高中教师称使用频率达到每天或几乎每天;小学教师的对应比例为 45%。准备工作落后于使用速度:只有 20%的教育工作者接受过大量 AI 培训,42%把培训或专业发展不足列为支持 AI 素养的首要障碍。只有 24%的教育工作者和 16%的家长认为美国教育系统“适应得非常好”。6
家长也在要求更清楚的参与方式:77%的家长希望参与孩子课堂使用 AI 的方式,只有 20%的家长明确了解学校给孩子的 AI 指导;51%的家长希望学校先给出更清晰的规则,48%希望学校提高课堂 AI 使用的透明度。学校面对的具体问题因此从“要不要用”转向“谁批准、谁培训、谁告知、谁复核学生受到的影响”。
加拿大把透明度写成采用条件
加拿大创新、科学与经济发展部公开的透明度咨询文件,把负责任采用拆成五个可记录的对象:识别 AI 生成内容、让个人知道自己正在与 AI 互动、提供关于 AI 系统能力和限制的一致信息、追踪严重 AI 事故,以及记录 AI 代理的活动和互动。文件把透明度定义为通知、披露、解释或报告,服务对象可以是用户、企业链条中的其他组织、监管机构或研究者。7
这份文件属于征求意见和政策设计材料,读者可以把它看成一份检查表,而不是已经生效的统一法律。它还引用加拿大统计局数据称,2026 年第二季度,19.2%的加拿大企业在此前 12 个月使用 AI 生产商品或提供服务,高于一年前的 12.2%,约为 2024 年比例的三倍。随着采用率上升,企业需要留下的记录也会从模型说明扩展到代理做过什么、事故怎样发生、用户何时被告知,以及哪一个组织负责纠正结果。7
总体民调、X 和 Reddit 各自回答不同问题
总体调查给出的信号是“使用增加,接受有条件”。Ipsos 2026 年 8 月 20 日发布的美国 AI 观察汇总页显示,44%的美国成年人认为 AI 工具提高了工作生产率,50%的受雇美国人称在工作场所看到 ChatGPT 或类似工具,44%对美国新建数据中心表示强烈或有些反对。该页面汇集多项调查,指标和调查时间各有差异,不能当作一份单一问卷的统一结果;它更适合用来观察使用、基础设施态度和工作感受之间的并列关系。8
公开 X 上的讨论更像即时传播样本。Bloomberg 的认证账号 @business 于 2026 年 9 月 3 日 07:45(UTC+08:00)转发 G20 轻监管报道,抓取于 2026 年 9 月 3 日 09:01(UTC+08:00)时显示 15,422 次浏览、9 个赞、2 次转发、0 条回复和 2 个书签;账号当时约有 1,043 万粉丝。这个帖子说明政策消息如何进入平台信息流,互动量受账号规模、发布时间和平台推荐影响,无法推导美国或 G20 公众的总体态度。9
Loading content card…
Reddit 则把一部分注意力放在实现细节上:r/artificial 的 EFS 讨论帖关注客户自有存储之后,检测信号怎样跨账户工作;截至抓取时,帖子只有 2 分、75%的赞成率和 4 条评论。作者身份是 Servola-Journal,公开资料无法确认地域和职业背景。这个样本能帮助读者发现公告留下的技术问题,却只能代表一个公开英语社区中的少量讨论,不能替代总体调查。4
Loading content card…
把三类材料放在一起,得到的判断比较窄,也更有用:总体调查衡量人们怎样使用和评价 AI,X 反映政策消息怎样扩散,Reddit 暴露产品说明会让技术用户追问哪些边界。三者的分母、时间和参与机制都不同,读者应把它们分别放回各自的问题里。
接下来核对什么
- 版权:美国司法部的 brief 如何影响诉讼,法院是否对训练使用作出具体裁决,政策是否补上创作者的授权、补偿和申诉机制。
- 企业:EFS 何时从分阶段推出走向广泛可用,客户安全团队是否能独立处理告警,跨客户检测信号和数据隔离之间如何平衡。
- 学校:学校是否公开 AI 使用规则、培训安排、家长通知和学生申诉路径。课堂使用率本身只能说明工具进入了教学现场。
- 加拿大:透明度咨询是否形成针对生成内容、AI 互动、事故和代理活动的具体记录义务,企业能否在供应商更换后保留完整审计链。
- 个人与社区:AI 带来的时间收益是否转化为更公平的工作安排,数据中心和高风险 AI 应用的成本由谁承担,出了问题之后谁能暂停系统并给出人工处理。
北美 AI 的下一阶段仍然会追求更快的模型和更广的应用,但部署能否持续,取决于这些具体条件是否跟得上。版权边界、客户数据、学校培训、透明度记录和人工接管路径,正在成为判断“已经能用”与“值得放进现实流程”的分界线。
References
- 1Reuters:美国敦促 G20 允许使用创作者作品训练 AI
reuters.com
- 2Reuters:美国政府支持 OpenAI 与《纽约时报》的版权争议立场
reuters.com
- 3
- 4
- 5r/artificial:关于存储与检测解耦的评论
reddit.com
- 6
- 7
- 8
- 9
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.