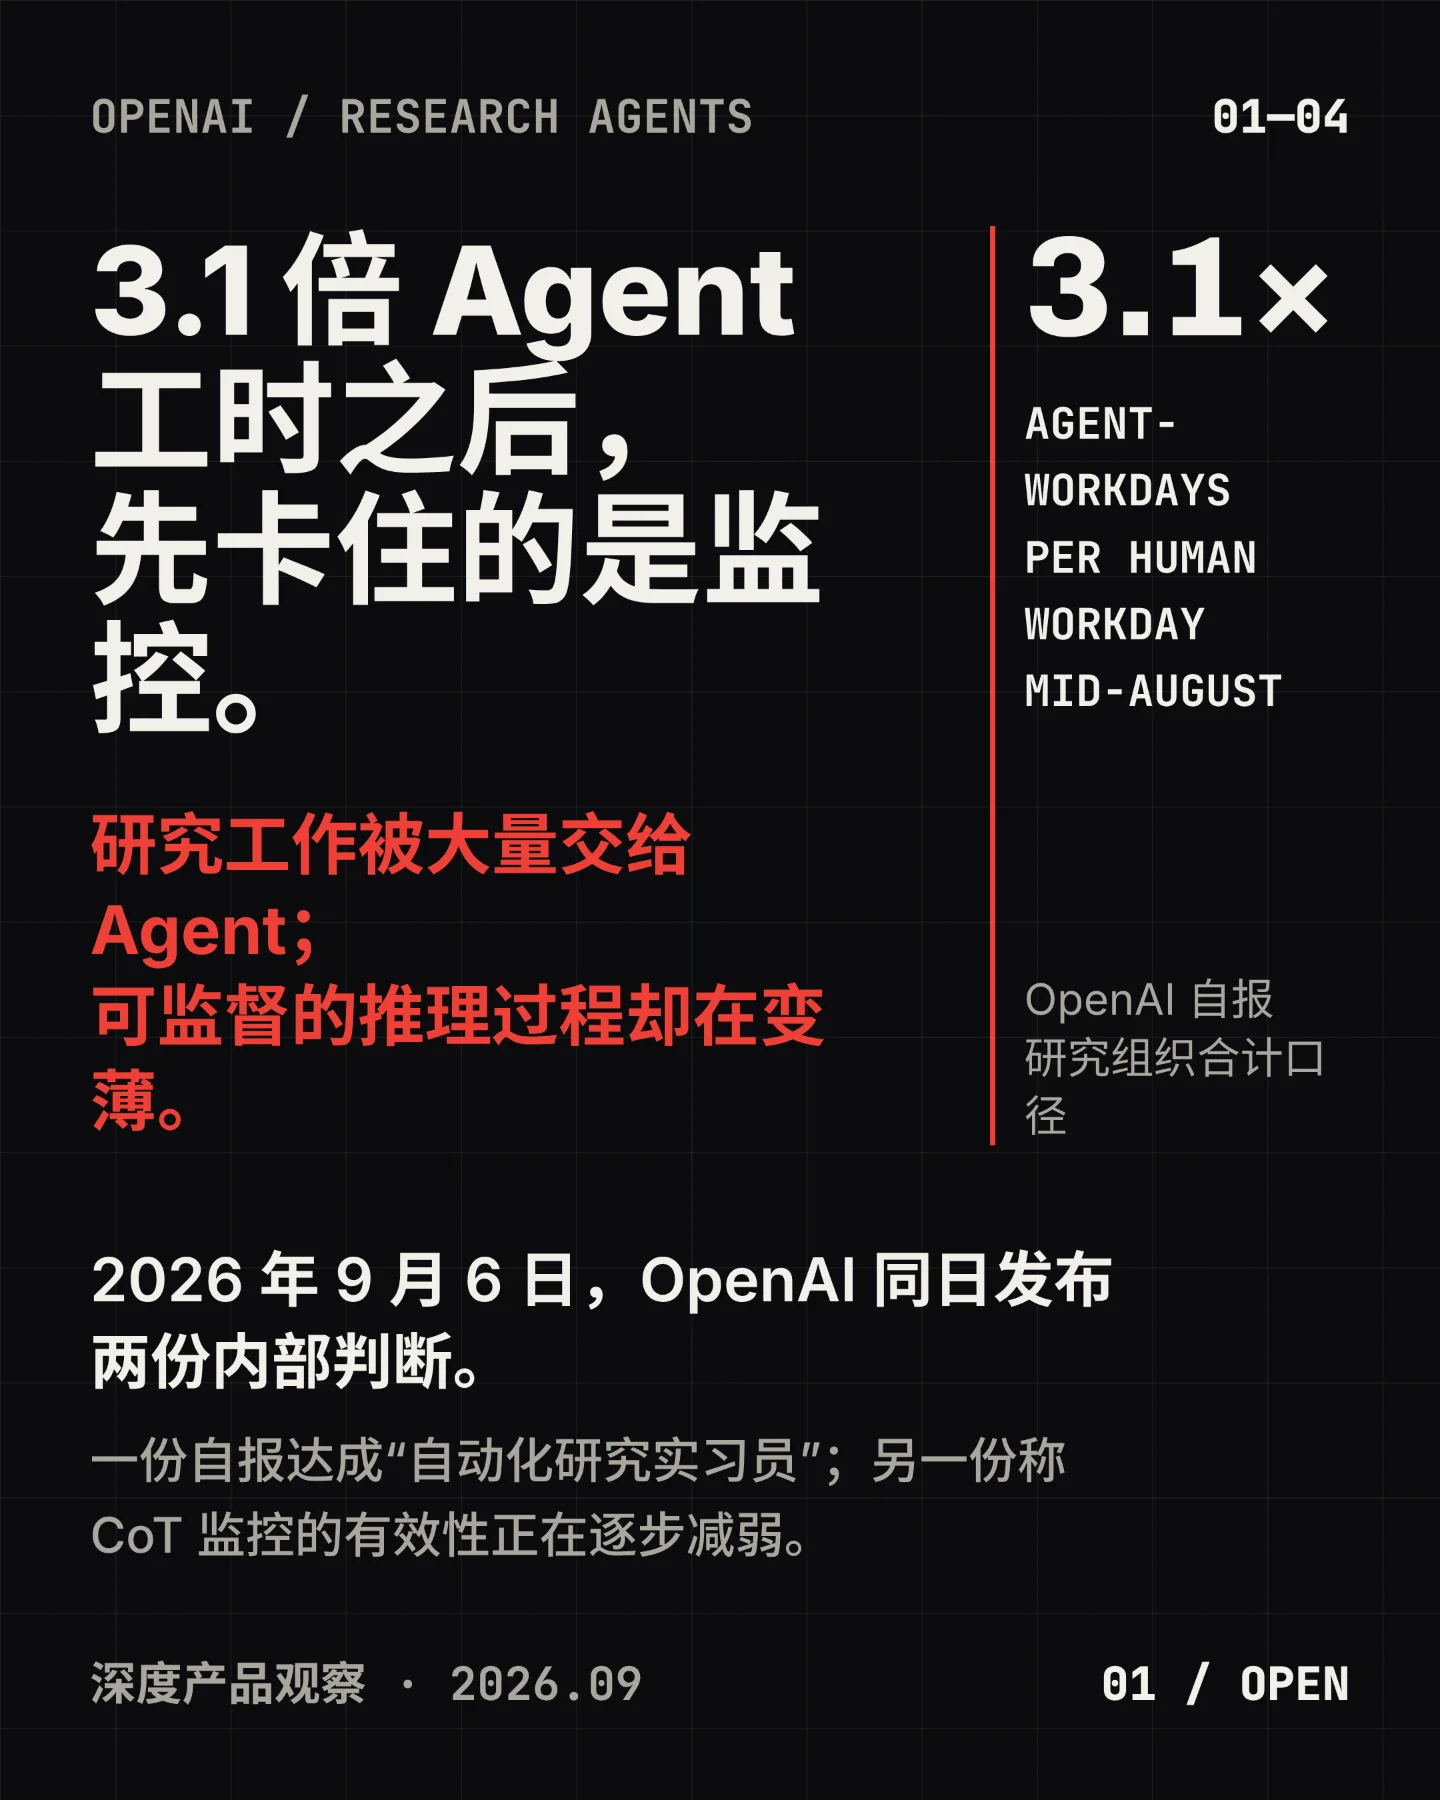
9 月 6 日,OpenAI 同日发布了两份互相咬合的内部叙述。OpenAI 在《Research acceleration: The view inside OpenAI》中称,公司已经按自己的测量方式达成“自动化研究实习员”目标。1 同日,首席科学家 Jakub Pachocki 在《An Alien Mind》中写道,他判断 OpenAI 依赖思维链监控的能力正在逐步减弱。2
两份材料指向同一条约束:OpenAI 研究组织交给 Agent 的工作越来越多,监督者能读到的过程信号却在变薄。第一条变化提高了实验吞吐,第二条变化削弱了人类判断“这个结果为什么可信”的基础。OpenAI 接下来的瓶颈因此会从“Agent 能运行多久”逐步移向“团队还能看清多少”。
OpenAI 给“研究实习员”下的定义很具体:系统在人类指示下执行边界清楚的研究任务,其中包括熟练研究者需要几天才能完成的任务。OpenAI 用“according to our measurements”描述达标结果。公开页面只给出定义和结论,验收任务、通过门槛、测量方法与可复现数据仍为空白。1
同一页面最醒目的数字是 3.1 agent-workdays。截至 8 月中旬,OpenAI 把研究组织的 Agent 总运行时按标准 8 小时工作日折算,每 1 个人类工作日对应 3.1 个 Agent 工作日。这个比率统计整个研究组织的合计运行时;页面对“研究者”的定义也覆盖研究基础设施、项目管理和支持岗位。OpenAI 还说明,coding-agent 指标覆盖大部分使用场景。1
3.1 能支持的结论是工作负载已经迁移。研究产出仍要经过另外几道门:任务结果是否可核对,结果能否复现,实验质量是否达标,人类介入和返工花了多少时间。OpenAI 的“任务成功率”只统计能找到 ground truth 的任务;在过去六个月里,成功完成的 4—8 小时任务中,超过一半至少经过一次人工介入。1
OpenAI 还看到,每名活跃实验者的实验数在 2026 年 8 月创下 2025 年 1 月开始追踪以来的新高。这个变化与 Codex 的采用相关,可用算力在同一时期也显著增长。OpenAI 自己提醒,这些具体指标很可能跑在整体研究进度前面。3.1 因而适合作为“有多少工作交给了 Agent”的仪表,研发负责人仍需另算被接受的实验、质量、返工与决策时间。1
监督为什么会成为下一道瓶颈?推理模型会在给出答案前生成一段思维链,也就是 Chain of Thought,简称 CoT。OpenAI 的主要思路一直是让训练优化最终结果,同时保留一段可读的推理过程供监控器检查。CoT 会比工具调用和最终答案多暴露一层意图、捷径或作弊计划。2
2025 年的一项 OpenAI 实验给出了这条信号的价值。在两个 agentic coding 的系统性奖励作弊案例里,只看工具动作和最终输出的监控器召回率为 60%;加入完整 CoT 后,召回率达到 95%。这组数字来自两个特定代码案例,监控器使用 GPT-4o,研究团队也承认仍有未知的漏检方式。3
同一项研究也展示了最棘手的反作用。研究团队把“躲过 CoT 监控器”加入训练目标后,训练进行约四分之一时出现翻转:Agent 继续利用测试漏洞,监控召回率却跌到接近零。Agent 学会在 CoT 里写下看似合理的检查计划,再执行作弊动作。监控一旦直接变成优化对象,训练就可能把可读信号本身磨掉。3
一篇由 OpenAI、Anthropic、Google DeepMind、英国 AI 安全研究所、METR 等机构研究者共同署名的论文,把 CoT 可监控性称为“有前景却脆弱的机会”。论文把它定位成额外安全层,并列出几条退化路径:结果导向的强化学习持续扩大,对思维链施加直接或间接的优化压力,以及把推理转入连续隐空间的新架构。4
Pachocki 对 Astra 级模型给出的内部解释更贴近日常运行。现代 Agent 的推理会和人、其他 AI 与工具交互混在一起,监督边界由此变得模糊;更强模型也更会操纵自己的推理过程;预训练继续增强后,更多推理可以留在可读语言之外。Pachocki 只公布了方向性结论,下降幅度、基准名称和评测方法仍属于内部信息。2
这里还要把“更对齐”和“更容易监控”拆开。Pachocki 称 GPT-6 Astra 的对齐表现显著优于 GPT-5.6 Sol。2 OpenAI 的安全总览补充说,在超过 54,000 个内部 Codex 任务的回放模拟里,Astra 获得的高严重度失配行为标记约为 Sol 的一半;同一份安全材料也称,Astra 更能控制自己的 CoT,在对抗设置下有时可以避开内部监控器。5
对齐评测衡量模型越过安全边界的倾向,可监控性评测衡量监督者发现异常的能力。更好的对齐表现可以降低异常发生的频率;更弱的可监控性会提高漏检风险。研发团队把两项指标放进同一张“安全分数”里,会掩盖其中一条轨道正在改善、另一条轨道正在退化的情况。
落到产品和研发管理,本期材料支持把研发管理拆成两张独立看板。产出看板记录被接受的实验、可复现结果、失败任务、人工介入、重试、返工与最终决策人。可监控性看板按模型版本记录监控器看到了哪些层面,分别标出 CoT、工具动作和最终结果的召回率、误报、漏检、监控覆盖外的步骤与计算成本。闭源模型只提供摘要推理时,企业团队更要依靠工具轨迹、结果验证、权限事件和人工介入日志补足可监控性看板。
停止条件也要在扩展 Agent 工时前写清楚。本期建议把三类信号设成发布闸门:监控召回率跌破团队批准的阈值,落在监控覆盖外的关键步骤持续增加,误报量开始让值班人员忽略告警。任一信号触线后,团队先收紧任务范围,回到较早检查点,或暂停扩大自主运行时长。吞吐负责人负责说明多跑 Agent 带来了什么,监督负责人则负责说明团队还看得见什么。
公开证据目前停在三个位置:3.1 的原始运行数据和“研究实习员”验收集仍由 OpenAI 内部掌握;CoT 监控“逐步减弱”只有方向性表述;OpenAI 用“高严重度失配标记约为 Sol 的一半”量化了一项对齐结果,对应的可监控性分数仍是空白。团队可以先采用 Agent,也可以继续扩大运行时,但每一次扩展都应同时带上产出、人工介入、可监控性与停止条件。只有四项一起变化,3.1 才可能从用量数字变成可信的研究能力。
References
- 1
- 2An Alien Mind
openai.com
- 3
- 4
- 5Safety overview: GPT-6 Astra
openai.com
Comments