Kasparov 说「萎缩是选择」,LeCun 说棋是「心智健身房」:两边的证据各有多少
LeCun 把国际象棋、围棋与部分纯数学叫作「心智健身房」,Kasparov 说「萎缩是选择」;本篇把这两句话背后的证据各摊开一遍,并核对那篇被反复误传的 MIT 脑电预印本到底写了什么。

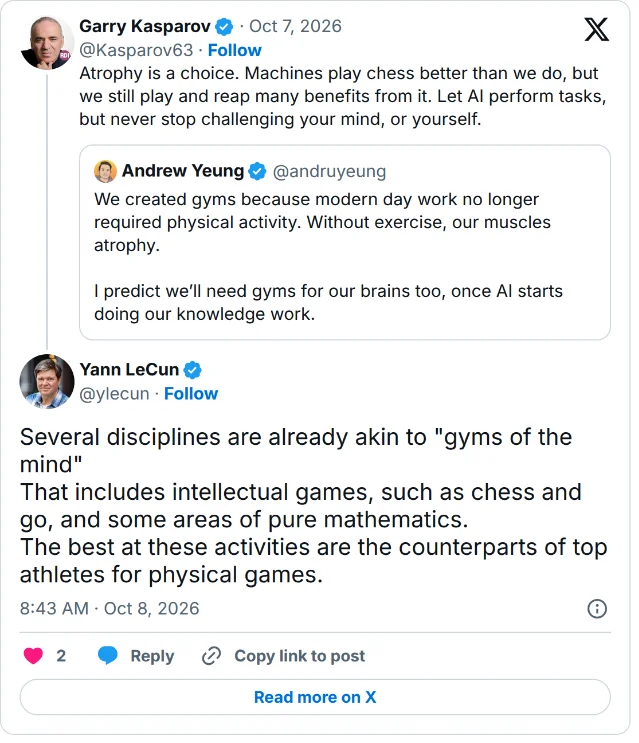
北京时间 10 月 8 日 16:43:49,Yann LeCun 在 Garry Kasparov 的一条帖下面回了三行字:若干学科已经算是「心智健身房」,包括国际象棋、围棋这类智力游戏,也包括纯数学的某些领域;这些活动里最强的人,相当于体力项目里的顶级运动员。1
七分钟前,他把 Kasparov 那条原帖转了出去。2
Kasparov 那条帖写于北京时间 8 日凌晨 3 点 24 分,三句话:「萎缩是一种选择。机器下棋比我们强,但我们仍然在下棋,并从中得到许多好处。让 AI 去执行任务,但永远不要停止挑战你的头脑,或者你自己。」3
而这条帖,本身是在回应另一位发帖人 10 月 5 日的一段推想。
把 Kasparov 的「萎缩是选择」和 LeCun 的「心智健身房」放在一起,就是一套完整的立场:机器把活接过去以后,人不必然退化,因为有些活动本身就是训练。前一句话有证据支撑,后一句的证据最薄——练出来的东西,带不走。
01 三条帖,一次表态
这条链的源头在 10 月 5 日。
那天上午 10 点 53 分,Andrew Yeung 在 X 上写下这样一段:「我们造出健身房,是因为现代的工作不再需要体力活动。没有锻炼,肌肉就会萎缩。我猜,等 AI 开始做我们的知识工作以后,我们也会需要给大脑的健身房。」4
到本篇发稿,这条帖有 1.39 万个赞、1292 条回复和 209 万次浏览。4
Andrew Yeung 住在纽约,在个人主页上把自己写成「做企业、投公司、写字、办活动」的人,经营科技行业的聚会品牌 Fibe 和招聘社群 The Shortlist,此前在 Google 做过全球产品负责人、在 Meta 做过商业规划运营。5
两天后,也就是 10 月 8 日凌晨 3 点 24 分,Kasparov 把这段话引了过来,加上自己的判断。
Kasparov 的身份不需要多解释:1985 年到 2000 年的国际象棋世界冠军,1997 年在纽约以 3.5 比 2.5 输给 IBM 的深蓝,那是计算机第一次在标准比赛时限下击败在位世界冠军。6
输掉那场比赛的第二年,他自己设计了「高级国际象棋」:两名棋手各配一台引擎,引擎负责找候选着法,人负责决定走哪一步。首届赛事 1998 年 6 月在西班牙莱昂举行,他执 Fritz 5 对 Veselin Topalov 执 ChessBase 7.0,六局三比三。7
又过了十九年,他写了《Deep Thinking》。8
六天前,也就是北京时间 10 月 2 日上午 9 点,他在回复一位网友时说,新书「很快就要出,里面有关于 AI 的更新,还有很多别的内容」。9
LeCun 的身份同样清楚:纽约大学教授、图灵奖得主、Meta 前首席 AI 科学家,现在自己开公司做世界模型。1
三条帖的次序很清楚:一个纽约的社群经营者提出比喻,一个下过那盘棋的人接过来,一个做模型的人给出定义。
热度说明谁被听见,另有一件事决定谁说得对:「萎缩」和「健身房」这两个说法,哪一边背后有测量。
02 说会萎缩的一侧,账本
这一侧的看法很朴素:能力靠使用维持,不用就退。它老得比 AI 早得多。
1983 年,伦敦大学学院的 Lisanne Bainbridge 在《Automatica》上写了一篇四页的短文,叫《自动化的反讽》。她写下过一句后来被反复引用的话:越先进的自动控制系统,操作者的贡献可能越关键。10
她的理由是这样的:自动化接走的是正常工作状况,留给人的是它处理不了的情况——也就是最难、最罕见的那部分。而人的技能只能在「使用加反馈」里维持,所以自动化越彻底,人越难保持接管时需要的水平。她在同一篇里写得更直接:「技能不用就会退化,尤其是那些关于增益和时机的细微手感。」10
同一篇里还有一句更值得记住的:当时那些自动化系统由老一代手动操作员看着,等于在借用他们的技能,而下一代操作员不会有这些技能。10
四十三年后,这段话几乎是逐字地在知识工作里重演。
记忆这一侧最早被量到的效应出现在 2011 年。哥伦比亚大学的 Betsy Sparrow、威斯康星大学的 Jenny Liu 和哈佛的 Daniel Wegner 在《Science》上发表了四个实验,结论是:当人预期某个信息以后还能查到,他对这条信息本身的记忆就更差,而对「去哪里查」的记忆更好。11
第一个实验测到的这项差异是 t(68)=3.26,P<0.003,达到统计显著。11
这就是后来被叫作「Google 效应」的那组实验。它记下的是记忆怎么被分配,能力的涨落不在这次测量的范围里。
再往后十年,才有了针对 AI 的行为测量。
2023 年,科隆大学医院等机构的 Thomas Dratsch 和同事在《Radiology》上做了一次实验:27 名放射科医生读 50 张乳腺钼靶片,先给 10 张「AI 全对」的片子做铺垫,剩下的 40 张里有 12 张,所谓的 AI 会故意给出错误建议。12
结果是断崖式的。AI 建议正确时,三档经验的医生判读正确率分别是 79.7%、81.3% 和 82.3%;AI 建议错误时,掉到 19.8%、24.8% 和 45.5%。12
经验最少的一组最容易被 AI 的错误建议带走。12
这是一份少见的硬数字:机器出错的时候,人跟着一起错,而且越没经验的人跟得越紧。
同一类结论在问卷层面也出现过。2025 年 1 月,SBS 瑞士商学院的 Michael Gerlich 在 MDPI 的《Societies》上发表了一份 666 人的调查,报告 AI 工具使用与批判性思维之间的相关系数是 r=−0.68,回归系数 β=−1.76。13
这份研究有两个要一起读的地方。
一是它在 2025 年 9 月 10 日发过更正:原发表的表 4 是表 3 的重复,属出版错误,作者声明结论不受影响。14
二是它是一份横断面问卷,测到的是相关,方向无法确定:批判性思维本来就弱的人,也可能更依赖 AI。13
中文互联网上被转得最多的一份,是麻省理工学院媒体实验室 2025 年那篇脑电研究。
它的实际内容是:54 名参与者分三组,分别用 ChatGPT、搜索引擎和不借助任何工具写议论文,全程戴脑电帽;研究一共四轮,第四轮只留下 18 人,让他们在对调的小组里再写一次。结论是 LLM 组的脑连接性最弱,搜索引擎组居中,纯脑力组最强,LLM 组对自己所写内容的「归属感」也最低。15
这份研究是预印本,到现在没有经过同行评审。作者自己在项目页上注明,所有结论都只作初步看待,并列出样本小、地域集中、只用了单一模型、任务只有议论文写作等局限。16
它受到的批评是有名有姓的。维也纳大学与德累斯顿工业大学的四位研究者写过一份评论,指出的问题包括样本量有限、分析可复现性、脑电分析方法本身,以及若干结果报告的不一致。17 这份评论同样是预印本。
另有一篇经过同行评审的文章在《Frontiers in Developmental Psychology》上指出,这项研究的被试是 18 到 39 岁的成年人、执行功能早已发育成熟,而且神经连接性的下降不能直接读成学习结果的下降。18
被评论的那份脑电研究测的是连接性差异和自报的感受,「能力有没有变差」不在它的测量范围里。样本 54 人,成人,单一模型,单一任务。15
再补一个同期的对照。
北京时间 10 月 6 日零点,麻省理工斯隆管理学院在自己的网站上登出了一篇文章,介绍该院全球经济学与行为科学教授 Eric So 的新书。文章里有一句是他本人说的:「外包思考会带来认知萎缩。」19
他把这个现象叫「AI 引力」,并把人脑和肌肉的废用性萎缩直接对上。同一篇文章还给了他的一个分类:用 AI 的人分成两类,一类用它想得更好,一类用它代替思考。19
这一侧的账本是这样:一条四十年前的机制,一条十五年前的记忆测量,一份有明显设计缺陷但数字很硬的放射科实验,一份只能证明相关的问卷,一份被反复误传的预印本,以及一组方向相同的同行表态。
这六样加起来,撑不住「AI 让人变笨」这么宽的结论。它们撑住的是一个窄得多的判断:当你把某段判断交给机器、自己不再做那段判断时,那段判断会变差。
问题在于另一半。
03 说这是健身房的一侧,账本
LeCun 那句定义里藏着一个前提:下棋、下围棋、做纯数学,等于锻炼一般的心智能力。
这个前提,心理学界测了二十多年,结论和直觉相反。
2010 年,剑桥 MRC 认知与脑科学部的 Adrian Owen 和同事在《Nature》上发表了当时规模最大的一次脑力训练实验。研究者借 BBC 一档科普节目招募了 11430 名 18 到 60 岁的参与者,随机分组,做了六周训练,训练任务覆盖推理、记忆、计划、视空间和注意力。20
结果是:每一个被训练的任务,参与者的表现都提高了;但没有任何一项提升迁移到了没被训练的任务上——连与训练任务密切相关的任务都没有。20
跨基准测试的组间效应量落在 0.01 到 0.22 之间。20
2016 年,七位心理学家在《Psychological Science in the Public Interest》上发了一份期刊委托的权威综述,把这批研究分了层:对被训练的任务本身,证据充分;对「接近但不相同」的任务,证据少得多;对远迁移和日常认知表现,几乎没有证据。21
棋类单独被拎出来测过。
利物浦大学的 Giovanni Sala 和 Fernand Gobet 做过一项元分析,覆盖 24 项「用国际象棋教学提升认知」的研究、40 个效应量。合起来的结果是:一般认知能力 d̄=0.34,数学成绩 d̄=0.38,读写成绩 d̄=0.25。22
这组研究者自己指出了一处要害:24 项研究里几乎没有一项设了主动对照组,安慰剂效应无法排除。22
配套的是一个反面结果。英国教育研究院的一项研究让 1965 名五年级学生接受一整年、共 25 到 30 小时的国际象棋教学,另有 1900 名学生作为对照,一年后两组在语文、科学和数学成绩上没有差异。22
至于「下棋练出来的是什么」,Gobet 更早的工作给得很清楚:国际象棋专家看真实棋局时,复盘能力远超新手;换成随机摆放的棋子,这点优势就大幅缩水甚至消失。23
专家的强,强在对特定局面攒下的识别结构上。这套结构跟着棋盘走,不跟着人走。
回到「脑力健身房」这个比喻。
认知卸载同时带来好处和代价,这一点 2016 年就被写清楚了。滑铁卢大学的 Evan Risko 和伦敦大学学院的 Sam Gilbert 在《Trends in Cognitive Sciences》上做的综述给出的结论是:卸载对外部记忆有好处,对内部记忆有代价,两样同时发生。24
但他的句子还有一层更强的意思:这些活动能替代性地维持一般心智能力。这一层,现有实证不支持。
04 这场争论真正做过的那个实验,是棋
国际象棋和围棋各自经历过一次无法重做的自然实验:机器先超过人,然后看人怎么走。
国际象棋这边,机器超过人已经二十九年。
1997 年 5 月的那六局结束后,深蓝退役进了史密森尼博物馆,它当时用 32 个处理器、每秒评估约 2 亿个局面。6
人类没有停手。2024 年,Merim Bilalić 和同事在《British Journal of Psychology》上发表了一项分析:他们把 1985 年到 2021 年间顶级棋手的 1160 万手决策拿出来,逐手用 Stockfish 评估。25
结论是:人类顶尖棋手的决策质量在这 1160 万手里稳定上升;只有最年轻的顶尖棋手在 1990 年代末出现过一次明显跃升,整条曲线没有与两次引擎换代对应的骤变期——一次是 1990 年代末的传统引擎,一次是 2010 年代中期的神经网络引擎。25
论文里有一句原话:「出人意料的是,这一波以神经网络为动力的引擎并没有显著影响最顶尖的棋手——至少到现在还没有。」25
围棋这边的时间线短得多。
2016 年 3 月,AlphaGo 在首尔以 4 比 1 击败李世石,五局比赛据 DeepMind 官方统计有超过两亿人观看。26 韩国棋院给了这个程序九段,是第一次有计算机围棋程序拿到最高段位。26
一年后,DeepMind 公开总结了 AlphaGo 带出的几手新着。文章里最著名的一条是「早期三三进角」:传统教科书认为这个定式让出太多外势、不适合开局,AlphaGo 的做法是把其中几手交换省掉,让角部悬着不解决。文章写道,韩国顶尖棋手金志锡在正式比赛中采用了另一条 AlphaGo 的变例,并且赢了。27
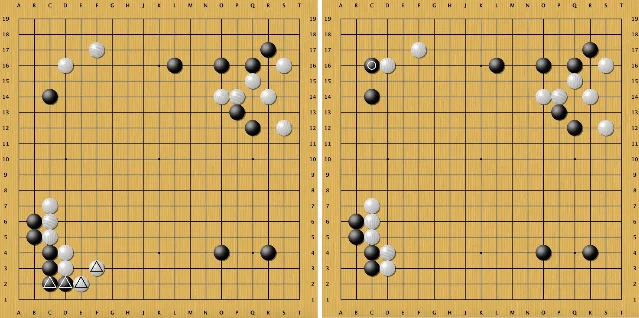
职业棋手吸收的是具体哪几手棋。左为教科书定式,右为 AlphaGo 的走法。图取自 DeepMind 官方博文《Innovations of AlphaGo》(2017 年 4 月 10 日),两张原图左右拼合
围棋的变化被量化过,而且不止一次。
2023 年,Minkyu Shin 和同事在《PNAS》上分析了职业棋手从 1950 年到 2021 年的 5857513 手决策,用 KataGo 生成 580 亿个反事实棋局来估计每一步的质量。28
结论是:超人 AI 出现之后,人类决策质量显著提升,而且提升与「走法的创新性」上升同时发生。交互项 β3≈0.515,p<0.001。28
作者还排除了「只是背谱」这个解释:把与 AI 最优着法一致的那部分落子剔除之后,提升依然存在。28
围棋的另一个变化由 2022 年的一篇 CHI 论文测到。韩国研究者分析了 6292 盘韩国围棋赛事对局和 1362 名棋手的等级分,发现自 2017 年起棋手的走法与 AI 推荐走法的相似度急剧上升,一局棋里「预期胜率的波动幅度」显著下降,而 AI 训练对年长棋手的收益更大。29
参与度这一头,Kasparov 那句话说对了。
在线国际象棋平台 chess.com 的官方季报显示:2026 年第一季度新增账户 1490 万,日均活跃 970 万,当季对局 26 亿盘,会员数截至 3 月 31 日为 2.52 亿以上。30 这个平台在 2022 年 12 月才到 1 亿会员。31
另一个开源平台 lichess 官方页写的是:每天有超过 500 万盘对局。32
但如果把问题收窄成「人类下得比以前好吗」,答案会变得不那么好看。
接下来这三个时点,分别是 2000 年、2010 年和现在。
| FIDE 前 100 名榜面 | 2000 年 1 月33 | 2010 年 7 月34 | 2026 年 10 月35 |
|---|---|---|---|
| 第 1 名与等级分 | Kasparov 2851 | Carlsen 2826 | Carlsen 2823 |
| 等级分 2800 以上人数 | 1 | 3 | 1 |
| 等级分 2700 以上人数 | 10 | 37 | 33 |
| 前 100 名平均等级分(据榜面计算) | ≈2641 | ≈2693 | ≈2680 |
| 第 100 名的等级分 | 2594 | 2639 | 2626 |
顶尖区间的曲线在 2010 年见顶,此后小幅回落:2026 年的前 100 名平均等级分低于 2010 年,2800 分以上的人数也回到了 2000 年的水平。
能支撑的只有一句:顶尖区间这二十六年的曲线,没有为「人因为和机器下棋而集体变强」这个说法提供支持。
两份结果可以同时成立,因为它们量的是两样东西。 Bilalić 比的是每一步走法与引擎最优着法之间的差距,FIDE 榜面算的是比赛成绩换算出来的分数。所有人都在同一档水平上一起提高的时候,走法会更精确,名次和分数却不会因此上升。253335
Kasparov 自己十六年前就区分过这一点。 2010 年,他在《纽约书评》上写过一篇文章,回应一个常被拿来类比的例子:有人说机器取代人下棋,好比汽车取代人跑步而人照样跑步。他称这是「一个站不住脚的类比」——汽车不帮人跑得更快,而棋类计算机确实影响了人类下棋的质量。36
05 分界线
把「萎缩」一侧和「健身房」一侧的账合起来,可以得到一条比「会不会萎缩」更有用的线。决定结果的那件事很具体:你在用 AI 的同时,还在不在做那个会退化的动作。
支持这条线的证据,比支持任何一方的都硬。
最直接的证据来自课堂:工具被拿走之后,用过的人比从没用过的人更差。 宾夕法尼亚大学等机构的研究者做过一项涉及近 1000 名高中生的随机实验:用 ChatGPT 的那段时间,学生的表现确实提升了;但后来被撤掉访问权的学生,成绩比从来没有用过 ChatGPT 的学生低 17%。37
这组数字来自 OECD 2025 年 6 月那份报告的转述,原始研究是一份尚未正式发表的工作论文。37
澳大利亚莫纳什大学等机构的另一项实验涉及 117 名大学生,论文发在《British Journal of Educational Technology》上:用 ChatGPT 的组作文分数更高,但知识增益和迁移没有提高,作者把这个现象叫「元认知惰性」。38
明尼苏达大学法学院的几位研究者做了一项约 100 名高年级法学生参加的随机实验,结果被拆成三段。39
第一段:用 AI 整合法律素材的那一组,表现高出 50% 到 70%,而且更快。39
第二段:随后要求所有人不带 AI 做法律分析时,先前用过 AI 的人仍然更好。研究者自己的解读是,早期使用 AI 反而强化了后面的独立推理。39
第三段:最后一步要求用 AI 修改备忘录时,初稿弱的人改好了,初稿强的人改差了——AI 在这里替代了思考。39
同一批学生、同一个工具、同一门训练,用法不同,结果反向。
正面的一例来自哈佛。2025 年,Greg Kestin 和同事在《Scientific Reports》上发表了针对 194 名本科物理课学生的随机对照实验:内容相同,一组用专门设计的 AI 导师在家学,一组上常规的主动学习课堂。AI 组后测的中位学习增益是课堂组的两倍以上,中位用时 49 分钟对 60 分钟,差异的 p 值小于 10⁻⁸。40
那套 AI 导师是按教学法专门写的提示,和「让学生用 ChatGPT 写作业」是两件事。40
生产力这一侧也有对照。2023 年,麻省理工学院的 Shakked Noy 和 Whitney Zhang 在《Science》上报告了一项 453 名专业人士参加的随机实验:用 ChatGPT 的一组平均完成时间下降 40%,产出质量上升 18%,能力较弱者的收益更大。41
最难解释的一份结果来自 METR。2025 年,这家评估机构找了 16 名经验丰富的开源开发者,在他们自己平均做了五年的成熟项目上完成 246 个任务,每个任务随机决定能不能用 AI 工具。42
结果是:允许用 AI 的那一半任务,完成时间反而多了 19%。42
而开发者在动手前预测 AI 能省下 24% 的时间,做完之后自评省了 20%。42
主观感受和客观结果,方向相反。
到这一步,制度侧的反应已经落地了。
2025 年 5 月 12 日,中国教育部基础教育教学指导委员会发布了两份指南,其中明确写入了学段边界:小学阶段禁止学生独自使用开放式内容生成功能,初中阶段可以适度探索生成内容的逻辑性分析,高中阶段允许结合技术原理开展探究性学习。43
世界卫生组织则在 2024 年 1 月的一份治理指南里提示了「过早依赖 AI 输出、减少独立推理」的风险。44
OECD 在 2025 年 6 月那份报告里写下的原句是:「对生成式 AI 的过度依赖,可能在长期损害批判性思维、阻碍认知发展,尤其是在使用者不去批判性分析生成内容的时候。」37
医学教育这条线上,伦敦大学学院的 Jonathan Turney 和同事在 2026 年做了一次系统综述,检索后只筛出 4 项研究、共 408 名医学生。他们的结论是:AI 辅助学习提升了效率和基础知识获取,但在高阶临床推理和复杂决策上结果不一致;他们给出的两个机制名字是「去技能化」——已经获得的技能因为练习减少而衰退,和「技能抑制」——本该形成的能力因为任务被外包而没有形成。45
他们还写了一句:这个领域的现有研究「出奇地少」。45
LeCun 那句话里最准确的一处,其实是他没打算强调的那一处:这些领域里最强的人,相当于顶级运动员。1
顶级运动员的状态只有一个来源:他们每天还在练。10
References
- 1
- 2
- 3
- 4
- 5Andrew Yeung 个人主页
andrewyeung.co
- 6IBM 官方史页「Deep Blue」
ibm.com
- 7Advanced Chess matches · chessgames.com(含首届赛事逐局记录与引语)
chessgames.com
- 8Goodreads 书目:Deep Thinking(2017 年 6 月 1 日)
goodreads.com
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16Your Brain on ChatGPT 项目页(含未评审声明与作者列出的局限)
brainonllm.com
- 17
- 18
- 19
- 20Owen et al., Putting brain training to the test(Nature 465:775–778, 2010)
pmc.ncbi.nlm.nih.gov
- 21Do “Brain-Training” Programs Work? · Association for Psychological Science
psychologicalscience.org
- 22Sala, Foley & Gobet, 国际象棋教学迁移的元分析与综述(Front. Psychol. 8:238, 2017)
pmc.ncbi.nlm.nih.gov
- 23Gobet, Expert memory: a comparison of four theories(Cognition 66(2):115–152, 1998)
pubmed.ncbi.nlm.nih.gov
- 24
- 25
- 26AlphaGo · Google DeepMind 官方研究页
deepmind.google
- 27Innovations of AlphaGo · Google DeepMind(2017-04-10)
deepmind.google
- 28
- 29
- 30chess.com Q1 2026 Board Report
chess.com
- 31
- 32Lichess · About
lichess.org
- 33FIDE Rating List January 2000(OlimpBase 存档)
olimpbase.org
- 34FIDE Top 100 Players July 2010(FIDE 官网 2010-07-25 存档)
web.archive.org
- 35FIDE Top 100 逐月榜(2026 年 10 月)
2700chess.com
- 36
- 37
- 38Fan et al., Beware of metacognitive laziness(British Journal of Educational Technology)
bera-journals.onlinelibrary.wiley.com
- 39
- 40
- 41
- 42
- 43《中小学生成式人工智能使用指南(2025年版)》全文(甘肃省教育厅转发,2025-05-12)
jyt.gansu.gov.cn
- 44
- 45
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.