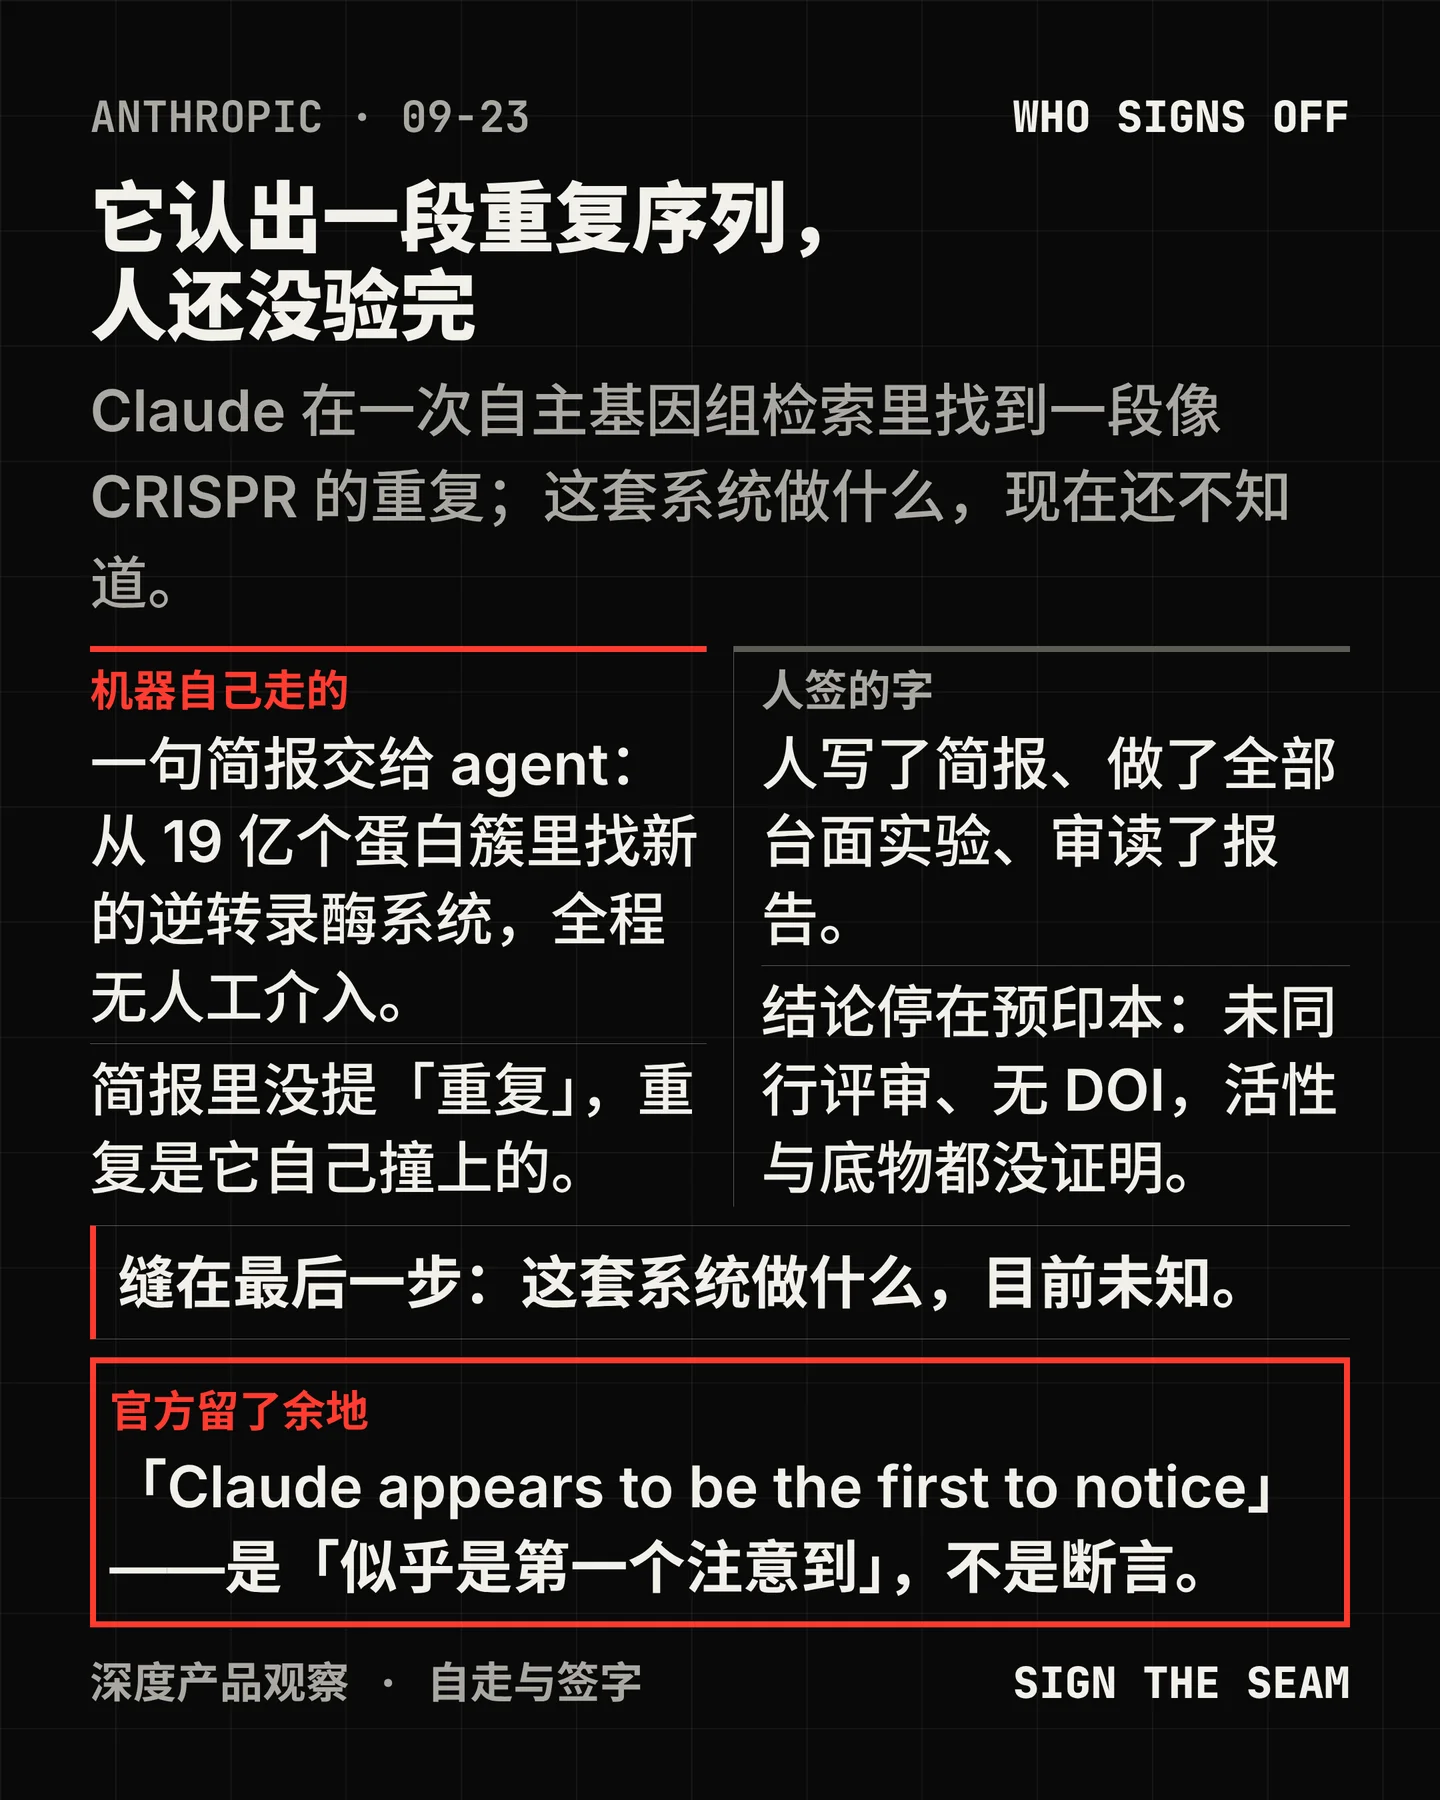

2026 年 9 月 23 日,Anthropic 发布官方文章《Claude discovers a novel enzyme system with CRISPR-like repeats》,宣布成立生命科学研究组与一间自有湿实验室,并称 Claude 在一次自主基因组检索中发现了一个与 CRISPR 有相似之处的全新酶系统。1 公司给这套系统起的名字是 ART(array-associated reverse transcriptases,阵列关联逆转录酶),它由一个噬菌体逆转录酶、一段非编码 DNA 重复阵列,以及一个功能未知的附件蛋白组成;官方同时公开了预印本,并引用了 CRISPR 先驱、MIT 与 Broad Institute 教授 Feng Zhang 的评论。1
这条消息里最需要看清的,是「谁走完了哪一步」。 按官方自己的表述,公司的参与「仅限于最初的提示词与实验室工作」,数据库的梳理、各逆转录酶家族的调查、从候选中挑出值得看的那几个,都由 Claude agent 完成;1 实验室位于湾区,只做生物安全一级与二级(BSL-1、BSL-2)的研究,不处理能感染人类的病原体,而且「All of the lab work is performed by human scientists」——全部台面工作由人类科学家完成。1 这句话是理解这条消息的钥匙:检索被交给了机器,判定「这东西是真的吗」仍然留在人的手上。
官方在三个地方给自己留了余地,三处都值得逐字读。 第一处是优先权:「While this underlying RT, found in a jumbo phage, had been identified in previous studies, Claude appears to be the first to notice the system's defining features」(这个位于巨型噬菌体中的逆转录酶此前的研究已经识别过,而 Claude 似乎是第一个注意到该系统决定性特征的人)——注意是「appears to be(似乎是)」,不是断言。1 第二处是功能:「Although we don't yet know its function」(虽然我们还不知道它的功能)。1 第三处写在预印本里:「we have not shown that the RT is active or that the unit RNAs are its substrates. Whether the RT and its partner interact, and what the system does for the phage, are currently unknown.」(我们尚未证明该逆转录酶具有活性,也未证明这些单元 RNA 是它的底物;它与伙伴蛋白是否相互作用、对噬菌体有什么用,目前都未知。)2 关于「这件事有多新」,路透社在转述时把官方的「似乎是第一个注意到」写成了断言式的「Claude was the first to recognize」,引用时应当回到官方原文。3
这场检索的规模可以逐条核,而它与「发现 ART」并不是同一件事。 预印本给出的口径是:整场行动包含 119 个任务、949 个 agent 会话(含 worker、supervisor、curator、editor 四类角色),累计 77 个 agent 小时、2.156 亿 token,墙钟时间 21.5 小时,全程无人工介入。2 官方博客把这些数字写成「约 950 个 agent」「21 小时」「2.1 亿 token」,三项与预印本都不完全一致,属于四舍五入与口径差。1 更要紧的是分母:这场检索的任务简报要的是「基于新的伙伴基因关联去识别新的逆转录酶系统」,简报里从头到尾没有提到重复序列或阵列,预印本写得很清楚——「Neither this task brief nor the research brief mentioned repeats or arrays.」换句话说,ART 是行动过程中的一个意外旁支,把它说成「用 2 亿 token 找到了这个酶」是口径错位。2
官方博客与其自家预印本的数字逐项对不上,这件事本身值得单列。 博客写「汇集了 20 万个以上逆转录酶」,预印本写序列经聚类后得到 198,290 个簇;博客写「筛出 3,500 个新候选系统」,预印本写的是「对 3,564 个伙伴蛋白家族打分」,而且这 3,564 个里只有 3 个被确认为此前未报道的逆转录酶关联;博客写「收敛到 20 个最值得分析的候选」,预印本写的是收到 19 份报告。12 预印本没有 DOI、没有期刊、也没有托管在任何预印本服务器上,文件放在 Anthropic 自家的 CDN 上,未见同行评审声明。2
一条博客里没有写、预印本写了的保留,比数字差异更重要:这次发现没有被复制出来。 预印本自述:同一场检索又跑了十次,几乎每一次都采样到了 ART 位点,但「none read the DNA upstream of the RTs, and the array was missed in every rerun」——没有任何一次读到那段阵列。作者把原因归为逆转录酶的搜索空间过大与 harness 行为的非确定性。2 在同一篇里还有一组固定输入的测试:把位点直接放进上下文时,能力最强的模型至少 90% 的尝试能准确描述那段阵列;换成文件加工具的形式后,成功率最低降至 32%(Opus 5,level 4),原因是 39% 的尝试根本没有读到 200 nt 以上的连续序列,也就看不到一个完整的重复单元。2 这两组数字合起来说明的是同一件事:这一次的发现是真的,但它目前是一次性的。
这套系统到底是什么,原始材料能支持的写法是有限的。 ART 的阵列长 0.3 至 4.1 kb,由 3 到 21 个拷贝的短重复组成,每个重复单元长 15 至 49 nt,中间有一段约 15 nt 的回文核心。2 与 CRISPR 阵列的关键差别有两条:CRISPR 的重复之间是约 30 nt 的间隔序列,而且阵列旁边一定有 cas 基因;ART 的阵列旁边没有 cas 基因,预印本因此把它写成「a new type of non-coding repeat element」(一种新的非编码重复元件),并说它「belongs to no described RT class」。2 系统发育分析把它的逆转录酶放在 retron 支系旁边,而不是放进 CRISPR 或 group II intron。2 表达证据来自两块:一是重分析已发表的噬菌体感染 RNA 测序数据(BioProject PRJNA836150,12 个文库、3 个培养物,取样点在感染前与感染后 5、15、55 分钟),感染后 15 分钟阵列来源的 RNA 最高可占噬菌体 RNA 的 8%;二是本组自己做的 small RNA 测序,把阵列在两种质粒构建体里表达,而方法学写明每个构建体只有一个培养物。2 官方博客把这一层概括为「展现为一组不同的短 RNA」,没有给实验类型与样本量。1
把先例摊开,能看到这项工作的位置。 这个逆转录酶本身早在 2021 年一篇关于三种金黄色葡萄球菌巨型噬菌体的基因组报告里就被识别,那篇报告甚至提出了一个可能的 5′ 非编码 RNA,但没有描述重复阵列,也没有描述伙伴基因。2 在预印本里引用的另一项工作——斯坦福等机构用基因组语言模型挖掘原核非编码元件——独立报告了另一类「逆转录酶旁边带非编码 RNA 阵列」的系统 UG27。4 预印本由此写下结论:「this architecture arose more than once in nature(这种结构在自然界中不止一次出现)」;Anthropic 首席执行官 Dario Amodei 也在 X 上承认了这个并行发现,并说明两者是各自独立演化的不同系统。5
公司之外的独立评价,目前只有一位具名科学家。 Feng Zhang 的原话是:「This is an exciting example of how AI agents can contribute to biological discovery. The identification of RNA-repeat arrays associated with reverse transcriptases is genuinely intriguing and merits further investigation.」(这是一个令人振奋的例子,说明 AI agent 可以如何对生物发现做出贡献。识别出与逆转录酶关联的 RNA 重复阵列确实很有意思,值得进一步研究。)1 需要看清这句话的边界:他说的是「intriguing」与「值得进一步研究」,没有说这套系统可能成为新的基因编辑工具;预印本致谢里写的是他审读了早期稿并提供意见,除此之外没有查到他和 Anthropic 之间存在顾问、合作或投资关系的证据。2 The Verge 在同日报道里给出了这次发布中最明确的保留:「it remains unclear whether the discovery will have any practical applications, let alone be as transformative as the gene-editing technology」,并把这次发布称为「the admittedly premature announcement」。6 TechCrunch 把看点定在另一处:这场发布里最大的信息不是发现本身,而是「the biology lab hasn't let Claude loose. The physical experiments were done by humans.」7 社区里确实有不少质疑,但需要标明它们的性质:Hacker News 上「我在意的是 CRISPR 这个说法」「这不是什么特别新东西」这类评论都来自匿名或非专业账号,不能当作专家判断使用。8
要判断这件事的分量,得把这家公司自己过去说过的话放在一起读。 2025 年 9 月,Anthropic 在关于生物风险的官方文章里写下:「To be sure, Claude and other LLMs are not currently capable of actually doing science autonomously at an expert level.」(可以肯定的是,Claude 与其他大模型目前还不能以专家水平自主地做科学。)9 一年后,同一家公司宣布 Claude 在无人介入的情况下发现了一个新酶系统。官方没有对这两句话做过正式对照。可以核到的相关动作有三项:6 月 30 日上线的 Claude Science(一个面向科学家的 AI 工作台,含 60 多个基因组学、单细胞、蛋白质组学等方向的技能与连接器);8 月 27 日的 Model Hardware Standard 研究预览(让 agent 安全操作实验设备的共享规范);以及 9 月 17 日的 Life Sciences Verification Program——通过核验的研究者可以获得更适合生物研究的模型档位,其中「高风险用途」按单个项目授权,每半年续期,并移除所有阻挡生命科学请求的护栏。101112 这次工作用的是 Claude Mythos 5,属于该计划「标准用途」覆盖的档位;但官方文与预印本都没有说明 ART 项目本身是否走了这套授权流程。2
落到产品与决策上,这一案给出的是一组判断顺序,而不是一个结论。 第一,先问功能:功能、活性、底物三条都是空的,「像 CRISPR」说的是阵列形状的相似,不是机制相同。第二,再问复现:同一场检索重跑十次全部漏掉,工具形态下的识别率最低 32%——把这类能力写成「可复用」之前,先要有一个复现率。第三,把成本分开算:这一端的生成越来越便宜,验证那一端仍然由人按天计价,预算与工期应该落在后者。第四,别把两支混成一支:系统发育上它靠近 retron 支系,把它当成 CRISPR 的同门会直接影响对用途与风险的判断。第五,如果要在采购或投资里给「AI 发现的候选」定价,先看它有没有独立复现、有没有实验证明活性、有没有同行评审——这三条这次都还是空的。
最后压三句。第一,检索那一段由 agent 自己走完,判定那一段留在实验台上;官方的参与声明把这条缝写得很清楚。第二,官方博客与自家预印本的数字逐项不一致,而最重要的那条保留——重跑十次全漏——只写在预印本里,所以读这类发布时要读到底层文件。第三,这项工作的真正门槛不在生成,在验证:它现在是一份值得研究的假设,还不是一个可用的工具。
References
- 1
- 2Autonomous AI agents discover reverse transcriptases with tandem repeat arrays(预印本)
www-cdn.anthropic.com
- 3
- 4
- 5Dario Amodei 在 X 的说明
x.com
- 6
- 7
- 8Hacker News 讨论串
news.ycombinator.com
- 9
- 10
- 11Previewing the Model Hardware Standard
anthropic.com
- 12Introducing the Life Sciences Verification Program
anthropic.com
Comments