蚂蚁 inclusionAI 开源 LBS-27B:只用合成 GUI 截图训练,靠裁图放大把视觉感知做到 59.67
蚂蚁 inclusionAI 开源 LBS-27B:27.36B 视觉语言模型靠多轮裁图放大做 GUI 定位,训练只用了约 1 万条合成 GUI 数据,ScreenSpot-Pro 81.15、PerceptionBench 59.67,权重 54.7 GB、Apache-2.0,第三方还没有评测。

10 月 20 日 21:16(北京),UI-Venus 仓库的 LBS 分支推了第一个提交,提交信息只有一行「Initial LBS release」。1 七位作者来自武汉理工大学、中科院自动化所、浙江大学和蚂蚁集团。2
六天后的 10 月 26 日 13:36,Hugging Face 上出现 inclusionAI/LBS-27B 仓;19:15,模型卡与评测图补齐。3 12 个权重分片就放在这个仓里,合计 54.7 GB。4
到发稿时,官网和博客上都没有找到单独的发布公告。能核对的材料是仓库、模型卡和评测记录三处,写法更像论文的附带开放:先放代码与权重,论文等 arXiv。2
LBS 是「Learning to look beyond screens」的缩写,直译是「学会看向屏幕之外」。5 它是 UI-Venus 仓库上的一个分支,那个仓库主仓是 GUI agent 项目,1.1k 星。2
先说结论
- 形态:27.36B 的视觉语言模型,基座是 Qwen3.8-27B,许可 Apache-2.0,BF16 权重 12 个分片共 54.7 GB,现在就能下。45
- 训练:只用合成的 GUI 定位数据——约 1 万条冷启动 SFT,接 80 步 GRPO,batch 64、每 prompt 8 条 rollout。训练集里没有通用域图片,也没有 VQA 题。25
- 机制:坐标分几轮给出。模型先看整屏,用一行纯文本
crop_image要求裁图,看过放大的裁图后再定位;一段最多裁三次,一回合最多两张。2 - 最强项:ScreenSpot-Pro 81.15(1,581 条),比同仓库上一代 UI-Venus2-27B 的 74.1 高 7.05 分。56
- 没赢的地方:同一张官方对比图上,作者提供的 Qwen-UI-Agent-27B 是 81.5,比它高 0.35;PerceptionBench 59.67 比 GPT-5.6 Sol 的 59.7 低 0.03,两边判分模型还不同。6
- 缺口:没有技术报告与 arXiv、没有训练数据、没有速度与延迟、没有托管 API,第三方榜单也还没收录。27
快速核对
| 项目 | 内容 | 来源 |
|---|---|---|
| 时间窗口 | 代码 10 月 20 日先出,权重与模型卡 10 月 26 日补齐;第三方评测还是空白期 | GitHub 提交 · HF 提交 |
| 发布方 | 作者单位含蚂蚁集团;权重挂在 inclusionAI 组织下,该组织此前发的是 Ling 与 Ming 系列 | README |
| 现在能做什么 | 权重可下;有一个社区搭的 gradio demo 能传截图试定位;没有官方 API | demo |
| 基座模型 | Qwen3.8-27B,2026 年 8 月 5 日发布 | 模型卡 · 基座 |
| 参数规模 | 27,356,728,560(27.36B) | HF 元数据 |
| 权重体积 | 12 个 safetensors 分片,合计 54.7 GB | HF 元数据 |
| 架构 | Qwen3_5ForConditionalGeneration;64 层,16 层全注意力 + 48 层线性注意力;隐层 5120;24 个查询头对 4 组 KV,head_dim 256 | config.json |
| 视觉塔 | 27 层,隐层 1152,patch 16,2×2 合并,输出接回 5120 维 | config.json |
| 上下文 | 262,144 tokens | config.json |
| 输入输出 | 图像加文本进、文本出;坐标归一化到 0–1000 | 模型卡 |
| 观察协议 | 每回合最多 2 张裁图,一段最多 3 次;裁图 4 倍放大、上限 400 万像素 | README |
| 推理设置 | 默认 reasoning_effort=xhigh、thinking_budget=4096 | 模型卡 |
| 许可 | Apache-2.0,模型卡写明权重与项目代码同一许可 | 模型卡 |
| 部署 | 官方 vLLM 示例为 4 卡张量并行(--tp 4),训练走 ms-swift 加 vLLM | 模型卡 · README |
| 评测口径 | 5 项,全部作者自测;PerceptionBench 用自建 Deepseekv4-flash-0731 判分 | 模型卡 |
| 第三方 | Artificial Analysis 三个候选落点全 404;OpenRouter 只有 Ling 系列;Vals 榜单无条目 | AA · OpenRouter · Vals |
| 技术报告 | 未发布,README 写明等 arXiv | README |
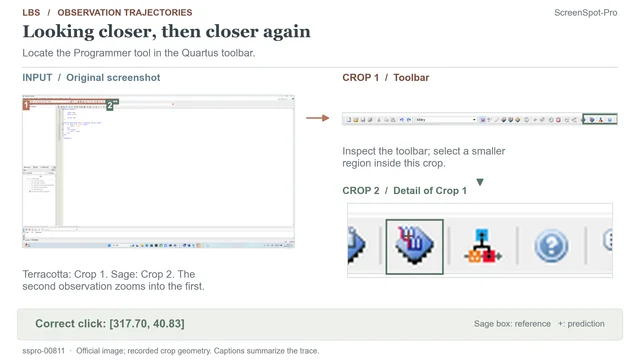
一次定位要裁三次图
GUI 定位要做的事,是给一张界面截图和一句指令,说出该点哪个位置。难的地方在分辨率:一张 4K 截图送进模型时要先缩到它能吃的尺寸,要点的图标可能只剩几个像素宽。2
LBS 把这一步拆成几轮。模型先读整张截图,写出一行普通助手文本,形如
crop_image(image_path="screenshot.png", x1=560, y1=150, x2=844, y2=240)。2执行端按这行坐标裁出区域,放大 4 倍(上限 400 万像素),把裁图、尺寸,以及这张裁图对应原图的哪一块,一起送回模型。2
下一轮模型可以引用这张裁图继续裁,也可以回到原图重新框,还可以在同一回合里要两张不同区域的图。一段最多 3 次裁切,一回合最多 2 张。2
最终答案给的是原图上的归一化坐标
[x.xx,y.yy],范围 0 到 1000,由调用方换算成像素。5这套协议的好处是接口简单,动作就是文本,任何支持多轮并会回传图片的推理服务都能接。代价落在延迟上:一次定位通常要走 2 到 3 轮,每轮都重新送图。
一万条冷启动样本,80 步 RL
训练数据全部是合成的 GUI 定位数据。5
流程分两段:约 10,000 条冷启动 SFT 样本,然后 80 步 GRPO,batch 64,每 prompt 8 条 rollout。2
奖励有五项:最终落点是否落在目标框内;裁切过程分,由结果门控的最佳裁切 IoU 减去重复裁切与无进展的惩罚,每次裁图再扣 0.05;格式是否合规;困难样本上的放大加成;可选的 CoT 裁判分。2
80 步这个量级,RL 更像收尾:基座 Qwen3.8-27B 已经会看图,这里学的是「什么时候裁、裁哪里」。8
作者在 README 里写,这些设计各自起多大作用要靠受控消融来定,这一轮没有做。2
五个分数,三种判分方式
| 基准 | 记录数 | 指标 | 分数 | 判分方式 |
|---|---|---|---|---|
| ScreenSpot-Pro | 1,581 | 操作准确率 | 81.15 | 本地几何判定,点是否落在框内 |
| OS-World-G (Refine) | 564(510 正例 + 54 拒答) | 含拒答的操作准确率 | 84.57 | 本地判定,另算拒答行为 |
| PerceptionBench | 3,000 | 裁判准确率 | 59.67 | LLM 裁判,自建 Deepseekv4-flash-0731 |
| HR-Bench 4K | 800 | 严格选项匹配 | 89.13 | 严格匹配,不用 LLM 裁判 |
| HR-Bench 8K | 800 | 严格选项匹配 | 87.75 | 严格匹配,不用 LLM 裁判 |
判分方式的分量不一样。ScreenSpot-Pro 与 OS-World-G 是几何判定,模型给一个点,判分器看这个点是否落在标注框里。2
PerceptionBench 用 LLM 判分,LBS 这一侧是自建 Deepseekv4-flash-0731,上游榜单用 GPT-oss-120B。官方注明重复判分可能有出入,这一次没有失败或跳过的判分。9
HR-Bench 用严格选项匹配,不是 LLM 裁判分。每档 800 条,分成 200 个题组,每题四个选项轮换顺序。2
OS-World-G 的 564 条里有 54 条是拒答记录,84.57 把「该说找不到时说了找不到」也算了进去。2
把 ScreenSpot-Pro 拆开看,强弱项就清楚了。1,581 条里文本目标 977 条、图标 604 条,文本准确率 90.17%,图标 66.56%,总体是按记录数加权算出来的。2
六个域里 Office Suite 最高,93.04;Creative 最低,74.78。2
26 个应用里,EViews 98.00、Word 96.43 最稳;FL Studio 59.65、Origin 62.90 最弱;AutoCAD 的 7 条图标记录全错。2
PerceptionBench 的十个类别里,视觉关系 68.48 最高,计数 61.82、属性 65.76 居中,与感知相关的幻觉 43.91 最低,深度与 3D 感知 50.30。2
两张对比图上,它都没排第一
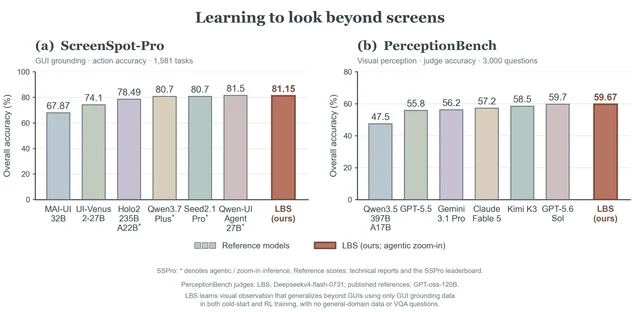
官方那张双栏图值得逐条看左栏:MAI-UI-32B 67.87、UI-Venus2-27B 74.1、Holo2-235B-A22B 78.49、Qwen3.7 Plus 80.7、Seed2.1 Pro 80.7、Qwen-UI-Agent-27B 81.5,最后是 LBS 的 81.15。6
带星号的四根柱子是 agentic 或 zoom-in 推理,跟 LBS 一样多轮裁图跑出来。9
其中三个数值——Qwen3.7 Plus 的 80.7、Seed2.1 Pro 的 80.7、Qwen-UI-Agent-27B 的 81.5——来源栏写的是仓库作者提供,官方 references.json 里标记为 author_reported,提供日期 2026 年 10 月 15 日。6
于是这张图上最右边那根柱子是 81.15,比作者自己提供的 81.5 低 0.35 分。图从左到右递增的排法容易让人以为最后一根最高,数值上不是。6
右栏 PerceptionBench 最高的是 GPT-5.6 Sol,59.7;LBS 的 59.67 低 0.03。官方在图注里写了一句话:59.67% 不构成对 59.7% 的提升。9
这句注解是这一期最该记住的。两边判分模型不同,0.03 分的差距落在判分差异里,谁高谁低算不出来。6
有一处可以自己核:ScreenSpot-Pro 官方榜单的数据文件里,Holo2 与 MAI-UI 都能查到,LBS 与那三个作者提供的数值一条都没有。10
出了屏幕之后
迁移是这次真正的主张:训练集只有 GUI 截图,却能拿去回答风景照和流程图的问题。5
HR-Bench 从 4K 的 89.13 掉到 8K 的 87.75。两档各 800 条,用严格选项匹配。2
官方没有给 HR-Bench 的对照数值,这两个分数只能看绝对值,判断不了它比谁好。6
有一条轨迹能看清它在做什么。题目是一张 8K 的教堂照片,问日晷上刻的年份。第一次裁切落在天空和墙的交界,什么都没读到;模型重新框定,第二次裁到日晷盘面,读出 1762,严格匹配判对。11
裁错之后回到原图重新框,是这套策略的一部分。评测协议给了余量:HR-Bench 默认 4 轮格式纠正,其他基准默认 2 轮。2
PerceptionBench 那 59.67 是另一个方向的迁移。题目里有图表、流程图和照片细节,跟屏幕上该点哪里没有关系。2
跑起来要几张卡
权重 54.7 GB,对应 BF16 下的 27.36B 参数。4
官方 vLLM 示例写的是
--tp 4 --dp 1,4 卡张量并行。5这套架构比同尺寸的稠密模型省 KV 缓存:64 层里只有 16 层是全注意力,其余 48 层是线性注意力,每层只保留固定大小的状态,不随上下文变长。12
按 config 推算,每个 token 的 KV 缓存约 64 KB(16 层 × 4 组 KV × 256 维 × K 与 V 各一份 × 2 字节)。32K 上下文约 2 GB,跑满 262,144 上下文约 16 GB。12
两项加起来,一张 80GB 的卡装得下 54.7 GB 权重,长上下文再留十几 GB。官方没有给单卡实测,示例仍然是 4 卡。5
真正吃资源的是多轮。一次定位 2 到 3 轮,每轮都要把之前的裁图重新送进去,批量跑评测时成本按轮数算。2
该不该试
- 做文本密集界面的自动化:ScreenSpot-Pro 上文本目标 90.17%,这是它最稳的一段,值得排一次自己的用例。2
- 界面以图标为主:图标定位 66.56%,AutoCAD 的 7 条图标全错,CAD 与创意软件先小样本试,别直接上线。2
- 只有单张 24GB 或 48GB 卡:54.7 GB 权重放不下,Hugging Face 上目前也只有官方一个仓,没有社区量化版本。13
- 延迟敏感的一次前向定位:默认就是 2 到 3 轮裁图,省不掉;要单轮得自己改协议。2
- 要托管接口的:官方 API 与推理提供方都没有,可以先拿社区那个 demo 试手感。14
- 做高分辨率读图的:HR-Bench 只有绝对分、没有对照,拿自己的一批图跑一遍,比对着分数猜有用。6
还没有的数字
- 技术报告:README 写「论文与引用信息将在 arXiv 发布后补充」,到发稿还没有。2
- 训练数据:合成数据怎么生成、覆盖哪些应用都没写;仓库只放了 8 条训练输入和 32 条 rollout 样本。2
- 权重的口径:README 写「仓库不包含模型权重和完整训练数据集」,权重实际在 Hugging Face 仓里。两处说的是两件事,GitHub 侧不带权重,HF 侧带。25
- 速度与成本:没有 tokens/s、没有首 token 延迟,也没有一次定位的平均耗时与轮数。
- 第三方复跑:Artificial Analysis 三个可能的落点全是 404,OpenRouter 目录里 inclusionAI 只有 Ling 三条、没有 LBS-27B,Vals 榜单也查不到。71516
- 安全与偏差评估:模型卡没有这一节,要接生产环境的得自己补。
- 移动端与中文界面:26 个应用全是桌面软件,VS Code、Photoshop、AutoCAD、Word、Excel 都在其中,手机界面和中文软件没有覆盖数据。2
- 官方发布页:官网与博客都没有单独公告,可核对的入口是仓库和模型卡。25
References
- 1GitHub 提交记录
github.com
- 2LBS 分支 README
github.com
- 3HF 提交记录
huggingface.co
- 4HF 仓库元数据
huggingface.co
- 5LBS-27B 模型卡
huggingface.co
- 6官方对照数值
github.com
- 7Artificial Analysis 落点
artificialanalysis.ai
- 8Qwen3.8-27B
huggingface.co
- 9图表说明与对比来源
github.com
- 10ScreenSpot-Pro 榜单数据
raw.githubusercontent.com
- 11轨迹文档
github.com
- 12config.json
huggingface.co
- 13HF 全站搜索
huggingface.co
- 14社区 demo
huggingface.co
- 15OpenRouter 目录
openrouter.ai
- 16Vals Index
vals.ai
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.