1M 上下文、1 小时音视频输入、0.2 美元/小时:Qwen3.8-Omni-Flash 把全模态接进智能体
解读阿里 Qwen 2026 年 9 月 18 日的官方博客:Qwen3.8-Omni-Flash 把上下文推到 100 万 token、音视频输入压到每小时 0.20 美元,在语音与音频轴上大幅领先 Gemini 3.8 Flash,长视频推理与部分智能体评测仍然落后。

阿里 Qwen 团队在 2026 年 9 月 18 日上线 Qwen3.8-Omni-Flash,官方把它定位成从「理解全模态内容」走向「规划任务、调用工具、完成创作」的一代原生全模态模型1。模型接受文本、图像、音频、视频四种输入,上下文窗口 100 万 token,由阿里云百炼提供 API 服务2。
官方导语给的平均数字是:29 项评测的分数比上一代 Qwen3.5-Omni-Plus 高出 25% 以上1。把这批数字拆开看,这一代在音频轴上把对手甩开很大一截,在长视频推理和部分智能体评测上仍落后 Gemini 3.8 Flash。要判断该不该把活交给它,答案就落在这两条线之间。
一次放出三件东西:模型、插件、实时运行时
Qwen3.8-Omni-Flash 本体是 API 形态。阿里云百炼的模型页写明:输入模态是文本、图片、音频、视频,输出模态只有文本;上下文长度 100 万 token,非思考模式下最大输入 991,808 token、思考模式 983,616 token,最大输出 131,072 token2。深度思考默认开启,推理强度分 xhigh、medium、low 三档;函数调用、联网搜索、隐式上下文缓存都在支持列表内;多通道音频用
use_multichannel 参数开启,接收空间音频12。输出只有文本这一条会直接影响接入方式:想让它开口说话,得走同日发布的 Qwen3.8-Omni-Flash-Realtime;阿里云百炼的模型列表页另外注明,离线语音输出改用 Qwen3.5-Omni-Plus23。
第二件东西是插件。Qwen-MM-Plugins 当天在 GitHub 开源,官方列出六个:
core:读图、视频帧、PDF、Office 文档与代码4;api:图像理解、OCR、目标定位、音视频转写、说话人分离与事件分析4;omni-chatcut:MV、长片解说与视频翻译4;omni-video2note:把教程视频转成带关键截图的 PDF 笔记4;omni-skill-creator:把教学视频或操作录屏变成可复用的 Skill.md4;omni-memory:为长视频里的人物、对话、声音和事件建记忆4。
插件面向 Codex、Claude Code、Qwen Code、Gemini CLI、Qoder、CodeBuddy、OpenClaw 这些智能体运行时(agent harness),官方给了自然语言安装指令和一行 curl 安装命令1。
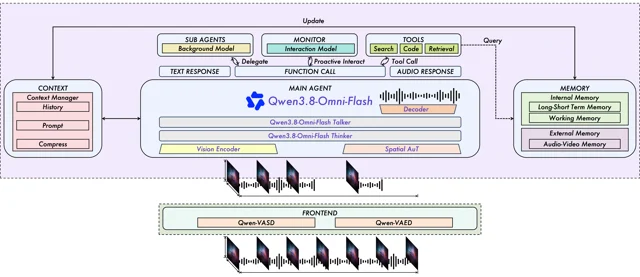
第三件是 Qwen-Live Harness,围绕实时 API 的开源运行时,一行 npm 安装,支持任务委派、主动交互、长期记忆与上下文管理5。官方评测里的智能体模式跑的就是 Qwen 自家的 Qwen Code 运行时6。
三条流水线:MV、短剧翻译、长片解说
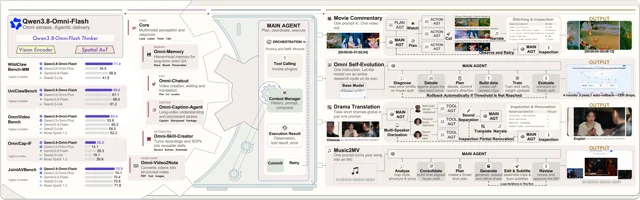
官方用三条流水线说明「交付成品」是什么意思。做音乐 MV 时,模型先解析歌曲的结构、节奏、情绪、人声与器乐变化,据此设计角色、场景与镜头,再输出带时间戳的行级歌词,用来对齐演唱、字幕与画面1。短剧翻译的入口是一句话:智能体依次做带说话人信息的对白识别、对话翻译、角色声音克隆与配音、音频重混,最后过一遍质量复核,官方把它描述成把原本要在转写、翻译、配音与剪辑平台之间来回切换的流程收成一条1。长片解说的对象是两三个小时的电影,一句创意要求换到长视频理解、关键情节抽取、解说规划、配音与音乐、剪辑、渲染与质检;官方特别提到解说与原声对白交错时,模型会自动调节语速与音量,让旁白、原声、背景音乐与画面接上1。
同一套能力还用在以视频为中心的图文研究报告上。用户遇到 Photoshop 抠图留下的色边时,模型拆解教程步骤、弄清 Multiply 与 Screen 两种混合模式的原理、比较几种边缘修复方案,再给出适合这个用户的做法1。video2note 与 Omni Skill Creator 走的是另一个方向:把几小时视频里的知识压成可检索、可复用的资产1。
这几条流水线在官方博客里各配了一段演示视频;材料里没有端到端成功率、单条成片的成本与人工介入量,这些流程能不能直接当产线用,还需要在自己的素材上跑一遍。
同一张表上的两条曲线
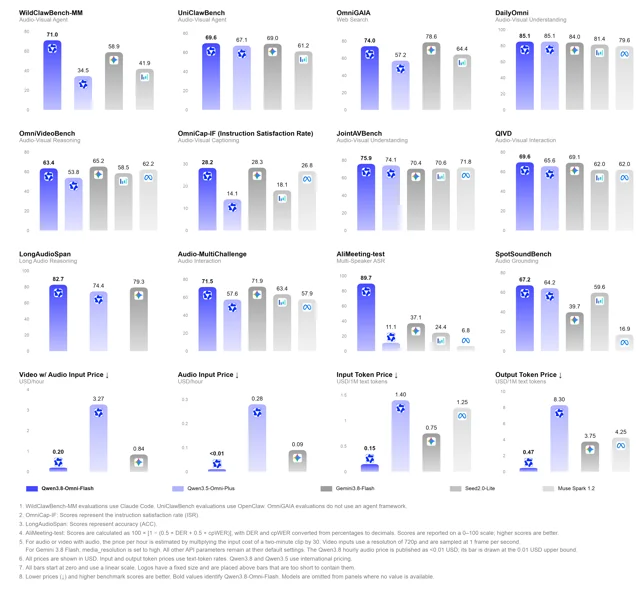
官方对照表里,音频这一侧的领先幅度最大。说话人分离错误率(DER)与拼接词错率(cpWER)越低越好,Qwen 在四个多说话人集上把上一代几乎无法使用的成绩换成了可用的成绩。
| 评测(方向) | Qwen3.8-Omni-Flash | Qwen3.5-Omni-Plus | Gemini 3.8 Flash |
|---|---|---|---|
| AliMeeting Test 多说话人 ASR(DER|cpWER,越低越好)1 | 3.4|17.2 | 88.1|89.6 | 72.6|53.1 |
| AISHELL-4 多说话人 ASR(同上)1 | 2.8|11.2 | 100.0|100.0 | 66.4|56.9 |
| MLC-SLM (en) 多说话人 ASR(同上)1 | 4.0|14.2 | 68.6|63.9 | 60.8|26.6 |
| WenetSpeech (Meeting) ASR(WER,越低越好)1 | 4.6 | 4.8 | 16.7 |
| SpotSoundBench 音频定位 1 | 67.2 | 64.2 | 39.7 |
| MuchoMusic-RUL 音乐理解 1 | 72.6 | 71.6 | 53.7 |
| LongAudioSpan 长音频推理(Accuracy 轴)1 | 82.7 | 74.4 | 79.3 |
音视频这一侧,方向反过来。
| 评测(方向) | Qwen3.8-Omni-Flash | Qwen3.5-Omni-Plus | Gemini 3.8 Flash |
|---|---|---|---|
| OmniVideoBench 音视频推理 1 | 63.4 | 53.8 | 65.2 |
| Video-MME-v2 音视频推理 1 | 65.0 | 47.9 | 71.0 |
| LVOmniBench 长视频推理 1 | 63.3 | 53.2 | 70.7 |
| StreamingBench 音视频交互 1 | 80.8 | 57.1 | 79.9 |
| WildClawBench-MM 多模态工具使用 1 | 71.0 | 34.5 | 58.9 |
| AgenticVBench 多模态工具使用 1 | 36.8 | 14.5 | 45.0 |
| OmniGAIA 联网搜索 1 | 74.0 | 57.2 | 78.6 |
两处口径需要摆在一起看。第一处是那条最醒目的进步:AliMeeting 的 DER 与 cpWER 从 88.11 / 89.61 降到 3.35 / 17.181。DER 88 意味着上一代的分离结果与标注几乎对不上,这一代把它修到 3.4,同时又超过了 Gemini 3.8 Flash 的 72.6——官方对照图的同一面板把这条曲线记成综合分 11.1 到 89.7,读者从图里就能看到它是一次修复加一次反超1。
第二处是导语那句「音视频表现接近 Gemini 3.8 Flash,音频整体超过 Gemini 3.8 Flash」的算法。官方没有说明「整体音频」按哪些轴、用什么权重平均,逐轴看 Gemini 仍在 MMSU(83.3 对 82.1)、VoiceBench(92.3 对 91.6)、Audio MultiChallenge(71.9 对 71.5)、WildSpeech(76.4 对 74.3)四项小幅领先1。对照表里还有若干空格,官方注明是尚未取得或不适用的分数,逐轴比较只能停在有值的那几项上。
文本能力这一边,官方口径是「与同尺寸纯文本模型相当」。同一篇里的对照是它的同尺寸纯文本型号 Qwen3.8-Flash:SWE-bench Pro 63.3 对 62.5,CoWorkBench 75.3 对 73.9,DeepSWE 1.1 是 57.8 对 58.7,SWE-bench Multilingual 是 80.5 对 81.0,GPQA Diamond 是 91.0 对 91.71。这几项互有胜负、差距都在一两个点内,说明这一代把语音与音视频吃进来时,没有在编码和办公任务上付出明显代价。参考点是上一代的位置:Qwen3.5-Omni 的技术报告当时写的是 256k 上下文与「10 小时以上音频理解」,这一代把上下文推到 100 万 token7。
长音视频怎么算得起:先粗后细地找证据
几小时的视频里,答案常常只在几分钟的画面里。官方的做法是让模型从问题出发,自己决定看哪一段、听哪一段,用多轮由粗到细的检索把计算集中在相关片段上。
| OmniVideoBench 上的两种模式 | 准确率(越高越好) | 每次查询的 token(越低越好) |
|---|---|---|
| Static 直接理解 1 | 63.4 | 145,736 |
| Agentic 模式(跑 Qwen Code)1 | 67.8 | 79,117 |
准确率涨 4.4 个点,token 少用约 45.7%1。这两行数字说明增益来自哪里:模型把计算集中在相关片段上,要处理的画面量降了约 46%。
官方的第二组对照更值得记下来。两家模型都跑在 Qwen Code 这个运行时上,OmniVideoBench 从 63.4 涨到 67.8(Qwen)与 65.2 涨到 70.1(Gemini 3.8 Flash),Video-MME-v2 从 65.0 涨到 71.3 与 71.0 涨到 72.7;只有 LVOmniBench 上出现反转,Qwen 从 63.3 涨到 73.6,Gemini 停在 70.71。同一个智能体运行时给两家都加分,加完之后 Gemini 仍在两项上领先,Qwen 在长视频那一轴反超。把智能体模式的分数全部记到模型能力上,会高估这一代;反过来,把 LVOmniBench 的 73.6 当成通用优势,同样会高估。官方另有一条说明:智能体模式跨轮保留上下文,两种模式的条件因此并不完全对等1。
可控描述是同一轴上的另一半工作。用户可以在提示里指定看谁、看哪一段时间、要多少细节、用什么输出格式;同一段视频可以只给概要,也可以按镜头、光照与声音做结构化细描1。官方同时给了两条工程做法:把画面、台词、音乐、音效、环境声分节输出并保留时间戳,以及把完整的 JSON Schema 写进提示以保证下游能解析1。会议场景是这套能力的压力测试:多说话人轮流与重叠发言时,模型同时用音频与画面判断谁在说,支持最长 1 小时的音视频输入,端到端做说话人切分、转写与身份对齐,再接上工具去发邮件、建任务甚至写代码1。
每小时 0.2 美元是怎么算出来的
音视频输入的成本结构是这类模型落地时最先被问到的问题。官方给的两个降幅是:每小时音频输入的价格比 Qwen3.5-Omni-Plus 低 98% 以上,每小时音视频输入低 93% 以上1。
| 价格面板(美元,越低越好) | Qwen3.8-Omni-Flash | Qwen3.5-Omni-Plus | Gemini 3.8 Flash |
|---|---|---|---|
| 含音频的视频输入(每小时)1 | 0.20 | 3.27 | 0.84 |
| 音频输入(每小时)1 | < 0.01 | 0.28 | 0.09 |
| 输入 token(每百万)1 | 0.15 | 1.40 | 0.75 |
| 输出 token(每百万)1 | 0.47 | 8.30 | 3.75 |
这张表里有一处必须同时写的条件:每小时的价格是用两分钟素材的输入成本乘 30 估出来的,音视频输入按 720p、每秒 1 帧采样1;抽帧密度或分辨率一改,每小时成本就跟着变。币种也有两套口径:正文脚注说文本价格按人民币每百万 token 计,同一篇的对照图用的是美元,图注只说明两个 Qwen 模型用的是国际价1。
12 小时把 3B 模型的方言错误率降四成
这次发布里还有一条实验,方向是让模型自己做研发。官方给 Qwen3.8-Omni-Flash 的任务是:12 小时内改善 Qwen2.5-Omni-3B 的四川话识别,交付一个可用模型1。
模型自己选了 WenetSpeech-Chuan 评测集、定下评测标准、跑出基线,然后直接听音频样本、用识别结果诊断问题、构造针对性训练数据,连着跑了四轮实验,共建 3,413 条训练样本,按评测反馈保留有效改动、回滚失败的尝试1。Qwen2.5-Omni-3B 在同一评测集上的字符错误率从 25.79% 降到 15.30%,相对下降约 40.7%1。
这条结果的适用范围要跟着数字一起读:它是单一方言、单一模型、四轮实验的一次跑法;评测集由模型自己选定,官方没有给出人类工程师在同样时间内能达到的水平作对照,也没有公开这条流水线的算力与 token 成本1。这三项缺一项,40.7% 就只能当作一个存在性证据:这条路能走通,能走多远还没有读数。
实时那支与它的延迟表
Qwen3.8-Omni-Flash-Realtime 走 WebSocket 与 WebRTC 两条接入方式,官方示例直接打开摄像头与麦克风做实时音视频对话,输出模态里同时有文本与音频1。官方称它是首个能靠声音定位目标的全模态模型:把空间声音与画面合起来判断声源的方向与距离,同时感知障碍与可通行区域,再调工具做定位、搜索与路径规划1。「首个」是官方自述,材料里没有第三方对照。
延迟表的数字是这样的:纯音频输入时,首个 token 在 591 到 618 毫秒之间,首个音频包在 978 到 1,026 毫秒之间;音视频同时输入时,这两个数字变成 838 到 981 毫秒与 1,215 到 1,350 毫秒;文本输出速度在 81 到 85 token/秒,音频生成的时间比(RTF,生成一秒音频所需的时间)稳定在 0.1531。官方只说明这是「不同输入条件下观测到的」结果,硬件、地域与并发条件都没有写在表里,把它当作生产环境的承诺前,需要在自己的部署上量一遍。
今天能拿到什么
模型侧的入口是阿里云百炼的
qwen3.8-omni-flash,可用地域包括华北 2(北京)、新加坡、中国香港、日本(东京)、德国(法兰克福)与美国(弗吉尼亚),各地域用各自的 API Key2。调用协议兼容 OpenAI 的 Chat Completions 与 Responses 两种,思考强度用 reasoning_effort 调,preserve_thinking 默认开启1。可以下载的东西有两个仓库:Qwen-MM-Plugins 与 Qwen-Live Harness,都带安装脚本。模型本体的权重在官方材料里没有出现,这一代走的是 API 路线。
官方的发布页也有两处状态需要读者自己留意:页面标注的日期是 2026 年 9 月 18 日,标题后带一个
[draft] 标记;本代的参数量与架构细节,官方在博客与图里只给到 Thinker、Talker、视觉编码器与空间音频编码器这一层,发布材料里也没有指向技术报告的链接1。上面所有对照数字都出自 Qwen 自己的发布表与对照图,评测运行的运行时分别是 Claude Code(WildClawBench-MM)、OpenClaw(UniClawBench)与无运行时(OmniGAIA)1。按这两条曲线做选择并不复杂。多说话人会议记录、方言与多语种转写、音乐与音频内容理解、需要按小时读长音频的活,这张表上都指向这一代;几小时视频的深度推理、需要图像工具链的智能体任务,Gemini 3.8 Flash 那一列还占着上风,这一代的优势要等到把长视频检索接进自己流水线之后才谈得上。想验证哪一种,两个仓库今天就能装进常用的智能体运行时里跑起来。
References
- 1
- 2qwen3.8-omni-flash 模型信息(阿里云百炼)
help.aliyun.com
- 3模型大全(阿里云百炼)
help.aliyun.com
- 4QwenLM/Qwen-MM-Plugins
github.com
- 5QwenLM/Qwen-Live-Harness
github.com
- 6QwenLM/Qwen Code
github.com
- 7
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.