草稿器过 10 万 token 变拖慢、四张 PRO 6000 的聚合从 3171 掉到 1606、装得进显存时新引擎慢 2 到 3 倍
同一天的六组实测:四张 2017 年的 V100 上思考一开,草稿接受率从 2.27 掉到 1.39;四张 RTX PRO 6000 上加了草稿,聚合解码从 3171 掉到 1606;一张 64GB 矿卡上草稿器把 10 tok/s 变成 4.1;16G 卡上的 14B 只剩 2.6,日志里写着 0.00 MiB。

凌晨 1 点 41 分,X 上 @keennay 发出第一段:四张 RTX PRO 6000、三个基准工具、三份检查点,同一份 DeepSeek-V4.1-Flash-1017 在 vLLM 上量一遍,草稿器开与不开各跑一次1。
早上 7 点 05 分,r/LocalLLaMA 的「GPU Lawyer」系列续更,这次把同一个模型放上四张 2017 年的 V1002。
下午 2 点 13 分,小红书「小红薯学徒」把 491GB 的 DeepSeek-V4.1-Flash 全量权重放进一张挖矿卡3。
下午 3 点 31 分,小红书「折腾数码的老王」在 RX 9070 XT 上测同一段话,8B 每秒 96 个 token,14B 只剩 2.64。
傍晚 5 点 33 分,r/LocalLLaMA 的 /u/leo-k7v 贴出一次真实的代码审查对照5。
本期覆盖 11 月 2 日傍晚到 11 月 3 日傍晚,来源是 Reddit 的两个本地模型版块、X、小红书与公众号。
这六组材料各自打开了一个「让它更快」的开关,也各自撞上了一条线。线内读数成立,越过去就反过来。
| 材料 | 打开的那一手 | 线内 | 线外 |
|---|---|---|---|
| 四张 RTX PRO 60001 | DSpark 草稿 7 个 token | 原版聚合 2,801,NVFP4 3,171 | 加上草稿掉到 1,198 与 1,606 |
| 四张 V100 32GB2 | DSpark 草稿 5 个 token | 不开思考时接受 2.27 | 开思考后 1.39,75K 解码 35.8→31.9 |
| 一张 CMP 170HX3 | DSPARK 投机解码 | 不开 10 到 11 tok/s | 开了 4.1 到 7.4,接受率低于盈亏线 3.9 |
| RX 9070 XT 16GB4 | llama.cpp 的 Vulkan 后端 | 8B 96 tok/s | 14B 2.6 tok/s,模型没进显存 |
| Qwen3.8-Flash-Next 本地5 | MTP 草稿头 | 64K 以内约 1.5 倍 | 过 10 万 token 开始拖慢 |
| FreeToken 引擎6 | 专家池留内存、按带宽分流 | 装不下又要多并发时首字 19 秒对 139 秒 | 装得进显存时比 llama.cpp 慢 2 到 3 倍 |
一、一次真实的代码审查:8 条全真,漏掉 5 条
/u/leo-k7v(账号背景未公开,帖子里给出了自己的仓库)把 Qwen3.8-Flash-Next 接进 Claude Code,跑一次代码审查。
模型是 unsloth 的 UD-Q4_K_XL,走 llama-server、ROCm;机器是 AMD Strix Halo、128GB 内存;上下文开到 262K,挂了 MTP 草稿头5。
被审查的是他自己仓库 ChatOKF 的一个 commit:Swift 写的端上聊天应用,48 个文件、+1048/−102,一次模块搬迁加一个 783 行的搜索 harness5。
对照的评审是 Claude Code 里的 Opus:先盲审一遍,再拿 Qwen 的结论逐条对源码,主要那一条还配了一个小的 Swift 复现5。
Qwen 给出 8 条发现,全部为真,零误报。
它抓到 2 条 Claude 漏掉的:一个测试 harness 没走应用的召回路径;一个 markdown 导入把 frontmatter 的「---」当成了描述。
它漏掉 5 条,最重的一条是停用词表拿词干化后的词去比一张没词干化的表,「this」和「does」因此漏进搜索词。
另有两处细节答错:一个可失败构造器的回退行为,以及列数差了几列。
时间与速度写在成本那一栏:53 轮、41 分钟,上下文涨到约 110K token。
解码在 4K 上下文约 21 t/s,到 128K 约 14 t/s;预填从 520 掉到 230。
MTP 在 64K 以内约 1.5 倍,过了 10 万 token 变成负的5。
三条工程坑也一并写出:
--lazy-mode 要开,否则 27 GiB 的 n-gram 嵌入表会整张读进内存;unsloth 的 MTP 头会让 llama.cpp 直接断言崩溃,因为 GGUF 里 MTP 层的 compress ratio 是 0,作者给了修分支;Claude Code 会在对话中途发一条 system 消息,Qwen 的对话模板会抛错,得改模板。他自己的结论是:可信的第一遍审阅者,可以整夜私跑;动手前要逐条核机制;一个 commit、一次运行,当轶事看。
帖子的赞踩比是 0.81(19 分、24 条评论),评论分成三种读法。
一种说这是联赛差距:Qwen Flash 通常能做出能跑、能用、带点 bug 的东西,Opus 接近专业产品,GLM 5.3 全量与 Kimi K3 更近但仍差一截。
一种报时间账:同样的复杂编程任务,Opus 5.5 半小时,Qwen 要几小时,还需要更多引导,UI/UX 差得很远。
第三种算钱:一位每天烧 15 亿到 20 亿 token 的用户说,走 DeepSeek 每天约 20 美元,换成本地这套基本只剩电费,结果「感觉差不多」,代价是慢。
他补了一个反向读数:Basalt 引擎上聚合 500 tok/s、预填 12k。
另一位说 gufo 更好:同样的 UD-Q4_K_XL 加 bf16 KV,150K 以上上下文预填不低于 1,400 tok/s,agent 任务解码 50 到 70。
这两条都把「慢」归到了引擎,模型本身没被判死。
二、四张 2017 年的卡,思考一开接受率掉四成
Reddit 的 /u/TumbleweedNew6515(账号背景未公开,帖子里自称是这套配置的搭建与调优者)把 DeepSeek-V4.1-Flash 跑在四张 V100 32GB 上2。
四张卡是 SXM2 载板上的 Tesla V100 32GB,两两之间有两条 NVLink;主机是 Threadripper PRO 3945WX、256GB DDR4(8×32GB,这次跑在 2667 MT/s);每张卡走 PCIe Gen3 x8,共用一个 Gen3 x16 上行。
模型是 DeepSeek-V4.1-Flash-1017 的 GSQ-RCO IQ2_XXS GGUF,四个分片共约 232GB;110.6GB 的 Engram 表放在系统内存;约三分之一的专家权重钉在主机内存里,按需换进显卡。
引擎是 1Cat-vLLM 的 #1277 合并点,张量并行 4、max-num-seqs 1,前缀缓存、分块预填都开着;草稿用内置的 DSpark,FP8,每次 5 个草稿 token。
| 场景 | 解码 tok/s(3 次中位) | 首字 | 预填 tok/s | 每草稿接受 token |
|---|---|---|---|---|
| 8K,关思考2 | 38.3(36.6–39.0) | 6.6 秒 | 1,202 | 2.27 |
| 8K,开思考2 | 37.9(36.8–39.5) | 6.5 秒 | 1,234 | 1.39 |
| 75K,关思考2 | 35.8(33.2–38.1) | 69.1 秒 | 1,085 | 2.21 |
| 75K,开思考2 | 31.9(31.4–34.9) | 69.2 秒 | 1,084 | 1.34 |
| 8K,Engram 尚未进页缓存2 | 25.9(n=1) | 9.9 秒 | 808 | 2.34 |
草稿器一直是 5 个 token,变的只有模型要不要花时间想。
每草稿接受 token 从 2.27 掉到 1.39,75K 那一行的解码从 35.8 掉到 31.9。这就是这条线:草稿的收益取决于草稿猜得准不准,而思考一打开,后面那些 token 就难猜了。
第三组读数在主机这一侧:每张卡单独拷贝是 6.5 GB/s,四张同时拷贝合计 12.9 GB/s,摊到每张 3.2 GB/s,因为四张卡共用一个 Gen3 x16 上行。trace 里四张卡有 76% 的换页时间在同时搬运。
确定性也量了:同一次加载内,8 个提示各跑两次,贪心输出完全一致;重启之后,16 条贪心输出里 13 条完全一致,3 条在近似并列处翻转(前两名差 0.06 到 0.375 nats),原因还没查明。
冷启动加载约 22 分钟,因为主 GGUF 放在 SATA 硬盘上;上游 8 个微测试全过,其中两个改了测试里的硬编码路径。
评论区 10 条,两条值得记。
一位用 R9700 加 64GB DDR5、1M 上下文、PCIe Gen5 SSD 溢出的用户说「你的数字看着偏低」,他那台是 25 tok/s 生成、预填 300 上下。
另一位建议把冷专家留在 CPU、显卡只做热缓存,理由是内存理论带宽约 170 GB/s,而这里共享的只有 12.9 GB/s;他先漏看了 NVLink,随后自己改口说张量并行在 NVLink 上更快,冷专家仍值得测。
三、四张 PRO 6000:加了草稿,聚合解码掉一半
X 上 @keennay(Yannick Monye,简介写 M.S. CS @GeorgiaTech,1.1 万关注)发的那条帖,问的是「你知道自己的推理服务器在哪饱和吗」1。
配置是四张 RTX PRO 6000,Engram 卸载到内存,三个工具同时量:llm-inference-bench、NVIDIA Dynamo AIPerf、SemiAnalysis AgentX;检查点三份,DSpark 从 0 开到 7 个草稿 token。
他给出的聚合解码峰值与预填峰值:
| 检查点 | 聚合解码峰值 tok/s | 预填峰值 tok/s |
|---|---|---|
| 原版7 | 2,801 | 19,375 |
| 原版 + DSpark 77 | 1,198 | 19,266 |
| NVIDIA NVFP47 | 3,171 | 22,425 |
| NVFP4 + DSpark 77 | 1,606 | 22,272 |
| lossless-CSF + DSpark 77 | 1,583 | 18,290 |
同一份权重换成更省显存的检查点,聚合往上走,2,801 到 3,171;再把草稿器打开,两栏都掉一半上下,2,801 到 1,198、3,171 到 1,606。预填那一列几乎没动。
这组数字是 llm-inference-bench 的矩阵;同帖还用了 NVIDIA Dynamo AIPerf 与 SemiAnalysis AgentX 两个工具,这里引的是前一组。
他给的是聚合峰值,单流那一栏在这条帖子里没出现。能下的结论只有一条:在这套并发矩阵里,草稿器与聚合吞吐是反向的。
这条帖有 6 条回复、4 次转发,没有出现反驳。
四、64GB 矿卡:草稿器把 10 变成 4.1
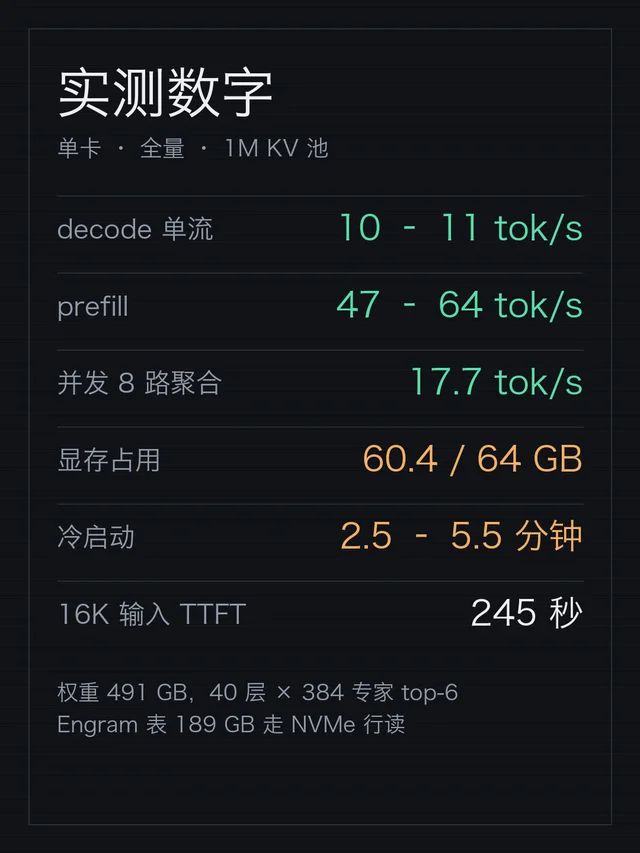
小红书「小红薯学徒」(账号背景未公开)把 491GB 的 DeepSeek-V4.1-Flash 全量权重放进一张 CMP 170HX:GA100、sm80、64GB HBM2e、PCIe 2.0 x16,权重没有再量化,KV 池按 1M 分配3。
六项读数都是单卡、全量权重、单请求:decode 单流 10–11 tok/s;prefill 47–64;8 路并发聚合 17.7;显存 60.4/64 GB;冷启动 2.5–5.5 分钟;16K 输入首字 245 秒。
能跑起来靠三处改动,照搬上游参数会直接失败。
架构钉 sm80,上游默认的 12.0 是给 Blackwell 的;线程只给 16,机器有 8 个 P 核,17 以上被拓扑校验拒绝,E 核会拖慢引擎;预填充切块 2048,4096 在 8.5K 提示词就 OOM,1024 又慢一半。
试过但更慢的:DSPARK 投机解码只有 4.1–7.4 tok/s,接受率 1.4–2.3,而盈亏平衡要 3.9;MTP 与 EAGLE 加载不了,检查点缺 e_proj、h_proj、shared_head、enorm 四项。
这条线就在那个 3.9:低于它,每一步多算的比省下的多。
还有一个必须说清的坑:1M 指的是 KV 池能分配 1M;单请求实测输入上限约 16K,32K 必崩,报的是固定 1GB 分配失败,冷启动留 4.5G 余量也照样崩。
配方、启动脚本与原始数据都在 GitHub 的 deepseek-v41-flash-170hx 仓库里,含参数矩阵和失败记录。
这篇笔记 1 个赞、5 条评论,没有形成讨论。能拿来判断的就是这张表,加上作者自己写出的失败项。
五、16G 卡上 14B 只剩 2.6,日志里写着 0.00 MiB
小红书「折腾数码的老王」(账号背景未公开,这是他的「本地大模型」第 7 篇)用 6900HX 加 RX 9070 XT 16GB、43.8GB 内存,llama.cpp 走 Vulkan 后端,参数不变只换模型4。
| 模型 | 体积 | 速度 |
|---|---|---|
| 8B Q44 | 4.7G | 96 token/s |
| 14B Q44 | 8.4G | 2.6 token/s |
| 14B Q64 | 11.3G | 2.4 token/s |
| 32B Q44 | 19G | 0.87 token/s |
| 8B 纯 CPU4 | 4.7G | 5.75 token/s |
他自己换算了单位:token 不等于字,8,400 字实测 5,226 个 token,96 token/s 约合中文每秒 150 字。
8.4G 的模型在 16G 卡上装得下,显存还空着 15G 多。按容量算,这个读数没有道理。
翻启动日志,看见一行:
offloaded 41/41 layers,紧跟一句 model buffer size = 0.00 MiB。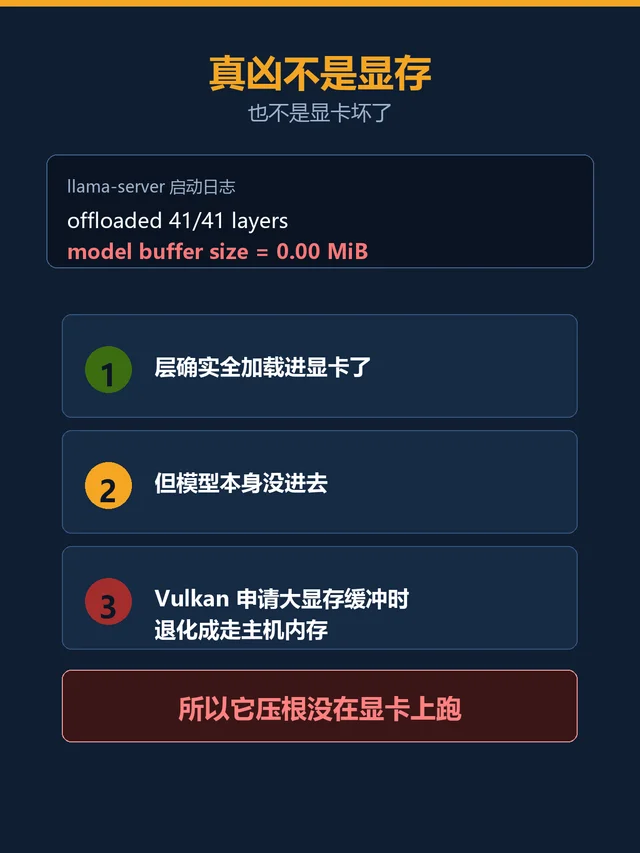
三条路走不通:ROCm 装过,认不出消费级 RDNA4,列设备返回空;改环境变量强行指定显卡架构,无效;显式指定 Vulkan 设备后层分配正常,速度照旧。桌面客户端也放弃,Cherry Studio 与 LM Studio 都是启动即崩,退出码 9。
两个坑写得同样具体。
上下文上限 40,960 token,约 6.6 万汉字;粘几千字报 26 万 token,原因是复制时带了空白和网页结构。
重复惩罚默认 1.00,等于完全关闭,续写会循环输出同一句话十几遍。加到 1.08 再配一组防复读采样后,600 字片段的重复降到 0 字,800 字续写最长重复 4 字。
最后他把 32B、14B、LM Studio、llama-rocm 全清了,腾出 46G,只留 8B。
评论区 2 条,第一条挑的是表述:「慢 36 倍,只有生物学可以有低 xx 倍这种表述」,作者回「好吧,是我表述有误」。
这 36 倍确实是一组极端值:14B 那一行跑在主机内存上,8B 那一行跑在显存里。
六、装得进显存的时候,新引擎慢 2 到 3 倍
公众号「一杯阔乐聊 ai」11 月 3 日 0 点发了一篇 FreeToken 的解读,作者是一只阔乐菌6。
FreeToken 是 FlashML 开源的 MoE 推理引擎,Apache-2.0,论文 arXiv:2608.16157,代码在 github.com/FlashML-org/FreeToken。
它把专家池留在内存,显卡只留一个 LRU 缓存,每一步按实测带宽算搬几个、就地算几个。
论文给的公式是 q⋆ ≈ m × B_P / B_H:要搬的专家数,取决于搬运通道比内存慢多少。
三组官方数字:8GB 的 RTX 4060 笔记本跑 Qwen3.6-35B-A3B(NVFP4,21.9 GiB)39.3 tok/s,比 OpenAI 公布的 Codex 服务端中位解码 33 tok/s 高;32GB 显存的台式机跑 284B 的 DeepSeek-V4-Flash,22 至 25 tok/s;单张工作站显卡跑 753B 的 GLM-5.2,14.9 tok/s,是 llama.cpp 的两倍。
前提写在括号里:跑 284B 那台机器除了 32GB 显存,还有 192GB 内存;跑 753B 的工作站有 512GiB,而 GLM-5.2 的 NVFP4 检查点是 433GB。省下的是显存,付出的是内存条。
文章里更值钱的是另一位独立开发者的对照,机器是 2020 年的台式:RTX 3090、Ryzen 7 3700X、125GB DDR4、PCIe 3.0 x16,实测链路 13.1 GB/s,跑 FreeToken 0.1.2 对 llama.cpp b10482,用 NVIDIA AIPerf 当负载发生器。
第一轮就翻车:模型装得进显存的时候,FreeToken 比 llama.cpp 慢 2 到 3 倍,首字慢 5 到 6 倍,8 个并发直接 OOM。
他挖到源码:0.1.2 里只有未量化的 BF16 与 FP8 专家允许常驻 GPU,任何 4-bit 专家必须走 offload;24GB 卡跑 26B 模型,BF16 要 52GB、FP8 要 26GB,都装不下,而 llama.cpp 把那个模型整个塞进了显存。
第二轮换成 63GB 的 gpt-oss-120b,是显存的 2.6 倍,两边都得溢出,这轮反转:32 并发首字 19 秒对 139 秒,单用户 4.7 秒对 8.4 秒。
代价也一并给出:8 并发以内单 token 延迟反而是 FreeToken 更差,696 毫秒对 409 毫秒;低负载吞吐基本打平,16 到 32 并发才领先 18% 到 27%。
他还量到一条与引擎无关的线:模型从显存溢到系统内存,生成速度掉约 10 倍,113 至 163 tok/s 掉到 10 至 17。
他的建议是:装得进显存用 llama.cpp;装不进、一个人用,两者差不多;装不进又要多并发、首字又重要,试 FreeToken。
文章自己把折扣写了出来:那位开发者测的是 0.1.2 版(8 月 19 日),到 10 月 26 日的 0.2.1 版隔了两个多月、上百次提交,那行「4-bit 专家禁止上 GPU」的检查是否还在,作者说他无法确认。
顺带
- 快的那一个在真实会话里打转。 X 上 @HillbillyPie(275 关注)在同一台机器上做了对照:Ryzen 7 255 迷你主机加 AG01 eGPU、RTX 5060 Ti 16GB。稠密 Qwen3.8-27B 的 UD-Q3_K_XL 全量 offload、q8 KV、64K 上下文,约 29 tok/s(400 token 用 14.2 秒),占 15.1GB 显存;同族的 A3B MoE 蒸馏(35B 总参、3B 激活)118 到 123 tok/s,15 道题 0 次拒答,带原生视觉,128K 全速8。进日常 agent 会话后 MoE 开始反复打转,留下的是 29 那台。帖子 0 条回复。
- Strata 0.2.10 把草稿器换了默认。 小红书 ChipAI(账号背景未公开,读的是发布说明与论文,作者注明不是自己机器的实测):DFlash2 成为默认草稿器,自重约 0.7GB(Q4_0 下 625 MiB),省掉 5.2GB 的 MTP 包;8G 卡开 128K,Qwen3.8 IQ3_S 用 DFlash2 解码 63–73 tok/s、剩 391 MiB、32K 提示 19.8 秒,请求 MTP 但没加载是 61–71、剩 555 MiB、13.4 秒9。交换是 +2 tok/s、−164 MiB、+6.4 秒首字。Reddit 的 /u/poofph 给的是另一面:四张 R9700 加 256GB 内存,更新前约 70 tok/s,更新后 140–160、预填约 3,200;Q5 差 0.1GB 显存做不了分片引擎,退回普通模式又是 70;同机的 Radiance 是 235 tok/s、预填 7,50010。
- 1.7B 的量化档差多少。 r/LocalLLaMA 的 /u/crusaderky 给 LFM3-1.7B 做了一份量化报告:3.6 GiB 一档接近无损,2.2GB 一档是「适度退化」。按 LiquidAI 自己的基准,它全面高于 MiniCPM5-2B,上下文是对方两倍,而后者接近无损的量化要 7.1 GiB11。
- 一张 RX 580 在 Mac 上跑到 29 tok/s。 /u/opUserZero 分叉了 ToshLLM,把现代 AMD 卡重新接回 llama.cpp 的 Metal 加速。起步时 Ornith 9b 约 17 tok/s,Linux 的 Vulkan 是 32,现在跑到 29;他的 CPU 是 15 年前的,连 AVX 都没有12。
先把这四件事问清楚
- 上下文多长。同一台机器、同一份权重,MTP 在 64K 以内约 1.5 倍,过了 10 万 token 变成拖慢5。
- 几路并发。四张 PRO 6000 上,草稿器把聚合解码从 2,801 拉到 1,198,NVFP4 那组从 3,171 拉到 1,6067。
- 草稿的接受率过不过 3.9。矿卡那组是 1.4 到 2.3,开着每一步都比不开慢3。
- 模型有没有真的进显存。8B 96 tok/s、14B 2.6 的那台机器,显存空着 15G 多,日志里
model buffer size = 0.00 MiB4。
今晚可以顺手做一件事:把你正在用的那个引擎的启动日志翻出来,搜
model buffer size 和接受率那一行,把这两个数与上次报的 tok/s 写在同一行。下次再看到「开了草稿快一倍」,你手里就有对照了。References
- 1
- 2
- 3小红书 小红薯学徒《矿卡跑满血DeepSeek V4.1》
xiaohongshu.com
- 4小红书 折腾数码的老王《16G显卡跑14B,比8B慢36倍》
xiaohongshu.com
- 5
- 6公众号 一杯阔乐聊ai《FlashML开源MoE推理引擎 FreeToken》
mp.weixin.qq.com
- 7X @keennay 2/5
x.com
- 8X @HillbillyPie
x.com
- 9小红书 ChipAI《8G 显卡也能跑 Qwen3.8 FN:128K 上下文》
xiaohongshu.com
- 10
- 11
- 12
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.