Mistral Large 4 技术报告:KV 缓存省下的 16 倍要拿 agentic 分数还,自家表里编码只排第二
Mistral 把 Mistral Large 4 的技术报告挂上了 Hugging Face:30 页写了为什么从极致压缩退回接近全注意力、六张跨模型评测表里它赢哪几项,以及 4×GB300 服务一个副本的真实代价。

北京时间 11 月 3 日凌晨 2 点 30 分,Hugging Face 上
mistralai/Mistral-Large-4-1T-A52B 仓库里多了一份 30 页的 PDF:assets/technical_report.pdf,作者栏写 Mistral AI,PDF 的生成时间是同一天 02:12。1仓库的提交记录显示两次动作:11 月 2 日 23 点 50 分先加进来,两个多小时后更新了一版。2
10 月 29 日权重开放那条简讯里,「技术报告与后训练方法未公布」写在缺口一栏。5 这条补上的就是它,并且带来了六张带对照模型的评测表。
快速核对
| 项目 | 情况 |
|---|---|
| 文件 | assets/technical_report.pdf,30 页,PDF 生成于北京时间 11 月 3 日 02:12 1 |
| 时点 | 仓库 11 月 2 日 23:50 加入、11 月 3 日 02:30 更新;同期 Mistral 新闻页没有新条目 23 |
| 规格 | 1T 总参、52B 激活的多模态 MoE 1;72 层、128 个路由专家每 token 选 4 加 1 个共享专家、词表 204,800、上下文上限 1,048,576 6 |
| 预训练 | 巴黎附近的自有数据中心、3,840 张 GB200,45 天,约 415 万 GPU 小时,MFU 36%,goodput 94.1% 1 |
| 数据 | 两阶段课程:第一阶段占 65%(网页 56.3%、代码 16.9%),第二阶段 35%(代码升到 39.0%),序列长度从 4K 提到 40K 1 |
| 视觉 | 1.6B 参数编码器自训,图像最长边 1,540 像素,预训练期间冻结 1 |
| 后训练 | 智能体自造可执行环境,分软件工程、终端、CVE 补丁、知识工作四条产线,RL 用 CISPO 1 |
| 服务 | 4×GB300 跑一个副本,显存内 KV 缓存约 20M token;混合精度 NVFP4 权重 606 GB 1 |
| 评测 | 六张表、七个模型对照,行名标 AA、internal、Vals 三种来源 1 |
| 价格 | 每百万 token 输入 $0.70、输出 $2.10、缓存命中 $0.07,Batch 五折;三档 reasoning effort 78 |
| 权重 | 仓库 FP8 版约 1.06 TB、NVFP4 版 610 GB;社区已有 GGUF、MLX 与 2bit 量化 49 |
先压到极致,再退回来
Mistral 最初把 KV 缓存当作头号开销,四种压缩手段一起上。
每四层里一层用全注意力,其余用 512 token 的滑窗。跨层注意力共享(CLA)让每隔一层的全注意力层直接复用前一层的 KV。YOCO 让后半段的注意力层使用前半段产出的 KV,不再各自维护。1
三者叠起来,KV 缓存缩到全注意力基线的十六分之一。1
早期的消融看不出问题:困惑度、知识类基准都接近,省下的显存和吞吐是白拿的。1
问题在智能体任务上才露头。同样的训练 token 预算,从全注意力换到滑窗,SWE-bench Verified 往下掉;再叠 CLA,掉得更多。1
报告给这件事起了个名字:agentic penalty——架构本身会让 agentic 能力打折,而知识类基准上看不到同样的折扣。1
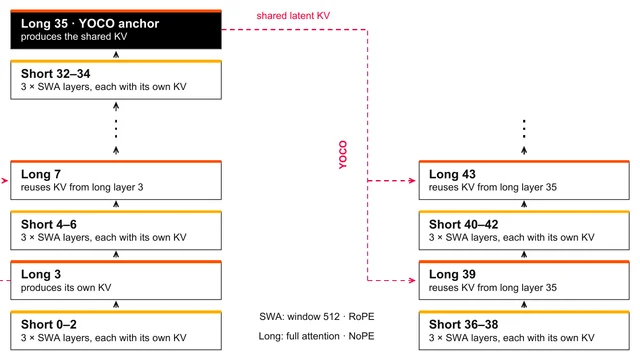
技术报告 Figure 3(第 5 页)。这就是后来被手术去掉的结构:Long 3 与 Long 7 之间的 CLA 复用、Long 35 作为 YOCO 锚点向后半段供 KV。截图时间 2026 年 11 月 5 日。1
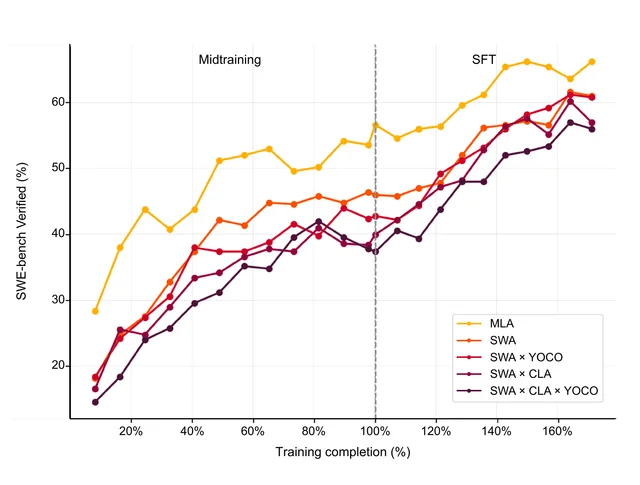
技术报告 Figure 4(第 5 页):中训与 SFT 期间的 SWE-bench Verified,横轴按标准中训长度折算,100% 处的虚线分开两个阶段。到 SFT 末段,全注意力约 66%,三层压缩叠加约 56%,差约 10 个百分点。截图时间 2026 年 11 月 5 日。1
手术:把 KV 生产者权重复制回去
放开滑窗限制很直接:让这些层看完整上下文就行。难的是拆掉 CLA 和 YOCO——原本靠别人 KV 的层,得自己算、自己存。1
Mistral 的办法是给每个受影响的层补一份 KV 生产者权重,从最近一个自持 KV 的 Long 层复制过来。1
位置编码换成可学习的 LeRoPE,注意力 softmax 换成 SSMax,替掉固定的 YaRN 缩放。1
报告说这一组改动在中训里下游更好,训练损失几乎一样——最大两处频率变化出现在 4K 训练长度附近,分别放大到 YaRN 的约 1.5 倍和 1.8 倍。1
YOCO 在全尺寸模型里留了下来。8×10²³ FLOPs 的对照显示,只做中训时,保留 YOCO 的那一版下游更好。1
接着转成 DeepSeek 稀疏注意力(DSA):先用 15.1B token 预热 indexer,主模型冻结、跑全注意力;再花 198B token 联合训练,indexer 在原来的滑窗组内共用。1
公开的
params.json 能看到手术后架构:lerope: true、ssmax_scaling: true、dsa.topk: 2048、fp8_indexer: true,ragged_attention 为空。6后训练:让智能体自己出题
代码环境来自公开 GitHub 仓库:作者智能体把候选提交做成能跑的环境,装工具链、找出可复现的测试,修复前失败、修复后通过的测试当验证器。1
第二道工序专门修题:让几个能力不同的求解器都跑一遍,再由智能体判断是模型不行还是题目有毛病。1
CVE 那条线把公开披露的漏洞转成仓库级环境,池子覆盖数万条 CVE、约 600 个弱点类别。1
RL 一步的规模:5.36M 条 rollout、452k 个组、306k 个实例,合计 162.5B 输出 token。代码任务占总 rollout 的 20%,却占输出 token 的 46.6%。1
峰值时流水线跑 26k 条并发 rollout,动用约 20k 个沙箱、3,104 张 GPU,训练与生成的配比是 1:2.5。加上裁判与其他服务,同时在跑的约 4,000 张。最长的一条 rollout 跑了约 37 小时,跨 136 次权重更新。1
三档 effort 出自同一条流水线:high 直接取高推理档的 checkpoint,medium 与 low 来自加了长度惩罚的 RL 教师,再用多教师 on-policy 蒸馏合成一个模型。1
六张表里它站在哪
六张表覆盖通用智能体、推理与知识、代码、网络安全、内部安全、金融与法律,对照 GLM-5.3、DeepSeek V4-Pro-0813、DeepSeek V4.1-Flash-1017、Kimi K3、Muse Spark Open。1
| 基准 | Mistral Large 4 | 最强对照 | 位置 |
|---|---|---|---|
| FrontierCode 2.0 | 19.7% | DeepSeek V4.1-Flash 19.3% | 第一 1 |
| Terminal-Bench 4.0 | 41.0% | GLM-5.3 40.0% | 第一 1 |
| Terminal-Bench 2.1 | 90.2% | DeepSeek V4.1-Flash 90.6% | 第二 1 |
| DeepSWE 1.1 | 65.2% | DeepSeek V4.1-Flash 74.2% | 第四(六个模型) 1 |
| AA Coding Agent Index v2 | 48.3% | GLM-5.3 48.9% | 第二 1 |
| CyberGym-E2E-AA | 79.0% | DeepSeek V4.1-Flash 76.3% | 第一 1 |
| AA Cyber Index | 50.9% | DeepSeek V4.1-Flash 56.8% | 第二 1 |
| HLE-Diamond | 17.3% | Kimi K3 26.9% | 最低 1 |
| AA-Briefcase | 42.5% | DeepSeek V4.1-Flash 53.5% | 第四 1 |
| HLAB-v1.1 | 15.83% | Muse Spark Open 25.00% | 第二 1 |
| B3 agentic security | 97.1% | GLM-5.3 94.8% | 第一 1 |
10 月 29 日那条简讯按官方公告写过「编码与 GLM-5.3 并列第一」。报告自己的表里这一项站不住:AA Coding Agent Index v2 是 48.3 对 48.9,落后 0.6 分;DeepSWE 1.1 更明显,65.2 对 GLM-5.3 的 66.9 和 DeepSeek 的 74.2,六个模型里排第四。15
拿第一的是 FrontierCode 2.0 和 Terminal-Bench 4.0,两项各领先 0.4 到 1 个百分点。1
网络安全一侧是同一个形状:CyberGym-E2E-AA 79.0 分领先 2.7 个百分点,AA Cyber Index 的 50.9% 却落后 DeepSeek 5.9 个百分点。1 上次写的 51% 就是这个数字的四舍五入。
最弱的一项在知识侧。AA-Omniscience 准确率 26.0%,有分数的六家里最低;非幻觉率 71.8%,六家里第二高。1 一个读法是它在不确定时更愿意不给答案,报告本身没有解释这个组合。
法务与金融也不占优:HLAB-v1.1 15.83% 对 Muse Spark Open 25.00%,Vals Finance Agent v2.1 61.72% 对 GLM-5.3 65.00%。1
官方数字与第三方榜对不上的两行
对得上的是这几项数字:HLE-Diamond 17.3%、GDP.pdf 17.6%、AutomationBench 57.8%、Omniscience 准确率 26.0% 与非幻觉率 71.8%,与 AA 榜一致。110
Terminal-Bench 4.0 一行只在括号里注了「AA Coding Agent Index」,FrontierCode 2.0 一行注的出处是 Cognition。报告没有给这两行的 harness 版本、时间预算与采样参数,也没有解释与 AA 榜的差异。1
拿这份表做选型的话,能当第三方可核的是与 AA 一致的那四项;Terminal-Bench 4.0 与 FrontierCode 2.0 两行先按厂商口径看,等 AA 的分项页更新再比。
服务一个副本要什么
报告给出的生产配置是 4×GB300 跑一个副本,显存里能放下约 20M token 的 KV 缓存,靠原生 FP8 KV 缓存加 offload。1
代价是通信。朴素的张量并行延迟最好,KV 却要在各卡复制,并发和缓存命中都上不去,于是 Mistral 改用上下文并行,把 KV 沿序列维切开。1
标准实现比张量并行慢很多,原因是 kernel 效率。重写通信原语、把计算和通信在内核里重叠之后,8 并发下的解码交互性提升 51%,通信开销压到张量并行的 10% 到 15%。1
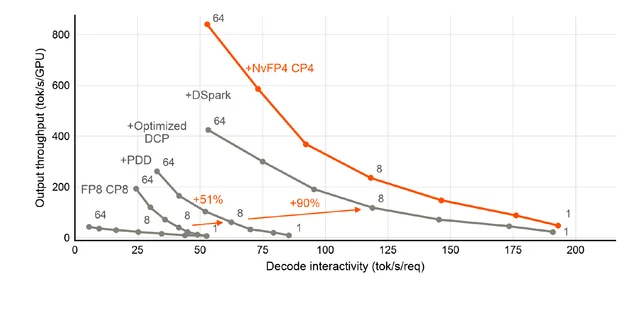
技术报告 Figure 16(第 20 页):50K 输入长度下,解码交互性(横轴)与每卡输出吞吐(纵轴)的取舍,点上标的是并发请求数。报告给的口径是 8 并发下自研解码上下文并行 +51%、再叠 DSpark +90%。截图时间 2026 年 11 月 5 日。1
投机解码用的是 DSpark,训练量 70B token,比 EAGLE-3 基线高 15%。1
量化只动了路由专家:其余组件保持训练精度,混出一份 606 GB 的 BF16–FP8–NVFP4 checkpoint,校准用 SFT 混合数据里的 2 亿 token,评测与 FP8 参考版持平。1
调度层用 llm-d 做路由与容错,Model Express 走 InfiniBand 做 P2P checkpoint 传输,新副本的启动时间压到 120 秒以内。1
现在能怎么用
走 API 的话,型号名是
mistral-large-4,每百万 token 输入 $0.70、输出 $2.10、缓存命中 $0.07,Batch 五折。78 价格与 10 月 29 日一致,这次没有动。三档 effort 是这次能用起来的东西。Artificial Analysis 已经把正式版建了档,并给了两档的成本:high 26.1 分、每任务 $2.06;medium 23.1 分、每任务 $1.41。10 从 high 降到 medium,指数掉约 3 分,每任务省 0.65 美元。
上次简讯里说的「AA 只有预览版条目」已经变了:预览版标记为 deprecated,正式版按 high 与 medium 两档分开记。10
自建的话,FP8 权重约 1.06 TB,NVFP4 版 610 GB,官方说的是 4 张 GB300 一个副本。4 社区侧已有 unsloth、ggml-org 的 GGUF,以及 mlx-community 的 2bit 与 4bit 版本。9
什么情况下值得排进评测:跑 agentic coding 与终端任务、对漏洞修补有需求的团队,报告里有实测位置的正是这两块。1
判断顺序也有一条可操作的:先在自己的 SWE 类任务或终端任务上跑一轮,别用 HLE 这类知识指标定去留——它在这类题上是有分数的六家里最低的。1
还没有的数字
语言模型的预训练 token 数没给。报告里唯一一个 8T 是视觉编码器的训练量。1
知识截止日期没写。1
AA 还没给 ML4 的输出速度、首 token 延迟与每任务耗时,这三栏在榜上是空的。10
六张表的 harness 版本、时间预算、采样参数都没写;Terminal-Bench 4.0 与 FrontierCode 2.0 两处与 AA 的差异,报告没有解释。1
三档 effort 各自多花多少 token,报告只有一张相对冗长度的训练曲线,没有绝对数。1
References
- 1Mistral AI:Mistral Large 4 Technical Report
huggingface.co
- 2Hugging Face:Mistral-Large-4-1T-A52B 提交记录
huggingface.co
- 3Mistral:最新动态
mistral.ai
- 4Hugging Face:Mistral-Large-4-1T-A52B 模型卡
huggingface.co
- 5
- 6Hugging Face:params.json
huggingface.co
- 7Mistral:Mistral Large 4 模型文档
docs.mistral.ai
- 8Mistral:定价说明
docs.mistral.ai
- 9Hugging Face:Mistral-Large-4-1T-A52B 相关仓库检索
huggingface.co
- 10Artificial Analysis:LLM 榜单
artificialanalysis.ai
- 11Mistral:Mistral Large 4 公开预览公告
mistral.ai
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.