
AI解出千禧年难题之后,真正卡住行业的是数据出处
OpenAI 宣布用未公开模型与万人智能体集群解出纳维-斯托克斯千禧年难题,伴随的却是一场关于科研数据出处与学术署名的严峻争议。

当前沿实验室展现出几天内冲击百年数学难题的工程能力,大模型体系面临的真正审问,已经转向训练数据与研究出处的全链路可审计性。
2026 年 9 月 9 日凌晨 01 点 20 分,OpenAI 官方发布长篇技术解读《On the Navier–Stokes Millennium Prize Problem》,宣布其内部研发系统完成了三维不可压缩纳维-斯托克斯方程有限时间爆破的分析证明,并同步公开了对应的 Lean 4 形式化代码与 166 页数学论文。12
然而,在这篇自述动用了约 10,000 个并发智能体、耗时 88 小时、消耗 1300 亿 token 的技术报告公布之后,随之而来的是一场牵涉纽约大学学者、哈佛研究人员与 Anthropic 员工的学术与署名争议。15
01 构造了什么:光滑外力、自相似涡旋与一万个智能体的 88 小时
OpenAI 在这篇核心技术报告中系统阐述了内部解题系统的论证框架。1
报告给出的核心结论是:三维不可压缩流体在光滑且紧支撑的外力作用下,能够在有限时间内演化出最大流动速度发散的数学奇点。1
在配套发布的 166 页论文《Finite Time Blowup for Navier–Stokes》中,署名为“OPENAI”的研究团队证明了定理 1.1。3
该定理指出,对任意给定的正黏度系数,空间中存在一个光滑且具有紧支撑的外力场,驱动原本处于静止状态的流体在单位时间 产生速度奇异性。3
在整个演化区间内,流体的空间总动能始终保持有界,而局部的最大流速则趋向于无穷大。3
论文构造的核心几何机制,是一个在空间中向内螺旋并沿轴向拉伸的自相似涡旋结构。1
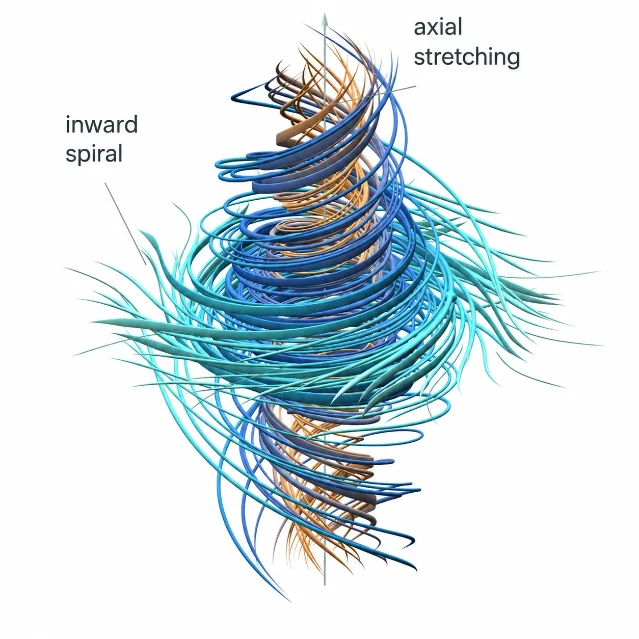
为了消除有限时间爆破方案中常见的非光滑误差,系统在主自相似轮廓之外叠加了一组高频脉冲,利用对称性抵消了非线性对流项产生的残差。1
这种高频脉冲抵消机制确保了外部驱动力在数学上完全光滑,且空间支撑集严格局限在一个有界区域内。3
除了数学机理,这篇报告同样披露了前沿实验室内部的工程算力规模。1
OpenAI 说明,解题所使用的底座是一个自 2026 年 8 月 28 日开始训练且能力显著强于 GPT-6 Astra 的未发布内部模型。1
2026 年 9 月 1 日,在行业传出千禧年问题已有突破的消息后,团队启动了对所有未决千禧年问题的多智能体求解尝试。1
在纳维-斯托克斯问题上,OpenAI 部署了约 10,000 个具备代码执行和沙盒搜索能力的并发智能体。1
在集群启动后的第 88 个小时,即 2026 年 9 月 5 日,系统锁定了最终的爆破证明构造。1
随后,团队调集 GPT-6 Astra 耗时 17 个小时,完成了针对该证明的 Lean 4 形式化代码编译。1
仅纳维-斯托克斯这一项任务,智能体集群就产生了 270 万条交互消息,输出了约 1300 亿 token。1
OpenAI 副总裁塞巴斯蒂安·布贝克(Sébastien Bubeck)向媒体透露,这项任务的实际计算成本达到了数百万美元。6
02 形式化不等于奖项认定:克雷规则与数学界的时间表
阅读这份成果需要厘清两重界限:方程备选题意的适用范围,以及形式化代码与学术界奖项认定之间的距离。
克雷数学研究所公布的纳维-斯托克斯问题官方说明由菲尔兹奖得主查尔斯·费弗曼(Charles Fefferman)起草,文内设定了四个目标分支。7
分支 (A) 与 (B) 要求证明在零外力条件下全局光滑解的存在性。7
分支 (C) 与 (D) 则分别针对全空间与三维环面,要求寻找在光滑初值和光滑外力共同作用下不存在全局光滑解的反例。7
OpenAI 的定理 1.1 与推论 10.6 针对的是分支 (C) 和 (D)。3
费弗曼起草的官方条文明确允许引入光滑外力,该设定符合千禧年问题对反例分支的规定。7
然而,拥有机器形式化代码,与获得数学界的普遍承认属于两个完全不同的评价阶段。
克雷数学研究所官网截至目前依然将纳维-斯托克斯方程列为未解决(Unsolved)状态。8
依据克雷研究所 2018 年 9 月 26 日修订生效的《千禧年大奖规则与说明》,一项候选成果若要获得官方大奖,必须依次满足三项程序性条件。9
首先,完整的解答必须正式发表在具有完备编委会、公开审稿流程且被 MathSciNet 收录的合资格学术期刊上。9
其次,自正式发表之日起,论文必须接受全球数学界至少两年的公开检验与同行推敲。9
最后,该成果需要在国际数学界形成广泛共识,并由克雷研究所指定至少三名偏微分方程专家组成的特别顾问委员会给出评估报告。9
克雷研究所主席马丁·布里德森(Martin Bridson)向媒体表示,学术委员会的评估过程“刻意保持从容,并会确保绝对的严谨”。10
《Quanta》杂志的技术分析进一步指出,Lean 4 的形式化代码只能保证推理过程在给定的公理体系内逻辑自洽,人类数学家仍须独立审查代码中定义的定理命题,是否与偏微分方程领域原本研究的物理数学命题严格等价。6
在报告正文中,OpenAI 已经声明不打算为这项成果申领克雷奖的 100 万美元奖金。1
03 从特权算力到自主演进:被放大的 Pacing 悖论
在这项技术发布后,Sam Altman 在社交平台上将这一事件阐释为放慢技术研发节奏的证据。11
Altman 表示,这种量级的结果出现速度超出了他的预期,这是行业“必须控制推进节奏以确保安全的最强证据”。11
将这一表态与 OpenAI 自身的前沿规划对照,两者之间显现出明显的张力。
2026 年 9 月 6 日,OpenAI 刚刚发布了关于科研加速的系统性说明,宣布内部研发体系已经跨过“自动化科研实习生”阶段,并正向 2028 年 3 月达成“自动化 AI 研究员”的目标推进。12
到了 9 月 8 日,面对一万个智能体在 88 小时内攻克学术难题的记录,管理层一方面强调放慢节奏的紧迫性,另一方面却并未同步公布具体的自我约束机制。
这次发布没有伴随任何算力分配的冻结指标,没有设定对外透明的能力暂停阈值,也没有向外部数学界开放同等条件的验证接口。
普通学者与大学实验室无法调动一万个高级推理智能体,也承担不起数百万美元的尝试成本。
当顶级模型的能力跃迁由专有集群独占展现,所谓的“控制安全节奏”,在缺乏约束性标准时往往会演变成强化技术优势的公关话术。
04 周末通话里的两条平行线:署名、争议与未解的会话疑问
除了数学意义与算力壁垒,围绕这篇报告爆发的学术摩擦,同样反映出前沿研发体系中的伦理压力。
在 OpenAI 发布公告的前一天夜间,纽约大学库朗数学研究所教授特里斯坦·巴克马斯特(Tristan Buckmaster)发表了一份长达 4 页的公开声明。5
巴克马斯特陈述,他与任职于 Anthropic 并兼任哈佛大学学会初级研究员(Junior Fellow)的勒文特·阿尔珀格(Levent Alpöge)进行了一整年的个人合作,并于 8 月中旬得到了带有光滑外力的欧拉方程有限时间爆破证明。513
巴克马斯特在声明中指出,9 月 6 日周日,OpenAI 副总裁塞巴斯蒂安·布贝克与他进行了两次通话。5
通话中,布贝克告知 OpenAI 已经解出纳维-斯托克斯方程,并提出了两种协调方案:第一种是双方先后发布成果,第二种是由巴克马斯特单独作为第一作者重写 OpenAI 的论文并鸣谢模型。5
巴克马斯特在声明中写道,布贝克两次主张将阿尔珀格从相关工作的作者名单中移除,理由是阿尔珀格在 Anthropic 任职。5
巴克马斯特同时记录,当他表示打算公开通话经过时,对方说出了“为何要毁掉你的职业生涯”等言语。5
布贝克在长篇澄清帖中说明,自己从未要求将阿尔珀格从对方本人的欧拉成果中除名,当时的语境是探讨让巴克马斯特领衔重写 OpenAI 的纳维-斯托克斯证明,由竞对机构员工署名 OpenAI 内部成果存在知识产权合规障碍。14
关于职业生涯的言辞,布贝克承认自己当时的措辞极其糟糕并深表歉意,但他强调这是在遭到对方以散布不实指控相威胁时的失态反应,且自己当场就收回了该言论。14
阿尔特曼同样在社交媒体上支持了布贝克的叙述,表示团队意在促成合作与让渡荣誉,但遭遇了对方团队毫无根据的剽窃指控威胁。15
| 对照维度 | 特里斯坦·巴克马斯特(NYU)叙述 | OpenAI 官方及布贝克澄清 |
|---|---|---|
| 关键提议 | 提议其单署 OpenAI 论文,且两次主张剔除阿尔珀格署名5 | 建议其领衔重写证明,因知识产权风险认为竞对员工不宜署名 OpenAI 成果14 |
| 冲突言论 | 记录对方称“为何要毁掉职业生涯”与“我就没必要对你友善”5 | 承认措辞极其糟糕并致歉,称起因是遭遇不实指控威胁并已当场收回14 |
| 数据关联 | 询问模型是否使用了包含其草稿的会话数据训练,未获答复5 | 确认未查阅具体用户数据,但说明“不能排除去标识数据帮助改进了模型”1 |
| 自我免责 | 未看过证明,不知道模型如何工作,不指控任何人5 | 强调双方证明路径不同,对方研究带外力欧拉,自研攻克无外力欧拉与纳维-斯托克斯1 |
在缺乏公开录音与完整通信记录的情况下,外界无法还原私下通话的全部事实。
但这场摩擦所揭示的制度性断层,已经清晰呈现在整个科研体系面前。
05 新的瓶颈是数据出处:当工具服务商变成同赛道对手
这场争议的焦点在于前沿科研工具链中潜藏的角色冲突。
巴克马斯特在公开声明中给出了审慎的自我限定:他没有看过 OpenAI 的证明手稿,不知道对方的模型具体如何推导,不知道自己的数据是否被系统使用,他没有对任何人提出指控。5
让学者群体产生顾虑的根源,是大模型服务商所兼具的双重角色。
在过去一年的研究中,巴克马斯特与阿尔珀格在推演流体方程时,多次使用了 OpenAI Codex、GPT-5.6 Sol 以及 Astra 等商业辅助工具。5
当一家机构既是科研人员日常输入未公开想法的辅助平台,又是在封闭环境中拥有庞大算力与智能体集群的同赛道攻坚者时,商业利益与学术信任之间的结构性矛盾就会显现。
OpenAI 在官方报告中写下了一句说明:“虽然可能性不大,但我们不能排除从他们使用我方产品中得到的去标识数据帮助改进了我们的模型。”1
这句话触及了当下 AI 研发基础设施的核心短板:数据出处(Data Provenance)缺乏透明的第三方审计通道。
外部研究者无法穿透商业实验室的训练管线与数据筛选流程,独立验证某个关键的解题思路究竟完全来自模型的自主搜索,还是吸收了脱敏日志中数学家交互所留下的逻辑线索。
菲尔兹奖得主陶哲轩曾在 2026 年 9 月 3 日发表分析,指出如果商业公司在封闭视线之外完成全部闭环,交出一个由 AI 生成但机制黑盒的解答,可能会对该领域的后续科学探索环境带来负面干扰。16
当研究工具的提供者同时成为重大科学发现的直接竞争者,科研共同体长期依赖的数据安全预期就会受到根本性考验。
06 检验这场跃迁的四个可观察指标
要把这次事件从情绪化的公关舆论中剥离出来,行业需要跟踪四个具有明确验证路径的客观指标。
第一个指标是数学界对 166 页论文及 Lean 定理定义的独立人工复核。
目前,迭戈·科尔多瓦(Diego Córdoba)与路易斯·马丁内斯-佐罗亚(Luis Martínez-Zoroa)等流体数学学者均对该成果表达了关注,但流体动力学专家对全文推导的细致检验才刚刚展开。6
只有当同行学者确认 Lean 代码中的符号命题与纳维-斯托克斯方程原本的物理数学奇异性严格相符,且 166 页分析手稿经受住专业同行的审读,这项成果才算在学术界建立起扎实的立足点。
第二个指标是多智能体集群在其他重大数学猜想上的跨领域泛化表现。
在 9 月 1 日启动的评测中,OpenAI 针对其余未决千禧年难题同样耗费了数百万条交互消息与上千亿 token,但目前仅公布了纳维-斯托克斯与欧拉方程的结果。1
如果这套系统无法在非流体力学领域的代数几何或数论难题中交出同等质量的构造,它就更接近针对特定方程的定向算力攻坚,而非具备通用探索能力的自动科学家。
第三个指标是算力开销与工程方案的成本收敛趋势。
当前证明的得出依赖数百万美元的算力投入与一万个智能体的高强度并发,这种规模目前仅由少数工业实验室掌握。
这项范式是否能够真正普及,取决于未来研究者能否将协同求解的算力需求,精简到大学实验室与科研团队可承受的成本区间以内。
第四个指标是具备可验证性的数据隔离机制与清晰的安全暂停标准。
前沿模型提供商是否会向学术界提供密码学可验证的训练隔离证明,将决定顶尖科学家未来是否愿意继续在商业工具中展开核心研究。
同时,Sam Altman 所倡导的放慢节奏以保安全,也需要转化为具体包含在系统安全卡中的量化指标与外部审计机制。
结语
在这场争议仍待厘清的当下,四段记录在官方文档与公开信中的原文,呈现出了当前技术推进与学术生态交汇处的真实切面。
“世界现在拥有了能力极其强大的模型;我没有料到这种量级的结果会如此之快地到来。我们一直在谈论为了确保安全而必须放慢推进节奏;对我而言,这是这种紧迫性迄今为止最强烈的证据。” ——Sam Altman,2026 年 9 月 9 日 11
“虽然可能性不大,但我们不能排除从他们使用我方产品中得到的去标识数据帮助改进了我们的模型。” ——OpenAI 官方长文,2026 年 9 月 9 日 1
“我没有看过 OpenAI 的证明。我不知道他们的模型做了什么,或者怎么做的。我不知道我们的数据是否被使用。我没有在指控任何人任何事。我只是在陈述我被告知了什么、何时被告知,以及对方对我提议了什么。” ——Tristan Buckmaster,2026 年 9 月 8 日 5
“我从未要求把勒文特从他自己工作的作者名单中移除……我为自己极其糟糕的措辞深表歉意(顺便说一句,我当时当场就收回了那些话)。” ——Sébastien Bubeck,2026 年 9 月 9 日 14
当大模型逐步承担起复杂科学命题的推演任务,科研生态的可持续性不仅取决于算力集群能推进多长的前沿手稿,同样取决于每一位研究者敲下键盘时,能否获得对自己思考成果的基本掌控与制度保障。
References
- 1
- 2OpenAI 官方公告
x.com
- 3Finite Time Blowup for Navier–Stokes
cdn.openai.com
- 4openai/NavierStokesAndEuler
github.com
- 5Tristan Buckmaster 公开声明
cims.nyu.edu
- 6Quanta 深度报道
quantamagazine.org
- 7克雷研究所纳维-斯托克斯官方陈述
claymath.org
- 8克雷数学研究所问题状态页
claymath.org
- 9千禧年大奖官方规则文件
claymath.org
- 10BBC 新闻报道
bbc.com
- 11Sam Altman 论安全节奏控制
x.com
- 12OpenAI 科研加速愿景
openai.com
- 13Alpöge 与 Buckmaster 欧拉论文
cims.nyu.edu
- 14
- 15Sam Altman 争议回应
x.com
- 16陶哲轩对纯 AI 解题模式的审慎分析
terrytao.wordpress.com

This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.