10月22日语音与音频雷达:探针 0.970 的那一层改不动说话人、12.5 Hz 下码本 dWER 0.62%、让现成多模态模型自己改混音反而更差:语音栏 18 篇里的 11 篇分层雷达
本期把该账号 10 月 22 日语音与音频栏 18 篇逐条筛完,收录 11 篇:能读到 0.970 说话人准确率的层沿等范数方向干预 60 组全落空、第 0 层 60 组全成,12.5 Hz 码本把 dWER 压到 0.62% 而保真仍输,让现成多模态模型自己改混音反而把误差推高。

本频道盯「arXiv 每日学术速递」的三个栏目:人工智能、自然语言处理、语音与音频学术速递。
本期处理该账号 2026 年 10 月 22 日 21:09(GMT+8)批次里的语音与音频栏:语音与音频学术速递[10.22],CS.SD 分类,共 18 篇。同批次的人工智能栏(63 篇)已在当天单独成篇,本期与它零重复。自然语言处理栏这一天没有发布。
公众号正文只展开每栏前 8 篇,完整名单在它自己的官网 arxivdaily.com 上。这一期的候选池按官网同日同栏目的完整条目重建:被标为「新提交」的 18 条,与公众号标题里的「共 18 篇」逐条吻合;同一页还有 3 条交叉投稿、3 条版本更新,不计入。
18 篇逐条读完后收录 11 篇,排除 7 篇。排除分四类:以硬件能效为主线的架构工作(脉冲神经网络语音识别)、音乐转录与音乐生成本身(钢琴起始点增强、钢琴音频到乐谱、昆曲唱词对齐)、含音乐场景的目标说话人提取(源分离),以及艺术创作报告与生物声学各一篇。
收录的 11 篇按与四条研究线的关系分层:直接命中 8 篇、邻近跟踪 3 篇。再按建议的阅读投入分档:精读 5 篇、值得扫读 5 篇、其余 1 篇为第三档,在全景表里记作优先级 3。
四条线按每篇的主要归属计:TTS 生成与评估(C 线)8 篇、轨迹学习与自进化(B 线)1 篇、大模型长程任务的训练与评估(A 线)1 篇、播客生成与节目级评估(D 线)1 篇。这一期是语音栏,权重自然压在 C 线上;A 线那篇讲的是工具增强推理的评测设计,B 线那篇是智能体用学习到的批评器反复改产物。
本期有五条判断值得先记住,理由与限定写在各自条目里。
探针读得出来,不等于改得动。 在 VoxCPM2 上,最终残差声学层的参考音频状态能把说话人分到 0.970 的探针准确率,但在 30 个说话人组成的 60 组方向上,沿这些方向挪动没有一组让目标说话人占优;同样的干预放到音频编码器的第 0 层,60 组全部改成了目标音色,目标相似度提升 0.326。
音色信息散在频带、谱包络与浅层表征里,只看一处会看错。 45 名听者的听测加上频带、WORLD 源滤波分解与自监督层探针一起显示:1–8 kHz 的幅度谱与声道包络主导听感,8 kHz 以上频带机器仍能分辨,浅层自监督表征里说话人信息最紧凑,分词器的泄漏量则取决于选哪个分词器和哪一层。
控制要落到具体位置,代价要用相似度算。 普通话字符级韵律控制把音高、时长、能量、停顿写成词表外的 Unicode 符号塞进文本流,只微调骨干、不改结构;跨语言克隆那边用一条可复用的母语锚点参考把法语口音残留压掉 73%,代价是 ECAPA 说话人相似度掉 0.042。
序列长度与延迟都能事先算出来,代价落在别处。 RubatoCodec 把事件预算写成每句话一条的硬约束,让生成器按事件逐个预测与解码:12.5 Hz 下可懂度从 dWER 0.72% 降到 0.62%,保真仍输给最强的外部码本。StyleStream 2.0 在 RTX 4060、300 ms chunk 的设置下把端到端延迟做到 520.7 ms,但情绪相似度 0.774 低于 StyleStream 1.0 的 0.808。
工具把答案递到手上之后,模型还要自己走几步。 推导深度实验把音乐信息固定在工具输出里、只改「从工具输出到答案要几步」:报告直接写明结论时五个模型都接近 100%,隔一步正确率就掉,开放模型在转调题上落到 57–81%,再深就到 0。
全景表
| 优先级 | 分层 | 标题与 arXiv | 一句话方法 | 关键数字 | 主要局限 | 来源 |
|---|---|---|---|---|---|---|
| 1 | 直接命中 | 把韵律写成词表外 Unicode 符号塞进文本流:字长 240→391 ms,音高偏移只从 +6 Hz 到 +11 Hz · arXiv:2610.29123 | 音高、时长、能量、停顿四类词表外 Unicode 符号直接写进文本流,只微调 CosyVoice2 的 LLM,不动结构 | 字长 240→391 ms(+62.9%);F0 偏移 +6→+11 Hz;四档停顿实测 354/525/824/1,109 ms;24 名听者,自然度 4.44 对 4.46 | 音高推动量没到训练标签自己的 ±100 Hz 门槛;只验普通话与单一骨干;主观部分无统计检验 | 公众号 · 官网 · 全文 |
| 1 | 直接命中 | 探针 0.970 的那一层改不动说话人:60 个有向 dyad 里 0 个换成目标,而第 0 层 60 个全成 · arXiv:2610.29345 | 在 VoxCPM2 上做等范数配对方向的激活干预,把「探针读得出」和「干预改得动」拆成两个指标分别测 | L7 探针 0.970 而目标增益 0.000、0/60;L0 增益 +0.326、60/60;双盲 1,500 次判定里 L0 胜 L7 76.0% | 60 个 dyad 的抽法未说明;L0 增益有 0.326 与 0.387 两套口径;没有微调上界作参照 | 公众号 · 官网 · 全文 |
| 2 | 直接命中 | 一条可复用的母语锚把法语口音残留概率压掉 73%,ECAPA 说话人相似度只掉 0.042 · arXiv:2610.29351 | 原始参考管音色、语种锚管发音,两套参考各预填一套 LM 状态,每个 patch 解完把音频回灌给两边 | P(fr) 0.093→0.025(−73%);ECAPA 0.601→0.559(−0.042);WER 0.009;对级联 WER −81% | 盲测 60 个 session 里 39 个判平,κ 仅 0.167–0.256;三个说话人编码器结论不一致;LID 聚合单位未报 | 公众号 · 官网 · 全文 |
| 2 | 直接命中 | 1–4 kHz 让机器认出说话人 92.1%,只听这一段的听者只给 2.92 分 · arXiv:2610.29150 | 频带滤波、幅度/相位替换、WORLD 源滤波分解、自监督逐层探针与令牌泄漏分析,配 45 人听测 | VCTK 1–4 kHz 92.1%;低通 EER 到 8 kHz 压平(0.225→0.11);同人 4.44 对异人 2.29,1–4 kHz 单带仅 2.92 | 每个听测条件只有 45 个评分、未按听者聚类;缺同带异人对照;闭集规模小(AISHELL-1 仅 20 人) | 公众号 · 官网 · 全文 |
| 1 | 直接命中 | 用「每句事件预算」把序列长度钉死:12.5 Hz 下 dWER 0.62%,保真仍输给最强基线 · arXiv:2610.29434 | 先按 K=round(R·T) 定事件数、再用累积放电定切点,每个事件带显式时长,解码端逐事件流式出音频 | 12.5 Hz 深度 16:dWER 0.72%→0.62%、PESQ 2.442→2.556;1.23 kbit/s 档 dWER 0.75% 最好,PESQ 2.684 低于 3.052 | 单种子、无置信区间;训练量混杂(10 万步对 100 万步);GT 行 PESQ 4.644 超标准上限 | 公众号 · 官网 · 全文 |
| 2 | 直接命中 | 端到端 520.7 ms 的流式音色风格转换:把风格收进一个 768 维嵌入,再用文本改它 · arXiv:2610.28940 | 少步 MeanFlow 加 Self Forcing 式自回归微调压延迟,砍掉 mel 上下文、风格只走一条 768 维嵌入以支持文本控制 | RTX 4060 上 300+80+140.7=520.7 ms;同 600 ms chunk 单 chunk 快 3.8×;S-SIM 0.879 | 「2×」混用了两种 chunk 大小;分类器判分的随机基线未报;编辑任务 E-acc 14.67% 与主观 3.76 打架 | 公众号 · 官网 · 全文 |
| 1 | 直接命中 | 把工具结论挪开一步,三个开放模型从接近 100% 掉到 57–81%:推理深度阶梯测「用不用得上」 · arXiv:2610.29060 | 固定音乐信息、只改「工具输出到答案要走几步」,六种报告格式加翻转对照,五个模型各跑有/无音频两条件 | 报告直接给结论时五个模型接近 100% 且跟着错结论走;隔一步转调题开放模型 57–81%,更深为 0%;带音频不恢复 | 任务集 143 对上限是各任务上限相加的推算;「一步最多损失 43 分」漏算带音频那半;伦理声明的人评基线全文无数字 | 公众号 · 官网 · 全文 |
| 1 | 直接命中 | 把「改混音」训成可执行批评器:MedleyDB 重建误差 2.17→1.75,现成多模态模型自己听了改反而更差 · arXiv:2610.29093 | 分组/规划/检测/批评四段 agent 流水线;用「这次修正让渲染结果离拟合目标近了多少」造批评数据,SFT 加 DPO 训批评器 | MRS 2.17→1.75(−19.35%);DPO 再降 8.38%;Self-Refine 让 MSS 从 3.73 升到 4.57(越改越差) | 45,657 是三种反馈形式合计,独立修正点为 15,219;评测集小(20 个片段);听测仅 11 人 10 个片段 | 公众号 · 官网 · 全文 |
| 2 | 邻近跟踪 | 冻结音频语言模型能验证不能定位:变更查询随上文从 0.102 升到 0.312,整轨提问最高只有 0.072 · arXiv:2610.29256 | 配对查询把「状态」与「变更」挂到同一段音频,再用整轨提问、窗口是-否打分、注意力三种方式取出时间跨度 | 变更查询 Qwen3-Omni 0.102→0.312;整轨提问最高 0.072(基线 0.100);30 s 补零编码器反而从 0.230 掉到 0.142 | MIDI 渲染的合成音频,只涉及乐器进出;编码器与效果的结论只建立相关;总分普遍偏低 | 公众号 · 官网 · 全文 |
| 2 | 邻近跟踪 | 用模板模拟出 197,280 对音频-文本差异:差异类型分类从 58.5% 升到 91.9%,但只训字幕会掉到 20.2% · arXiv:2610.29836 | 把音频-文本对齐从给一个分数改成生成差异描述,差异由「音频结构 × 差异类型」模板注入,微调 Qwen3-Omni-30B | 差异检测 80.9%→94.8%;类型分类 58.5%→91.9%;CIDEr-D 1.021→6.882;只训字幕时类型掉到 20.2% | 参考句由模板生成,绝对值不可跨任务比;只覆盖两类事件、五类差异;只微调一个模型 | 公众号 · 官网 · 全文 |
| 3 | 邻近跟踪 | Qwen-Audio-3.1-ASR:四套说话人分离测试集 cpWER 最低 12.04%,参数量与语言清单未公布 · arXiv:2610.28711 | 音频编码器加适配器接 MoE 解码器,另设辅助 CTC 分支供给热词与长上下文初稿;分离转写输出带说话人标签与时间戳 | AliMeeting-test cpWER 12.04%(Next);DER 1.80–3.26;MMAU 81.60%;AISHELL-1 CER 1.08% 高于上一代 1.03% | 参数量、数据配比、重复次数均未报告;30 种语言无清单;ASR 表跨 Panel A/B 比名次会不同 | 公众号 · 官网 · 全文 |
一、TTS 可控性:控制量落在哪一层
这四篇都在问同一件事:控制量怎么落到具体位置上。位置各不相同——一个汉字、一条说话人方向、一套发音习惯、一段频带。
两条方向相反的收数值得并排。字符级韵律控制确实推动目标字,字长从 240 ms 拉到 391 ms,但音高偏移只从 +6 Hz 到 +11 Hz,还没到训练标签自己的 ±100 Hz 门槛。说话人控制那篇更极端:探针在最终残差声学层能读到 0.970 的说话人准确率,沿同一层做等范数干预却 60 组方向全部落空;把同样的干预放到第 0 层,60 组全成。
「像不像」这件事在两个测量体系里给的答案也不一样。音色定位那篇里,1–4 kHz 频带让机器闭集分类到 92.1%,只听这一段的听者给 2.92 分,低于 4 kHz 以下低通条件的 3.81。跨语言口音那篇的盲测里,60 个 session 有 39 个判平。
1. 把韵律写成词表外 Unicode 符号塞进文本流:字长 240→391 ms,音高偏移只从 +6 Hz 到 +11 Hz
Character-Level Prosody Control for Mandarin Speech Synthesis: An Architecture-Preserving Approach · arXiv:2610.29123 · 精读
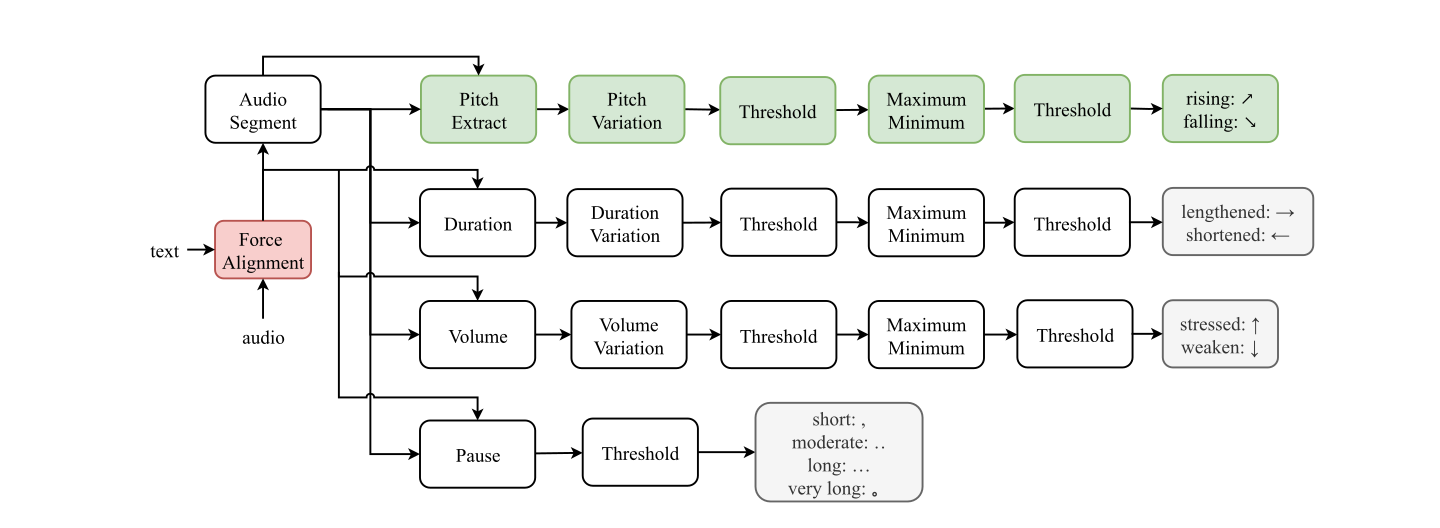
研究问题与核心方法:现有的 LLM-TTS 风格控制停在整句层面。说一句「说得悲伤」可以,指定第三个字升高、第四个字后面停久一点做不到。影视配音和有声书恰好需要后者。1
他们的解法不动模型结构,只动输入分布。每个汉字旁边插入一个词汇表外的 Unicode 符号,四类:音高升/降(U+2197 / U+2198)、能量强/弱、时长长/短、停顿四级。符号写在字的左边(音高、能量)或右边(时长、停顿)。1
标记不靠人标出来。MFA 和 WhisperX 两套强制对齐先各跑一遍,两套边界差超过 150 ms 的样本直接丢弃,留下的按置信度加权融合。
然后在短语内部算每个字的 F0(基频)、时长、能量,超过阈值才打标。
阈值全部来自语料分布:字长超过 430 ms(第 95 百分位)标「长」,落在 30–50 ms(最低的 5% 带)标「短」。音高另有一套门槛:F0 偏离短语均值超过 ±100 Hz 才算「升/降」,且要求字内 F0 波动小于 35 Hz、字长超过 150 ms,这样标签反映的是整字高低,不是字内滑动。1
训练只在 CosyVoice2 上做微调:tokenizer、LLM、decoder 全部保留,学习率 1e-5,8 张 B200 跑 20 个 epoch,取验证损失最低的三个 checkpoint 做权重平均。语料 215 万条普通话(5,858 小时),平均每条 9.8 秒。1
另有一个可选前端:Qwen3-8B 用 LoRA 把自然语言指令翻成标记串,训练集约 21 万条三元组,来自电视剧 60.75%、讲座 34.97%、直播 4.29%。这部分只评到文本层,没有端到端合成。1
关键结果:
- 字长:目标字从 240 ms 拉到 391 ms,相对基线 +62.9%(绝对 +151 ms);缩短从 144 ms 压到 119 ms,−17.4%(−25 ms)。12 个说话人 × 11 句条件的均值。1
- 音高:升标记把「相对短语均值的偏移」从 +6 Hz 推到 +11 Hz,相对 +83.3%、绝对 +5 Hz;降标记从 −8 Hz 到 −12 Hz,幅度 +50.0%。1
- 停顿:四档各合成 2,000 条,实测均值 354 / 525 / 824 / 1,109 ms,分别落在训练时用的目标区间 [300,500) / [500,800) / [800,1000) / [1000,1500) 内。1
- 主观:24 名自报母语听者,每人评 24 条刺激(每系统 12 条)。自然度 4.44 对基线 4.46,真实感 4.15 对 4.10,说话人相似度 4.00 对 3.95,5 分制,作者明确不做显著性检验。1
- Tokenizer 敏感性:1,000 条音频做响度、音高、加噪扰动,看 token 序列的 NED(归一化编辑距离,逐条按参考长度归一的 Levenshtein 距离)。CosyVoice2 最低(强扰动的响度 / 音高 / 噪声依次 0.27 / 0.43 / 0.46),TaDiCodec 接近 1.0(1.00 / 1.00 / 0.99)。1
证据与局限:作者自己写了三条:只验普通话和单一骨干 CosyVoice2,字符级对齐没法直接搬到非声调语言;阈值是语料导出的固定常数,没跟人工标注比过;主观研究是 24 人的描述性比较,无推断统计,控制实验也只报条件均值。前端只评到文本层,端到端指令转语音留作后续。1
核下来最要紧的问题在幅度上。训练时「升/降」的判定门槛是偏离短语均值 ±100 Hz,「长音」的门槛是超过 430 ms,而实测只把偏移从 +6 Hz 推到 +11 Hz、把字长从 240 ms 推到 391 ms——标记确实推动了目标字,推动量却仍不到训练标签自己的门槛。表 3 只写「12 说话人 × 11 句」也就是 132 个上限,但 11 句按设计只是「覆盖所有标记类型」,每个条件实际有多少个目标字符没报。前端那段把 7.91 降到 4.61 的指标叫「按参考长度归一化的编辑距离」,归一化后本应落在 0–1 量级,这两个数与定义对不上,更像未归一的字符数或百分数。1
与目标研究线的连接点:落在 C 线。可搬的第一件是控制通道的形状:把控制量做成词汇表外符号直接拼进文本,不动 tokenizer、LLM、decoder,代价只是一次 SFT,任何自回归 TTS 都能照抄。第二件是评测口径:用训练时同一套提取器分别测基线和条件模型上的同一个字,只比增量,提取器的系统误差在两边抵消——这比追求绝对目标值更适合做消融。第三件是 codec 预筛:同一条音频加扰动后看 token 序列的 NED,能在训练前判断这个 tokenizer 还留不留得住韵律信息。
结论建议:读 §3.1 的四组阈值(430 ms、30–50 ms、±100 Hz、35 Hz)和 §4.2 的表 3、表 4。引用「+62.9%」时必须说明它是对基线的相对增量(240→391 ms)、条件是 12 说话人 × 11 句、单一 CosyVoice2,不能当成「模型能把字拉长到 391 ms」这类绝对能力。语速那组结果先回原文核纵轴:图 3 的轴标的是「每分钟词数」,图注和正文写的是「平均字时长」,两处口径不一致。
2. 探针 0.970 的那一层改不动说话人:60 个有向 dyad 里 0 个换成目标,而第 0 层 60 个全成
Decodability Is Not Controllability: Local and Anisotropic Speaker Control in Continuous-Latent TTS · arXiv:2610.29345 · 精读
研究问题与核心方法:在连续 latent 的 TTS 里做免训练说话人控制,常见做法是先训一个线性探针,看说话人信息在哪一层最清楚,然后就在那里改激活。这篇要证伪的正是这个推论:能读出来,不等于改得动。2
模型是 VoxCPM2。参考音频经 AudioVAE 打成 patch,过局部音频编码器,与文本嵌入交错后进 TSLM 和 8 层 RALM(residual acoustic language model,残差声学语言模型),再由 flow-matching 的 LocDiT 和 AudioVAE 解码成波形。干预发生在 RALM 的 prefill 第 0 步之后,保留该层已算好的 KV cache。2
干预量是配对方向 d = h_B − h_A:同一句话下,目标说话人 B 的隐状态减去源说话人 A 的。为排除「只是把激活搞乱」,所有条件共用一个 Frobenius 范数 r(取自参考音频对齐方向的范数),只换方向和位置:对齐、正交、随机、非音频位置、末位。2
评测分三层。探针准确率量「可解码」;源相似度变化和 WER(词错误率,用 Whisper 转写后算)量「有没有杠杆」;目标增益 ΔSIM_B 和「目标主导」量「有没有特异性」。目标主导要求 ΔSIM_B > 0 且 SIM(y,B) > SIM(y,A),两个条件同时成立才算一个 dyad 成功。2
规模:30 个 LibriTTS-R 英语说话人组成 60 个角色平衡的有向 dyad,每个 dyad 跑 2 条 prompt × 3 个种子,即每条件 60 × 2 × 3 = 360 条生成。探针用另一批 300 条同池语音,5 折交叉验证按转写分组,1,000 次全标签置换,24 条件 max-statistic 族错误率校正(6 层 × 4 种读出位置正好 24)。2
关键结果:
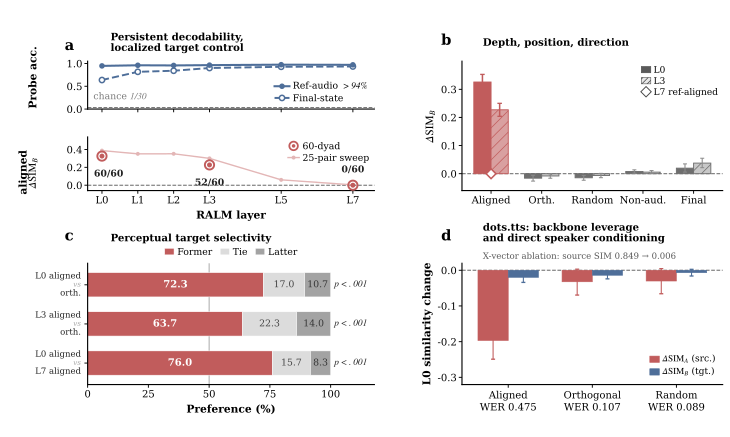
- 可解码与可控在层深上分道:L0 参考音频位置对齐编辑得到 ΔSIM_B = +0.326 [0.298, 0.353]、60/60 目标主导;L3 +0.227、52/60;L7 探针 0.970 却只有 0.000 [−0.002, 0.001]、0/60。2
- L0 的对齐方向比四个等范数对照都高:比正交 +0.342、比随机 +0.340、比非音频位置 +0.318、比末位 +0.306,四个 95% CI 都排除 0。2
- 正交方向不是没作用:L0 把源相似度压低 0.195,同时目标相似度也降 0.016——有杠杆、没方向。末位干预的杠杆落在可懂度上,L0 / L3 / L7 分别把 WER 抬高 0.113 [0.058, 0.179]、0.127 [0.043, 0.251]、0.096 [0.053, 0.147]。2
- 换编码器、换参考都还成立:CAM++ 下 L0 / L3 / L7 增益 +0.237 / +0.190 / +0.001,目标主导 55/60、43/60、0/60;对 30 个互不重叠的五句说话人原型做 top-1 检索,L0 上 ECAPA 与 CAM++ 都是 46/60(随机 1/30)。2
- 双盲听测 5 个对比 × 60 dyad × 每 dyad 5 次判定 = 1,500 次(每个对比 300 次,平局留在分母)。L0 对齐胜同层正交 72.3% [67.2, 77.1],L3 胜 63.7%,L0 胜 L7 76.0%;CMOS 自然度 L0 −0.12 [−0.21, −0.03]。另在 dots.tts 上做交叉验证:x-vector 消融把源相似度从 0.849 压到 0.006,而骨干 L0 对齐虽把 WER 推到 0.475(正交 0.107、随机 0.089),目标增益全非正、0/60。2
证据与局限:原文没有独立的局限章节,讨论部分只把结论收成两条设计原则(几何特异性 + 一条能把说话人条件送进声学合成的计算通路),没有讨论这套干预对音色之外属性的代价,主观部分也只有一项 CMOS。2
有三个点需要压住。第一,60 个有向 dyad 是从 30 个说话人的 870 个有序对里抽出来的,「角色平衡」的抽法原文没写,而「60/60」这种满分结论对抽样最敏感——虽然用了 dyad bootstrap 和双向 cluster-robust 区间。第二,同一个量有两套口径:表 1 的 L0 增益是 60 dyad 上的 +0.326,§3.2 的范数扫描在 25 dyad 上是 +0.387,正文没说这是不同子集,只有看图 1(a) 才能发现 L0 有两个点。第三,摘要写 L0 的 60/60 对「任何等范数方向或位置对照最多 1/60」,但表 1 里 L7 的末位条件(一个位置对照)拿到 7/60,这句话只在 L0 的对照集合内成立。此外 VoxCPM2 与 dots.tts 两侧都是免训练干预,没有微调上界作参照。2
与目标研究线的连接点:落在 C 线。可搬的机制有三件。一是「等范数方向 × 位置」的因子设计,把「真的改到了属性」和「只是扰动」分开——任何声称能改某一属性的激活干预都该跑这一组。二是「目标主导」这个判据,要求同时接近 B 且比 A 更像 B,单看目标相似度上升会把「把所有说话人推成同一个人」误判成成功。三是「读出可达性」这个概念:干预点必须在下游还有注意力能读到它,末位状态虽然直接进声学头,改掉的却是可懂度而不是音色。
结论建议:读 §2.2 的公式 (1)(2)(等范数怎么归一、掩码怎么取)、表 1 与表 2(两套编码器 + 检索)、表 4(听测分母含平局)。引数字必须同时带层号、评估器(ECAPA-TDNN 还是 CAM++)和「60 个有向 dyad、2 prompt × 3 种子」这三个条件;+0.326 与 +0.387 是两个 dyad 子集上的数,不要混用。
3. 一条可复用的母语锚把法语口音残留概率压掉 73%,ECAPA 说话人相似度只掉 0.042
Closed-Loop Dual-Reference Guidance for Accent Control in Cross-Lingual Voice Cloning · arXiv:2610.29351 · 值得扫读
研究问题与核心方法:跨语种零样本克隆里,参考音频同时带来音色和发音习惯。用法语参考去说英语,出来的是带法语腔的英语;把腔调压下去,说话人往往一起丢掉。3
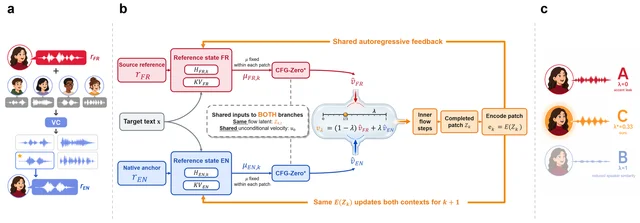
作者准备两个参考。原始法语参考 r_FR 负责音色,另造一个英语锚 r_EN 负责发音。锚在注册阶段用 Seed-VC 把 LibriTTS-R 的英语捐赠者转成参考说话人的音色,四条候选里按 SIM_avg(ECAPA 与 CAM++-CN 余弦的均值)留最高的一条,之后所有句子复用这次转换的结果。3
两套参考各自预填一套 LM 状态(base 与 residual LM 的 KV 缓存),各自给扩散 Transformer 一个条件 μ_FR、μ_EN。两个条件场在同一个 flow latent 上先过 CFG-Zero*,再按 v_λ=(1−λ)·v̂_FR+λ·v̂_EN 混合。λ=0 就是直接克隆,λ=1 就是只用锚,中间值是两者的插值。3
所谓闭环押在状态推进上:每个 patch 解完后,把生成的音频编码 E(Z_k) 回灌给两套 LM 状态。两条分支因此跟着同一条已经生成的语音走,同时各自保留自己的参考前缀,不会像独立滚动那样越走越偏。3
实验用冻结的 VoxCPM2(2B、48 kHz、无 LoRA)。开发集是 30 名 VoxPopuli 法语说话人 × 10 条英语文本(n=300/arm,单种子 20260822);测试集是 20 名 MLS 法语说话人 × 20 条文本 × 3 seeds(n=1200/arm),λ 在开发集扫过 0.1 到 0.75 后固定为 0.33。口音残留用 faster-whisper-large-v3 的语言辨识(LID)边际概率 P(fr) 度量,GOP(音素后验优度,此处取正确音素与最强竞争音素的对数概率差)用 wav2vec2-xls-r-300m-phoneme 的后验算,音色相似度同时报 ECAPA-TDNN、CAM++-EN、CAM++-CN 三个编码器。3
关键结果:
- 口音残留:留出测试集 20 名法语说话人、n=1200 下,P(fr) 从直接克隆的 0.093 降到 0.025,相对降 73%,绝对降 6.8 个百分点(Δ=−0.068,95% CI [−0.119,−0.027])。3
- 音色代价:同一组的 ECAPA 相似度 0.601→0.559,掉 0.042(CI [−0.048,−0.036]);相对只用锚的 arm B(0.404)回收 0.155(CI [0.137,0.173])。3
- 转写质量:WER(词错误率)0.009、GOP 4.750,在直接克隆(λ=0)、只用锚(λ=1)、本方法(λ=0.33)与 TTS→VC 级联四个 arm 里分别最低和最高;但 C 与 A 的配对 WER 差是 −0.0072、CI [−0.0147,0.0003] 跨 0,「最低 WER」只是点估计,不是显著差异。3
- 对 TTS→VC 级联:WER 从 0.047 降到 0.009(约 −81%,Δ=−0.038),GOP 4.378→4.750(+0.372),ECAPA +0.091;级联有 38/1200(3.2%)的输出出现两词以上的重复或插入,A、B、C 都低于 0.5%。3
- 跨语种与主观:西班牙语→英语不重调 λ,P(es) 0.032→0.014(−56%);7 名英语母语评测者、60 个 session 的盲测里,C 对 A 的发音自然度是 17:4 胜(39 个 session 判平,p=0.0057),对级联反而 13:32 输(p=0.026)。3
证据与局限:原文自陈三条:只评了英语一个目标语;锚的质量取决于零样本转换器;引导权重在整句所有 patch 上固定,不随片段自适应。作者把它们列为下一步。3
读出来的问题更具体。主观测试只有 7 名评测者、60 个 session,Fleiss κ 只有 0.167–0.256,属于轻微到中等一致;C 对 A 的「显著更自然」建立在 17:4 上,65% 的 session 判平,而且评测轴写的是「Accent / nat.」——口音和自然度合成一栏,没有分开问,因此无法回答「腔调是被纠正了还是被模糊了」。三个说话人编码器给出的结论也互相矛盾:C 相对级联在 ECAPA 上 +0.091、CAM++-EN 上 +0.094,在 CAM++-CN 上却是 −0.022,换一个编码器就换一个「音色掉没掉」的答案。LID 的聚合单位没交代:原文只说用 faster-whisper 的全 softmax 边际 P(fr),是按帧平均、按 token 平均还是按整句求和,没写。λ*=0.33 是在 30 人、n=300、单个种子的开发集上选的,测试集只有 20 人;西班牙语的 56% 与法语的 73% 不能直接比,因为基准 P(es) 本身只有 0.032。3
与目标研究线的连接点:落在 C 线。可搬走的是这个结构:一次离线转换造出承载「目标属性」的锚,推理时用双条件分支加输出回灌,把两条分支钉在同一条生成历史上。它不改权重、不重训模型,只改推理时的状态推进方式,因此能套到任何带 KV 缓存的因果 TTS 上做属性控制;代价是每个 patch 多一次条件分支评估,从 18 次涨到 27 次。
结论建议:先读 §3.2 的式 (1)(2),再看 §5.2–5.3 的 Table 1 与级联对比。引用 73% 必须带齐「20 名 MLS 法语说话人 × 20 文本 × 3 seeds、λ*=0.33 在开发集固定、faster-whisper 边际 P(fr)」;引用 RTF 0.59 对 0.80 时要说清是 H100 80 GB、9 词文本、热身之后计时 5 次,且锚的 3.1 s 转换成本要到第 6 句之后才摊平。
4. 1–4 kHz 让机器认出说话人 92.1%,只听这一段的听者只给 2.92 分
Where Does Timbre Hide? Localizing Speaker Information in Speech Signals · arXiv:2610.29150 · 值得扫读
研究问题与核心方法:音色相似度已经是生成语音的核心评测项,但「音色到底存在哪」没有可操作的答案。作者把说话人身份当作可测代理,并坚持把机器可判别性和人耳的相似度判断分开报,不让一个分数代言两件事。4
信号侧做四类手术:Butterworth 低通与高通滤波后提 WavLM-base-sv 嵌入,看同人与异人可分性、EER(等错误率)怎么随带宽变;STFT 后保留幅度随机化相位,或保留相位随机化幅度;用 WORLD 分解出 F0、谱包络、非周期,做跨说话人替换;再切出浊音段与清音段分别评测。4
8 kHz 以上 WavLM 用不了,因为它只吃 16 kHz 输入。作者另起一套:保持原采样率,切固定频带,提 log-mel 统计量,训两层闭集 MLP 说话人分类器,并配打乱标签与时长/能量基线,防止分类器靠句长和响度蒙对。4
表示侧逐层探:WavLM、HuBERT、Wav2Vec2、Whisper 的每层特征先均值池化再训分类器,加 PCA 看信息是否压缩在低维子空间;离散侧用 EnCodec 各 RVQ 层与累积层、HuBERT k-means 各层各码本大小的直方图做分类。4
感知侧用 45 名听者对 AISHELL-3 构造的配对打 1–5 分,条件覆盖同人与异人的全带、低通、带通、高通。数据跨六套语料:AISHELL-1(20 人)、AISHELL-3(98 人)、VCTK(100 人)、ESD/CREMA-D(20/91 人)、NUS/JVS(12/100 人),加一套 4 人自录语料做受控替换。4
关键结果:
- 频带(闭集 MLP 准确率):VCTK 1–4 kHz 92.1%、4–8 kHz 89.3%、20–24 kHz 50.1%;AISHELL-3 对应为 82.5%、72.4%、42.8%;打乱标签 0.8–1.5%,时长/能量基线 4.5–6.4%,因此 8 kHz 以上的 42.8–50.1% 确实高于瞎猜。4
- 低通 EER 到 8 kHz 基本压平:AISHELL-1 从 0.5 kHz 的 0.33 降到 8 kHz 的 0.11,VCTK 从 0.225 降到 0.11,再往上加带宽几乎不动。4
- 幅度与包络:保幅度、随机相位仍保留 81.6%(WavLM)与 77.1%(ECAPA)的可分性;保相位、随机幅度掉到 −0.199 与 0.003。WORLD 保谱包络保留 92.4%(WavLM)与 79.3%(ECAPA)的同人相似度,只保 F0 是 82.0% 与 26.2%。4
- 听测:同人全带 4.44 对异人全带 2.29(p=3.6×10⁻²¹);<8 kHz 的 4.45 对 >8 kHz 的 1.24(p=1.3×10⁻³⁹);但 1–4 kHz 单带只有 2.92,12–20 kHz 只有 1.07,后者比异人全带的 2.29 还低。4
- 表示与令牌:AISHELL-1 上 WavLM 峰值在 L1(99.8%),末层 L12 为 94.8%;AISHELL-3 上 L0–L4 有 96.5–97.7%,L9–L12 掉到 75.7–76.5%;PCA 压到 32 维时 L0 仍 95.8%、L12 只剩 62.7%。HuBERT 令牌在 k=1000 时 L6 达 96.2%,k=50 时 L9 只有 37.7%,泄漏量既看层也看码本大小。4
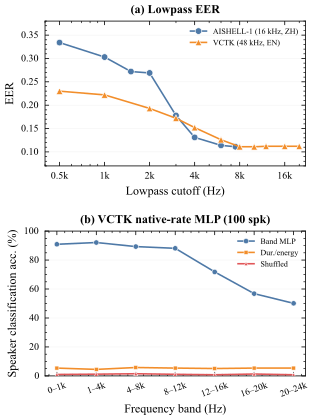
证据与局限:原文自陈:多数探针是闭集,分类准确率不等于开集说话人确认性能;WavLM-base-sv 的 16 kHz 限制让 8 kHz 以上的 SV 分析缺一条腿;高频听测刺激本身是窄带、不自然;情绪、歌唱与令牌的结论还缺更多后端、听者元数据和受控回放条件。4
读出来的问题有五处。第一,「1–8 kHz 主导感知」在听测里没有对应的 4–8 kHz 单带条件,只有 <4、1–4、<8、>8、12–20 五档;而机器最强的 1–4 kHz 单带拿到 92.1%,人耳那里只有 2.92 分,低于 <4 kHz 的 3.81,这两个数字原文都在,但没有放在一起解释。第二,每个频带条件都没有同带的异人对照,唯一的异人参照是全带 2.29,于是「Same >8 kHz = 1.24」比异人全带还低,作者归因于窄带不自然,可这个解释和「听者判成不是一个人」在数据上分不开。第三,45 名听者的数字与工作量对不上:Table III 报的均值是 4.44、标准差 0.36,标准差除以 √45 再乘 1.96 得 ±0.105,正好对上表里的 [4.34,4.55],说明每个条件只有 45 个评分,即每人每条件只判一对;p 值按 45 个独立观测算,没有按听者聚类。第四,闭集规模太小:AISHELL-1 只有 20 人(随机 5%),WavLM 的峰值 99.8%(L1)与 L0 的 95.8% 已经贴顶,区分不了「信息集中」和「任务太容易」。第五,跨数据集比 EER 有混淆:20 人的 AISHELL-1 与 100 人的 VCTK 画在同一张图上,0.5 kHz 处 0.33 对 0.225 的差里有多少来自人数,原文没讨论。4
与目标研究线的连接点:落在 C 线。可搬走的是评测切分方式:把「机器可判别」和「人耳相似度」拆成两个指标同时报,并给每个信号处理探针配一条打乱标签与时长/能量的对照线,这条对照能直接挡掉「分类器只是记住了句长」的假结论。另一件可搬的是「保幅度对保相位」「保包络对保 F0」这类替换实验,用来判断某个模块传的是音色还是韵律。
结论建议:先看 §III-A 的 Table II 与 Fig. 2,再看 §III-B、§III-C 的 Table IV。引用「1–4 kHz 92.1%」时要带 VCTK 100 人闭集、2 层 MLP、log-mel 统计量这三个条件;引用「45 名听者」时要说明是 AISHELL-3 构造的配对、每人每条件只判一对、没有同带异人对照,因此那组 p 值只说明排序,不说明效应量的大小。
二、分词与流式:延迟预算怎么花
一篇决定「这段语音用几个 token 表示」,一篇决定「多快能出第一段音频」。两者都是预算问题,花法不同。
RubatoCodec 把预算写成硬约束:每句话的事件数先按 K=round(R·T) 定死,内容只决定切点落在哪,于是下游生成器可以用时长直接推出序列长度。StyleStream 2.0 把延迟拆成 chunk、lookahead、单 chunk 处理三项分别报,端到端 520.7 ms。
两篇的增益都带着代价。RubatoCodec 在可懂度上赢(dWER 0.75% 是该比特率档最好),保真上输(PESQ 2.684 对 3.052);StyleStream 2.0 的说话人相似度 0.879 高于 StyleStream 1.0 的 0.869,情绪相似度 0.774 却低于 StyleStream 1.0 的 0.808,编辑任务的情绪准确率只有 14.67%。
5. 用「每句事件预算」把序列长度钉死:12.5 Hz 下 dWER 0.62%,保真仍输给最强基线
RubatoCodec: Budgeted Adaptive Speech Tokenization with Streaming Decoding · arXiv:2610.29434 · 精读
研究问题与核心方法:变帧率码本按内容分配 token,序列长度跟着内容浮动,下游生成器要生成多长事先算不出来。作者给出一个反例数字:一个公开的阈值型码本在同一阈值下,跨五个评测集跑出 46.1 到 81.5 events/s(表 15),拿音频时长完全推不出 token 数。5
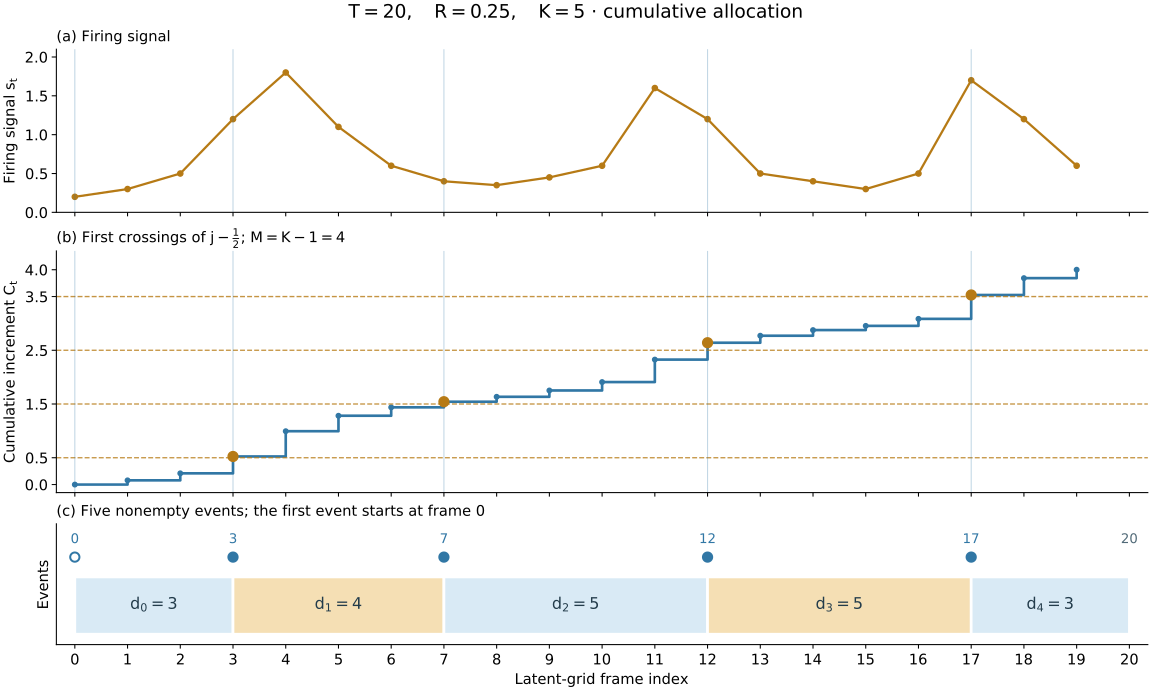
他们的做法是把「几个」和「切在哪」拆开。在 T 个 50 Hz 隐帧(每帧 20 ms)上先定事件数 K = round(R·T),默认保留比 R=0.25,也就是平均 12.5 events/s;再用放电信号 s_t = 隐特征多尺度不相似度(均值归一化)+ 波形 log-mel 谱通量,把有界增量 δ_t = min(α·s_t, 1) 累积到 M = K−1 个阈值 j−½ 上,α 用二分求出,最后做一次单调位置校正保证 K 个非空事件。边界是确定性统计量算出来的,没有学出来的边界预测器。5
一个事件包含 d_i 个 20 ms 帧、D 个 12 bit 码(D 为活跃量化层数)和一个显式时长。事件内部用起始帧特征加一个 MLP 修正(输入含事件内帧均值与时长嵌入)合成量化输入,解码时把事件向量稀疏铺回 50 Hz 网格、中间填可学的空位向量,12 层因果 Transformer 加三倍上采样到 150 Hz,再过 Vocos 式谱头与 hop=294 的 ISTFT 出 44.1 kHz。事件一凑齐就能出 d_i/50 秒音频。5
预算的作用域是「每句话」:K 只由这句话的 T 和 R 决定,偏移不超过 25/T events/s,所以时长决定序列长度、内容只决定边界落点。比特率按 B = 12·D·K/τ 算(τ 为时长),12.5 events/s 下 D=1/4/8/16 分别对应 0.15/0.60/1.20/2.40 kbit/s,另加约 0.028 kbit/s 的时长熵。5
评测覆盖英、日、中三种语言的 5 个数据集,共 10,563 句(LibriSpeech test-clean 2,620、VCTK 1,308、JVS 3,000、JVNV 1,615、seed-tts-eval test-zh 2,020)。受控对比用 HiFiTTS-2 英语 44 kHz 的约 5,000 小时子集,6.25/12.5/25 Hz 各自单独训练 10 万步;多语种模型 37.5 万小时、150 万步。对手共 13 个:EnCodec、DAC、BigCodec、WavTokenizer、X-Codec-2(本作的骨干)、Mimi、MiMo-Audio-Tokenizer、MOSS-Audio-Tokenizer、Qwen3-TTS-Tokenizer-12Hz、DTM-Codec、CodecSlime、FlexiCodec、DyCAST;TFC 无公开权重、VARSTok 比特率太低,两者未参赛。5
关键结果:
- 12.5 Hz、深度 16(自适应 2.43 kbit/s 对定帧率 2.40 kbit/s,LibriSpeech test-clean):PESQ-WB(宽带感知语音质量评分,1–4.5)2.442→2.556,dWER(与原始波形 ASR 转写的词错率之差)0.72%→0.62%,即 0.10 个百分点、相对 13.9%;UTMOSv2(无参考预测自然度)3.363→3.444,SIM(WavLM-Large 说话人嵌入余弦)0.810→0.807。5
- 事件率一升高,优势就没了:25 Hz 下自适应 dWER 反而是 0.53% 对 0.52%(深度 8)、0.47% 对 0.45%(深度 16),SIM 在深度 8 也更低;6.25 Hz 深度 16 则是 PESQ 1.812→1.932、dWER 1.24%→1.08%。增益集中在低事件率。5
- 只换边界位置(表 8,两模型共享 50 Hz 网格、聚合器、量化器与因果解码器,同训练 100 万步):自适应 dWER 在深度 8 反而更差(0.76% 对 0.70%),深度 16 更好(0.44% 对 0.52%),单码本 17.00%→11.64%;SIM 每个深度都更高。作者自己承认,定距对照仍是强对照。5
- 与外部码本比是「可懂度赢、保真输」:LibriSpeech 1.23 kbit/s 档 dWER 0.75% 为该档最好(次优 FlexiCodec τ=1 为 0.83%),PESQ 2.684 却低于 MOSS-Audio-Tokenizer 的 3.052 与 DTM-Codec 的 2.971;2.43 kbit/s 档 dWER 0.50% 优于 Qwen3-TTS-Tokenizer 的 0.53%,PESQ 3.029 低于其 3.177。JVS 上 dCER(字错率之差)1.07%/0.77% 两档都最好;中文 seed-tts-eval 上 0.91%/0.50% 落后 MOSS 的 0.56%/0.38%。5
- 落到生成端:1,088 句 zero-shot 克隆(seed-tts-eval 英文,8 层码本、Qwen3-0.6B 时间骨干),WER 3.20%→3.10%、UTMOS 4.080→4.162、UTMOSv2 3.239→3.295,SIM 0.392 两边相同;生成的事件率均值 12.461(5–95 百分位 12.329–12.609),88.3% 的句子事件数与 round(0.25T) 完全相同、99.9% 差不超过一个,而生成时并未加任何速率约束。5
证据与局限:原文第 7.5 节自陈:架构对比每个配置只训一个模型、一个种子;只换边界的对比只用了英文朗读语音,跨语种与录音条件的稳健性未测;所有评测语言都在训练混合里(英 44%、日 27%、中 13%),多语种结果不能当未见语种的迁移证据;TTS 只覆盖一个英文有声书语料和受控对比里的码本,且没有把「自适应放置」对 TTS 的贡献单独拆开。第 7.4 节还主动点出:LibriSpeech 上 UTMOSv2 给重建音频的打分高于原始录音,所以预测质量分数不能当保真度用。5
读表时能挑出几处口径问题。其一,所有主表的 GT 行 PESQ-WB 都写 4.644,超出 PESQ MOS-LQO 通常的 4.5 上限,说明他们的 PESQ 计算或映射不是标准配置,跨论文比 PESQ 绝对值要打折扣。其二,表 6 与表 10 是同一配置(12.5 Hz、深度 8)却给出两套数:dWER 0.80% 对 0.75%、SIM 0.757 对 0.871,原因是一个用 5,000 小时受控模型、一个用 37.5 万小时多语种模型,两处不能混引。其三,表 6 的对照只训 10 万步,表 8 的定距对照训 100 万步,表 8 里定距模型 dWER 0.70% 已经低于表 6 里自适应模型的 0.80%——训练量带来的差比「自适应放置」带来的差更大,这一点原文没有讨论。其四,全文没有给任何一个指标配置信区间或多种子方差(表 7、表 8 明说每个配置只训一个种子),所以 0.04 个百分点级的 dWER 差(0.84% 对 0.80%)不能当稳定差异引。5
与目标研究线的连接点:落在 C 线(TTS 生成与评估)。可搬走的是「先定 token 数、再定边界」这个约束写法:把 K=round(R·T) 写进分词器,生成器就能用参考音频或文本时长直接推出目标序列长度,不必在解码时加速率惩罚或阈值调参。第二个可搬的是 code–duration 接口:每个事件自带时长,生成端按事件为单位出 token 与时长,波形端逐个事件流式解码(实测每事件 11.07 ms,12.5 events/s 下每事件代表约 80 ms 音频),这套接口可以直接接到自回归 TTS 的流式输出上。第三是可懂度与保真度分离的评法:dWER/dCER 与 PESQ/STOI 在这篇里走向相反,评测表里必须分列,不能合成一个「质量」分。5
结论建议:方法看第 3.3 节(式 7–10 是预算的全部定义)与 3.5 节(稀疏网格解码),结果看表 6(12.5 Hz 受控)、表 8(只换边界)、表 10 与表 12(对外对比,注意两档比特率 0.8–1.5 与 2.2–3.0 kbit/s 分开读)、表 18(TTS)。引用 dWER 0.75%/0.50% 时必须带「12.5 Hz、1.23/2.43 kbit/s、LibriSpeech test-clean、多语种 37.5 万小时模型」四个条件;引用「降帧率」时要说明波形解码器仍在 50 Hz 网格上跑,缩短的只是下游序列,不是解码算力。
6. 端到端 520.7 ms 的流式音色风格转换:把风格收进一个 768 维嵌入,再用文本改它
StyleStream 2.0: Fast and Controllable Streaming Voice Style Conversion · arXiv:2610.28940 · 值得扫读
研究问题与核心方法:语音风格转换要在保留语言内容的前提下,把音色、口音、情绪换成目标的。流式场景还多一条硬约束:端到端延迟要低到能对话。6
1.0 已经做到流式零样本转换,但留了两个缺口:消费级硬件上约 1 s 延迟;只能用一段参考音频指定目标,说不出「年轻、英式口音」这种描述。2.0 的改动分别对着这两条。6
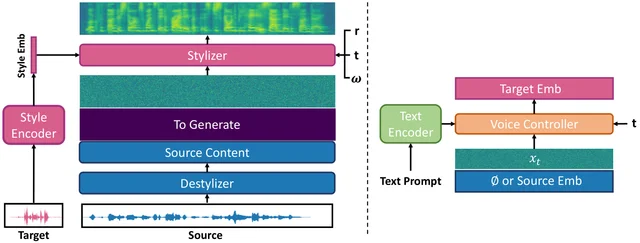
架构沿用 Destylizer–Stylizer 两段。Destylizer 不动:冻结 HuBERT-Large 加 6 层 conformer,训练时接 FSQ(有限标量量化)码本 45 和 ASR 解码器,输出 50 Hz 内容特征;改动都在 Stylizer,一个 16 层 DiT,768 维、12 头。6
提速靠两件事。一是把多步扩散换成少步的 pixel MeanFlow:网络预测干净样本 x 而不是速度场,CFG 蒸馏进网络后每个采样步只需一次评估,NFE(函数评估次数)用 4。二是照 Self Forcing 的办法做自回归微调:训练时随机取 8–30 帧的 chunk,带 3 s 前缀与 3 s 过去窗口,让模型在自己的不完美历史上算损失。6
可控性靠砍掉一条条件通道。1.0 同时用未掩码的 mel 上下文和风格嵌入,风格信息分散在两处;2.0 去掉 mel 上下文,目标风格只走一个 768 维嵌入,由 WavLM-base-plus 十二层拼接后经 8 个 query 的 perceiver resampler 压出。6
于是文本控制变成「在嵌入空间里预测或改写这个向量」:一个文本条件 DiT,Flan-T5-base 编 prompt,设计任务(按文字描述造一个风格)的辅助输入是学出来的空嵌入,编辑任务(改造已有的源风格)换成同形状的源嵌入,两个任务一起训。评测用 300 条源语音 × 10 条 prompt(设计,3000 项)与 × 10 条单属性指令(编辑,3000 项)。6
关键结果:
- 延迟:RTX 4060 上,300 ms chunk 加 80 ms lookahead 加 140.7 ms 单 chunk 处理,得 520.7 ms 端到端(300+80+140.7),处理时间含声码器,声码器自身占 3.139 ms/chunk。原文对 1.0 只给「约 1 s」,据此称 2×。6
- 同卡同协议扫 chunk:2.0 每 chunk 130.5–157.0 ms,1.0 是 500.1–598.4 ms;到 600 ms 档,2.0 用 157.0 ms、1.0 用 598.4 ms,单 chunk 快约 3.8×,而 1.0 只在 600 ms 档勉强实时(598.4/600)。6
- 参考条件转换(离线、4 NFE):S-SIM(说话人相似度)0.879、A-SIM(口音相似度)0.705,高于 1.0 的 0.869/0.699 与全部基线;E-SIM(情绪相似度)0.774 反而低于 1.0 的 0.808;WER 7.00% 高于 Vevo 2.0 的 5.79%。流式 300 ms 下 WER 12.02%、S-SIM 0.866,1.0 是 11.41% 与 0.842。6
- 可控性(VoxProfile 分类器判分):设计任务 Age-acc 70.67%、G-acc 99.44%、A-acc 52.73%、E-acc 32.20%,SC-MOS(prompt 一致性的主观分)3.96;编辑任务 Age 71.67%、G 99.17%、A 54.33%、E 仅 14.67%,SC-MOS 3.76、SP-MOS(非编辑属性保持)3.58。6
- 消融:去掉自回归微调,流式 WER 从 12.03% 涨到 19.54%,而 S-SIM 不动(0.866),说明这一步主要修的是 chunk 边界的失配;把风格编码器换回 1.0 的 TDNN,WER 7.00%→8.04%、A-SIM 0.705→0.633。6
证据与局限:原文自陈三条:520 ms 对强交互场景仍偏高;音色接口只覆盖年龄和性别,气声、明亮度、发声力度没有;情绪编辑在各项里最弱,编辑还会带动非目标属性漂移。6
读出来的问题集中在口径上。第一,「2×」不是同一 chunk 下的加速比:1.0 的流式配置是 600 ms chunk,2.0 主配置是 300 ms chunk,把 chunk 固定到 600 ms,处理时间之比是 598.4/157.0≈3.8×,而端到端延迟是 837 ms 对 1278 ms、约 1.5×;2× 只有拿 520.7 ms 去比「约 1 s」才成立,而 1.0 只写了「约 1 s」,端到端毫秒数原文没给,每 chunk 处理时间倒是有(500.1–598.4 ms)。第二,同一配置在不同表里数值不一致:离线 WER 在 Table 1 是 7.00%、Table 8(ω=3)是 7.03%、Table 9(NFE=4、ω=3)是 7.02%;流式 WER 在 Table 1 是 12.02%、Table 2 与 Table 5 是 12.03%。第三,可控性只有一个分类器判分,随机基线没报:评分用 VoxProfile 的三个 checkpoint,类别数只在年龄上交代了「折叠成 young 与 middle-aged 两类」,另外三个属性没有;即便照训练词表的 17 类口音、10 类情绪去推,编辑任务 E-acc 14.67% 离随机有多远,读者也只能自己猜。第四,客观与主观打架:编辑任务 E-acc 只有 14.67%,同一行的 SC-MOS 却有 3.76,设计任务 E-acc 32.20%、SC-MOS 3.96,听者认为「改对了」与分类器认为「改对了」不是一回事,原文没有解释这个落差。第五,主观规模:Prolific 招 40 人,NMOS 每人 90 条、每个 SMOS 变体 80 对,但没报每条评分的听者数、听者间一致性,也没说 ±0.12 的半宽是否按听者聚类。6
与目标研究线的连接点:落在 C 线。可搬走的是「把可控性做成对风格嵌入的改写」这个接口:一旦风格只由一条 768 维向量承载,文本控制就退化成在这个空间里做条件生成,不必改声学模型,也不必给每个属性训一个适配器。另一半可搬的是延迟口径,把端到端延迟拆成 chunk、lookahead、单 chunk 处理三项分别报,才能判断换 chunk 大小带来的是真加速还是拿质量换时间。
结论建议:先读 §3.2 与附录 B.1,再看 Table 2(延迟随 chunk 的完整扫描)与 Table 3、Table 4(可控性)。引用 520.7 ms 必须带「RTX 4060、300 ms chunk、80 ms lookahead、含声码器」;引用 2× 时要同时说明 1.0 的 chunk 是 600 ms、且原文只给「约 1 s」;引用 A-acc 52.73% 时要带「VoxProfile 单分类器、300 源 × 10 prompt、随机基线未报」。
三、工具增强与迭代修正
一篇问「工具把正确信息给到手上之后,模型还要自己走几步」,另一篇问「模型改完产物之后,判官判得准不准」。
两篇都把一个模糊的东西换成了可测的量。推导深度那篇的量是步数:报告直接写出结论,五个模型接近 100%;隔一步,开放模型在转调题上落到 57–81%;再深就到 0。混音那篇的量是距离:修正有没有让渲染结果离拟合目标更近,用这个当标签,才把「怎么改」训成一个可执行的批评器。
两个负结果说的是同一件事:判断这一步没有变准。推导深度实验里模型跟着工具给的错结论走;混音实验里让现成多模态模型自己听了改,Self-Refine 把多尺度频谱距离从 3.73 推到 4.57。
7. 把工具结论挪开一步,三个开放模型从接近 100% 掉到 57–81%:推理深度阶梯测「用不用得上」
Derivation Depth Exposes Reasoning Failures in Tool-Augmented Music Analysis · arXiv:2610.29060 · 精读
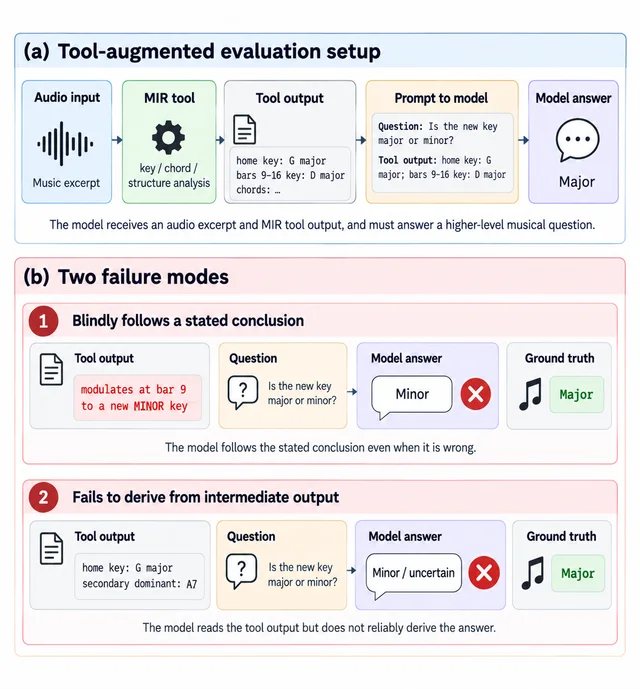
研究问题与核心结论:音频语言模型从音频里直接读调性、和弦这类基本属性时接近随机,于是一类常见做法是把 MIR 工具塞在音频和模型之间,让工具报测量值、模型负责推出答案。作者要问的是后半段:工具已经给对了信息,模型能不能把它推成答案。7
他们把这个能力拆成一个自变量:从工具输出到答案要走几步推理,记作推理深度(derivation depth),d0 是报告直接写出结论,d1 只给差一步的事实(例如「新调:D major」,还得自己判断它是大调),d2 给出判断所依据的和弦证据(转调里是枢轴和弦,实例为主调 G major 加副属和弦 A7),d3 只给和弦的构成音。刺激是程序生成 MIDI 再用 FluidSynth 渲染的短谱,模板报告按已知乐谱填写,所以标准答案精确;每处只改「信息以什么形式到达模型」,不改音乐事实。7
任务集是五个最小对照:终止式(正格对变格)、转调(新调为大调还是小调)、音阶(Lydian 对 Ionian,只差一个音)、动机(移调再现对新动机)、结构(ABA 对通曲式)。每个任务 6 个作品,在 −6 到 +6 半音之间最多五个移调,凑成每任务最多 30 对(音阶 23 对),五项合计上限 143 对——这个总数原文没写,是按各任务上限相加得到的。7
六种报告格式加一个翻转对照,固定同一事实:F1 直接给结论,F1 的反转版(原文记作 F1 加一条上划线)把结论改成错的,F2 给键值(新调 G major),F3 用散文给结论,F4 给逐小节和弦报告,F5 在 F4 上叠速度、起始调、RMS 噪声,F6 再包成 JSON。另有一组 72 项的深度阶梯,同一事实分四个深度呈现,用来把格式差异从深度差异里剥出来。7
模型清单是 5 个:本地跑的三个开源权重 Qwen2.5-Omni、Music Flamingo、Audio Flamingo 3,两个 API 模型 Gemini 2.5 Flash 与 Gemini 3.6 Flash。每种格式跑两个条件:无音频(只看测量值,测它会不会读)与带音频(再给原始录音,测音频能不能补上推理的缺口)。7
评分按「最小对照对」算:一对里两个成员的正确答案相反,只有一个模型两个都答对才算对,所以永远给同一个答案的模型得 0%,随机水平的对准确率是 25%。区间用 10,000 次 bootstrap 在作品层面重采样(同一作品的移调不独立),自动关键词判分与 100 条人工判分对齐,κ=0.90。此外还有三类探针:知识探针直接问每一深度所需的那条乐理事实(开放式模型每题 48 条,音阶级问题 37 条,Gemini 144 条);logit lens 逐层看正确答案是否可解码;激活引导把「结论已给」条件下的隐状态差注入到「需要推导」的前向里,看能不能救回来。7
关键结果:
- 工具直接写结论时五个模型全是 100%;把结论故意改成错的(F1 的反转版),五个模型准确率一起掉到 0%,即每一对都跟着错结论走,带音频也一样(表 2 末列)。7
- 只挪开一步(转调、d1:不再直接写「这是大调」,而是给出主调与新调两个调名,例如「主调 G major、第 9–16 小节 D major」,模型要自己判断该报哪一个、它是什么调式),三个开源模型从 100% 掉到 57–81%;同一批模型被单独问「某个调名是大调还是小调」时 100% 答对(表 3 知识列),所以这不是知识缺口。7
- 深度继续加就崩:d2 只给和弦证据时 0–26%(其中 Gemini 2.5 Flash 15%,与开源模型同水平),d3 只给和弦音时开源模型全 0%;Gemini 3.6 Flash 因为先内部推理再作答,d2/d3 还能守住 86%/82%(带音频 81%/47%)。7
- 汇总看格式落差(结构与转调合并,n=60 对、12 个作品):开源模型结论式 100% 对测量式约 35%,差 64–65 个百分点;Gemini 2.5/3.6 Flash 是 100% 对 85%/90%,只差 15 与 10 个百分点(表 2,95% 区间 9–21 与 4–17)。7
- 真实工具与真实录音不改变结论:换成在跑 librosa 分析器的输出,三个开源模型的测量式仍比结论式低 54–73 个百分点(两个 Gemini 低 12–33 个百分点);60 段 GuitarSet 上给一条错的调性标注,各模型采纳的比例是 33–100%,而它们自己从音频认调性只有 50–62%(开源)与 8–15%(Gemini)(表 4)。7
证据与局限:原文自己写下的边界很少,结论段只留了一句「未来扩展到更多模型家族与非西方音乐体系」,另在伦理声明里交代所有非合成音频来自 GuitarSet、人评基线由一名成人音乐家采集。读下来更实际的限制是:全部结论建立在 5 个任务、每个任务 6 个程序生成的短谱上(合成 MIDI 经 FluidSynth 渲染),真实录音只覆盖 GuitarSet 的调性一项;机制部分只做了 Qwen2.5-Omni 一个模型的 logit lens 与激活引导(转调 d2 上把 25% 抬到最多 29%,7 层都试过),不能推广到其余四个模型。伦理声明里那条「一名成人音乐家的人评基线」在正文与所有表格中都找不到任何数字,属于有声明无结果;单人也做不了偏好类结论。7
几处数字需要按口径读,不能拉平。第一,摘要说「一步之外开源模型掉到 57–81%」,这个区间只取无音频条件;表 3 里 Audio Flamingo 3 在 d1 带音频是 8%,比无音频的 81% 低 73 个百分点,所以「加音频不救」在个别格子里其实是「加音频更糟」。第二,正文说「一步最多损失 43 分」,也是只算无音频(Music Flamingo 100→57);按带音频算,Audio Flamingo 3 从 100% 掉到 8%,损失 92 个百分点。第三,深度阶梯每格 72 对(表 3)、格式汇总每格 60 对(表 2)、真实录音一项是 60 段 GuitarSet 录音的开集调性识别(机会水平约 4%,不是 25% 的对准确率),三处 n 与机会水平都不同,跨表比较要看清分母。第四,两轮调用(two-call)的缓解办法(表 5)只在少数格子有效:终止式 d2 从 17% 到 42%,但结构 d1 从 100% 掉到 62%、d2 从 90% 掉到 38%;正文还说「结构整份报告从 0% 到 17%」,这个 0%→17% 在表 5 里找不到对应格(表 5 只有 d1–d3 的 100→62、90→38、40→43),属于正文独有、无表可查的数字。7
与目标研究线的连接点:落在 A 线(长程任务训练与评估)。这套设计可以整段搬到任何「工具返回结构化测量、模型负责下结论」的评测上:固定事实、只改报告形式与推理步数,就得到一个可复算的深度阶梯;再用「结论翻转」当对照,就能把「会读工具输出」与「会核对工具输出」分开。对训练侧,深度阶梯的每一级天然是一批监督样本,翻转结论则是一个免费的诚实性奖励信号——模型该在工具结论与自己推导冲突时报警,而不是照抄。另外它提供了一个诊断分岔:logit lens 显示转调的答案从未成形(激活引导从 25% 只抬到 29%),结构的答案在中层可解码(93% 的样本)却在输出前衰减——「没算出来」和「算出来没用上」需要两种不同的干预。7
结论建议:先读 2.1 节(任务、六种格式、深度阶梯、评分口径都在这里)与表 1、表 3;再看表 2 的格式落差与表 4 的真实工具、真实录音;机制部分看第 5 条发现与图 3。引用「57–81%」必须带「转调、d1、无音频、72 对」;引用「一步最多 43 分」要说明是无音频口径,带音频的极值是 92 分;引用「35%」要带「结构与转调合并、60 对、F2/F4/F5/F6 四种测量格式平均」。
8. 把「改混音」训成可执行批评器:MedleyDB 重建误差 2.17→1.75,现成多模态模型自己听了改反而更差
Agentic Music Post-Production · arXiv:2610.29093 · 精读
研究问题与核心方法:混音的难点是「人声太闷」这句话落不到旋钮上——它既没说是哪个效果器,也没说改多少,而且效果器之间互相牵制,鼓一响就盖住人声。8。
他们只做参考曲引导的混音:输入是未经处理的干声分轨加乐器标签,再给一首不同歌、同风格的成品混音当风格参考;输出是轨、编组、总混音三层的具名效果器链和数值参数。8。音频只能由这些效果器渲染出来,模型不许直接生成波形。
流水线按录音师的分工切成四段。
分组 agent 听完所有分轨和文件名,把鼓组麦克风之类归到同一个编组;规划 agent 用检索到的样例,在轨、编组、总混音三级依次选效果器和顺序,但这一轮不写参数。
参数由规划 agent 初始化后,检测器(34.9M 参数的分类器,判「哪个元素需要改」)和批评器(判「怎么改」)接手,从轨到编组到总混音各跑一遍,后一级能听到前一级改完的音频。8。
MixCritic 的来路决定了批评器能学到什么。
对 165 个训练片段,先用 GRAFX 把链上参数梯度拟合到专业混音,得到伪真值参数;再让 Qwen3-30B-Thinking 对同一条链猜一套参数,随机替换若干轨的拟合值,造出「坏状态」。
教师模型(Qwen3.6-35B)对比坏参数和拟合参数,写出三种反馈:A1 感知描述、A2 点名工具和方向、A3 直接给数值。只有修正能把渲染音频拉近伪真值的样本才留下。
批评器是 Qwen3.5-4B 加一个冻结的 RLAT 效果器编码器,中间接可训练的音频适配器。训练分两段:先只训适配器,再和 LoRA 联合训,损失是交叉熵加 0.3 倍的「数字 token 损失」;然后做 DPO——同一状态采 8 条候选批评,逐条实际渲染,按归一化修正得分排序,最好的配两条最差的做偏好对。8。
关键结果:
- 在一套固定效果器链下,学到的修正把 MedleyDB 全混音 MRS(多分辨率 STFT 距离,越低越好)从 2.17 降到 1.75,降 0.42,相对 19.35%;同一对照的 MSS(多尺度频谱距离)从 3.70 降到 2.83,相对 23.5%。8。
- DPO 相对 SFT 再降 8.38%(1.91→1.75);每次修正的平均 ΔMRS 从 +0.0221 升到 +0.0398,修正成功率从 64.7% 升到 66.8%,即 2.1 个百分点。8。
- 让现成模型自己听了改,多数情况更差。MedleyDB 上 Qwen3-Omni 单遍 MSS 3.73,Self-Refine 4.57,Self-Critic 4.79;GPT-4o-audio 3.67→3.95→4.53;Gemini 3.8 Flash 3.77→3.69→3.73,只有它的 Self-Refine 略好于单遍。8。
- 检索样例改善的是「选什么效果器」:把参数拟合到真值后,无样例时 MRS 2.13,3 条文本加 1 条音频样例降到 1.08,随机样例只有 1.71;每轨选中的工具数从 1.55 涨到 3.77。8。
- 11 人各做 10 次试听的多人听测里,MixAgent 的评分显著高于三个 LLM 基线(p<0.001,Holm 校正的配对 t 检验),但与原始人混音仍有明显差距;Table 2 上 MedleyDB 的 MSS 是 2.83,最好的基线 GPT-4o-audio 单遍是 3.67。8。
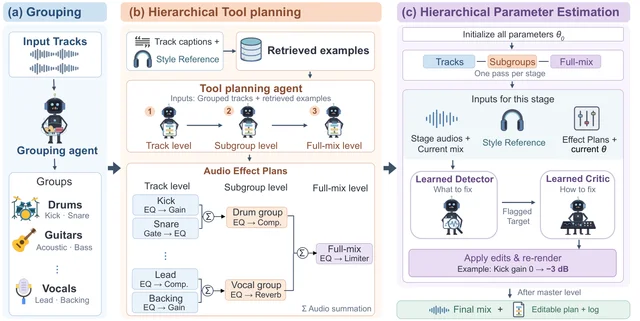
证据与局限:原文自己列了五条:同一个输入可以有多组合法混音,对着一条专业混音算重建误差并不等于混音质量;TuneJury(预测听众偏好的打分器)的输入是单声道,立体声像看不到;Audiobox 那条管线只用 16 kHz,高频细节也看不到;评测集小(MedleyDB 20 个片段、17 首;AlbumDB 14 个片段;听测 10 个片段);监督和 oracle 都来自 GRAFX 拟合参数,与工程师真参数有距离(本方法重建误差 1.75,拟合参数自身对齐到 0.90);效果器库只覆盖专业工具的一小部分,链在规划后就固定了。8。
有三处要自己补上。
第一,45,657 是 A1/A2/A3 三种反馈形式的合计,按 Training 和 Table 8 的说明除以 3 是 15,219 个修正点,再除以 165 个片段约每片段 92 个;摘要里「45,657 条修正批评」若被当作独立修正常识引用,会把实体数放大三倍。
第二,Table 5 里去掉检索后 TuneJury 是 0.28,高于完整模型的 0.21,正文只讲检索带来的重建收益,没提这个反向。
第三,未训练批评器(直接用 Qwen3-Omni 提示)在三个形式下只落到 113–117 次修正,训练后是 238–252 次,成功率对比里混着「改得少」这一层差异。
听测部分原文没给均值,只有 Figure 4 的分布;「显著高于」的结论靠 11 人、10 个片段支撑,样本量本身不足以分辨小差距。
与目标研究线的连接点:落在 B 线。可搬的是批评器的监督信号怎么造:不用人写的偏好文本,而用「这次修正让渲染结果离拟合目标近了多远」当标签,再在同一状态上采多条候选、真渲染、按结果排序做偏好对,于是「哪种改法更好」变成可验证的量而不是措辞。第二个可搬的是 what 与 how 的分工——检测器只管点名,批评器只管给数,两个模块分开训练、分开评估。第三个是层级顺序:自下而上逐级修正,让后一级在听到前一级结果的基础上判断,消融里这个顺序比从上往下(MRS 1.82)和一次改完(1.88)都好。
结论建议:先读 3.3 节(MixCritic 构造与 DPO 采样)、Table 3(反馈形式×训练阶段的交叉)和 Table 5(组件消融),再看 5.1 节对「反馈越具体越好」的论证。引用 19% 必须带「MRS、相对规划器单独输出的 2.17」;引用 8.4% 必须带「相对 DPO 之前的 SFT 批评器 1.91」;引用 45,657 要说明是三种反馈形式的合计。
四、音频侧评测口径:时间定位、差异与说话人转写
三篇都在做同一类工作:把音频里的某件事变成一句能核对的话,分别是对应第几秒、和文本差在哪里、谁在什么时候说了什么。
三篇的产物都能直接接进评测流水线。配对查询给出三种取出时间跨度的测法,哪一种失败都能定位到具体环节;差异字幕把 0.72 的相似度换成一个「把狗叫说成了猫叫」;分离转写的 [SPK|start-end]text 可以直接当节目级评测的中间表示,80 ms 的时间网格给出了对齐精度的上限。
这三条都是邻近跟踪,理由写在各自条目里:它们解决的是「怎么说清楚」,而四条研究线要的是「怎么训练与怎么判分」,接口能搬,结论不能直接搬。
9. 冻结音频语言模型能验证不能定位:变更查询随上文从 0.102 升到 0.312,整轨提问最高只有 0.072
Heard But Not Said: Prompting Understates Temporal Information of Musical Moments in Frozen Large Audio-Language Models · arXiv:2610.29256 · 值得扫读
研究问题与核心方法:大型音频语言模型(LALM)说不准「这段话描述的是第几秒」,这可能说明模型里没有时间信息,也可能说明提问方式把已有的信息挡住了。这篇不训练任何东西,只换「怎么把时间段取出来」这一件事。9。
探针建在 Slakh2100 上:MIDI 声部活动精确记录了每一刻有哪些乐器在响。
他们找「稀疏织体」——至少 3 秒、最多 4 个声部、该组合占全曲不到五分之一——并要求它紧接一次「声部退出」(此前已响至少 6 秒、随后静默至少 3 秒)。
同一段音频因此可以配两句话:状态查询「只有钢琴和贝斯在响」,和变更查询「吉他退出,剩下钢琴和贝斯」。
配对是这套设计的关键:两种查询指向同一段音频、同一位置、同一时长,所以基线命中率在构造上就相同;剩下的差异只能归给查询要求的那部分时间计算。9。
三种取出方式问的是三件不同的事。Exp.1 整轨提问,要模型直接报起止秒数,问的是「它能不能说出来」。
Exp.2 不给时间,把窗口沿轨滑动,在每个位置问「窗口最后 2 秒是否匹配这句话」,但不去读模型的回答,而是取 logit[yes]−logit[no] 当分数,问的是「片段递到手上它能不能确认,以及需不需要先听前面的」。
Exp.3 读最后一个提示 token 对音频 token 的注意力,问的是「没人给窗口时它能不能自己找到」。
Exp.2 只操纵一个变量:窗口写成 [t−C, t+2],总以被判的 2 秒结尾,往前多听 C ∈ {0, 2, 4, 8} 秒。
C=0 时退出的乐器落在窗外,变更查询只剩「残留状态」可依据;C 变长,退出事件才进入窗口,所以变更查询能不能随 C 恢复,直接检验模型是否在拿当前段和前面比。
数据上,去掉 221 条重复轨后是 713 对、503 条轨,抽 20%(143 对)当 dev 只用于定两个后处理参数和选注意力变体,剩下 570 对(1,140 条查询)做评测。模型是 7 个开源权重 LALM:4 个编码器只在小窗口内做自注意力(Qwen2.5-Omni 2 秒、Qwen3-Omni 1 秒、两个 MOSS 4 秒),3 个是 Whisper 式编码器,每个输入都补到 30 秒,长曲被切成互不相干的 30 秒帧。9。
关键结果:
- 变更查询在三个短片段模型上随上文恢复:Qwen3-Omni 从 0.102 到 0.312、Qwen2.5-Omni 从 0.105 到 0.219、MOSS-Audio 从 0.163 到 0.233;MOSS-Music 只从 0.139 到 0.170,不显著(p=0.09)9。
- 三个 30 秒补零编码器没有这种恢复,状态分反而掉:Audio Flamingo 3 从 0.230 掉到 0.142、变更从 0.147 掉到 0.107;C=8 时三个模型的两个条件都低于 0.147。9。
- 整轨提问全线失败:最高的 MOSS-Music 只有 0.072,其余 0.007–0.042,都低于 0.100 的「按真值时长给固定段」基线;这一问的对照口径与前面的 0.147 不同,0.147 是 best-constant-span;答案多半只跟查询形状有关(状态给开头段、变更给中段),四个模型在打乱音频后答案不变。9。
- 注意力只在两个 Qwen-Omni 上有显著的段内超出(0.041/0.020 与 0.044/0.062 z 单位),但即便在这里,定位仍低于基线;打乱音频后注意力跟着内容走,说明是局部声学匹配而不是整轨定位。9。
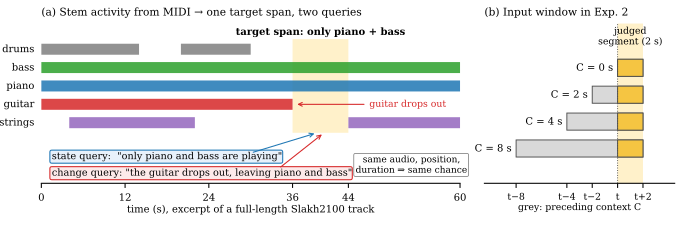
证据与局限:原文自陈三处:Slakh2100 是 MIDI 渲染,查询只涉及「哪些乐器在/不在」,不涉及和声、力度、节奏或人声结构;各方法的绝对分数都不高;编码器与效果之间只建立了相关,原文明确写「correlational and may not be causal」。9。
自己读下来有两点要注意。
其一,不同 C 下窗口总长从 2 秒变到 10 秒,「补零编码器把音频结束位置藏起来」只是对现象的一种解释,原文也承认没做因果干预;而窗口长度本身在变,短片段模型与补零模型的对比里混着这个因素。
其二,Exp.1 与 Exp.2 不是同一种读出(一个是生成文本再解析,一个是读 logit 差),两边的数值区间几乎不重叠(0.004–0.072 对 0.10–0.31),不能把差值折算成「提问比打分差几倍」。
另外原文写 Audio Flamingo 3「状态分掉一半」,这句只在 oracle-duration 列成立(0.226→0.107,−53%),在 R@1@0.3 列是 0.230→0.142(−38%)。
与目标研究线的连接点:落在 C 线,属邻近跟踪。可搬的是评测口径本身:把「模型会不会说出时间」和「模型能不能确认一段音频匹配描述」拆成两个测法,后者不要求生成、只读 logit[yes]−logit[no],并按(样本, 查询)做 z 归一化以去掉「爱说是」的整体偏置。配对查询的构造也值得照抄——两种条件共用音频与位置,基线因此在构造上相等,任何差值都不用再解释成难度不同。对合成语音或播客片段的质检,这套窗口打分比让模型报时间戳更稳。
结论建议:读 3.1 节的探针构造、3.2 节的三种取出方式和 Table 1;主结论看 Figure 2 的七个小图,左半(短片段)红点随 C 上抬、右半(30 秒补零)红蓝一起下滑,是全篇最直观的一处。引用 0.312 要带「Qwen3-Omni-30B-A3B、R@1@0.3、570 对评测集、C=8 秒」;引用整轨提问的 0.072 要说明那是 R@1@0.5、且基线是 0.100。
10. 用模板模拟出 197,280 对音频-文本差异:差异类型分类从 58.5% 升到 91.9%,但只训字幕会掉到 20.2%
AT-Differ: Dataset for Audio-Text Difference Captioning · arXiv:2610.29836 · 值得扫读
研究问题与核心方法:现有的音频-文本对齐评测基本只给一个分数——CLAP 相似度,或者训一个回归器去预测主观分。分数低的时候没人知道是认错了事件、漏了事件,还是把顺序说反了。10。
这篇把任务改成生成:给定一段音频和一句文本,输出一句差异描述,句式由模板固定,比如「caption 把 X 的声音说成了 Y」「caption 漏掉了实际存在的 Z」。10。
差异是「系统模拟」出来的,不是从真实系统里收集的。源音频用 FSD50K-Solo(只含单一事件的片段);每个片段随机抽 N=6 个合法组合,一个组合由「音频结构 × 差异类型」决定。
音频结构有三种:单事件、两个事件同时、两个事件先后。差异类型有五种:语义替换、文本漏述(音频有、文本没写)、音频缺失(文本写了、音频没有)、顺序颠倒、同时/先后错认。
需要第二个事件时再叠一段音频,文本和差异描述都用 FSD50K 的事件标签代入模板生成。
这样标签和音频改动同源:改了哪一处,描述就写哪一处,不需要人工标注,也不会出现描述与音频对不上的情况。10。
规模按 FSD50K 原有划分:训练 149,172 对(单 30,770、同时 51,279、先后 67,123)、验证 14,466 对、测试 33,642 对,合计 197,280 对。
按每片段 6 条反推,对应 24,862 / 2,411 / 5,607 个片段——原文只给对数,没给片段数。
评测用 Qwen3-Omni-30B-A3B-Thinking,LoRA 只调自注意力的 query/key/value/output 投影(rank 16、α=32),训 1 个 epoch。
三种微调法差别在于监督哪些输出:只监督最终字幕;三个任务(检测、类型、字幕)拼成一条序列算一个交叉熵;三个任务分开算再加权(λ 都取 1/3)。
关键结果:
- 差异检测(二分类「有没有差异」)准确率:未微调 80.9%,只训字幕 75.4%,拼序列 94.8%,分开加权 94.7%。10。
- 差异类型分类准确率:58.5% → 20.2% / 91.7% / 91.9%,只训字幕的做法把这项从 58.5% 打到 20.2%。10。
- 字幕指标(CIDEr-D 衡量与参考句的 n-gram 共识,BLEU-4 看四元组重合,SPICE 看语义命题):CIDEr-D 从 1.021 升到 6.882,BLEU-4 从 0.269 升到 0.843,SPICE 从 0.449 升到 0.809,SBERT(句向量的余弦相似度)从 0.735 升到 0.911。10。
- 拼序列与分开加权的差别在噪声级:CIDEr-D 6.882 对 6.873,BLEU-4 0.843 对 0.841,检测 94.8% 对 94.7%,类型 91.7% 对 91.9%。
- 「固定事件、随机换差异类型」的模拟基线本身就有 CIDEr-D 4.839、SBERT 0.864,只训字幕的做法(2.858 / 0.755)低于这条基线。10。
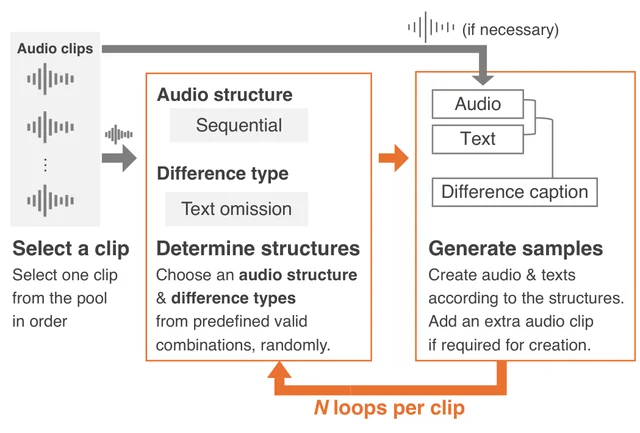
证据与局限:原文没有单独的局限小节,限制散在方法里:每段音频最多两个事件、每对最多两种差异类型;时长、计数、空间关系三类差异被排除;只在 FSD50K-Solo 上做,只微调了一个模型,只报了一个测试集。
自己读出来三点。
第一,参考句是模板生成的,任何按模板填词的系统都会得到高分——只训字幕那一档的 BLEU-1 到 0.915,这个数不能拿去和真实字幕任务横比;真正可比的是同一张表里两行随机基线,而表里「Random」那一行是空的,只有两个受控版本有数。
第二,「所有方法都超过基线」这句只对未微调模型成立;只训字幕那一档在检测(75.4% 对 80.9%)和类型(20.2% 对 58.5%)上都比未微调更差,十三个指标里有九个低于「固定事件、随机换类型」的基线(只有 BLEU-2/3/4 与 BERTScore 精确率更高)。
第三,三个任务在同一次生成里串行输出,检测与类型准确率的提升有多少来自多任务监督、有多少来自输出格式被固定,原文没做这个消融。
与目标研究线的连接点:落在 C 线,属邻近跟踪。可搬的是「把对齐分数换成差异描述」这个输出形式:给合成音频做质检时,比起一个 0.72 的相似度,一句「把狗叫说成了猫叫」更容易定位问题。构造办法也能照搬——只在文本侧做受控置换、音频侧同步改动,标签由改动本身决定,因而无需人工标注,也不会有标注歧义。要注意它测的是「能不能说出被注入的差异」,不是「能不能发现真实系统产生的差异」。
结论建议:读 3.2 节(三种结构 × 五种差异的组合规则)、3.3 节(规模拆分)和 4.3 节(三任务结果),Table 2 要与「Fixed sound event」那行对照着看。引用 91.9% 必须带「差异类型分类、方法 3、Qwen3-Omni-30B-A3B-Thinking、AT-DIFFER 测试集」;引用 CIDEr-D 6.882 要说明参考句是模板生成,绝对值不可跨任务比较。
11. Qwen-Audio-3.1-ASR:四套说话人分离测试集 cpWER 最低 12.04%,参数量与语言清单未公布
Qwen-Audio-3.1-ASR Technical Report · arXiv:2610.28711 · 第三档
研究问题与核心方法:这是一份模型族的技术报告,不是单点方法论文。核心结构是音频编码器、音频适配器、MoE 的 LLM 解码器,另有一条辅助 CTC 分支,只用来给热词和长音频上下文提供初稿假设,不作为最终转写。11。
相对上一代新增两块能力。说话人分离转写把输出写成一串
[SPK|start-end]text:时间是相对输入的秒数、量化到 80 ms 网格(对应编码器 12.5 Hz 的帧率),同一说话人在整段里共用一个标签,不同说话人的区间允许重叠。通用音频理解只有 Next 变体有,覆盖字幕、时间定位(单区间边界定位与多区间检索)和音频问答。三个可调控制都在指令里:历史上下文把前几轮转写当条件,指令明说历史可能不全、无关或错误;分层热词分 P0(高置信)和 P1(候选池)两档;原生润色用一个二值指令决定保留口语原样还是去掉填充词、重复和自我更正,润色在解码内完成,不另起一次 LLM 调用。11。
五个部署变体里,分离转写只在 Flash 与 Next(都是非流式)上有,通用音频理解只有 Next 有;Filetrans、Streaming、Message 只做转写,Message 另带润色。
规模这块读者能核对的很少:全文没有给参数量,只说 LLM 部分用 MoE 骨干、「Flash」是尺寸代号;数据给的是小时数——编码器预训练「数千万小时」,音频 LLM 预训练约 2,000 万小时,cooldown 约 100 万小时。
语言数是 30 种语言、16 种中文方言(分属八个方言区),但正文没有语言清单,评测表里出现的非中英语种只有 10 种。
关键结果:
- 中文与英文(自家统一 API 口径,Panel B):AISHELL-1 CER 1.08%、AISHELL-2 2.05%、FLEURS-zh 2.25%、FLEURS-en WER 4.72%、LibriSpeech-clean 1.23%、LibriSpeech-other 2.19%、WeNetSpeech-net 4.37%;七项里四项最低,其余三项是 Fun-ASR-Flash 最低。11。
- 多语种:GigaSpeechBench 七个东亚与东南亚语种宏均 15.09%(上一代 22.50%),Common Voice 15 宏均 3.74%(只算结果齐全的系统),FLEURS 宏均 3.85%,比 Azure MAI-Transcribe-2 的 3.25% 差。11。
- 说话人分离(约 4 分钟分块):Flash 版在 AISHELL-4 / AliMeeting-test / MLC-SLM / MagicData-RAMC 上 DER(说话人分离错误率,含漏检、误检、说话人混淆)为 3.26 / 2.11 / 1.80 / 3.08,cpWER(先把同一说话人的预测词按最优排列拼接、再算词错率)为 15.02 / 15.78 / 12.35 / 13.32;Next 版 cpWER 为 13.51 / 12.04 / 12.60 / 13.58,AliMeeting 上比 Flash 低 3.74 个百分点。11。
- 音频理解:MMAU 81.60%、MMSU 82.24%、CochlScene 76.30%、NSynth 66.90%、Clotho-Moment mIoU 82.20%,九项里七项最好;MMSU 落后最好成绩 3.06 个百分点,DESED 落后 0.04 个百分点。11。
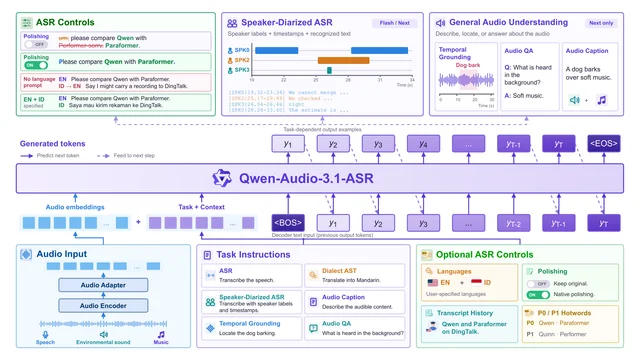
证据与局限:最要紧的一条是原文没报参数量,也没报训练数据配比和重复次数,所以「30 种语言、16 种方言」这类能力声明无法从报告内部核对,只能看它列出的评测子集。
数字上有两处口径要分清楚。
一是 ASR 表分 Panel A(引用各家公开报告)和 Panel B(自家统一 API 重跑),原文自己说以 Panel B 为准,两栏里本模型的数值相同但基线不同,把本模型与跨栏的基线放在一起比,名次会不一样。
二是同一代际的对比并不全是进步:AISHELL-1 上 3.1 是 1.08%、3.0 是 1.03%,FLEURS-en 上 3.1 是 4.72%、3.0 是 4.17%,后者差 0.55 个百分点,是这两代在这七个测试集里最大的绝对差,摘要只写了「识别增强」。
延迟表(Table 6)也有读不顺的地方:Doubao 的首字延迟 570 ms 反而高于文本上屏延迟 530 ms,三个指标的定义正文没展开;且 Doubao 走 API、Qwen 自托管在 H100 上,网络条件只写了「假定相当」。
与目标研究线的连接点:落在 D 线,属邻近跟踪。节目级评测需要「谁在什么时候说了什么」的参考转写,
[SPK|start-end]text 这种串行格式可以直接当评测基准的中间表示,80 ms 网格也给出了时间对齐的精度上限。DER 与 cpWER 分开报,提醒「说话人分对」与「词听对」是两件独立的事,做播客质检时要分别设阈值。历史上下文与分层热词是把「同一节目里反复出现的人名、术语」变成可控条件的现成接口。结论建议:读 5.8 节的 Table 7 与 5.9 节的 Table 8,方法细节看 3.4.2 节(输出串行化、说话人 token 损失加权 10 倍、时间戳量化到 80 ms)。引用 cpWER 12.04 必须带「AliMeeting-test、Next 变体、约 4 分钟分块、百分比」;引用 MMAU 81.60 要带「Next 变体、准确率」;不要引用任何参数量,原文没有。
五、播客线、排除清单与本期可迁移结论
D 线与播客相关的能力本期只有一条邻近跟踪(Qwen-Audio-3.1-ASR 的分离转写),播客生成本体零命中。原因在候选口径:这一天语音与音频栏 18 篇里没有一篇做播客生成或节目级评估。
这条线本身仍在产出,用 arXiv 检索核对过四个短语,各自最近一次命中是:
"podcast generation" 查到 2607.21961(2026-07-24,文档转播客的逐轮忠实性);"podcast script" 只查到 2601.14903 PodBench(2026-01-21,800 条样本的播客脚本基准);"audio drama" 查到 2610.18010 Fish Audio Drama 3(2026-10-13,35B 专家混合骨干的表演式语音生成);cs.SD 分类下关键词 podcast 最近命中 2610.22401(2026-10-14)。第四条要打折扣:cs.SD 里带 podcast 的命中多数是 MSP-Podcast 这类语料名,不是播客生成本身。排除的 7 篇与理由。音乐转录与音乐生成本身三篇:2610.29222(合奏场景钢琴转录的相位起始点增强)、2610.29928(钢琴音频到乐谱的乐时坐标)、2610.29031(昆曲唱词对齐与押韵检索的语料库)。架构与硬件能效一篇:2610.29720(脉冲三元 GRU 加共振发放神经元的语音识别,主线是能效)。源分离一篇:2610.29119(含音乐场景的目标说话人提取,两段式带拆分加流匹配细化,连接点只到数据清洗一环)。艺术创作报告一篇:2610.29026(9 分钟电声打击乐作品的创作说明,4 页)。另有 2610.29101(抹香鲸咔嗒声的双通道对比编码)属生物声学,不在四条线上。
本期最值得搬走的三件事。一是「可解码不等于可控」的因子设计:等范数方向乘位置,再加一个「目标主导」判据(同时接近目标且比源更像目标),任何声称能改某个属性的激活干预都该跑这一组。二是把批评器的监督信号做成可验证的量:不看措辞,看这次修正让渲染结果离目标近了多少,再在同一状态采多条候选、真渲染、按结果排序做偏好对。三是延迟与预算的记账方式:端到端延迟拆成 chunk、lookahead、单 chunk 处理三项,token 预算写成每句事件数 K=round(R·T),两个写法都能直接搬进自己的流水线。
三处需要打折扣的读数。第一,字符级韵律控制的「+62.9%」是对基线的相对增量,音高只挪了 5 Hz,尚在训练标签门槛之下,不要当作「模型能把任意字拉长或抬高到指定值」。第二,音色定位的「1–8 kHz 主导感知」在听测里没有 4–8 kHz 单带条件,而机器最强的 1–4 kHz 单带人耳只给 2.92 分;引用这条结论时要说明它来自频带集合的对比,不是单带实验。第三,Qwen-Audio-3.1-ASR 的「识别增强」与它自己的数字不完全一致:AISHELL-1 的 CER 从 1.03% 升到 1.08%,FLEURS-en 的 WER 从 4.17% 升到 4.72%,引用时要按测试集分开说。
References
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8Agentic Music Post-Production
arxiv.org
- 9
- 10
- 11Qwen-Audio-3.1-ASR Technical Report
arxiv.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.