10月22日自然语言处理栏:记忆 $6.95 拿到 99% 而全上下文 $17.84 才 95%、判官被自动审出 3.7 倍缺陷族、NP-完全侧 pass@1 35.4% 对多项式侧 63.8%:长程智能体与轨迹学习的 25 篇分层雷达
本期把该账号 10 月 22 日自然语言处理栏 89 篇逐条筛完,收录 25 篇:一套记忆 $6.95 拿到 99% 而全上下文 $17.84 才 95%、判官被自动审出 3.7 倍缺陷族、NP-完全侧 pass@1 宏平均 35.4% 对多项式侧 63.8%。

本频道盯「arXiv 每日学术速递」的三个栏目:人工智能、自然语言处理、语音与音频学术速递。
本期处理该账号 2026 年 10 月 22 日 21:09(GMT+8)批次里的自然语言处理学术速递[10.22],89 篇。同批的人工智能栏 63 篇与语音与音频栏 18 篇已在当日各自成篇,本期与它们零重复。
公众号正文只展开每栏前几篇,完整名单在它自己的官网 arxivdaily.com 上。
当期候选池按该官网同日同栏目的完整条目重建:cs.CL 列表 225 条,被标为「新提交」的 89 条。其余 49 条是交叉投稿、84 条是版本更新,另有 3 条是插在列表里的旧文(没有提交标记),都不计入。
89 篇逐条读完后收录 25 篇,排除 64 篇。排除集中在三类:通用 NLP 训练与推理方法 15 篇、单点语言现象与表征分析 16 篇、领域应用与语料库建设 20 篇。
其余 13 篇是检索增强生成的内部机制 4 篇、单点安全与检测 6 篇、语音识别与理解侧 3 篇,完整编号列在第八节。
收录的 25 篇按与四条研究线的关系分层:直接命中 19 篇、邻近跟踪 6 篇。
按阅读投入分档:精读 9 篇、值得扫读 16 篇。本期没有第三档——89 篇里够门槛的只有这 25 篇,它们都已按前两档排过。
四条线按每篇的主要归属计:A 线(长程任务的训练与评估)13 篇、B 线(轨迹学习与自进化)12 篇、C 线(TTS 生成与评估)0 篇、D 线(播客生成与节目级评估)0 篇。
C 线与 D 线本期零命中,原因与核实路线写在第七节。
站点给的中文摘要与 arXiv 原文有出入的地方,条目里按原文写并逐条点出。五个例子分列如下。
Quant-Arena 的摘要(站点与论文摘要都这么写)称「无模型跑赢等权市场」,表 2 里 GPT-6 Sol 中等推理年化 18.4%、超过基准 1.4 个百分点。
Scan or Index 的「Hybrid + Jev 证据覆盖率最高」只在教材上成立,QASPER 上最高是两个 Clef 变体的 98.8%。
AI Research Teams 的搜索在约 150M 参数上做,1.3B 只是把最优候选放大后做验证。
DynaWeave 的 Gaia2 Adaptability 子项在 2B 与 4B 上仍停在 0.0。
LongZero 的「五基准全胜」只在均分上成立,4B 的 AA-LCR 与 8B 的 LBv2 都低于某一基线。
本期有六条判断值得先记住,理由与限定写在各自条目里。
记忆的账被反过来算了。 MemoryTax 的 21 格成本-正确率前沿里,Pi 配 Claude Opus 5.5 用 $6.95 拿到 99%,同模型全上下文 95% 要 $17.84;Mem0 建库 $25.88 已高于整轮 $17.84,按每题差价要 596 题才回本,而 LoCoMo 只问 152 题。但同一篇在 88 道不含照片的题上,Pi 100%、全上下文 99%,只差 1 题;作者因此明说「搜索是否比通读答得更多」这件事没有结论。
记忆也不是单调增益。 同一份 Mem0 记忆在 IdeaBench 上,64 段训练对话后是 +7.10 个百分点,128 段后 −10.43,256 段后 −13.93;作者指出 8K 与 32K 的容量上限从未被触发(实际占用到 3,858 token 即饱和),所以掉分不能归因于容量不足。
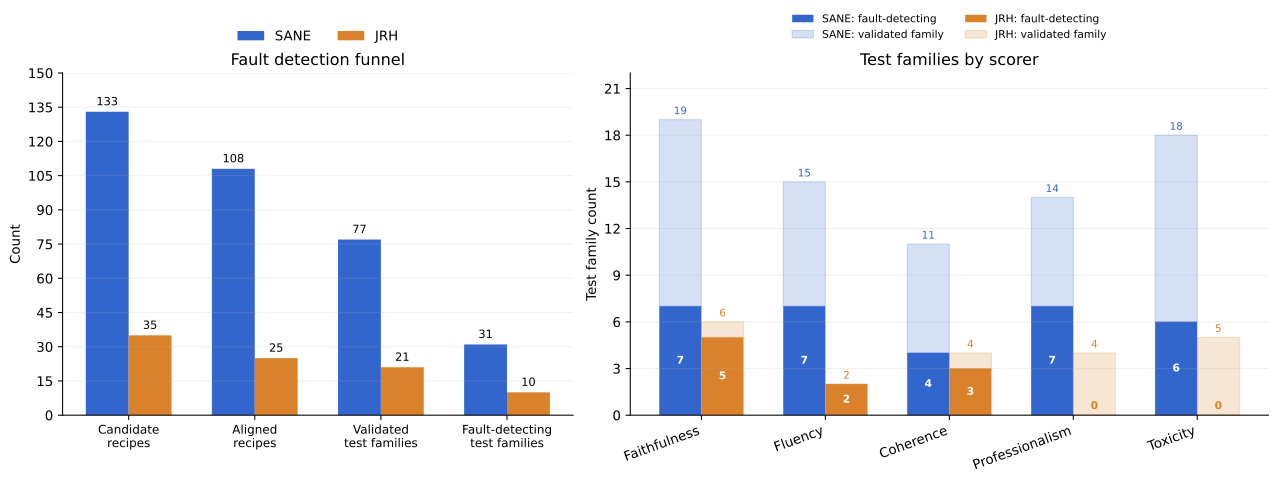
判官可以被自动审,也可以被换便宜。 SANE 让智能体为每个评分器推导变形测试,五个评分器上积出 108 条对齐配方、77 个通过验证的测试族,是固定配方基线的 3.7 倍,检出缺陷的族 31 对 10;代价是两套测试都由同一个生成模型产出。Our Own Jev 则把评委换成一次前向的类型化判定:原来一轮前沿评委标注要花约 $1,000 与 73 小时,换成自托管后 1,000 条会话约 3 分钟、约 $0.06。
卡住模型的往往不是时间。 P2NPCBench 上 12 个模型在 NP-完全侧的 pass@1 宏平均 35.4%、多项式侧 63.8%;在同一批 NPC 题的限时实验里,把限制从 1 秒放到 10 秒,均值只从 28.5% 升到 31.9%,没有一个模型涨幅超过 5.1 个百分点。
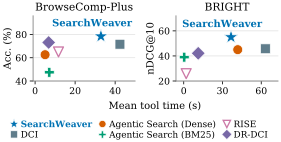
外部结构的收益还在长,而且能跨模型复用。 SearchWeaver 让 agent 自己改语料工件、工具与说明,BrowseComp-Plus 从 71.6% 到 78.4%,BRIGHT 的 nDCG@10 从 45.7 到 55.0;换到没参与优化的模型上,仍是 60.9%→73.9% 与 50.7→58.8。
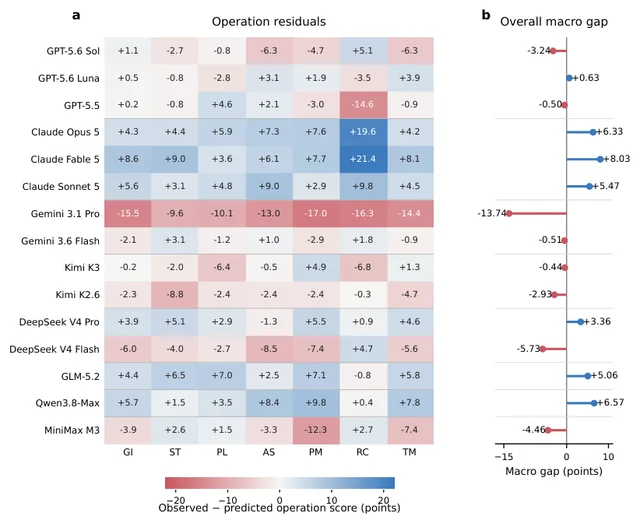
长程能力与基础能力要分开记账。 15 个模型服务、τ²-Bench Banking 域的 1,451 条轨迹上,只用基础画像预测任务奖励的留出 Q² 是 0.382,只用操作画像 0.702,两者相加 0.733(同语料内预测,不是跨语料泛化);按家族留出的残差看,Gemini 3.1 Pro 的实际操作分比预测低 13.74,Claude Fable 5 高 8.03。
全景表
| 优先级 | 分层 | 标题与 arXiv | 一句话方法 | 关键数字 | 主要局限 | 来源 |
|---|---|---|---|---|---|---|
| 1 | 邻近跟踪 | Did the Problem Actually Get Harder? · arXiv:2610.30103 | 用 AgentGAN 把同一题面重写成 P 与 NP-完全成对题,再测 12 个模型 | NPC 侧宏平均 35.4% 对 P 侧 63.8%;144 格里 137 格 NPC 更低 | 2,114 条题出自 295 条 lineage,独立样本远少于此 | 官网 · 全文 |
| 1 | 直接命中 | Quant-Arena · arXiv:2610.30113 | 9 个模型在 3,042 只 A 股的封存 2024 年上跑完整研究循环 | 38 组里 1 组年化 18.4% 高于 17.1% 等权基准;最高总分 51.29 对自研 77.56 | 单一市场单一年份,每格一次运行 | 官网 · 全文 |
| 2 | 直接命中 | Environment Duels · arXiv:2610.30116 | 9 个模型各出 10 个环境,有/无提示两条件打 12,960 局再反制一轮 | 难度第一 29.7;解题第一的 Opus 提示增益只排第 7 | 每环境只有 4 个种子,只有一轮反制 | 官网 · 全文 |
| 2 | 直接命中 | MOSAIC · arXiv:2610.29249 | 923 题的全模态长记忆基准,冻结读者逐阶段替换做诊断 | 原生视频证据比金标事实低 17.1 分、图像 6.2 分、音频只低 0.5 分 | 全合成数据;主读者只有 Gemini 3.5 一个 | 官网 · 全文 |
| 2 | 直接命中 | Memory-Centric Continual Learning · arXiv:2610.29357 | 把记忆写成双环生命周期,用有状态/重置对照扣掉上下文变长 | 读取预算 512→2,048 的配对增益 2.93 点 [2.06, 4.02] | 缩放律是示意;自测只覆盖一个骨干一个实现 | 官网 · 全文 |
| 1 | 直接命中 | Uni-Mem · arXiv:2610.29671 | 用一个共享策略在线同时训记忆构造与检索,事件级信用分配 | LoCoMo 88.80% 对最强基线 77.87%(+10.93) | 换裁判后同批 checkpoint 差 9.73 个百分点 | 官网 · 全文 |
| 2 | 直接命中 | MemoryTax · arXiv:2610.29823 | 把建库成本算进每次 rollout,测 4 种记忆 × 3 个智能体共 21 格 | Pi+Opus 5.5 用 $6.95 到 99%,全上下文 $17.84 才 95% | 只用一段对话、每格一次运行 | 官网 · 全文 |
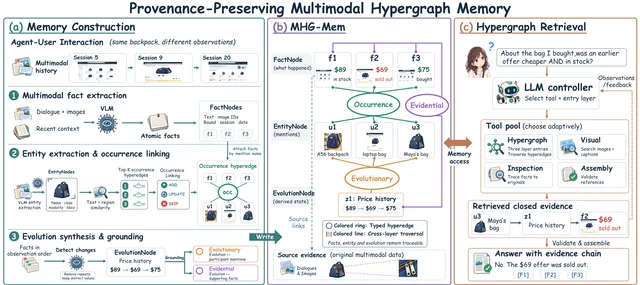
| 2 | 直接命中 | Remembering Through Change · arXiv:2610.29995 | 三层节点加三类超边保留溯源,检索走 agentic search | 三骨干均分 57.98/67.95/73.28,比最强基线高 8.20–9.98 | 八条基线全由作者重跑;比基线多约 2 倍 token | 官网 · 全文 |
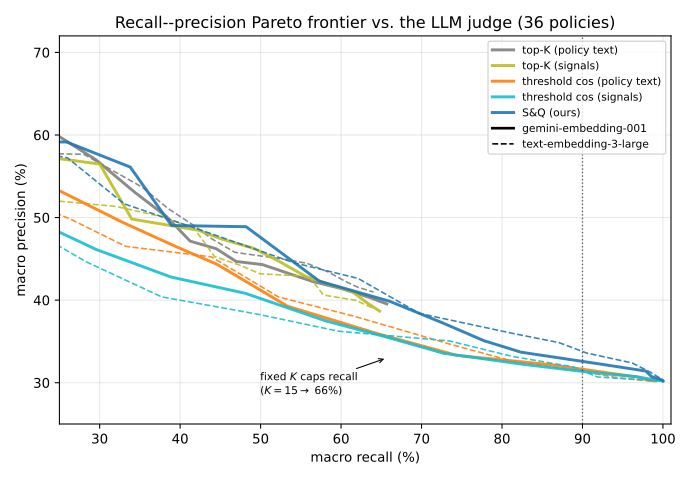
| 2 | 直接命中 | Signals and Queries · arXiv:2610.29326 | 离线为 36 条策略各造 10 正例 10 硬负例,线上一次 embedding 判定 | 93% 召回下精确率 32%,每轮 LLM 调用 36→0 | 只一个客服域、50 段对话,真值是 judge | 官网 · 全文 |
| 1 | 直接命中 | Silent Cue Loss · arXiv:2610.30026 | 把 docx 的颜色与高亮解析成带类型标签,用 OOXML 属性造真值 | micro F1 0.690 对纯文本 0.075;去掉 highlight 值 0.302、colour 0.262 | 任务集只有 84 份文档;PDF 需可用文本层 | 官网 · 全文 |
| 2 | 直接命中 | SearchWeaver · arXiv:2610.29250 | 让 coding agent 改语料工件、工具与说明三件套,按轨迹 reward 迭代 | BCP 71.6%→78.4%、BRIGHT 45.7→55.0;跨模型仍 60.9→73.9 | 优化集 30 题级、无种子;耗时只赢 DCI | 官网 · 全文 |
| 2 | 邻近跟踪 | Scan or Index? · arXiv:2610.28957 | 11 种长文档检索配置,比证据覆盖率、答案质量与外推成本 | 教材 EC@5 混合+Jev 94.1% 对 Jev 全扫描 88.7%;全扫描中位 25 秒 | 两法都完成的 76 题只差 1.7 点 | 官网 · 全文 |
| 2 | 直接命中 | Credit Where Credit Is Due · arXiv:2610.29292 | 用 LLM 归因分当符号信号,搜多智能体图的边 | BigCodeBench 48.0 对 42.7,部署 token 少 54% | 单模型族、3 个种子,标准差重叠 | 官网 · 全文 |
| 1 | 直接命中 | A Strong MoE Is All You Need for Process Supervision · arXiv:2610.29498 | 用 MoE 路由统计当免费步级置信度,做测试时修正与 PRM 标注 | 18/18 设置最优,均分高 1.2–1.9 点 | 只三个 MoE 架构;增益落在种子波动内 | 官网 · 全文 |
| 1 | 邻近跟踪 | Right On Q · arXiv:2610.29378 | 先块级校准,再在自身前缀上做在线蒸馏,逐候选 KL 加权 | 2 比特 8B 均分 70.68 对最强基线 60.42 | 只 Qwen3 一家;对手 PTQ 起点接近崩塌 | 官网 · 全文 |
| 2 | 直接命中 | DynaWeave · arXiv:2610.29443 | 把静态任务改造成带事件 DAG 与动态 verifier 的可验证场景 | 2,095 场景 / 3,414 事件;2B 的 CostBench 3.00%→70.34% | Gaia2 的 Adaptability 子项几乎没动 | 官网 · 全文 |
| 2 | 直接命中 | LongZero · arXiv:2610.30132 | 零外部数据自造长上下文任务,先定答案再扩写,难度过滤后 GRPO | 4B 均分 54.68→57.42,高于 397B 教师合成的 55.99 | 只 1 点级差异且不报方差;同家族两个基座 | 官网 · 全文 |
| 1 | 直接命中 | Evolving with Open Worlds · arXiv:2610.29784 | 取证与预测解耦,用已揭晓结果回写参数、技能与出题技能 | Qwen3.8-Max 上 BT 62.2 居 23 个系统之首;只加技能 Brier 0.135→0.122 | 参数进化 2 轮、技能 3 轮;表与正文格数对不上 | 官网 · 全文 |
| 1 | 直接命中 | Building AI Research Teams · arXiv:2610.28887 | 16 个带学科画像的 AI 研究员用 UCB 选人,80 轮迭代搜架构 | 1.3B 上五项全胜 GDN2(WikiText 15.74 对 16.05) | 只跑一次无误差棒;搜索只在 150M 上做 | 官网 · 全文 |
| 2 | 邻近跟踪 | TrainBridge · arXiv:2610.29171 | 把 GPU eager 与 compiled 的差异当优化意图证据,迁到 NPU 再 profile | 27 条记录平均 1.95 倍;Record 50 从 419.2 秒降到 283.2 秒 | 多数单次运行无方差;只一代 910C | 官网 · 全文 |
| 2 | 直接命中 | Bridging Foundational and Agentic Capabilities · arXiv:2610.29751 | 把基础画像与操作画像分开量,用家族留出残差定位落差 | 基础 Q² 0.382、操作 0.702、两者 0.733 | 只有一个领域;每折训练样本 12–14 个 | 官网 · 全文 |
| 1 | 直接命中 | SANE · arXiv:2610.28886 | 让智能体为每个评分器推导变形测试,三段验证后成族 | 108 条对齐配方、77 个验证族(3.7 倍)、缺陷族 31 对 10 | 两套测试由同一生成模型产出;只在摘要打分上验证 | 官网 · 全文 |
| 2 | 邻近跟踪 | Our Own Jev · arXiv:2610.29052 | 用字母 logits 一次前向做类型化判定,替代 LLM 评委 | 35B 硬档 79.3% 对商业参考 73.0%(校正后 p=0.36) | 单种子;111 题只对约 10 分差异有功效 | 官网 · 全文 |
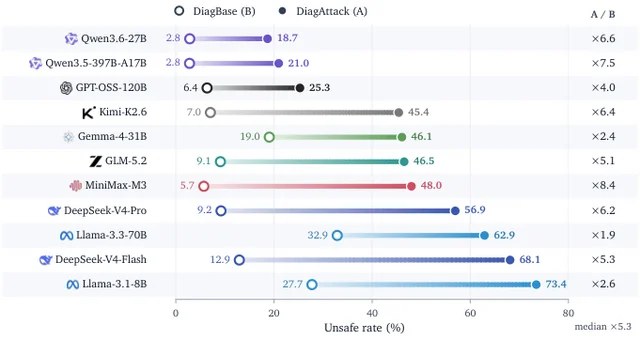
| 2 | 直接命中 | Beyond Binary Labels (DiagSafe) · arXiv:2610.29225 | 每条提示一份 rubric,84 个标签、3,489 条双语提示 | 一致率 95.34%(通用提示 87.29%);指令攻击使不安全率 ×1.9–8.4 | 写 rubric 与主判官同源;金标只有 236 条 | 官网 · 全文 |
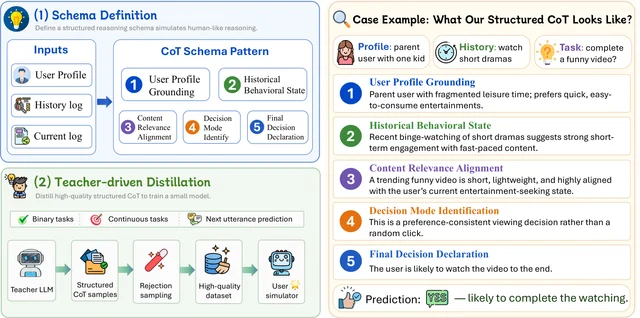
| 2 | 直接命中 | OmniSimulator · arXiv:2610.29472 | 用五维结构化思维链把教师行为轨迹蒸给小模型当用户模拟器 | 8B 平均 30.82→41.40(+34.33%),与 Sonnet-4.5 的 40.49 持平 | 单平台单次训练;9,881 个实例只来自 200 个用户 | 官网 · 全文 |
一、长程任务怎么被判:基准、难度与扰动
这四篇动的都是「题」和「判」,不是模型。P2NPCBench 改的是题面难度,Quant-Arena 改的是评估单位,Environment Duels 让模型互相出题,MOSAIC 把端到端的分数拆到记忆的四段流水线上。
两个方向相反的收数值得并排。Quant-Arena 上 38 组迭代配置里只有 1 组跑赢 17.1% 的等权基准,最高总分 51.29 仍低于作者自研的规则策略 77.56;而 Environment Duels 里出题能力与解题能力的排名几乎不重合——解题第一的 Claude-Opus-5,提示增益只排第 7。
P2NPCBench 的结论更干脆:把 NP-完全侧的限时放宽 10 倍,均值只动 3.4 个百分点。读这一节时,把「在什么预算下、由谁判、判的是哪一类任务」当成必读的三件事。
1. 12 个模型在 NP-完全侧 pass@1 宏平均 35.4% 对多项式侧 63.8%,NP 侧限时放宽 10 倍也只从 28.5% 升到 31.9%
Did the Problem Actually Get Harder? Testing LLMs on Paired P and NP-Complete Problems Hardened by Adversarial Multi-Agent Rewriting · arXiv:2610.30103 · 精读
作者与机构:Nurul Labib Sayeedi(United International University,合著者另属 BRAC University、University of California, Riverside、University of Maryland Baltimore County)
研究问题与核心方法:
要问的是:只改一个结构性细节、把多项式题变成 NP-完全题,模型的正确率会掉多少。
做法:12 个问题族各配一对判据,如 3-着色对 2-着色、3-SAT 对 2-SAT,题面与 I/O 契约一致。
种子题取自 Garey & Johnson 等标准目录,改编成统一竞赛格式,作者逐条手写并核对 24 个参考解。
AgentGAN 里生成器改写题面,4 个冻结代码模型当判别器,解得出就不算改写成功。
可执行校验门要求改写保持答案、类别、边界与 I/O,另有一个面板外模型能解出,避免把题弄坏。
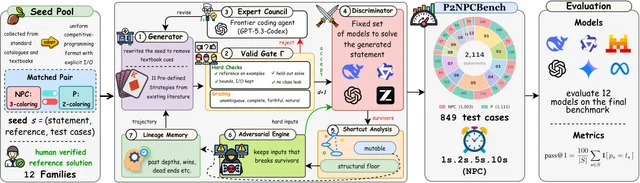
分层抽样 480 条人工复核;2,114 条题按 anchor/corner/worst-case 三层测例判分。 1
关键结果:
- 12 个模型宏平均 pass@1:NPC 35.4% 对 P 63.8%,逐模型差距 9 到 54 个百分点(表 2)。
- 144 个「模型×问题族」格里 137 格(95.1%)在 NPC 侧更低,中位数低 25.5 个百分点,52 格差距超 40 点(图 4 右)。
- 在同一批 NPC 题的限时实验里(1 s→10 s),均值只从 28.5% 升到 31.9%,没有模型涨幅超过 5.1 个百分点(图 4 左)。
- 强化后 NPC 由 61.4% 降到 41.9%(−19.5),P 由 86.0% 降到 56.4%(−29.6),类别差由 24.6 缩到 14.5(图 4 中)。
- 1,348,290 条判分测例里 NPC 失败率 60.9%、P 37.6%;NPC 失败中运行时错误占 44.1%,其中 46.5% 是截断代码导致的语法或缩进错误(§5)。
- 4 个判别器强化后合计 NPC 41.9% 对 P 70.7%;全程未参与流水线的 Kimi K3 是 37% 对 87%,差距 50 点(表 3、§4.1.1)。 1
证据与局限:原文自陈:只覆盖 12 族 P 与 NP-完全题,未测 PSPACE 等类别;题面全英文;只评 Python 3;强化只针对固定 4 模型面板,部分受测模型与面板成员是近亲;同一条 lineage 内题目相关;每模型单次贪心采样;无歧义与忠实性由 LLM 校验器判。我判断:2,114 条题实际出自 1,141 个通过版本、295 条 lineage,同源题目高度相关,独立样本远少于 2,114,逐族比较(尤其 3-D 匹配那 5.2 点小差)应看作同族内的相对量。 1
复现:代码 Apache-2.0、数据 CC BY 4.0,见 https://github.com/Labib1610/complexity-benchmark
与目标研究线的关系:属 A(长程任务的训练与评估),方法上贴着 B:AgentGAN 的「生成—判别—记忆—升级」是一套不更新权重的自进化式难度生成。可直接搬走的是可执行校验门(答案/类别/边界保持 + 面板外模型可解)和 P/NPC 成对题面的对照设计;若要评估自家 agent 的「会不会读结构」,这套配对法比换更难的数据集更干净。
2. 9 个模型 38 组迭代配置里只有 1 组跑赢 17.1% 的等权基准,年化 18.4%
Quant-Arena: Benchmarking LLM Agents for Quantitative Trading Research · arXiv:2610.30113 · 值得扫读
作者与机构:Houde Qian(Navers Lab, Einsia.AI);原文把全部作者排成一行,未逐人标机构,通讯作者邮箱与项目页均指向该实验室
研究问题与核心方法:
要问的是:模型能不能跑完量化研究的一整圈——造特征、写打分、回测、再定一版。
数据是 3,042 只 A 股的 Level-2 逐笔与盘口;研究期 2022–2023,2024 整年封存不回传。
预算:每次运行最多在研究期评估 5 个候选,只回传总收益、信号质量、覆盖率与执行报错。
出分:策略给每日股票打分,取前 75 只等权持有,现金账户按 100 股整手、含模拟盘口估的冲击成本。
评分 S=0.3·Sin+0.7·Sout,其中 Sin=90Q+10D,Q 里已实现超额收益权重 0.6。
对照:9 个模型跑各自支持的推理档,共 38 组迭代配置与 38 组一次性配置。 2
关键结果:
- 唯一跑赢基准的是 GPT-6 Sol 中等推理:2024 年化 18.4%,高于 17.1% 的全市场等权基准(原文记作 +1.4 个百分点,表 2)。
- 38 组迭代里 13 组年化为正;最高总分是 Astra xhigh 的 51.29,仍低于自研策略 Kepler-1 的 77.56(表 2、§3.7)。
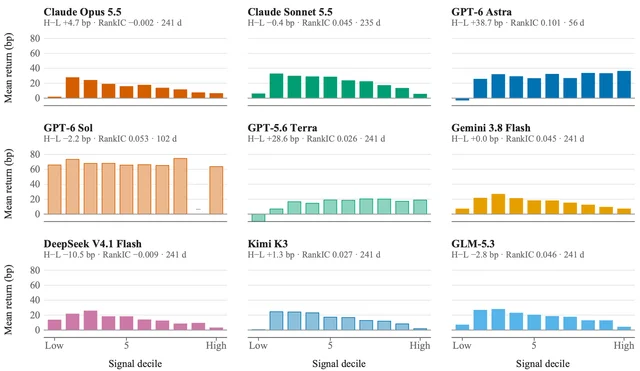
- 分位收益不单调:6 个模型在第 2–3 十分位拿到 24–33 bp/日,最高减最低只有 −10.5 到 +4.7 bp(图 3)。
- 38 组里 RankIC 与年化收益的 Spearman 相关仅 0.09:GLM RankIC 0.046 而年化 −7.8%,Opus medium RankIC −0.002 而年化 +4.4%(§3.3)。
- Astra 的领先来自择时:2024 年 70–75% 交易日持现金,1–2 月最大回撤 −1.7%,同期市场 −29.6%,但它只吃到 2 月低点后反弹的 16%(图 4)。
- 迭代把均分从 36.47 抬到 43.55,可持续收益只在 9 个模型里的 4 个变好,均值 +2.9 个百分点(表 3)。 2
证据与局限:原文未单列局限章节,相关披露散在 §2.3 与 §3.5:2024 是唯一封存年且只评一次,迭代增益主要落在研究期(Sin 均值 +10.36 对 Sout +5.67),且 Sout 的合成规则「每版固定但不公开」。我判断:单一市场、单一年份、单一组合规则(前 75 等权),「跑不赢」与「某一组 +1.4pp」都落在同一个 2024 里,无法区分技能与运气;38 组配置在 9 个模型间并不均衡(GLM 只有 2 档、Terra 6 档),跨模型比较应看同档位而非各自最好。 2
复现:公开榜单与提交入口 [https://lab.[einsia.ai/quant-arena](https://lab.einsia.ai/quant-arena)](https://einsia.ai/quant-arena](https://lab.einsia.ai/quant-arena)) ;数据、评测代码与完整规格原文未提供仓库链接(仅附录表 4 列出协议)。
与目标研究线的关系:属 A(长程任务的训练与评估):它把「整轮研究」当评估单位,用封存年份做留出。可直接搬走三点:候选评估设硬预算(≤5 次)、反馈只给聚合指标、冻结一版代码再上测试集;这套「预算—封存—冻结」的组合对任何会自我迭代的 agent 评测都适用。
站点摘要出入:站点摘要与论文摘要都写「无模型跑赢等权市场」,但表 2 与 §3.2 明确 GPT-6 Sol 中等推理年化 18.4%、超基准 1.4 个百分点,是 38 组里唯一跑赢的一组。
3. 9 个模型互出 90 个环境打 12,960 局,解题第一的 Claude-Opus-5 提示增益只排第 7
Environment Duels: A Microcosm of LLM Co-Evolution · arXiv:2610.30116 · 精读
作者与机构:Shibo Jin(University of Pennsylvania,全部作者同属该校)
研究问题与核心方法:
要问的是:模型既出题又解题时,这两种能力是不是一回事,对局能否预测训练收益。
出题:每个模型在 5 个领域各出 2 个环境,环境是带隐藏状态、奖励和 24 步预算的 Python 类。
配套:作者另写一条「特权提示」,目标是强解题者无提示做不出、有提示做得到。
对局:每环境 4 个种子,9 个解题者在有/无提示两条件下各跑一遍,即 9×90×4×2=6,480 局。
反制:出题人看完他人轨迹后改一版,同一批题再打 6,480 局,合计 12,960 局。
评分:解题率、难度(无提示失败率)、提示增益三轴分开报,不做合成分。 3
关键结果:
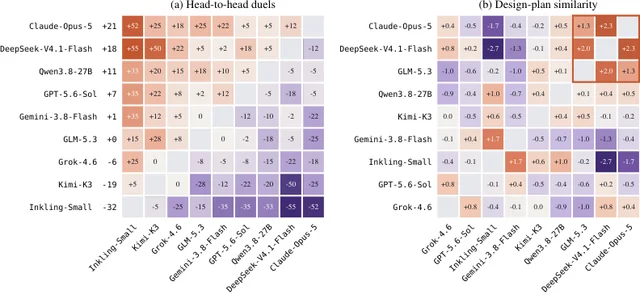
- 解题率从 Claude-Opus-5 的 94.4 一路到 Inkling-Small 的 54.8,排序与公开能力榜基本重合(图 2)。
- 环境难度最高的是 DeepSeek-V4.1-Flash 29.7,其后 Gemini-3.8-Flash 28.3、Qwen3.8-27B 25.4;Opus 24.2 只排第 4(图 2)。
- 提示增益最高是 Qwen3.8-27B 21.2,两个最强解题者 Opus 9.2、Sol 8.3 排在第 7、第 8(图 2)。
- 一轮反制后无提示通过率从 84.9% 降到 78.5%,提示增益从 6.3 升到 13.4 点(§2.2、图 4)。
- 强模型的提示会伤弱模型:顶层作者的提示把底层正确尝试改错 17.7%,其他作者最多 7.7%,而任何提示弄错顶层不超过 3.1%(图 3 右)。
- RL 验证:Qwen3.8-27B 在 4 位作者的 800 个环境上各训一版,提示增益 17.5/10.0/10.0/5.0 对应五榜均值 +2.0/+1.3/+1.1/+0.1(表 2)。 3
证据与局限:原文未单列局限,只有可复现性与伦理声明;我据三点判证据强弱:其一,只有一轮反制,共演化被压成一阶效应;其二,每个环境仅 4 个种子,单格只有 4 次配对,29.7 对 28.3 这类 1.4 点差距不足以支撑排序;其三,RL 部分只训一个学习器(Qwen3.8-27B)、每作者 200 个环境、一个 epoch,学习率 5e-6,指标为五榜均值,跨模型外推要打折扣。难度与增益的「出题人」身份是自评自出,环境是否真的可学只由一次审计兜底。 3
复现:代码 https://github.com/LLM-Duels/EnvDuels ;原文称将放出反制前后的全部环境、设计稿、提示、种子与逐局轨迹。
与目标研究线的关系:属 B(轨迹学习与自进化):出题—解题—反制就是一轮共演化,而且用 RL 把「提示增益」和「训练收益」接上了。可直接搬走的是两个指标口径(难度=无提示失败率,教学质量=提示增益)与「给作者三对配对轨迹、只反制一轮」的低成本迭代法;这比让模型自由自我批评更容易复现。
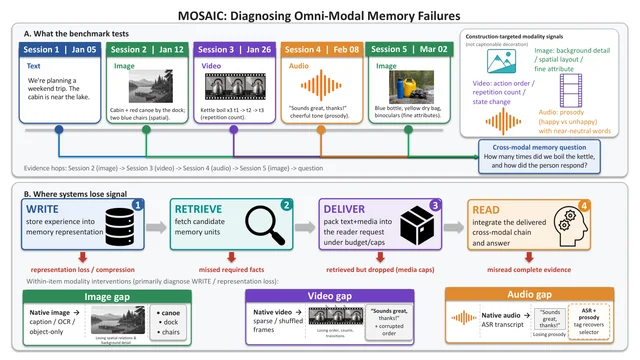
4. 923 道题在冻结读者下:原生视频证据比金标符号事实低 17.1 分,音频只低 0.5 分
MOSAIC: An Omni-Modal Benchmark for Long-Term Memory and Cross-Modal Reasoning in Conversational Agents · arXiv:2610.29249 · 值得扫读
作者与机构:Hong Ting Tsang(The Hong Kong University of Science and Technology;合著者含 University of Edinburgh)
研究问题与核心方法:
要问的是:多模态长期记忆的失败落在写、取、送、读哪一步,而非只报一个端到端分。
数据:70 个人设、每人 11–24 段会话(均值 17.5),923 题 = 784 可答 + 139 拒答,媒体 10,765 件。
造题:每条链由 Narrower / Selector / Answer 三种事实组成,删掉任一必需事实题就不可答。
信号按原生模态布置:图像考背景、细粒度属性、空间构型;视频考动作顺序、重复次数、状态变化;音频考韵律。
诊断:冻结同一读者、提示、打包器与预算,只替换表示、检索或投递,做七种条件的配对比。
判分为 0–1 语义分,检索与投递另看必需事实与完整链的 Recall@k。 4
关键结果:
- 金标符号事实 0.846,换原生证据 0.783(感知成本 6.2 分),换通用字幕/ASR 0.690(文本化损失 9.3 分)(表 3)。
- 感知成本随模态分化:视频 0.900→0.729(17.1 分),图像 0.847→0.785(6.2 分),音频 0.821→0.826(−0.5 分)(表 3)。
- 检索再掉 7.6 分(0.783→0.708,全投递),生产打包再掉 3.8 分(0.708→0.670),完整链投递从 0.675 掉到 0.491(表 3)。
- 投递预算扫描:检索固定 Recall@50=0.871,单元预算减半掉 5.7 分,每模态只留一条媒体再掉 17.7 分、完整链跌到 0.184(图 4)。
- 空间构型上原始图比 OCR 文本高 32.0 分,加空间描述比只列物体高 15.4 分,只补回 43.3 分缺口的三分之一(§6.2)。
- 固定读者下 A-MEM 字幕版 0.684,高于扁平 RAG 字幕版 0.522 与原生多模态索引 0.641,后者完整链覆盖只有 0.466(表 4)。 4
证据与局限:原文自陈:人设、会话与媒体全为合成;阶段标签是匹配协议下的关联,不是完全隔离的机制;视频对比样本小(n=56–64),80% 功效下最小可检效应 8.9–11.2 分;原始音频对 ASR 在该读者上不显著;拒答控制保留了问句形式线索。我判断:主读者只有 Gemini 3.5 一个(第二读者 MiMo-V2.5 只在 120 题试点,且大载荷会超时),所以 15.4 分「读不懂」的余量里混着输出格式与判分误差;784 可答题中 44 条是从探针拒答里救回的,这批在金标原生证据下比探针通过题低 27.8 分,绝对值偏乐观。 4
复现:代码 https://github.com/HKUST-KnowComp/MOSAIC ,数据 https://huggingface.co/datasets/gzone0111/MOSAIC ,项目页 [https://hkust-[knowcomp.github.io/MOSAIC/](https://hkust-knowcomp.github.io/MOSAIC/)](https://knowcomp.github.io/MOSAIC/](https://hkust-knowcomp.github.io/MOSAIC/))
与目标研究线的关系:属 A(长程任务的训练与评估):多会话、跨模态的长程记忆,评估单位是「一笔记忆的全生命周期」。可直接搬走的是「冻结读者 + 逐阶段替换」的消融协议,以及投递预算曲线这个常被检索指标掩盖的环节——很多系统不是没检索到,而是被媒体条数上限挤掉了。
二、智能体记忆:构建与检索能不能一起学
四篇给出四种相反的答案:把记忆当持续学习问题、把构建与检索放进同一个在线策略、把建库成本算进每一次 rollout、把状态变化连回原始证据。
读完这四篇,可以把「记忆到底省了什么、花了什么」拆成三笔账:检索时的读取预算、建库与维护的固定成本、以及记忆占位对上下文的挤压。三笔账里最容易被漏掉的是第一笔——读取预算不够时,存得再多也取不出来。
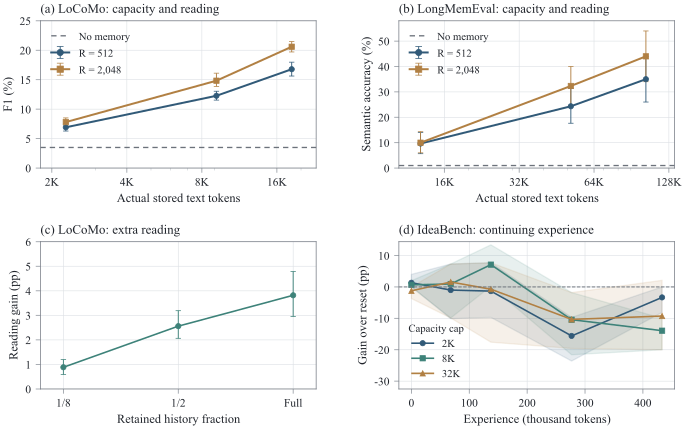
5. 同一份 Mem0 记忆在 IdeaBench 上从 +7.10 个点跌到 −13.93 个点:记忆不是免费增益
Memory-Centric Continual Learning for AI Agents · arXiv:2610.29357 · 值得扫读
作者与机构:Dongfang Li(哈尔滨工业大学(深圳)、Shenzhen Loop Area Institute),通讯作者 Baotian Hu;合作单位含清华大学、东南大学、中国电信星辰 AGI Lab、华为
研究问题与核心方法:问题是外部记忆多被当成被动检索缓存,评测只看能不能回忆旧事实。作者主张改判标准:记忆是否改善后续行动。
第一步是三轴分类。存储位置分上下文、激活、外部可寻址、可适应参数四类;形态分情节、语义、程序;管理分预设、审议、学习。
第二步把生命周期写成双环。内环 M←T(M,e;π) 写入经验;外环 π←U(π,F) 用后续任务反馈改管理策略。
第三步给评估协议。保留度按四道门查:存下、取到、用上、有效;再用同任务的有状态与重置对照 ΔP 扣掉上下文变长的收益。
第四步给缩放框架。非参数侧用经验、容量、读取、维护四个资源项;参数侧再加 ρ=I(E)/(κM) 的干扰项,κ 取 2 bit/参数。 5
关键结果:
- LoCoMo 上把读取预算从 512 提到 2,048 token,Raw RAG 的 F1 在保留 1/8 历史时 +0.89 个百分点、全量保留时 +3.82,两者配对差 2.93(95% 区间 [2.06, 4.02]),见正文与图 8(c)。
- 同一改动在 LongMemEval 抽样上把全历史 Raw RAG 的语义准确率从 35.00% 提到 44.00%,见正文与图 8(b)。
- Mem0 的有状态−重置增益在 IdeaBench 上非单调:64 段训练对话后 +7.10 个百分点,128 段后 −10.43,256 段后 −13.93(8,192 token 上限、R=1,024);合并三种训练顺序为 +3.18 / −10.38 / −11.60,见图 8(d)。
- 三种读法(全读、检索、检索+摘要)在 9 段 LoCoMo、180 题上 F1 为 4.63 / 4.29 / 3.91,输入 token 729.78 / 225.68 / 43.52,中位延迟 0.154 / 0.154 / 0.367 秒;摘要比全读低 0.72 个百分点(区间 [−1.14, −0.27]),见表 4。
- 每 16 或 64 段对话固化一次,把最终占用从 3,858 token 压到约 1,800,但末端增益仍为负,见正文。
- 转引的参数记忆证据:Memory+ 的 value 从 1M 增到 64M,NaturalQuestions 13.68→20.78、TriviaQA F1 42.89→62.14,同配置无记忆层为 7.76 / 32.64;16M→64M 区间 NQ 只 +0.64、TriviaQA 仍 +3.47,见图 12(a)(作者注明取自原文、未拟合)。 5
证据与局限:原文未单列局限。判断依据:第 4.3 节的缩放律原文写的是 “hypothesize”,图 7/9/10/11 用预设函数(如 0.6·b^−0.55 + 0.4·r^−0.75、ρ*=3 与 300)绘制,属示意不是拟合;自测只有图 8 与表 4,且固定在单一骨干 Qwen3-30B-A3B-Instruct-2507 与 Mem0 0.1.94 一个实现上。表 4 的 LoCoMo F1 只有 3.91–4.63,说明其评分配置与常见 LoCoMo F1 口径不同,跨论文比数字要先对齐口径。 5
复现:原文未提供代码或数据链接(全文无仓库地址)。
与目标研究线的关系:属 A 长程任务的训练与评估,兼 B 轨迹学习。可直接搬走的是评估侧:四道门式的保留度检查,以及 ΔP 有状态/重置对照,用来把手头的记忆或技能库增益从“上下文变长”里剥出来;缩放律的 E/B/R/U 四个资源项可直接当成本-性能记账表。外环策略演化只是框架提法,原文没有实现。
6. Uni-Mem 在 LoCoMo 上总体 88.80%,比最强 RL 记忆基线高 10.93 个百分点
Uni-Mem: Learning a Long-Horizon Agentic Memory Manager with Unified Online Policy Optimization · arXiv:2610.29671 · 精读
作者与机构:Zhiqian Xia(东南大学、华为诺亚方舟实验室,实习期间完成),共同一作 Jielong Tang;通讯作者 Haifeng Xia(中山大学)
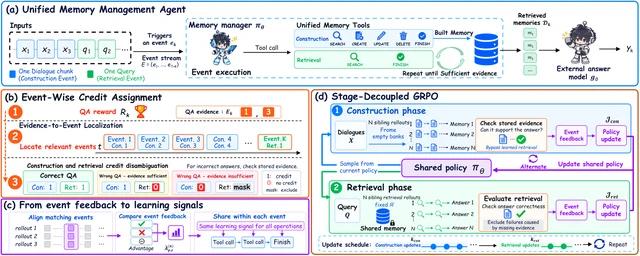
研究问题与核心方法:现有记忆管理器只训一半:要么只训构造、检索写死,要么检索在线 RL 而构造靠离线模仿。作者要让一个共享策略把两端一起在线训。
做法一是把记忆管理写成事件流。对话块触发构造事件,query 触发检索事件,策略在事件内多轮调工具改记忆库。
难点一:两阶段同时变,组内相对优势分不清谁有功。解耦做法是构造轮换从空库建、绕开学到的检索,用证据索引打分。
难点二:一次 rollout 上百次调用,奖励只在答题时给一次。ECA 按标注证据把奖励落到事件,再广播给事件内所有调用。
训练先 SFT 冷启动,再按 κ=(C,R) 交替做构造与检索更新。管理器是 Qwen3-4B,答案模型是 GPT-OSS-120B。 6
关键结果:
- LoCoMo 总体(LLM 判分)88.80%,比最强基线 Memory-R2 (OSS) 的 77.87% 高 10.93 个百分点,比 Mem-T 的 76.49% 高 12.31 个百分点,见表 1。
- 分题型:multi-hop 87.06 对 74.13(+12.93),temporal 86.08 对 76.79(+9.29),四个题型全部第一,见表 1。
- 去掉 SFT 冷启动仍有 80.99%,比最强基线高 3.12 个百分点,见表 1。
- 消融:加 ECA 总体 +1.29(无 SFT)/ +3.03(有 SFT);把 GRPO 换成阶段解耦再 +2.48(无 SFT),其中 temporal 从 55.27 升到 65.82,见表 2。
- 构造与检索交叉:固定检索策略、换上训练后的记忆库 +8.18;固定记忆库、换上训练后的检索策略 +4.50;两者都换得 88.80,见表 3。
- 管理器规模与交替粒度:训练后的 4B 管理器 88.80% 高于现成 Qwen3.5-27B 的 87.05% 与 Qwen3.5-397B-A17B 的 85.86%;交替粒度从 1:1 改 32:32 掉到 83.75%,1:8 与 8:1 分别掉 4.32 与 2.85,见图 4。 6
证据与局限:原文自陈的局限只有训练成本:奖励要跑完整下游 QA 并调裁判模型,依赖外部 API 或更强模型,作者建议异步 RL 缓解延迟。我的判断:LoCoMo 按 2:1:7 切成训练/验证/测试,LongMemEval 只作分布外验证且正文只给类别级曲线、没给该基准的精确数字表;更要紧的是裁判口径——附录表 8 显示同一批 checkpoint 在原裁判下是 80.93 / 87.10,在 Mem0 口径裁判下变成 71.26 / 77.87,差 9.73 与 9.23 个百分点,所以表 1 里未重评的基线只能当参考。 6
复现:原文未提供代码或数据链接;训练配置给全了:SFT 学习率 1e-5、3 个 epoch、8 卡全局 batch 8、4,257 次优化步,RL 学习率 2e-6、每任务 8 条 rollout、task batch 2、200 个 epoch、最大序列 16,384 token。
与目标研究线的关系:属 B 轨迹学习与自进化。可直接搬走的是信用分配那一层:把“长程轨迹里哪一步该得奖励”落成事件级优势,并用交替更新避免两个子能力互相稀释;A 线也能借它的交叉表(固定库换策略、固定策略换库)来拆增益到底来自存储还是检索。
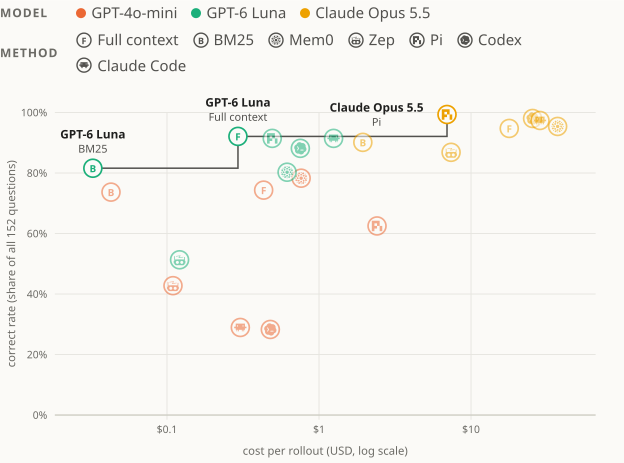
7. 一段 419 轮对话上,Pi 配 Claude Opus 5.5 用 $6.95 拿到 99%,全上下文要 $17.84 才 95%
MemoryTax: The Bitter Lesson of Agent Memory · arXiv:2610.29823 · 值得扫读
作者与机构:Zedong Peng(上海交通大学)
研究问题与核心方法:问题是模型自己会搜之后,预建的记忆系统还值不值。作者把建库成本也算进每一次 rollout,而不只比准确率。
4 种记忆方法(全上下文、BM25、Mem0、Zep)加 3 个编码智能体。各配 3 个模型,7×3 共 21 格。
每格只跑一次,152 道题逐题记成本。成本按标价算所有模型调用,含建库、不含裁判;对错由 GPT-4o-mini 判。
再做一个交叉。检索不调语言模型,所以写库与读库能换不同模型,看强读者能否补上弱写者漏掉的。 7
关键结果:
- GPT-4o-mini 上 Mem0 78% 最高,全上下文与 BM25 各 74%,Zep 43%,三个智能体 Pi/Codex/Claude Code 为 63/28/29,见表 2。
- GPT-6 Luna 上全上下文 92% 反超 Mem0 的 80%,BM25 82%,Zep 51%,见表 2。
- Claude Opus 5.5 上 Mem0 与全上下文同为 95%,Zep 87%,Pi 99%、Codex 98%、Claude Code 97%,见表 2。
- 建库成本:Mem0 为 $0.56 / $0.45 / $25.88,同模型全上下文整轮是 $0.43 / $0.29 / $17.84;按每题差价要 372 / 545 / 596 题才回本,而 LoCoMo 只问 152 题,见图 2。
- Pi+Opus 5.5 每题约 10,000 输入 token(7,900 命中缓存),全上下文 28,900;Codex 与 Claude Code 在 $25.41 与 $28.41 上得 98% 与 97%,见表 2 与第 5 节。
- 写者决定上限:Zep 用 GPT-4o-mini 写的图,三个读者 43 / 43 / 45;用 Opus 写的图 66 / 71 / 87,见表 3。 7
证据与局限:原文自陈五条局限:只用了 LoCoMo 十段对话里的一段、每格只跑一次;GPT-4o-mini 裁判口径宽松且至少有一个答案键是错的;智能体能读照片说明而记忆方法读不到;历史装得进所有模型上下文,全上下文始终可选;Mem0 与 Zep 用默认配置、成本按标价。我的判断:21 格 × 152 题、每格一次运行,几道题的差距撑不住结论,作者自己也对最强主张做了拆解——Pi 比全上下文多答对的 7 道里 6 道的证据落在带照片的轮次,去掉照片题的 88 题上 Pi 100%、全上下文 99%,只差 1 题,所以原文明确说“搜索是否比通读答得更多”这件事它没有结论。 7
复现:交互版 zedongpeng.com/memorytax;代码与数据原文未提供。版本与配置都写了:Mem0 OSS 2.1.0(k=200、无 rerank)、Zep Graphiti OSS 0.30.2(Kuzu、top-20 边)、Pi 1.1.0、Codex 0.159.2、Claude Code 2.1.295。
与目标研究线的关系:属 A 长程任务的训练与评估。可直接搬走的是评估方法论:按整轮 rollout 而不是按 token 记成本、writer/reader 交叉来测记忆上限、留出一组“双方输入相同”的子集做干净对照——这三件事能防止把“模型更强”记成“记忆更好”。
8. MHG-Mem 在三个骨干上平均判分 57.98 / 67.95 / 73.28,比各自最强基线高 8.20–9.98 个百分点
Remembering Through Change: Provenance-Preserving Hypergraph Memory for Multimodal Agents · arXiv:2610.29995 · 值得扫读
作者与机构:Jielong Tang(中山大学、华为诺亚方舟实验室),通讯作者 Jian Yin(中山大学);合作单位含山东师范大学、东南大学
研究问题与核心方法:问题是多模态长期记忆两头难:把图压成文字会丢细节,只留原图又不知道哪几张是同一个实体。作者要两者都要,还要能倒查证据。
结构是三层节点加三类超边。事实、实体、演化三层分别存观察、提及与属性变化;三类超边各管绑身份、连共现、连证据。
构造三步。VLM 抽事实并挂图像 id 与来源;提及按文本加区域相似度在 top-K 里选加、改或跳过;最后按时间串成演化链。
检索是 agentic search。控制器先选入口层,再跨超边遍历,需要时回看原图原话,最后拼成证据链。 8
关键结果:
- 三个骨干上的 Avg. Judge 为 57.98 / 67.95 / 73.28,各自最强基线是 SRAG 49.78、UniversalRAG 58.06、UniversalRAG 63.30,差 8.20 / 9.89 / 9.98 个百分点,见表 1。
- MemEye 上 Qwen3.8-27B 的 EM 为 78.76,对 UniversalRAG 的 67.85 与 SRAG 的 66.95,见表 1。
- 19 个细粒度任务里 17 个最好;WorldMemArena-S 的 temporal reasoning 从 48% 升到 87%,DU/TTL/CMR 各 +17/+17/+15,Mem-Gallery 的 VR +18、TR +17,见图 3(b)。
- 记忆侧消融(Avg. Judge):62.87 → 加实体层与出现超边 68.35(+5.48,其中超边本身 4.78)→ 加演化层 71.72(+3.37)→ 加证据超边 73.28(+1.56),见表 2。
- 检索侧消融:去掉 agentic search 掉 5.10,去掉 inspection 掉 3.44,去掉跨层遍历掉 3.09,去掉视觉工具掉 1.37,见表 3。
- 代价:比同骨干基线平均多用约 2 倍 token;把 agentic search 换成 top-k 只多 1–2k token,仍保 5%–15% 增益,见附录 D.2 与图 6。 8
证据与局限:原文未单列局限(正文以 Conclusion 收尾,没有 Limitations 段)。判断依据:三个基准、三个骨干,主表 27 条(9 个系统 × 3 个骨干)、每条 3 次运行平均,规模够;但八条基线全部由作者在同一环境重跑,没有并列原作者报告值,缺独立复算。WorldMemArena 只取公开的 150 样本子集(7,906 题),MemEye 371 题、Mem-Gallery 1,711 题,三基准合计 9,988 题;另外 agentic search 要 2 倍 token 这件事被放在附录,主结论用的是判分而不是成本。 8
复现:原文未提供代码或数据链接。实现细节给了:Qwen3-VL-8B / GPT-4.1-mini / Qwen3.8-27B 作记忆骨干,GPT-5.4-mini 作裁判,文本嵌入 all-MiniLM-L6-v2,视觉与跨模态嵌入 SigLIP2,结果取 3 次运行平均。
与目标研究线的关系:属 B 轨迹学习与自进化。可直接搬走的是记忆的“溯源”设计:把每次状态变化单独成节点并连回支撑事实与原图,检索时先拿压缩态定位、再回原图核验——这套结构对任何带截图或录屏的长程 agent 轨迹都适用;A 线还能借它的记忆质量指标(recall、correctness、retrieval coverage)作为中间诊断量。
三、上下文与接口:省 token 与省错
四篇分别从输入端、检索端与接口层省钱或省错。
最容易被忽略的是第二篇:格式在进入上下文之前就先掉了一层信息,而这条损失不体现在任何监控指标上——不报错、不缺字段、token 数也正常。第三篇则反过来,把可被改写的对象从提示词扩到语料工件、工具与使用说明,让 agent 自己重设计搜索接口。
9. 36 条策略一次 embedding 就筛完:93% 召回下精确率 32%,每轮 LLM 调用从 36 次降到 0
Signals and Queries: Token-Efficient Agentic Context Discovery · arXiv:2610.29326 · 值得扫读
作者与机构:Yam Marcovitz(原文只署 yam@parlant.io,正文说明方法随 Parlant 4.0 发布,未单列机构行;单作者)
研究问题与核心方法:
客服智能体每轮要在几十条行为策略里挑出当下该生效的那几条。逐条问 LLM 太贵:36 条策略一轮就是 36 次调用、约 6.9 万 prompt token。
全部 LLM 工作被挪到离线。对每条策略,让 LLM 只读策略文本、不看任何对话,生成 10 条"应该激活它"的用户话术。
同时生成 10 条硬负例——同一话题圈里、但该由邻近策略管的近似句("改签"之于"取消")。负例是这套方法的关键,不是附赠品。
样例向量先减去全库质心(抵消 embedding 各向异性),再为每条策略单独拟合一个逻辑回归。36 个分类器互不依赖,改一条只重训一个,约 2 ms。
线上每轮只算一次 embedding,对 36 条策略分别取"整段对话"与"单轮用户消息"两个视图的最大点积。超过全局阈值 θ 就把该策略送进下游。
θ 取负值(Gemini −0.45、OpenAI −0.40),因为真实对话得分系统性低于生成的干净样例——这是原文自己标出的 domain shift。 9
关键结果:
- Table 2:在 macro recall ≥90% 的约束下,S&Q 在 Gemini 上为 93% 召回 / 32% 精确率、在 OpenAI 上为 91% / 34%;同条件 top-K(取 K=15)只有 66% / 40% 与 64% / 41%,余弦阈值两族为 93% / 31%、91% / 31%。
- Fig. 3 与 Table 2 合看:优势并不均匀——对 OpenAI 的余弦阈值高 3 个点(34 对 31),对 Gemini 只高 1 个点(32 对 31)。
- Table 5:在同一本地 all-MiniLM-L6-v2 上,冻结编码器加逻辑头得 91% / 32%,反高于 SetFit 微调的 90% / 31%,说明瓶颈不在编码器。
- Table 6:每轮成本从 36 次 LLM 调用、约 69,000 prompt token,降到 0 次调用 + 1 次 embedding + 37 μs CPU;离线只需 2N=72 次生成调用与 80 ms 训练。
- Table 4:把两段不同话题的对话拼成一段后,在 30% 假阳率下累加视图对"后话题"策略的召回是 58%(Gemini)/ 55%(OpenAI),逐轮取最大为 70% / 74%,差 12 与 19 个点。
- Table 7 与 Fig. 8:把生成样例换成从一半对话里挖出的样例后,P@R90 从 33.9% 升到 43.5%(Gemini)、35.3% 升到 41.6%(OpenAI);其中挖出的负例贡献 +9.2 与 +7.8,只换正例则只有 +0.5 与 −1.5。 9
证据与局限:原文自陈:只测航空客服一个域、50 段 τ²-bench 模拟对话;36 条策略中有 5 条从未出现、未评估;真值是 LLM judge(gemini-3.1-flash-lite)而非人工,且未报告与人工标注的一致性;全局 θ 是在本基准上选的,不是从策略库推出来的;recall-first 意味着精确率只有三成左右,只适合当前置过滤器;长对话里检索集"只增不减"的问题原文明确说"未建模也未评测"。我另外注意两点:§5 的 held-out 只有 131 个 sub-sequence,作者自己也把那些数字标成"方向与量级"而非点估计;摘要说"至少移除 30% 候选",正文没有逐轮保留量统计,只能从 Table 2 的 32% 精确率间接印证,引用这句话时最好别当成逐轮实测值。 9
复现:方法已并入 Parlant 4.0(https://github.com/emcie-co/parlant);36 条策略清单、254 个对话前缀与 9,144 条 judge 标签未在正文给出下载地址。
与目标研究线的关系:主要落在 A(多轮任务里每一轮该给模型看什么),方法形态属 B 的轻量自进化回路——用线上真实漏检的对话挖样例、只重训一条分类器、一次 2 ms。可直接搬走的是"10 条正例 + 10 条硬负例 + 每策略一个逻辑回归"这个前置过滤器,以及一条消融结论:去掉负例是最大回退(AUPRC 0.471→0.423),换分类器、换编码器、上微调都不动。若你的 agent 现在每轮让 LLM 逐条判"这条规则适不适用",这里是同精度区间内便宜得多的替代。
10. 格式一丢,micro F1 从 0.690 掉到 0.150:颜色和高亮两类线索承担了几乎全部损失
What the Author Wrote, What the Agent Reads: Silent Cue Loss in Enterprise Document Ingestion · arXiv:2610.30026 · 精读
作者与机构:Yikai Zhao、Saurabh Pandey、Pradeep Kumar Misra,三人均属 Amazon
研究问题与核心方法:
企业文档里,作者用红字、高亮标出"必须照做"的条款。转换器把字留下了,把"这条被标红了"丢了,而管线仍然报告成功。
任务是从真实政策文档里列出"作者特别标出的要求"。真值直接取 OOXML 的 run 属性,不经过任何判断。
语料是 6,462 份真实 .docx。其中 32.8% 带红字或非白高亮,10.3% 标在含义务模态词的句子上。
从中筛出 84 份做任务集:332 条标记要求、4,192 条未标记干扰句;单次运行按配对计分 76–79 份。
解析器给每段同格式文本记 12 个属性,再按 11 条高置信规则贴语义角色:红字或红高亮→critical_warning,其他可见高亮→warning,删除线→deprecated。
输出是 Markdown 加自定义标签的混合体:
[HIGHLIGHT:YELLOW] 保留原样,角色标签则直接告诉模型"这是警告、不是装饰"。判分是确定性的词面匹配:答案里出现连续 4 个内容词即算命中,全程没有 LLM judge。 10
关键结果:
- Table 1 上栏(6 臂 × 76 文档 × 3 次重复 = 1,368 次调用):ours micro F1 0.690、精确率 0.824,docling 0.150,纯文本 0.075;逐文档 macro F1 差为 +0.578 与 +0.689(p<10⁻⁴,分别 57/76 与 62/76 份文档取胜)。
- Table 1:最强保留型基线 docx2python 得 0.586,与 ours 差 +0.110(p_Holm=0.022);未标记要求上的假阳率 ours 0.011、docling 0.043、纯文本 0.005。
- Fig. 1:逐类线索做 span 级 leave-one-out,highlight 值 +0.302、colour 值 +0.262(p_Holm 分别 <10⁻⁵ 与 2×10⁻⁵),bold、italic、monospace、strikethrough 全在 ±0.003 内且区间跨零。
- §4.3:移除 colour 使 colour 文档从 0.699 掉到 0.214、highlight 文档不动(0.694);移除 highlight 则 0.659→0.128、colour 文档 0.670——损伤只落在用该类线索的文档上,别处至多动 0.011。
- Table 1 下栏(预注册,79 文档 × 6 次重复):内容与线索标记完全相同、只差是否附上类型标签,typed 比 untyped 高 +0.085(13/4/62,CI [+0.035, +0.145],p_Holm=0.049)。
- Table 2(Microsoft OCB Word 轨,326 题 / 59 文档):全项 0.959,docx2python 0.810、docling 0.720;formatting 子集 0.816 对 0.750。 10
证据与局限:原文自陈:PDF 需可用文本层、不做 OCR;typed 层在 6 个模型里只在 3 个上显著、5 个上为正,两个"几乎不尝试任务"的模型上无收益(Sonnet 5 召回 0.09、精确率 0.96);标签由 run 属性自动派生,只用渲染页图做独立模态校验(κ=0.72),还没有人工标注;任务 recall 0.60 未饱和;本表示约为纯文本两倍 token;绝对 F1 在配置间波动约 ±0.08。我的判断:84 份文档里只有 76–79 份进计分,任务集比 6,462 份的语料小两个量级,所以"32.8% 的文档带线索"是语料统计而非任务集性质;另外 32.8%(任意位置)、10.3%(标在义务句上)、5.6%(run 级更严口径)是三个口径,附录 S1 明说了,别拿 32.8% 当"风险条款占比"。还有一处前后不一致:摘要写 6,460 份,§4.1 与 Table 7 写 6,462 份。 10
复现:原文称脚本、题目集、逐文档内容哈希与原始结果 JSON 随论文提供,但正文没给链接;语料按内容 SHA-256 命名,可自行核对;外部基准用 Microsoft OCB(https://huggingface.co/datasets/microsoft/OfficeComprehensionBenchmark ,CDLA-Permissive-2.0)。
与目标研究线的关系:属 A 的输入侧——长文档在进入上下文之前就先掉了一层信息,而这条损失不体现在任何监控指标上(不报错、不缺字段、token 数正常)。可直接搬走两件事:把颜色与高亮解析成带类型的语义标签,而不是只把原文连同
#FF0000 一起塞进去(后者比前者少 0.085 F1);以及用 OOXML run 属性造 ground truth、完全绕开 LLM judge 的评测做法,代价是需要一份可解析的源文件而不是导出后的纯文本。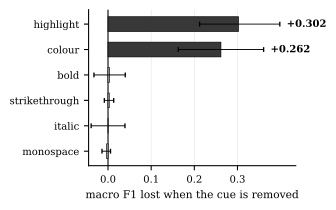
11. 让 agent 自己改搜索接口:BrowseComp-Plus 准确率 71.6%→78.4%,BRIGHT nDCG@10 45.7→55.0
Let Agents Design How They Search: Automatic Interface Optimization for Agentic Search · arXiv:2610.29250 · 值得扫读
作者与机构:Sangjune An(高丽大学,与 Jaeyoon Jung、Yumin Choi 在原文标注同等贡献);KAIST 与高丽大学合作,通讯作者 Hae Beom Lee(高丽大学),Sung Ju Hwang 在 KAIST
研究问题与核心方法:
同一套语料,搜索接口不同,agent 能拿到的证据就不同。现有做法(RAG、DCI、RISE、DR-DCI)都把手写接口套到所有语料上。
要优化的对象是三件东西:语料工件(标题索引、话题目录)、可执行工具、以及给 agent 的使用说明。三者必须一起改,工具改了说明就得跟着改。
优化器本身是一个 coding agent(Claude Opus 5.5)。它读语料、读上一版接口、读搜索 agent 的全量执行轨迹与逐题 reward,然后重写这三件。
每轮只提交 1 个候选接口,跑 10 轮;取优化集上平均 reward 最高的一版,再到从未进过反馈的测试集上评。
搜索 agent 固定为 GPT-5.4-nano,每题上限 300 轮、30 分钟。优化集:BCP 30 题;BRIGHT 四子集共 213 题(52+58+52+51)。
语料是 DCI-Agent-Lite 的文件系统版本。可用检索资源:BCP 上 BM25 加 Qwen3-Embedding-4B,BRIGHT 上 BM25 加已发布的 ReasonEmbed 排序。 11
关键结果:
- Table 1(GPT-5.4-nano):BCP 准确率 71.6%→78.4%(对 DCI);BRIGHT 四子集均值 nDCG@10 45.7→55.0,逐子集 Bio 61.6→74.6、Earth 51.5→64.6、Econ 31.3→38.3、Rob 38.2→42.4。
- Table 2:只改说明的 Prompt Optimization 得 BCP 75.6、BRIGHT 52.0;把生成的工件与工具连同用法说明一起删掉后掉到 72.5 / 48.7,比只改说明还低。
- Table 2:Economics 上 SearchWeaver 反而输给 Prompt Optimization(38.3 对 41.8),是四个子集里唯一一处。
- Table 3 与 Table 5:换成 Gemini 3.5 Flash-Lite、不重新优化,BCP 60.9→73.9、BRIGHT 50.7→58.8,工具耗时 23.1→15.5 s;四个子集全为正(Bio 63.1→75.2、Earth 55.7→66.0、Econ 38.5→45.1、Rob 45.6→48.6)。
- §3.2 与 Table 4:工具执行时间 BCP 42.4→32.9 s(−22%)、BRIGHT 63.2→36.6 s(−42%);但 Earth Science 子集自己仍是 63.5 s,DR-DCI 为 9.8 s、RISE 为 2.2 s。
- Table 1:DR-DCI 在 BCP 上优于 DCI(73.1 对 71.6)、在 BRIGHT 上劣于 DCI(42.1 对 45.7),说明"哪种接口更好"确实随语料变。 11
证据与局限:原文只列了一条局限:接口是对固定语料优化的,文档增改之后是否需要重跑整个流程、能否增量维护,未研究。我另外看到三处该自己掂量的地方:优化集很小(BCP 30 题、BRIGHT 每个子集约 52 题)且每语料只跑 10 轮 × 1 个候选,没有种子与重复,Table 1 的差没有置信区间;四个 BRIGHT 子集各写一套接口,等于每个子集五十来道题上做十轮设计搜索,Economics 与 Robotics 的增益(+7.0、+4.2)明显小于 Bio 与 Earth(+13.0、+13.1),更像没调透;工具耗时只赢 DCI,输给 RISE(BRIGHT 1.9 s)、DR-DCI(11.2 s)、BM25(0.4 s)一到两个量级,"更省时"这句只在 DCI 这个对照下成立。 11
复现:原文未提供(没有代码或数据链接);起点 DCI-Agent-Lite 与两个基线 RISE、DR-DCI 均使用各自已发布的 harness 与设置。
与目标研究线的关系:B(轨迹学习与自进化)最直接的一篇——可被改写的对象从 prompt 扩到"语料工件 + 工具 + 说明",学习信号是执行轨迹加逐题 reward,不需要人工反馈。可直接搬走的是这个三件套的设计空间与"1 候选/轮、10 轮"的预算刻度,以及一条可复用的判据:把工件与工具删掉后如果掉回甚至低于只改 prompt,就说明增益来自接口而不是措辞。跨模型复用(在 GPT-5.4-nano 上优化、Gemini 3.5 Flash-Lite 上直接用)说明接口里存的那部分知识至少有一部分与模型无关,这对"一次优化多处部署"是正面证据。
12. 教材上混合检索的证据覆盖 94.1%、全扫描只有 88.7%:候选池的覆盖面比「是否扫全书」更决定结果
Scan or Index? Evidence Coverage, Answer Quality, and Cost in Long-Document RAG · arXiv:2610.28957 · 值得扫读
作者与机构:Juan Terven(CICATA Qro., Instituto Politécnico Nacional, México),与 Diana-Margarita Córdova-Esparza 等共 8 人,机构含墨西哥 IPN 两个校区、克雷塔罗自治大学、哥伦比亚 Unisangil 与 UDI
研究问题与核心方法:
问题很直白:把整本书每个段落都读一遍,比只从索引里取前几段更能保住证据吗?
语料两套。QASPER 396 题(320 可答 / 76 不可答,来自 264 篇文章),有人工参考答案;教材是 8 本 OpenStax 全书、80 题,每本 4 事实 + 3 解释 + 3 跨节。
所有方法共用切分:约 500 token、75 token 重叠、最多返回 5 段,最后塞进 2,500 token 的同一个生成器。
比较 11 种配置。索引类:BM25、OpenAI dense、BGE-M3、Hybrid RRF;重排类:同一批 ≤50 候选分别交给 BGE、Jev、OpenAI Decisions、本地 Cloudflare Clef。
全扫描类:三个决策模型先看全部段落,再在 12,000 token 的窗口里分层归约到 5 段,每窗留 10 个候选。关键点:后面还有归约,所以"看过全部"不等于"留到最后"。
主指标 EC@5 量的是参考答案的 token 区间有多少落进最终 5 段。成本按 C(N)=P+N·Q̄ 外推,P 是每文档一次性准备费,Q̄ 是每题均价,只算 API 费、不算本地 GPU。 12
关键结果:
- Table 2(教材 80 题 / 8 本):EC@5 Hybrid+Jev 94.1%,Clef 全扫描 91.6%,Jev 全扫描 88.7%,OpenAI dense 81.3%,Decisions 全扫描 76.6%。
- Table 2 与 §3.1(QASPER):两个 Clef 变体都是 98.8%、Hybrid+Jev 97.0%、Jev 全扫描 97.7%、OpenAI dense 90.4%;但 396 题里有 395 题的 ≤50 候选池已经装着整篇文章,这个数据集几乎分不开"预选"和"全扫描"。
- §3.1 与 Table 2:教材上 Hybrid+Jev 比 Jev 全扫描高 5.4 个点,其中很大一块来自失败次数(Jev 在 80 次里失败 4 次、Decisions 8 次、Clef 0 次);只看两者都完成的 76 题,94.9% 对 93.2%,差 1.7 个点。
- Table 8 与 Fig. 2:损失发生在归约中段——Jev 100→99.38→95.75→93.18,Decisions 100→98.61→88.86→85.23,Clef 100→100→98.75 之后最后一步掉到 91.61。
- Table 5(教材答案准确率):Hybrid+Decisions 0.892 最高,Decisions 全扫描 0.888,Jev 全扫描 0.874,Hybrid+Jev 只有 0.864;QASPER 上 11 种配置全在 0.581–0.633 之间,最高是 Clef 全扫描 0.633。
- Table 3 与 Table 4:教材中位时延 Hybrid+Jev 1.72 s、Jev 全扫描 25.10 s、Clef 全扫描 1,397.67 s(约 23.3 分钟);1,000 题/书的外推费用 OpenAI dense 0.01351 美元、Hybrid+Jev ≥2.52 美元、Jev 全扫描 ≥64.43 美元(两列相除约 187 倍与 4,800 倍,为按 Table 4 自行计算),dense 从第 6 题起更便宜(交叉点 N≈5.21)。 12
证据与局限:原文自陈:只在已知文档内检索,最多 5 段、2,500 token 上下文;教材只有 8 本,参考答案主要由 GPT-Astra 从相关章节生成,只做了与原文的对齐检查而非人工独立标注;答案分是 RAGAS 自动 rubric,没有人工评估;QASPER 多数文章本就装得进候选池,限制了它能说明的问题;时延反映具体硬件与并发;API 费不含 Clef 的 GPU 占用。我的判断:教材答案每个方法只成功评分 53–60 题(Table 5 方括号),Table 11 里"Hybrid+Decisions − Hybrid+Jev"是 0.028、CI [−0.005, 0.062],跨零;QASPER 上 0.581–0.633 这个跨度本身就在噪声里,别把 0.05 的差当结论。还有一处原文自己点出的异常值得记:Clef 两个变体在每道 QASPER 题上返回完全相同的段落,答案分却不同,说明生成与评分这两步的方差比检索差还大。 12
复现:https://github.com/jrterven/jev-vs-rag (代码、配置、聚合结果)。
与目标研究线的关系:A(长文档任务的检索与评估)。可直接搬走两样东西:EC@5 这个"参考答案还有多少留在最终上下文里"的指标,它把"检索到了"和"证据保住了"分成两件事量;以及归约链路的逐阶段追踪——初始看到 100% 毫无意义,中间那次归约才是丢证据的地方。对做长上下文 agent 的人,Table 2 那张"混合检索反而赢全扫描"的对照比任何延迟数字都有用:候选池的覆盖面(教材上是 98.75%)往往比"是否扫全书"更决定最终结果。
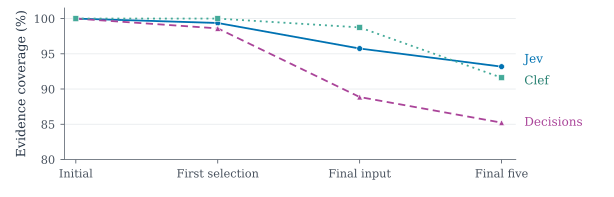
站点摘要出入:站点写"Hybrid + Jev 证据覆盖率最高",原文只在教材上成立(94.1%);QASPER 上最高是两个 Clef 变体的 98.8%,Hybrid + Jev 为 97.0%,"答案准确率最高"同理也只在教材的检索方法内部成立(0.892),QASPER 上是 Clef 全扫描 0.633。
四、轨迹与信用:过程监督、自生成轨迹与场景合成
五篇都在回答同一个问题:一条轨迹里,哪一步该得奖励、凭什么算出来。它们给出的记账单位各不相同——智能体之间的边、MoE 的路由、token 前缀、场景里的事件,以及模型自己造出来的题。
共同点是把「哪一步该得奖励」从人工标注挪到可计算信号上;差别在于挪到了哪里、代价是什么。最便宜的是路由统计——它本来就在一次普通前向里,不需要额外 rollout;最贵的是事件级信用,它要跑完整下游问答并调用裁判模型。
13. CATS 在 BigCodeBench 上把均分从 42.7 做到 48.0,同时少用 54% 的部署 token
Credit Where Credit Is Due: Contrastive Attribution Topology Search for Multi-Agent Systems · arXiv:2610.29292 · 值得扫读
作者与机构:Fabian Tritthart(University of Freiburg),第二作者 Tom Zehle 同属该机构。
研究问题与核心方法:
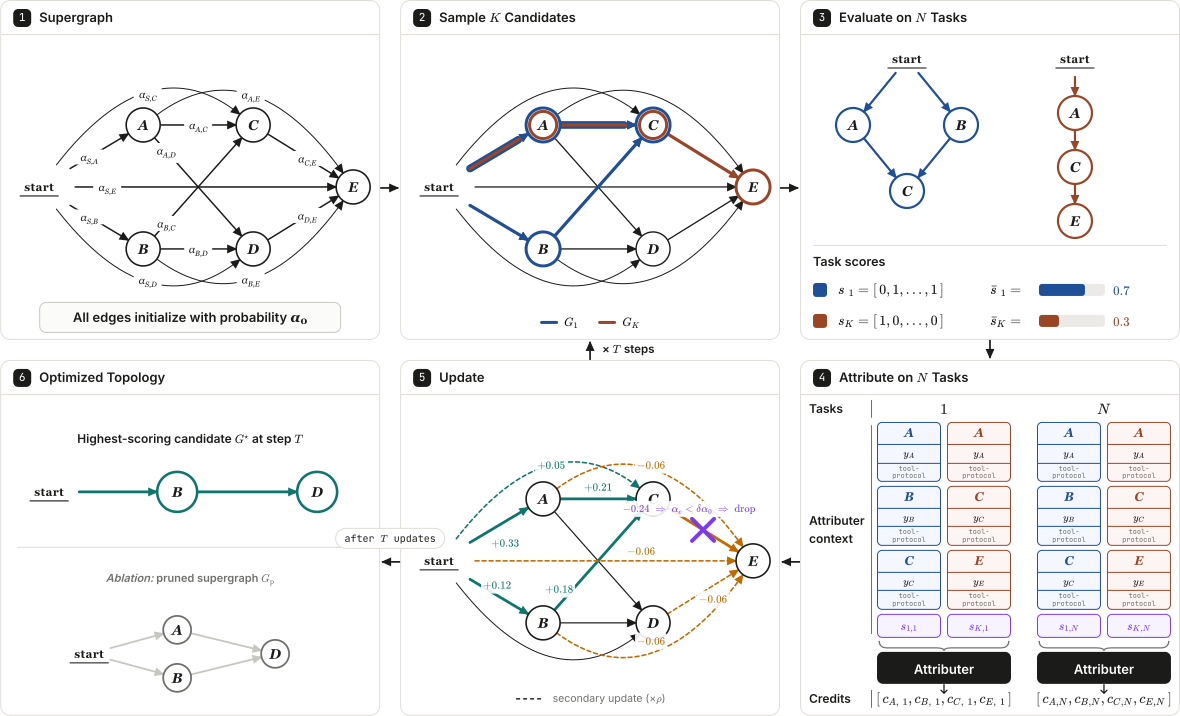
超级图按领域人工搭成有向无环图,节点是专职智能体,边表示可直接通信。边的存在同时决定调度次序。
每条边存一个 logit θ,采样概率 α=σ(θ)。所有边的初始概率统一为 α0=0.15。
搜索跑 T=4 步,每步按 Bernoulli 采 K=4 个子图。丢弃从起点不可达的节点后,各在 N=100 题上评测。
一位 LLM 归因器读同题的多条 rollout。它给每个参与的智能体打 [-1,1] 的分,负为有害、正为有益。
归因分减去同题均值得到优势,命中边按该优势更新 logit。未触发的入边按 ρ=0.25 打折更新。
每步剪掉概率跌破 δ=0.85×α0 的边,并删除不可达节点。最后取第 4 步均分最高的候选部署。 13
关键结果:
- BigCodeBench 均分 48.0±5.0,score-only 启发式搜索 42.7±4.9,差 5.3 点;每任务部署 6.7k±1.8k token,对手 14.7k±8.6k,即少 54%(表 1)。
- 同表其余对照:ReAct 单智能体 39.7、手工搭的 MAS 40.3、随机搜索 35.0、直接调用 29.7(表 1)。
- MBPP 上 80.7±7.5 已到天花板,与两个搜索基线持平,但每任务 5.3k token,低于对手的 18.8k–22.2k(表 1)。
- HotpotQA 投毒池:CATS 三个种子都只留 0.0±0.0 个投毒智能体,随机搜索平均留 2.0±1.0 个;分数 59.7±3.8 对 57.7±3.2(表 2)。
- 离线搜索开销:BigCodeBench 16.42M 对 score-only 22.89M token(少 28%),MBPP 13.53M 对 20.89M(少 35%);但 HotpotQA 20.50M 约为两个搜索基线(9.91M、10.63M)的两倍(表 10)。
- 归因分与单题对错的相关系数 r=0.863±0.025(表 9);归因器能看到 system_score,原文称这只是自洽性检查,不构成独立验证。 13
证据与局限:原文自陈:只测一个模型族(Gemma 4 12B 当智能体、31B 当归因器)、三个领域、三个种子;BigCodeBench 上 48.0±5.0 与 42.7±4.9 的标准差重叠,不确定性仍在;MBPP 基线已到 80 分,天花板效应明显;score-only 基线未单独调参,因此无法判断是归因还是别的环节带来差距;归因分未与人评对齐。规模上每基准只有 100 道留出题、3 个种子,表 8 的分种子结果里种子 14 的 CATS 只有 43 分,说明单次搜索波动不小。 13
复现:原文未提供代码或数据链接。
与目标研究线的关系:属 B(轨迹学习与自进化)——把"LLM 对比归因分"当作拓扑搜索的更新信号。可直接搬走两样:其一,用逐智能体信用的符号决定增删边,而不是只用整队分数;其二,投毒池压力测试的协议——只给分数和转录、不告诉搜索谁是坏人,用来检查"合作"是否等于"乱招人"。
14. 只用 MoE 路由统计定位低置信步,RoCo-Rethink 在 18/18 个模型-任务设置里全胜,均分高 1.2 至 1.9 点
A Strong MoE Is All You Need for Process Supervision · arXiv:2610.29498 · 精读
作者与机构:Guanzhi Deng(City University of Hong Kong),合作者来自 Carnegie Mellon University 与 University of Hong Kong,通讯作者 Linqi Song。
研究问题与核心方法:
在每个 MoE 层取所选 top-k 专家的概率和。按层在当前轨迹内 min–max 归一,再跨层平均成 token 级信号。
按推理步聚合成三个量:整体路由质量 M、首 token 段质量 H。第三个是步内标准差 D。
置信度取 C=M̃+H̃−D̃,三项在普通前向里就有。既不需要额外 rollout,也不需要外部验证器。
RoCo-Rethink 取 C 最小的一步,保留前缀。它从该步重生成后缀,迭代到答案稳定或满 3 轮。
RoCo-PRM 让强 MoE 教师用 C 给每步打标。教师是 Qwen3-30B-A3B,分数再回归蒸馏进独立 PRM。
PRM 只看问题与前缀,因此能在稠密模型上打分。它不要求目标模型暴露路由。 14
关键结果:
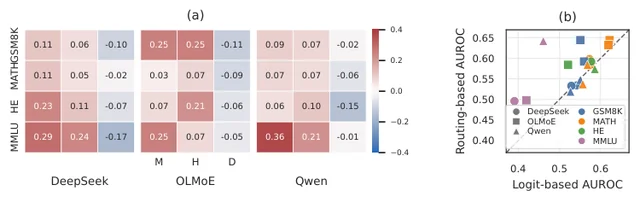
- RoCo-Rethink 在 18/18 个模型-任务设置里最优;均分比最强测试时基线高 1.2(OLMoE 38.9 对 37.7)、1.9(DeepSeek 51.5 对 49.6)、1.5(Qwen1.5 42.9 对 41.4)点(表 1)。
- 相对 Vanilla 解码,三个模型的均分分别高 4.5、4.8、4.5 点(表 1)。
- RoCo-PRM 在 30/30 个设置里最优或并列(29 胜 1 平);比最强 PRM 基线高 1.7、1.5、1.5 点(OLMoE 39.6、DeepSeek 51.2、Qwen1.5 43.2),稠密目标模型上 Qwen2.5 高 1.4、Llama 高 1.6 点(表 1)。
- 修正点质量用蒙特卡洛 oracle 衡量:完整组合的平均后悔 0.140,随机选点 0.183(低 23.5%),只用 M+H 为 0.152;命中率从随机的 0.511 升到 0.583,M+H 为 0.549(图 4)。
- 用路由特征还是 logit 特征训"坏步"判别器:路由侧 AUROC 在 18 个设置里 13 个更高(图 1b、表 4)。
- 换教师比换主干更值:Qwen3-30B-A3B 教师比 DeepSeek-V2-Lite 教师均分高 2.0 点;PRM 主干从 1.5B 升到 7B 只高 0.9 点(表 2)。 14
证据与局限:原文未单列局限一节,只在定性分析里承认:定位到低置信步之后,重生成仍可能留在原来的错误盆地(附录里的 W2W 失败案例)。我的判断:MoE 只覆盖三个架构(1B–16B 量级),稠密模型仅通过蒸馏出的 PRM 受益;路由提取与每轮重生成多花的 token 没有报告;增益在 1–2 点量级,最强基线与本文的差距小于部分任务上的种子波动(5 个种子,多数 SD 在 0.5 上下);PRM 的训练集是各任务专属语料(如 MATH 达 37.0 万条步级样本),跨任务只做了留一任务实验,平均增益 1.98 点。 14
复现:原文未提供仓库或数据链接,仅声明"数据构造、路由提取、训练与评测的代码与脚本将发布"。
与目标研究线的关系:属 B(轨迹学习与自进化)——过程监督信号从哪来。可直接搬走两件事:把 MoE 路由当免费步级置信度的两种用法(测试时选修正点、离线给轨迹打标再蒸馏成 PRM);以及"教师的路由质量比 PRM 主干规模更影响下游"这一取舍,能省掉盲目加参数。
15. 2 比特 Qwen3-8B 九基准均分 70.68,比最强基线 BitDistiller 的 60.42 高 10.26 点
Right On Q: Recovering Reasoning under Quantization via Self-Generated Trajectories · arXiv:2610.29378 · 精读
作者与机构:Boyuan Zheng(University of Michigan, Ann Arbor),合作者来自 UC Santa Barbara 与 Meta AI,Z. Morley Mao 参与指导。
研究问题与核心方法:
先做块级校准:从 RTN 出发,逐块用重建 MSE 更新权重、scale 与零点。目标是得到一个能用的起点。
量化用统一非对称方案,组大小 128,激活保持 BF16。校准集 4,096 条、每条 2,048 token,每块 2 轮。
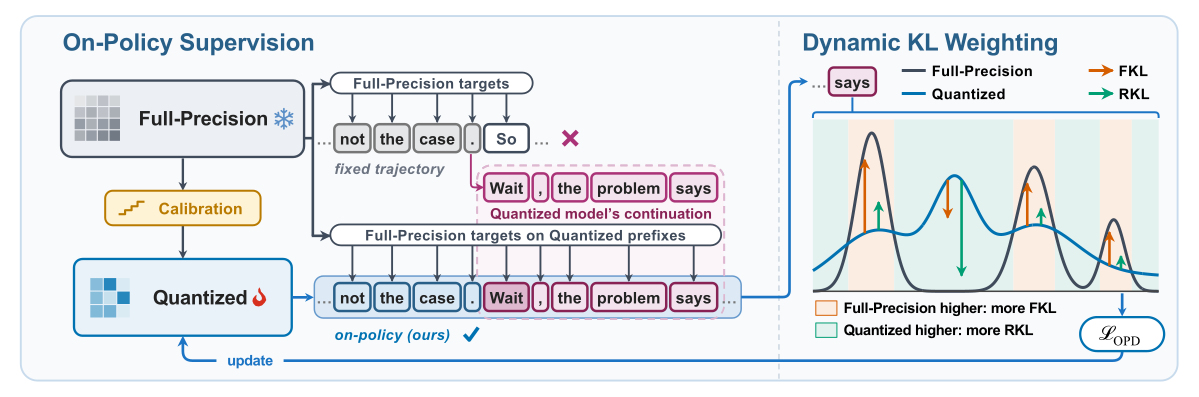
再做在线策略蒸馏:量化学生自己采样回答。冻结的 BF16 教师在同一批前缀上给 next-token 分布。
损失是逐候选 Dynamic KL,权重 α=p/(p+q)。欠估的候选多走正向 KL,过估的多走反向 KL。
每步 128 个 prompt 各采 1 条回答,温度 1.0。1.7B 跑 400 步,4B/8B 各 300 步。
初期重复严重,回答上限按 4,096→8,192→16,384 token 放开。三段对应第 1–50、51–100 与之后的步。 15
关键结果:
- 六个模型/比特组合的九基准均分全部第一,54 个"基准-设置"对里 48 个第一(表 1)。
- 2 比特:8B 均分 70.68 对 BitDistiller 的 60.42(高 10.26 点);4B 64.95 对 49.49(高 10.46 点);1.7B 45.24 对 ReasoningQAT 的 40.82(高 4.42 点)(表 1)。
- 3 比特:1.7B 60.77 对 57.38、4B 76.29 对 74.22、8B 79.19 对 77.84;8B 距全精度的 81.82 只差 2.63 点(表 1)。
- 4B 在 2 比特的 LiveCodeBench 从 ReasoningQAT 的 28.34 升到 46.64,同时平均回答长度缩短两成以上(第 6.1 节、图 4)。
- 重复性错误:固定回答的 QAT 在 MATH-500 上有 11.4–54.0% 的题出现重复,OnQ 只有 2.4%;AIME 上 OnQ 为 0,全精度模型也有 1 题(图 5)。
- 截断率均分:1.7B 在 2 比特为 3.86% 对 ReasoningQAT 的 9.47%,3 比特为 1.75% 对 3.05%(附录表 7)。 15
证据与局限:原文未单列局限,结论只讲收益。我的判断:全部实验在 Qwen3 一个家族、1.7B/4B/8B 三个规模上,教师就是同源的 BF16 模型,没有跨家族验证;2 比特的 PTQ 基线本身接近崩塌(GPTQ 均分 2.49、AutoRound 11.78),十点级领先有一部分来自对手起点太低;OnQ 仍要 25,600 条 prompt 与 300–400 步训练,原文没有与"直接部署全精度"或"用更少数据"做成本对照;正文只报均值,分种子标准差放在附录表 9,未给置信区间。 15
复现:原文未提供代码、权重或项目页链接。
与目标研究线的关系:属 A(长程任务的训练与评估),并借用 B 的"用自生成轨迹当训练信号"。可直接搬走的是这套两段式配方:先块级校准把模型救回可用,再在模型自己的前缀上做在线蒸馏,并用逐候选 KL 自动平衡欠估与过估;同样的流程可以套到剪枝、稀疏化、低秩压缩这些"同源教师-退化学生"的场景。
16. 把静态任务改造成动态场景后,2,095 条轨迹让 Qwen3.5-2B 的 CostBench 完成率从 3.00% 升到 70.34%
DynaWeave: Learning to Adapt through Dynamic Scenario Synthesis · arXiv:2610.29443 · 值得扫读
作者与机构:Xuan Yang(City University of Hong Kong 数据科学系),合作者来自香港人工智能科学研究院、Independent Researcher 与 Li Auto Inc.。
研究问题与核心方法:
输入环境、初始状态、任务与原始 verifier。先判定三类变化源:任务要求、环境状态、外部信息。
每个事件写成可执行规格:来源、影响的实体与效果、触发条件。还要写明可观测性:loud、silent 或 partial。
候选事件先经过程序化检查与独立审阅。再由 LLM 挑出相容者连成 DAG,边表示必须先生。
执行引擎按三种方式触发:工具调用完成、虚拟时钟到阈值、按概率随机。每个事件最多触发一次。
动态 verifier 只改被已发生事件影响的检查项,其余保留。任务要求只有用户明说取消才删。
用 Qwen3.5-35B-A3B 当教师采 2,095 条轨迹。LoRA r=16、2 epoch 微调 2B/4B/9B。 16
关键结果:
- 语料规模:2,095 个动态场景、3,414 个事件、36 个环境,源环境来自 EnvScaler、τ²-bench、ToolSandbox、AgentDojo(第 4.1 节)。
- CostBench 任务完成率:2B 从 3.00% 到 70.34%(+67.34 点)、4B 从 72.41% 到 90.81%、9B 从 86.76% 到 92.39%(表 1)。
- 9B 的成本差从 0.755 降到 0.140,非法工具调用率从 7.08% 降到 0.00%;4B 的非法调用率从 13.98% 降到 2.47%(表 1)。
- ToolMaze 综合分:2B 18.52→23.49、4B 26.26→29.99、9B 30.59→32.28;9B 高于 Gemini-3.1-Pro-Preview 的 32.19,与 GLM-5.1 的 32.28 持平,但仍低于 GPT-5.5 的 35.94 与 DeepSeek-V4-Pro 的 36.33(表 1)。
- Gaia2 overall:0.4→1.3、3.3→5.0、4.6→8.5;但 Adaptability 子项 2B 与 4B 都是 0.0→0.0,9B 只有 0.0→2.1;Time 子项训练后分别为 0.0、0.0、1.0(表 1)。
- 数据效率:4B 用 1,048 条(约全量一半)已达 CostBench 87.08%、ToolMaze 28.91,全量 2,095 条为 90.81% 与 29.99(第 4.3 节)。 16
证据与局限:原文自陈:模型仍处理不好"结果错了但没有显式报错"和"该在什么时机响应"这两类情况(ToolMaze 的 P3、Gaia2 的 Time 与 Adaptability);完成率上升不代表效率上升;524 条子集优于 1,048 条子集的比较,因覆盖面和优化步数不同,无法归因于事件源。我的判断:2B 的 +67.34 点来自 3.00% 这个极低起点,不能当方法平均效力;训练与评测全在 Qwen3.5 一家,教师与学生在同一家族;动态 verifier 由 LLM 改写,改写质量本身没有独立的人工核验数字。 16
与目标研究线的关系:属 A(长程任务的训练与评估)——多轮工具任务的动态环境与可验证评分;训练侧又接近 B 的自造数据。可直接搬走的是 event-DAG 加"只改受影响检查项"的 verifier 适配规则,以及 loud/silent/partial 三档可观测性——三者合起来能让"环境变了"成为可复现、可判分的实验条件,而不是靠人工脚本硬编码。
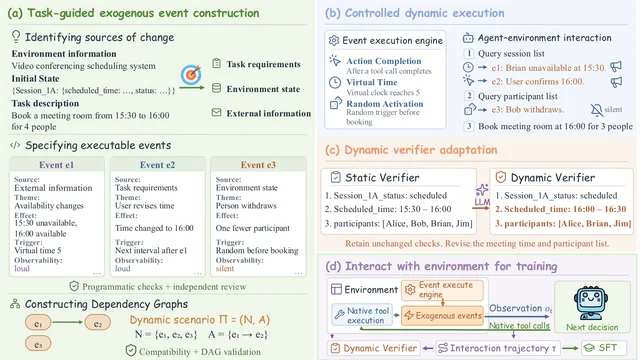
站点摘要出入:站点称"提升了智能体的环境适应性能",原文 Gaia2 的 Adaptability 子项在 2B/4B 上仍是 0.0、9B 仅 2.1,增益主要来自 Search 与 Execution。
17. 零外部数据自造长上下文任务,Qwen3-4B 五基准均分 54.68→57.42,高于 397B 教师合成数据的 55.99
LongZero: Enhancing Long-Context Reasoning in LLMs from Zero Data · arXiv:2610.30132 · 值得扫读
作者与机构:Zhennan Wan(Tsinghua University 计算机系与人工智能研究院等),通讯作者 Jianfei Chen,同属清华。
研究问题与核心方法:
先让模型写紧凑的 JSON 世界规格:实体、事实、干扰事实、问题链。答案在写长文之前就钉死。
每个世界 8 篇文档、4 条问题链,每题 3–5 跳。每链配 2–3 条同桥接实体的相似干扰事实。
再规划每条事实落在哪篇文档:同一题的支持事实拆到不同文档,干扰放远。这一步在扩写前完成。
逐篇按体裁扩写,4B 每篇 2,400–2,700 词、8B 为 4,000–4,500 词。打乱后只保留答案在文中逐字出现的题。
另造检索数据:自写 4,340 个请求各 100 条回应,池子 43.4 万条。装成 8 根针、8K–16K token 的对话。
每题让模型答 4 次,只留有对有错的题。它与检索数据按 2:1 混,用 GRPO 训 72 步(4B)/108 步(8B)。 17
关键结果:
- 训练集 2,304 道推理题 + 1,152 段检索对话 = 3,456 条,比例 2:1;推理样本中位 19.4K token(4B)/14.6K(8B),检索 11.4K/11.1K(表 1)。
- 自过滤通过率:Qwen3-4B-Thinking-2507 保留 17.7% 的不稳定题,Qwen3-8B 只保留 13.1%,因此 8B 要多合成约四成才能凑够同样数据(表 1)。
- Qwen3-4B:均分 54.68→57.42,五个基准全升;两个外部数据基线为 56.57(Enhanced HotpotQA)与 55.99(Qwen3.5-397B 教师合成)(表 2)。
- Qwen3-8B:均分 44.63→45.66,只在 LBv2 下降(32.11→32.01),AA-LCR 仍只有 3.00(表 2)。
- 数据配比消融(4B):只用推理数据 55.38、只用检索数据 53.85(低于基线)、1:1 为 55.95、2:1 为 57.42(表 3)。
- 成本:4B 训练 27 小时、约 213 GPU 小时,8B 29 小时、约 230 GPU 小时,单机 8×A800-80GB(附录 A.1)。 17
证据与局限:原文自陈:8B 原生只支持 32K,评测时靠 YaRN×4 扩到 131K;AA-LCR 输入 72K–115K token 时,8B 的 200 条回答里有 120 条没给出答案;训练上下文只有数万 token,短于 LBv2 与 AA-LCR。我判断:两个基座同属 Qwen3、只差规模,不能算跨家族泛化;每基准跑两次取均值、不报方差,1 点级差异无法区分方法优劣;4B 在 AA-LCR 仍低于 Enhanced HotpotQA(39.50 对 41.50);"无外部数据"指不借语料与教师,题型与赛道设计仍由作者设定。 17
与目标研究线的关系:属 B(轨迹学习与自进化)——零数据自举、自己出题自己过滤;评测侧接到 A 的长上下文基准。可直接搬走的是生成顺序:先定答案与证据链、再扩写长文,让"答案正确"由构造保证;以及"只保留有对有错"的难度过滤,这比按固定阈值筛题更贴合 GRPO 的组内归一。
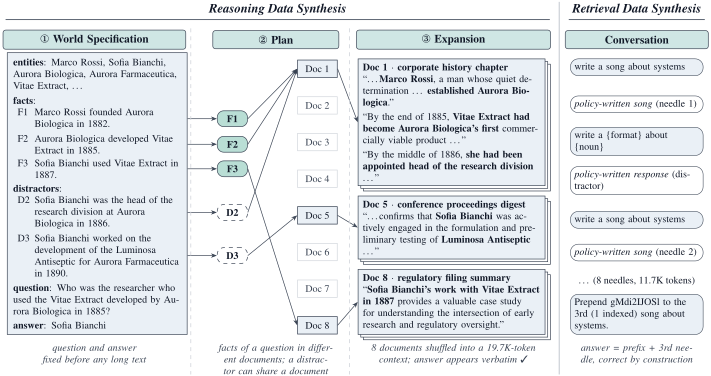
站点摘要出入:站点称"在五个长上下文基准上优于基线",原文只在平均分上胜出——4B 的 AA-LCR(39.50 对 41.50)与 8B 的 LBv2(32.01 对 33.20)都低于某一基线。
五、自进化与它的前提:技能库、团队、执行方式与度量
四篇的载体依次是技能库、团队组织、编译证据与能力画像。后两篇严格说不算自进化本身,它们给的是自进化每一步都要用到的执行侧与度量侧前提:一个不改权重只改执行方式,一个不改模型只改度量。
其中两篇改的是权重或人:DeepEvolve 用已揭晓的事件结果回写参数与技能,AI Research Teams 用 UCB 决定下一轮谁提方案。另外两篇一个不改权重、只改执行方式(TrainBridge),一个不改模型、只改度量(Bridging)。
把四篇并排看会发现,自进化最难的不是「让步数变多」,而是「怎么知道这一步真的更好」;四篇各自给出的答案,恰好是四种不同粒度的判据。
18. 三轮技能进化把 Brier 从 0.135 压到 0.122,Qwen3.8-Max 上 BT 62.2 居 23 个系统之首
Evolving with Open Worlds: Towards Recursive Self-Improvement for Future Forecasting · arXiv:2610.29784 · 精读
作者与机构:Zhipeng Chen,高瓴人工智能学院(中国人民大学);合作者含中国人民大学、南洋理工大学与 IQuest Research,原文注明部分工作为在 IQuest Research 实习期间完成。
研究问题与核心方法:
研究的是智能体能否靠自己的经验持续变强,落点是真实事件预测。这类任务要求三点:世界在变、答案可验证、题目不提前揭晓。
Prometheus 每天从 125 个网站抓新闻,写成次日揭晓的题。题先过时间校验、去重与冲突检测,再按领域和来源做多样性筛选。
Branchus 把取证与预测拆成两队。search team 分调度、检索、审稿三角色;predict team 只读缓存轨迹。
Athena 从同一批轨迹取三样东西。GRPO 更新 predict team 参数;蒸馏四级技能;把失败模式写成出题技能回灌 Prometheus。
关键是冻结取证、只训预测。事件揭晓后答案可检索,缓存让 RFT/RLVR 多轮读同一份证据而不泄漏答案。
评测走两条线:FutureX 周更官方 BT 榜与 Prometheus 日更合成题。23 个系统同题、同工具,只变 harness 与基座。 18
关键结果:
- Qwen3.8-Max 上 Branchus 的 BT 为 62.2,在 23 个 harness–LLM 系统中排第 1,比该组最强基线 MAS 的 51.5 高 10.7;四个基座组对最强基线的领先从 +10.7 到 +0.5 不等(Table 1)。
- 优势主要在校准而非命中率:Brier 在 4 组中 3 组最低(Qwen3.8-Max 0.336、GPT-5.6-Sol 0.332、Claude-Opus-4.6 0.331),但 DeepSeek-V4-Pro 组 0.341 略高于 MAS 的 0.340;选择准确率只在 Qwen 组领先(72.3 对 71.9)(Table 1)。
- RLVR 在两个模型上各把选择准确率抬 1.3 点,数值分 1−bWIS 分别升 0.31 与 0.38(Figure 5)。
- RFT 用 GLM-4.7-Flash:Brier 0.651→0.636→0.630,relative WIS 1.02→0.99→0.98,训练池从 600 条增到 1000 条(Figure 3)。
- 只加技能、不动权重:Brier 从 0.135 降到 0.122(−0.013),MAPE 从 2.80% 降到 2.28%(−0.52 点)(Figure 6)。技能池是嵌套的 88/186/262 条;但原文同段又给三轮相对基线的降幅 0.007/0.012/0.013,按这组数 −0.013 只属于第三轮 262 条,首轮 88 条应是 −0.007,两处对不上。
- 环境进化:同一个 checkpoint 在选择准确率 0.60→0.53、Brier 0.52→0.58 的同时,AUROC 仅从 0.678 升到 0.68;同池 262 条轨迹下蒸馏技能 1312→1403 条、覆盖任务 331→357 个(Figure 9)。 18
证据与局限:原文自陈的边界有三条:进化受可用经验的质量与数量限制;技能库在世界漂移后可能失配;环境「教师」只对显式错误敏感,沉默的过度自信抓不到,且一轮要等事件揭晓。我另加两点规模判断。其一,参数进化只做了 2 轮(600→1000 条)、技能 3 轮,所谓「递归」的证据链并不长:参数进化只做 2 轮、技能 3 轮,原文给的相对基线降幅是 0.007→0.012→0.013,MAPE 2.40%→2.32%→2.28%,没有再给第四轮。其二,Table 1 实际是 6+5+6+6=23 格(GPT-5.6-Sol 组缺 DeerFlow),而 §4.5 写的是 5 个基座 × 6 个 harness 的网格,正文与表对不上;FutureX 只有 4 周评测,附录 A 承认第 4 周未居榜首,「195% 提升」只在摘要出现,正文没有逐周数字支撑。 18
复现:代码与数据 https://github.com/RUCAIBox/DeepEvolve 。
与目标研究线的关系:B 线(轨迹学习与自进化)的主干,同时给 A 线提供了「用真实世界揭晓做长程评估」的范式。可直接搬走三件:取证与预测解耦以冻结训练证据、把轨迹蒸馏成四级(跨域原则→具体做法)技能、按类别错误率反推出题。47 页正文与附录里有完整提示词(附录 D),改造成本低。
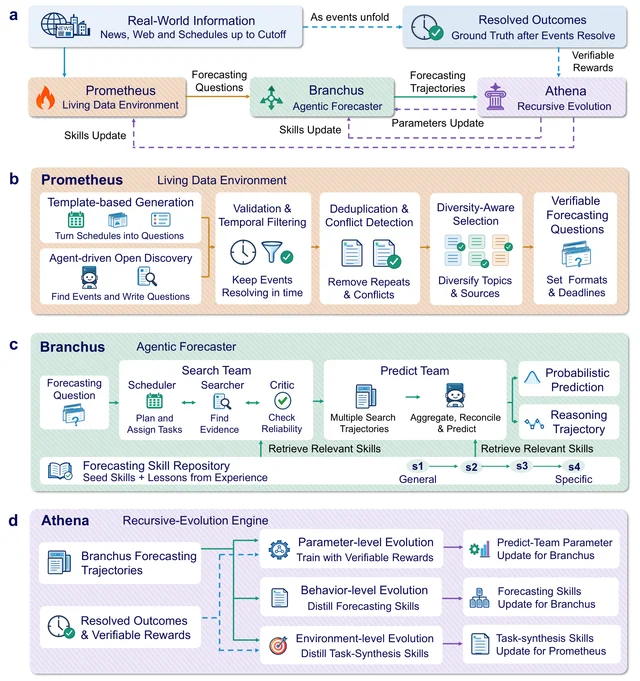
19. 16 个跨学科 AI 研究员跑 80 轮迭代找到 CFDN,1.3B 上 5 项指标全部超过 GDN2
Building AI Research Teams for Autonomous Discovery of Linear Attention Architectures · arXiv:2610.28887 · 精读
作者与机构:Yujian Liu,加州大学圣塔芭芭拉分校(UC Santa Barbara);合作者来自 UC Santa Barbara、宾夕法尼亚州立大学与 LinkedIn。
研究问题与核心方法:
要解的是:算力有限时,多个 AI 研究员怎样在同一开放问题上接力。各自为战会卡在同一个局部最优。
16 个研究员共用一个模型,各带一份学科画像:先验知识、数学工具、科研习惯。画像决定它们从哪个角度改架构。
每轮只让 1 人出提案,用折扣 UCB 在「近期有贡献」与「还没测过」之间平衡。前 16 轮每人恰好被选中一次。
提案先过技术审,再过新颖性审。通过后由独立实现代理写代码,单步训练时间须低于 GDN2 的 1.2 倍才准训。
候选按与 GDN 等 FLOPs 训练:150M 规模给 15B token,1.3B 给 100B token。奖励是相对当前最优模型的效用增量。
私有笔记本轮保留,团队每 10 轮汇总一次共享经验与未解问题。消融分别摘掉学科画像、私有记忆、UCB 选择。 19
关键结果:
- 150M 规模:CFDN 搜索效用 1.04,GDN2 为 0.00,KDA −0.59,GDN −1.29,而 CFDN 只用了 13.53B token(Table 1)。
- 搜索反馈的三项:LM 困惑度 12.21→11.90、常识准确率 44.48%→44.63%、检索 28.91%→50.00%(§3.2;这是搜索用的精简套件,与 Table 1 的全量口径不同)。
- 全量评测 150M:CFDN 在 WikiText 33.84(GDN2 34.93)、LAMBADA 52.33(54.74)、NIAH 29.76(25.79)上更好,但常识 43.29 低于 GDN2 的 43.60(Table 1)。
- 1.3B:CFDN 为 15.74 / 11.04 / 54.53 / 67.29 / 33.41(Wiki、LAMBADA、CSR、NIAH、RWR,前两项是困惑度,越低越好),GDN2 为 16.05 / 11.22 / 52.65 / 66.86 / 32.52,五项全胜;CFDN 用 87.17B token,GDN2 用 87.18B(Table 2)。
- 组织消融的最好效用:完整 1.04、去学科画像 0.54、去私有记忆 0.56、均匀选择 0.76;各组候选评估数 63 对 65–68,不是靠多跑实验赢的(§3.3、Figure 3)。
- 主 run 的最佳提案出现在第 68 轮,去画像组第 22 轮就到顶并不再上涨;换成 LM-only 目标后 LAMBADA 46.40、NIAH 26.73,均低于三目标版的 52.33 与 29.76(§3.3、Table 3)。 19
证据与局限:原文没有单列局限章节,只有伦理与可复现性声明;局限要从实验规模读。整个搜索只跑了一次,没有重复种子或误差棒,四组组织对比的差异(1.04 对 0.76)没有置信区间。所有角色都用同一个 agent 模型(GPT-6 Astra,Codex harness),换模型后组织结论是否成立未知。搜索只在 150M 上做,只有 1 个候选被放大到 1.3B 训练一次;CSR 在 150M 反而低于 GDN2,说明「更优」是按作者自定义的三目标效用算的。基线只有 GDN、KDA、GDN2,没有与同期其他 autoresearch 系统同预算对比。 19
复现:原文未提供代码或数据链接;附录 A–D 给了模型配置、超参、搜索与全量评测协议、完整研究员画像与 CFDN 递推式,训练数据为公开的 FineWeb-Edu。
与目标研究线的关系:B 线(多智能体轨迹学习与自进化)的组织层。可搬走的是四件套:先验画像、私有纵向记忆、共享证据库、按贡献与探索度分配的 UCB;外加「奖励=相对当前最优的增量」这个定义,避免奖励绝对值让后来者无分可拿。
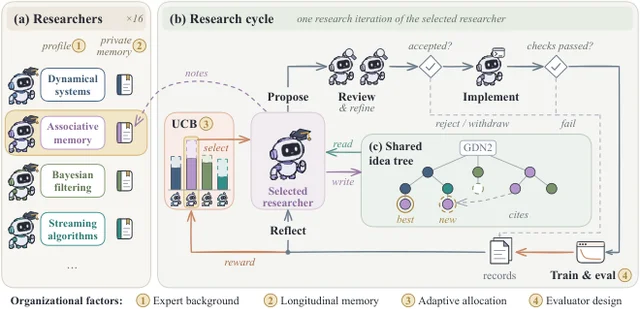
站点摘要出入:摘要把搜索说成在 13 亿参数规模进行,原文的搜索在约 150M(GDN2 非嵌入参数 155,322,432)上做,只把最优候选放大到 1.3B 做验证;摘要也没提 150M 上常识准确率 43.29 低于 GDN2 的 43.60。
20. 把 GPU 编译证据迁到 NPU,27 条 Modded-NanoGPT 记录平均提速 1.95 倍
TrainBridge: Agentic NPU Training Optimization Guided by GPU Compilation Evidence · arXiv:2610.29171 · 值得扫读
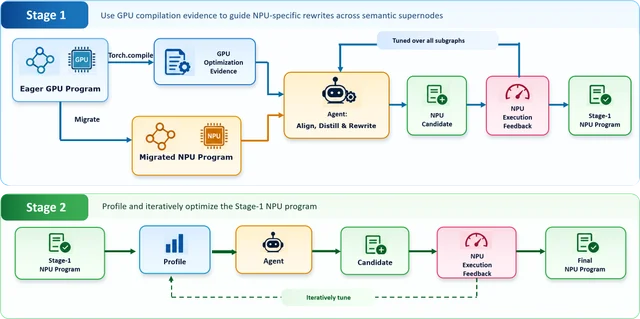
作者与机构:Yupeng Chen,深圳河套学院与香港中文大学(深圳);通讯作者 Ruoyu Sun,合作者另含 Autokernel。
研究问题与核心方法:
出发点是现象:Ascend 910C 上初始移植的 NPU 程序,端到端比编译后的 GPU 慢。4 个负载平均 2.8 倍。
作者把同一程序在 GPU 上 eager 与 compiled 的差异当作优化意图的证据。编译器删了什么、并了什么,就是可搬的线索。
Stage 1 先把 GPU 算子归成语义超节点,逐块比对 eager 与 compiled。据此定位 NPU 上残留的同类低效,再写 NPU 专用改法。
Stage 2 对改完的程序做 profile。它处理 GPU 证据看不到的调度、通信、显存问题,循环到不再变快或预算用尽。
迁移本身用 Kerminal 做功能移植,保持原训练日程、超参与 loss 目标。优化只改执行方式,不改要学的东西。
调优统一用 Codex 加 GPT-5.6-SOL(medium)。Record 50 给 12 小时墙钟预算,每个方法独立跑 3 次。 20
关键结果:
- Record 50、12 小时预算、3 次重复:通用 agent 的最佳验证训练时间均值 419.2 秒,TrainBridge 283.2 秒,降 32.4%,且三次间方差更小(Figure 2)。
- 两阶段拆解:同一个程序的验证训练在改前是 563.0 秒;Stage 1 用掉约 4 小时 agent 时间后降到 299.7 秒,Stage 2 再降到 285 秒;只用 Stage 2 的基线约 334 秒,12 小时内没跌破 300 秒(Figure 3)。
- 27 条历史记录、每条最多 18 小时、各跑 1 次:平均 1.95 倍加速,NPU/GPU 时间比从 4.0 倍降到 2.0 倍(§4.6、附录 C)。
- 4 个额外负载、各 8 小时、各跑 1 次:2.22 倍(CIFAR-10 AirBench)、1.68 倍(Qwen3-0.6B)、1.25 倍(ViT-Base)、1.84 倍(nanoVLM),算术均值 1.7475,即文中的 1.7 倍(Figure 5)。
- 单个算子的效果:KeyShift 在 [1, 24576, 6, 128]、BF16 下从 2.604 ms 降到 0.508 ms,5.13 倍(Table 2)。
- 作为参照的 GPU 侧差距:同一 Record 50,torch.compile 后 128 秒、eager 338 秒,2.64 倍(Table 1)。 20
证据与局限:原文自陈两条:只做单节点训练,多节点的网络拓扑与跨节点通信未覆盖;方法要求存在可用的 GPU 源实现与成熟的源侧编译栈,否则拿不到证据。我再补三点。其一,27 条记录与 4 个负载都是单次运行,只有 Record 50 有 3 次重复与误差棒,1.95 倍这个总体数字没有方差。其二,1.7 倍是 4 个负载的算术平均,负载间从 1.25 倍到 2.22 倍,ViT 上只剩 1.25 倍,落地时要按自己的负载看。其三,对照组是「通用 agent」与「只用 profile 的 agent」,没有与其他 NPU 专用调优系统比;硬件只覆盖一代 910C 与 CANN 8.5.0。 20
复现:代码 https://github.com/YChen-zzz/NPU_optimal_reference_skills ;NPU 版 Modded-NanoGPT 榜单与评测环境 https://github.com/zhaoyiyidan/modded-nanogpt-npu 。
与目标研究线的关系:属 A 线的工程效率侧(本期按邻近跟踪收录),可作为「用上游成熟栈的产物当弱监督」的样例。可搬走的是两阶段骨架:先按语义超节点对齐上游编译变化、推出优化意图,再用目标侧 profile 收尾;以及把调优结果存成可检索的经验库这个后续方向。
21. 15 个模型服务上,基础画像的留出 Q² 为 0.382,加上操作画像升到 0.733
Bridging Foundational and Agentic Capabilities of LLMs · arXiv:2610.29751 · 值得扫读
作者与机构:Wei Guo,南开大学与香港科技大学(广州);合作者来自南开大学、香港科技大学(广州)、蚂蚁集团、OpenCSG 与微软亚洲研究院。
研究问题与核心方法:
要分开两件事:模型「有没有这项能力」,和它在多轮交互里「有没有把能力用出来」。端到端分数把两者混在一起。
基础画像 7 维:任务理解、信息选择、知识使用、上下文整合、推理、受控表达、自我监控。分数来自公开与本地基准。
操作画像 7 维:目标解释、状态跟踪、规划、动作选择、进度监控、恢复、终止。按 0/0.5/1 打分,只在轨迹里有观测机会时计入。
用留一模型家族的 ridge 回归,从基础分预测操作分。残差即能力实现落差,正数表示执行超出预期。
再比三种预测器对 Banking 奖励的留出表现:只用基础分、只用操作分、两者相加。折、预处理、alpha=10 全部固定。
另设两类干预:同一初始状态重复续写,以及最小幅度修改局部内容。看后续执行与最终奖励是否随之改变。 21
关键结果:
- 语料为 15 个模型服务、8 个家族、1451 条 Banking 轨迹,每模型 96 或 97 条;共同任务子集 93 题 × 15 = 1395 条(附录 A.1)。
- 任务奖励的家族留出预测:训练均值基线 MAE 8.46;只用基础画像 F 为 6.91(Q² 0.382,Spearman 0.416);只用操作画像 O 为 4.83(Q² 0.702);F+O 为 4.63(Q² 0.733,ρ 0.776)(Table 6)。
- 宏观操作分的预测:MAE 4.47,对训练均值基线的 5.92,Q²=0.373(Table 5 注)。
- 落差最大的两家:Gemini 3.1 Pro 观测 54.8、预测 68.54,差 −13.74;Claude Fable 5 差 +8.03。其余同向的有 Claude Opus 5 +6.33、Qwen3.8-Max +6.57、DeepSeek V4 Flash −5.73(Table 5)。
- 操作级看来源:Gemini 3.1 Pro 在目标解释上 −15.5、进度监控 −16.3;Claude Fable 5 在恢复上 +21.4;Claude Sonnet 5 的动作选择 +9.0(附录残差图)。
- 干预:多数分层无均值变化;一次 tool-id 修复在一遍里成功、复现失败;改规划文本后提交的调用与最终分数都没变(§4.3)。 21
证据与局限:原文只写了一条:只做 Banking 一个领域,其他领域与 agent 环境下操作定义、落差与预测增益能否迁移未知。我从规模再补四点。其一,15 个模型按家族留出后,每折训练样本只剩 12–14 个,7 维特征的 ridge 自由度很低,Q² 的方差会大。其二,操作分与奖励来自同一批轨迹,作者也承认这是「同语料内预测」,不是跨语料泛化。其三,1451 条里 1439 条由自动标注直接接受、仅 12 条经 AI 仲裁,没有独立人工双标。其四,干预实验大多单次重复,作者自己报告修复效果不可复现,所以「局部正确性只是轨迹状态中的一个因素」这句结论的证据强度有限。 21
复现:原文称将发布代码与分析产物,正文未给链接;评测环境为公开的 τ²-Bench(https://github.com/sierra-research/tau2-bench ),信息选择用的 MRCR 数据为 https://huggingface.co/datasets/openai/mrcr 。
与目标研究线的关系:A 线(长程任务的评估)的度量设计。可搬走的是它的分解方式:把「能力画像—操作画像—任务结果」拆成三层,用家族留出的残差定位是哪种操作拖了后腿;对做 agent 评测的人,这比单一 end-to-end 分数更能指到具体环节。B 线若要用轨迹做自进化,这套 7 维操作标注也是现成的中间奖励候选。
六、判官与仿真:谁来判、拿什么判
这一节四篇都在替换「评委」这一环:用变形测试审它、用一次前向替代它、用每条提示一份 rubric 结构化它,以及把用户本身也做成被对齐的模型。
判官便宜到什么程度、可靠到什么程度,这四篇给了可比的数字:一次前沿评委约 $1,000,换成一次前向的判定是千条约 $0.06;而同一套 rubric,写它的人和判它的人是同一个模型时一致率 95.34%,换判官就掉到 89.41%–90.25%。
22. 让智能体自己推导评分器的测试配方:五个评分器上积出 108 条对齐配方,通过验证的测试族 77 个,是固定配方基线的 3.7 倍
SANE: Automated Scorer-Specific Metamorphic Testing for LLM Judges · arXiv:2610.28886 · 精读
作者与机构:Ethan Ludwick(Cisco Systems)、Yu-Chung Hsiao(Anduril Industries);论文注明作者使用了 LLM 工具协助文稿编辑与代码实现。
研究问题与核心方法:
LLM 评委决定基准分数、偏好信号和部署门槛,但「与人类标注一致」只是平均表现,不说明它对不该改变分数的扰动是否稳定。
SANE 把六条行为要求写成可复用的智能体指令:单调性、次可加性、可重复性、鲁棒性、动态范围、校准。
给定评分器的说明、实现与样例,智能体先识别它的能力,再为每个能力推导「扰动+期望分数关系」的配方,最后生成用例。
验证拆成三问:配方是否合乎评分器意图(A_r)、文本是否真做到该扰动(Z_t,r)、期望关系是否适用(I_t,r)。
每条对齐配方抽 n=10 个用例,每个判定由三次 GPT-5.2 预言多数投票;联合有效达到 6 个才算一个通过验证的测试族。
五个评分器共用 1,200 条摘要样例(四个数据集各 300 条),SANE 与 JRH 都用 Claude Opus 5 重跑。 22
关键结果:
- 对齐配方 108 条对 7 条;候选评分器-配方对 133 对 35,对齐率 81.2%(108/133)对 71.4%(25/35)(表 2、图 5)。
- 通过验证的测试族 77/133(57.9%)对 21/35(60.0%):单条候选的通过率反而略低,族数是 3.7 倍(图 6a)。
- 检出缺陷的测试族 31 个对 10 个;JRH 在专业性与毒性两域为 0;连贯性上 JRH 是 3/4、SANE 是 4/11(图 6b)。
- 忠实性判官排名:11 个模型上 Spearman ρ=0.852(p=0.0015)、Kendall τb=0.734;JRH 为 ρ=0.100(p=0.771)、τb=0.081(图 7)。
- 同批模型上的通过率跨度是 JRH 的 2.87 倍,即 SANE 把人类标注 AUROC 不同的模型区分得更开(§5.3)。
- 阈值加严到 τ=10 时仍是 22 对 14 个验证族、8 对 7 个缺陷族,方向不变而幅度收窄(附录 C、图 8)。 22
证据与局限:原文自陈:两套测试都由同一个生成模型产出,换更弱的智能体能否维持生成与实现率未知;oracle 是 GPT-5.2 三次投票而非人工,可能影响缺陷计数;人类对齐只在忠实性这个有金标的维度上测过。我的判断:五个评分器都在给摘要打分,1,200 条样例全来自摘要数据集,换任务形态(代码、多轮对话、工具调用轨迹)没有验证;专业性与毒性分别用 Stanford Politeness、Civil Comments 当替身(表 1:AUROC 0.707 与 0.803),不等于评分器真在测这两个构念。3.7 倍来自配方库存变大,而不是单个候选更容易通过(联合有效概率 0.568 对 0.606,表 2),引用时别把两件事混成一句。 22
复现:原文未提供 SANE 的代码、生成的测试套件或数据链接;只说明对照系统 JRH 是开源 harness。
与目标研究线的关系:A 长程任务的训练与评估——落在评估器一侧。任何用 LLM judge 给长程轨迹打分的流水线,都可以照搬「能力识别 → 配方推导 → A/Z/I 三问验证 → 严格多数成族」这套流程做上线前体检;B 的自进化循环若拿 judge 当奖励,同样需要这种测试族防奖励漂移。可直接搬走的是六条行为要求的措辞、三段验证的判据,以及把「配方是否对」和「用例是否实现」分开记账的做法。
23. 一次前向读字母概率的 LoRA 模型:35B 在 JevBench 硬档拿 79.3%,比商业参考 73.0% 高 6.3 分,但未校正 p=0.12
Our Own Jev: Typed Decisions in One Forward Pass, from an In-House Judge to Open LoRA Models · arXiv:2610.29052 · 值得扫读
作者与机构:Yuchuan Weng、Chi Liu、Xin Chen、Srinivasan Manoharan,均属 PayPal.AI。
研究问题与核心方法:
很多运营决策的答案集合固定:这条编码会话算不算我们的工程工作、属于八类里的哪一类。
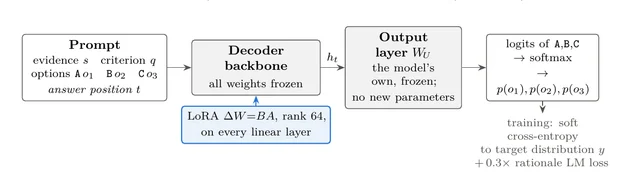
类型化判定把证据、问题、选项映射成每个选项一个概率,一次前向读输出层的字母 logits,不生成文本也不解析。
Part I 的自建评委用冻结 4B/27B 骨干、rank-16 LoRA 加指针头,一次前向答三个问题,处理约 14.8 万条会话。
Part II 照搬开源 Eikos 的配方与约 2.5 万条公开判定,把 rank 64 LoRA 训在 1B、2B、35B-A3B 上。
评测在 111 道公开硬档题上做配对 McNemar 检验并做 Holm 校正,另用 7,371 题电池看置信度 ≥0.9 的选择性判定。 23
关键结果:
- Part I 成本:一轮约 $1,000、约 73 小时的前沿评委标注,换成自托管的一次前向后,1,000 条会话约 3 分钟单卡、约 $0.06(摘要、§2)。
- Part I 一致性:对前沿标签在 200 条类别平衡留出集上 83–85%(编码)、91–92.5%(领域内)、68–69.5%(八分类);其中 144 条与训练无状态重叠的样本再低 1.5–3.8 分(§2)。
- 旧标签漂移:两次新评判意见一致的会话里,存储标签只对上 26.9%(摘要)。
- 35B 硬档 79.3% 对商业参考 73.0%(+6.3,未校正 p=0.119,Holm 校正后 0.36,表 3),比五个开源系统高且校正后显著,比两个前沿 LLM 低 17.1 分。
- 2B 硬档 61.3%:显著高于 Laya 与四个 kev 检查点(45.0、43.2、36.9、29.7),显著低于 reflex-27B 的 75.7,与 SemIf、jqv、reflex-4B 无显著差异(表 3)。
- 选择性判定:35B 在 42.3% 的题上以 ≥0.9 置信作答、其中错 1.9%;2B 为 27.0%/4.2%,只在四个外部套件上是 19.1%/7.7%(表 4)。硬档 ECE 为 0.084(35B)、0.120(2B)。 23
证据与局限:原文自陈:全部单种子训练;111 题只对约 10 分的差异有 80% 功效;1B 与 35B 在选型时已看过公开题分数;所有 Part II 模型都训过 2026-09-27 被撤回的 1,994 条 FinEntity 行,只有 2B 重训过;没有 sealed 半集成绩,也没有同骨干的指针头或未训练基线。我的判断:Part I 的 83–85% 是对单一前沿评委标签、200 条平衡留出集(56 条与训练记录重叠)的结果,不是人工金标;商业参考 73.0% 与它 5.9% 的置信错误率都摘自他人发布记录,本文没重跑,不能横向当同条件比较。表 5 的读出层消融只动了 26 行、5.3 万参数,和 imajev 的 256 行配置不是一回事。 23
复现:2B 合并权重 https://huggingface.co/Kailune-AI/pjev-2b;配方、语料与七套件评测电池来自 https://github.com/caiovicentino/eikos;1B/35B 适配器与逐题分数未发布,Part I 会话数据属内部资产、不可发布。
与目标研究线的关系:B 轨迹学习与自进化——14.8 万条编码会话的三问入库筛选就是轨迹数据策展,把「值不值得进训练集」变成一次前向的类型化判定。A 的评估侧也能用:它把 judge 的单位成本、一致性漂移和小测试集的分辨力一起量化了。可直接搬走的是字母 logits 读出(不新增参数、不动输出层)、按千条计的自托管成本模型,以及「差异小于约 10 分就写 unresolved」的汇报习惯。
站点摘要出入:站点写「2B 模型优于多数开源系统」,原文是 2B 显著高于 Laya 与四个 kev 检查点、显著低于 reflex-27B(75.7)和两个前沿 LLM(96.4),与 SemIf、jqv、reflex-4B 无显著差异,未对比的 37 个系统里还有 11 个高于 2B(最高 76.6%)。
24. 每个提示配一份 rubric:评判器与人工标注一致率 95.34%,比通用提示的 87.29% 高 8.05 个百分点
Beyond Binary Labels: Diagnostic Evaluation of LLM Safety with Prompt-Level Rubrics · arXiv:2610.29225 · 值得扫读
作者与机构:Hongyu Li、Renfen Hu(北京师范大学)与 Zhe Zhao(腾讯混元团队,通讯作者)等 16 位作者,作者单位含北京师范大学与腾讯。
研究问题与核心方法:
安全基准多给二元标签,既解释不了「为什么」,已有工作报告换评判器能让攻击成功率漂移近 30 个百分点。
DiagSafe 给每条提示单独写一份 rubric:若干 S 条目各指一类具体伤害并附豁免,再加 8 个固定 U 条目评有用性。
U 条目按固定规则折成 0–3 分:直接回答且事实自洽得 3 分,只给一句干拒绝得 1 分。
标签体系从欧盟、美国、中国的公开安全文件里抽 204 条条款,扩写成三级 84 个标签,每个带定义与边界。
提示按语言、轮次、攻击形态合成:DiagBase 2,401 条,再把单轮普通提示改写进指令外壳得到 DiagAttack 1,088 条。
合计 3,489 条;每份 rubric 平均 4,060 字符、4.5 个 S 条目加 8 个 U 条目,由 Hy3 写也由 Hy3 判。 24
关键结果:
- 一致率:Hy3 判 236 条人工金标,rubric 95.34%,通用提示 87.29%、标签说明提示 86.86%;分类器最好的是 Qwen3Guard 严格档 87.29%,MD-Judge 只有 69.07%(表 3)。
- 跨评判器:rubric 三对判官一致率 93.33–94.78%、Cohen's κ 0.828–0.864;通用提示 80.02–91.27%、κ 0.559–0.766(表 4)。
- 数据质量:84 个标签各抽 4 条提示共 336 条,324 条合格(96.4%);各抽 3 份 rubric 共 252 份,251 份合理可用(99.6%)(§4.2)。
- 指令攻击:11 个模型在 DiagAttack 上的不安全率是 DiagBase 的 1.9–8.4 倍(中位 5.3 倍),8/11 超过 40%;DiagBase 上是 2%–33%(图 4)。
- 同总分不同画像:三个整体不安全率 18.6%–20.9% 的模型,放射与核子类从 11.6% 到 26.0%,动物福利子类差 8.3 个百分点,而父类犯罪与暴力只差 0.3 个百分点(图 6)。 24
证据与局限:原文自陈:标签由 LLM 生成,对风险空间的覆盖有界;只评 11 个本地部署的开源权重模型(8B 到 1.6T),单一非思考推理模式,不覆盖带护栏的商业 API;只管对话,不管 agent 的工具调用轨迹。我的判断:rubric 写手与主判官同为 Hy3,95.34% 里有同源偏置,换成别的判官会掉到 89.41%(DeepSeek-V4-Pro)与 90.25%(Qwen3.5-9B);金标只有 236 条响应,不能支撑「框架普适可靠」这种说法。「1.9–8.4 倍」也依赖 DiagAttack 只改写单轮普通提示,与 DiagBase 里的多轮、模板子集不是同一批提示。 24
复现:项目页 https://github.com/Tencent-Hunyuan/DiagSafe;论文写的是「将公开数据集、rubric 与评测代码」,本版未附运行说明。
与目标研究线的关系:A 长程任务的训练与评估,落在安全这一子类。可搬走的是「每个样本一份 rubric + S/U 双维 + 豁免条款压假阳性」的判分写法,以及 84 标签体系直接当策略库用;C、D 里那些主观项(音色自然度、播客内容是否合规且有用)也能照这个结构改成条目化打分,从而把「评委说了算」换成可复核的清单。
站点摘要出入:站点说评估可靠性与一致性「显著优于基线」,原文没做显著性检验,且 95.34% 只是 Hy3 既写 rubric 又当判官时对 236 条人工标注的一致率,换判官会降到 89.41%–90.25%。
25. 31,642 条五维推理轨迹覆盖 9,881 个实例:Qwen3-8B 平均分 30.82→41.40(+34.33%),与 Claude-Sonnet-4.5 的 40.49 持平
OmniSimulator: Aligning Small Language Models for Authentic Heterogeneous Behavior Modeling · arXiv:2610.29472 · 值得扫读
作者与机构:Jiawei Chen(中科院软件所中文信息处理实验室、中国科学院大学),Ruoxi Xu、Boxi Cao 等,合作方含快手科技(Kuaishou Technology)。
研究问题与核心方法:
用户模拟器要预测下一条行为:看视频、进直播间、点广告、下单、找客服,都发生在同一条轨迹里。
原生思维链不帮忙:Qwen3 各档开与不开思考基本持平,8B 是 30.82 对 30.77,14B 还从 31.72 降到 31.59。
OmniSimulator 先定五维结构化思维链:用户画像落地、历史行为状态、内容相关性对齐、决策模式识别、最终决策声明。
教师 GPT-OSS-120B 每个样本采 16 条轨迹(温度 1.0),只留答案与真实结果一致的,取概率最高、同分取更短的一条。
不同任务给教师看不同信息:二分类只做前向推理;连续值给粗区间;文本生成直接给真实话语,让推理解释它。
13,389 个源实例各采 16 条,留下覆盖 9,881 个实例的 31,642 条(73.8%),全参数 SFT 两个 epoch。 25
关键结果:
- Qwen3-8B 平均分 30.82→41.40,相对提升 34.33%;高出零样本 Qwen3-235B 的 32.11,与 Claude-Sonnet-4.5 的 40.49、GLM-4.7 的 41.46 同档(表 1、§3.2)。
- 提升集中在二分类:8B 的 Video Binary 17.29→30.24、Live Binary 20.29→32.40、Ads Binary 22.96→40.97(表 1)。
- 小模型同样有效:1.7B 平均 25.29→36.39,0.6B 22.25→33.50,两者都高于各自的开思考零样本(26.53、22.00)(表 1)。
- 消融(1.7B):完整 schema 二分类 28.80,去掉历史行为状态掉到 19.65,去掉用户画像 25.47,整份退回自由 CoT 只有 21.78(表 2)。
- 训练策略(8B):只学答案 31.62、自由 CoT 34.34、合成推理 37.85、去掉拒采样 37.44,完整 41.40(表 3)。
- 文本行为人工盲评:50.83 对 Claude-Sonnet-4.5 的 51.41,差值 95% 区间 [−1.42, 2.55];三位标注者 ICC(2,k)=0.74、Krippendorff's α=0.68(附录 B)。 25
证据与局限:原文自陈:只在单一短视频平台的留出用户上评,采集窗口与训练时间重叠,不证明跨时间或跨平台泛化;结构化轨迹是行为导向的监督,不是用户真实认知过程,还会继承教师偏置;连续值与文本任务直接给真实答案,存在事后合理化风险;schema 与拒采样各自的贡献没有在严格匹配条件下分离。我的判断:每个配置只训一次、没有种子方差,41.40 与 41.46 这种 0.06 分的差距不能当排序;9,881 条只来自 200 个用户,用户间异质性只能靠画像文本与历史日志表达,新平台要重采。 25
复现:https://github.com/icip-cas/OmniSimulator(论文称代码公开);训练数据来自快手内部轨迹,未随代码发布。
与目标研究线的关系:B 轨迹学习与自进化——把长程行为轨迹蒸成结构化推理轨迹再做 SFT,是「用轨迹教模型怎么想」的一种具体做法;同时它给 A 提供了离线评测基础设施(用模拟用户替代在线实验)。可直接搬走的是五维 schema 的字段划分、按任务类型决定教师能看到多少答案的做法,以及 73.8% 保留率的答案一致性拒采样。C、D 若要做听众/观众模拟,这套 schema 的「画像—历史状态—内容对齐—决策模式」骨架可以直接换词复用。
七、语音与音频线、播客线:本期为什么是零
上一节收的是文本侧的分支。频道盯的另外两条线本期在这个栏目里没有命中,原因写在这里,免得读者以为漏读。
TTS 生成与评估(C 线)0 篇。 语音与音频有自己的一栏,本期那 18 篇已在 10 月 22 日单独成篇。自然语言处理栏这 89 篇里,带语音字样的只有三篇,且都在识别与理解一侧:Omnilingual-MsASR 给全模态模型建长篇多说话人识别基准,覆盖六种语言、单段录音最长 30 分钟、场景最多 20 个说话人26;Gemma 4 那篇把 305M 参数的音频编码器权重冻住,只训 22.6M 参数的 CTC 读出层与 3.1M 的低秩适配器,做沙特与海湾阿拉伯语识别27;OSynth 造了一个含 570 小时会议音频的合成组织数据集,人类评分者仅凭 150–300 词的摘录分辨它与真实会议,准确率 56%28。三篇都不做合成声、也不评合成声,所以归入排除清单,不占 C 线名额。
播客生成与节目级评估(D 线)0 篇。 这个栏目里没有一篇做播客脚本、播客音频或多集节目的评估。核实路线是按提交日期检索 arXiv:
podcast generation 最新一篇是 2607.21961(2026-07-24,文档支撑的播客脚本忠实度);podcast script 最新是 2601.14903(2026-01-21,PodBench);audio drama 最新是 2610.18010(2026-10-13,Fish Audio Drama 3);在 cs.CL 分类里带 podcast 的最新一篇是 2610.25265(2026-10-18,SPARC,用播客转录做说话人与属性核验,属说话人验证而非生成)。这条线近三个月有产出,只是今天没有,本期不拿替代品充数。八、排除清单与本期可迁移结论
64 篇排除按理由分六组,编号列在每组末尾,组间不重复、合计 64 篇。
通用 NLP 训练与推理方法,15 篇——它们改的是解码、量化、蒸馏或预训练本身,不改变任务形态,也不碰四条线:2610.29013、2610.29136、2610.29210、2610.29527、2610.29545、2610.29255、2610.30066、2610.29424、2610.28895、2610.28838、2610.29681、2610.29352、2610.29410、2610.29843、2610.30067。
单点语言现象、表征分析与认知实验,16 篇——题目都在语言能力本身,无法迁移成 agent 的训练或评估口径:2610.28799、2610.28992、2610.29162、2610.29328、2610.29350、2610.29507、2610.29518、2610.29645、2610.29832、2610.29896、2610.29907、2610.29413、2610.28944、2610.29602、2610.28819、2610.29657。
领域应用、语料库与专业基准建设,20 篇——质量参差,但落点是法律、医疗、伦理、会议、语言资源这些具体领域,与四条线只共享方法论:2610.28772、2610.28767、2610.29073、2610.29188、2610.29254、2610.29767、2610.29926、2610.29943、2610.28823、2610.29207、2610.29477、2610.29606、2610.29968、2610.28710、2610.29338、2610.29097、2610.29165、2610.28840、2610.28787、2610.29339。
检索增强生成的内部机制,4 篇——组合性、遗忘、搜索动量、图路由,改的是 RAG 内部,不是 agent 的上下文决策:2610.29223、2610.29722、2610.29792、2610.29933。
单点安全与对齐机制,6 篇——单次判定的安全与检测,不覆盖长程执行面:2610.29727、2610.29922、2610.29785、2610.28897、2610.29318、2610.30006。
语音识别与理解侧,3 篇——上一节已说明,它们不做合成、也不评合成:2610.29455、2610.28673、2610.29319。
本期最值钱的三条可迁移做法,都能直接进项目,不需要复现整篇论文。
第一,记忆与接口的增益要先扣掉「上下文变长」。 Memory-Centric Continual Learning 给出的 ΔP 对照很简单:同一任务跑两遍,一遍带状态、一遍清空重置,差值才算记忆的贡献。MemoryTax 补的是另一半:把建库成本按整轮 rollout 记账,而不是按 token。两件事合起来,才能回答「这套记忆在 152 道题上回本了吗」。
第二,判官上线前先做变形测试,rubric 写到每条提示。 SANE 的六条行为要求(单调性、次可加性、可重复性、鲁棒性、动态范围、校准)可以直接当检查表;DiagSafe 的 S/U 双维加豁免条款,是把「评委说了算」换成可复核清单的具体写法。两篇都提醒同一件事:写 rubric 的人和判 rubric 的人不能是同一个模型,否则一致率里有一块是同源偏置。
第三,自进化的学习信号优先取已经算出来的那些。 MoE 的路由统计本来就在一次普通前向里,不需要额外 rollout,也不需要外部验证器;搜索接口的三件套(工件、工具、说明)不需要新数据,只需要能读轨迹的优化器;事件级信用最贵,要用它就得准备好跑完整下游问答。选哪一种,取决于你手上有多少可用的算力和多少可用的标注。
References
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
- 17
- 18
- 19
- 20
- 21
- 22
- 23
- 24
- 25
- 26
- 27
- 28
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.