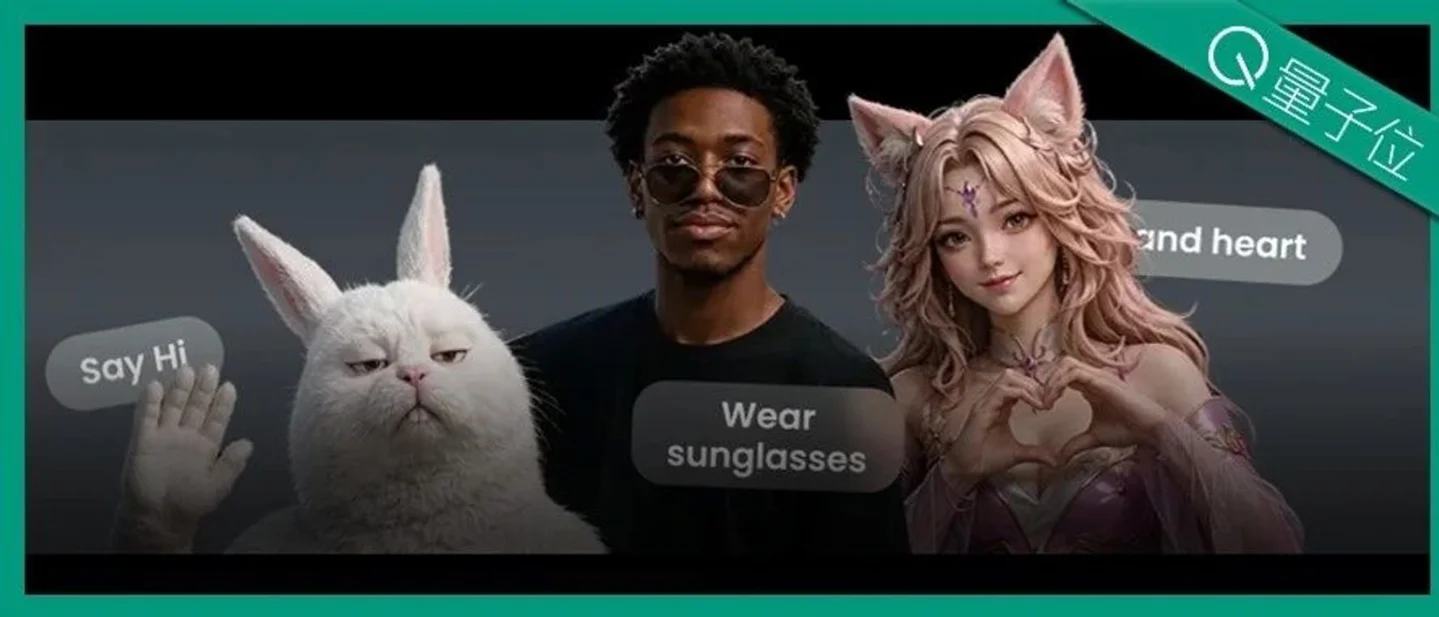
实时互动、实时改视频、探索空间视频,Vidu S2一次放了三个大招
量子位报道生数科技发布 Vidu S2:含实时交互模型 S2-Avatar 与实时视频编辑模型 S2-Editing,实测分辨率从 540p 升到 720p,并把实时生成与编辑的画面转成左右眼空间视频送进头显。

转载说明:本文转载自微信公众号「量子位」官方报道(官方账号 biz_id:MzIzNjc1NzUzMw),原文发表于 2026 年 9 月 15 日,作者署名“诺亚 发自 凹非寺 量子位 | 公众号 QbitAI”。原文链接:[量子位微信公众号原文](http://mp.weixin.qq.com/s?__biz=MzIzNjc1NzUzMw&mid=2247923437&idx=1&sn=0523d0d98c113a7671fbf52ee71595d6),技术报告可参考 Vidu S2: Real-Time Interactive, Editable, and Spatial Video Generation。
生数科技在 2026 年 9 月 15 日发布了 Vidu S2,发布当天就全量开放,官方说法是“不搞内测、不限名额” 1。
这一代包含两个模型。Vidu S2-Avatar 是实时交互模型,支持语音对话、语音控制数字人做动作,以及互动过程中随时输入参考图;Vidu S2-Editing 是实时视频编辑模型,可以改变视频里的服装、人物、背景和风格 1。
上一代 Vidu S1 是两个月前发布的,把数字人从“音频驱动口型+预设动作库”的传统模式,推进到能用语音控制数字人的行为、实现无限时长的连续互动。当时有用户把自家猫的照片喂给模型让它开口讲话,也有人把 Coding 界面传给模型,让它扮演“程序员鼓励师” 1。
三个大招:实时编辑、实时互动、空间视频
Vidu S2 这次放出三项升级,作用的对象各不相同 1。
- S2-Editing 作用在正在输入的视频上,可以实时换装、换角色、换背景、换风格。原文把它比作视频版的修图工具,也是这次最值得先上手的升级。
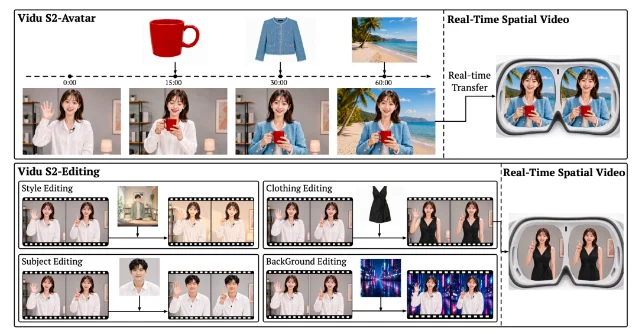
- S2-Avatar 把实时互动的角色升级到 720P,还能接住互动中途递来的物品参考图,按指令拿起、展示,完成更丰富的肢体表演。
- 实时空间视频探索 把生成或编辑后的视频转换成左右眼画面,送进 VR 头显,让互动多出一层纵深感。
实测:动作更听指挥,画面也更清楚
量子位把上一代请出来做了同屏对比。同样让数字人跳舞、转圈和跺脚,左边的 S1 没能完成要求,右边的 S2 跟着指令动了起来。以前 S1 主要是聊天互动,S2 把大幅度的身体动作也安排上了 1。
画面清晰度也上了一档:S2-Avatar 的实时输出分辨率从上一代的 540p 提升到 720p,角色的面部和衣服细节更完整 1。
互动过程中还可以随时递给数字人一张新图片,让它拿起图里的物品、换上指定的衣服,或者进入新的场景 1。
S2-Editing 的实测对象是一位正在接受采访的女士。模型把她的服装秒切成不同款式,人物动作连贯,脸部一致性保持得不错,服装随动作产生的形变也接近真实;最后一套驼色大衣的袖口半遮住她佩戴的首饰,这个细节处理得比较自然。原文也点了两处瑕疵:第二套衣服在呈现色块时仍有一点涂抹感,人物戴帽子时头发仍有一点穿模 1。
对正在进行的画面,S2-Editing 提供四类实时编辑 1:
- 实时人物换装,对应店家上新和穿搭博主的需求;
- 实时更换背景,足不出户换场景;
- 实时更换主体角色,把镜头里的人替换成别的形象;
- 实时风格渲染,给整段画面套上新的画风。
这些能力落到直播场景里,就是观众在弹幕里说想看看主播穿恐龙服,下一秒主播可能真的穿上了 1。
69 天完成一次大版本更迭
从 S1 到 S2,中间隔了 69 天 1。
Vidu S1 和 Vidu S2 的全链路研发,由清华大学朱军教授的博士生、生数科技流式视频生成与推理负责人张金涛负责 1。
实时交互视频走的是另一条路:它的每一帧都根据用户输入现场算出来,模型的生成速度必须跑赢播放速度,否则用户看到的就是 PPT 式的卡顿。要让速度达标,就得重塑整条生成链路。团队用 SageAttention 等技术给计算提速,再通过多 GPU 协同调度减少模块之间的等待 1。
空间视频:把左右眼画面送进头显
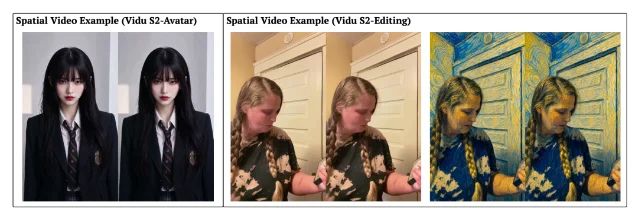
空间视频是一种能呈现三维立体深度和沉浸感的立体视频格式。它基于人的双目立体视觉原理,用两个不同视角(例如主摄和超广角摄像头)同时记录影像,把景物的深度信息一并存下来。观看它需要支持空间计算的设备,比如 Apple Vision Pro;在普通设备上播放,它只是一段普通的二维视频 1。
Vidu S2 在这件事上给了两条路径:基于 S2-Avatar 可以实时生成空间视频,基于 S2-Editing 可以实时编辑空间视频。用户能把一段普通视频实时转成空间视频,也能把通过头显摄像头看到的真实物理世界当成画布来创作 1。
团队对现阶段的边界说得很直接:
头显对分辨率和延迟的要求极其苛刻,画面糊了会晕,延迟高了转头和画面会“打架”,这块还在持续优化中。
按照原文的规划,下一步是把固定视角扩展到全景空间视频,让你转头就能自由探索 AI 生成的场景 1。
技术揭秘:怎么做到“边播边改”
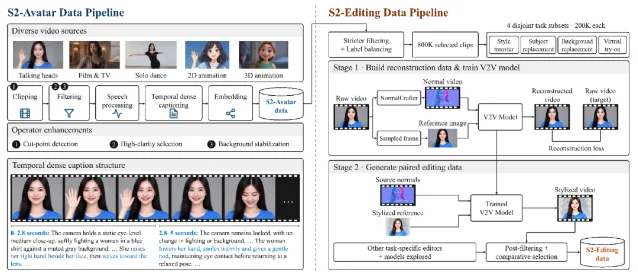
数据处理上,团队补充了舞蹈、二维动画和三维动画等训练素材,让数字人能表现出更丰富的动作与表情,还对符合条件的视频做了背景稳定处理,在保留大幅动作的同时减少镜头运动的干扰。标注方式也围绕连续互动重新设计:按事件发生的顺序记录动作何时开始、带来什么变化、结束后人物处于什么状态 1。
流式训练是另一个难点。这个过程像一场接力,下一段画面接着上一段往前走,前面的一点偏差也可能被一路传下去。Vidu S2 先用 Hybrid Forcing 学会逐段生成,再引入 Self-Replay Forcing:先让模型连续生成一段视频,再给生成结果分块加噪,做一次可训练的因果回放。这次复盘把前后片段连起来训练,让后续片段的训练反馈也能影响较早片段的表示,模型因此学会在前面出现偏差时把后面接稳、接顺 1。
画质与实时性靠 Backbone-Refiner 两阶段架构分头解决:Backbone 先在低分辨率下生成画面的主体结构、运动和语义内容,确定画面里有什么、正在做什么;Refiner 再负责细节。两者通过异步流水线并行推进,细节重建与后续内容生成不用排队,模型在 720P 输出下仍然不掉帧 1。
换装和换背景能做到“边播边改”,靠的是时间戳对齐。用户中途发来一张衣服图片,模型需要知道的不只是换成什么,还有从什么时候开始换。Vidu S2 重新设计了位置编码,把参考图的注入位置与时间戳对齐,让新条件从指定时间点开始生效,同时保持运动与光照的连续性 1。
此外还有一个 VLM Agent 充当盯着现场的执行导演。实时互动时用户可能接连提出要求,模型在执行下一步之前得先判断画面里现在有什么、人物正在做什么、上一条指令执行完了没有;VLM Agent 持续解析已经生成的画面、跟踪这些状态,再据此规划后续生成,并在合适的时机调整生成条件 1。
最后是强化学习。双向阶段采用 DPO,改善画质、表情、动作自然度和音画同步,为后续流式训练提供更强的教师模型;流式阶段采用 Streaming NFT,直接优化承担持续生成任务的因果模型。模型先生成自己的视频轨迹,再沿用 Self-Replay Forcing 的回放思路做奖励优化,让训练状态更贴近实际运行时的状态 1。
从 S1 的语音互动,到 S2 更清晰的画面、更准确的动作响应、随时加入的参考图和实时编辑,再到空间视频,原文最后给出的判断是:一个虚拟数字人能理解你此刻在做什么,并且立刻跟着指令行动,这在两年前听着还挺科幻,现在它成了直播间里随手一点的功能 1。
References
- 1实时互动、实时改视频、探索空间视频,Vidu S2一次放了三个大招
mp.weixin.qq.com
- 2Vidu S2:全球领先的实时交互与编辑模型
vidu.cn
- 3
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.