DeepMind 的 AGI 经济学:能力定水平,协调定规模,而今天的位置只有一个借来的读数
Google DeepMind 三位作者用一篇长文和一份 108 页论文,把 AGI 的经济影响拆成能力与协调两个参数:能力抬产出水平,协调决定公司能长多大;本篇逐条核到原始文件,指出唯一把今天定位在门槛哪一侧的读数,是论文从别人的一篇博客里转引的。

DeepMind 交出的这份 AGI 经济学,把「AI 会不会改变经济」拆成两个可以分别取值的量:能力决定每个人的产出水平,协调决定一家公司能长到多大。
前者一路在涨,后者还在门槛之下。而唯一一个把今天放到门槛哪一侧的数,这篇长文里没有,它出现在配套论文第 52 页;论文又是从别人的一篇博客里转引的。
01 先看清这是谁的判断
北京时间 10 月 29 日 22 点 50 分,Google DeepMind 的研究所平台挂出一篇长文。
平台叫 DeepMind Institute。文章标题是《The Economics of Intelligence》,副题问的是 AGI 何时、以何种方式带来经济转型。1
三位作者:AGI 经济学总监 Alex Imas、研究科学家 Andrew Koh、联合创始人兼首席 AGI 科学家 Shane Legg。1
前两位在论文首页标了兼职单位:Imas 在芝加哥大学,Koh 在哥伦比亚大学。2
DMI 这个平台今年 9 月 16 日上线,到这篇为止共 11 篇;同一天它还发了另一篇《What is Work For?》。1
Legg 在 X 上把两篇打包推了出去。3
经济这个题目对 DMI 不算新:此前已有《Economic Policy for AGI》等几篇。1
文章末尾、作者栏之上有一段免责声明,每个字都要紧:
The DMI is a platform, started by researchers from Google and Google DeepMind, to publish and discuss creative, deeply informed ideas about a world with AGI. DMI pieces are intended to serve as conversation starters, reflecting the author's ideas and research, and should not be read as Google's official view.
(DMI 是 Google 与 Google DeepMind 的研究者发起的平台,用来发表与讨论关于 AGI 世界的想法。DMI 的文章是讨论的起点,反映作者自己的观点与研究,不应被读作 Google 的官方立场。)1
配套论文同日上线,叫《Organizing Intelligence》,108 页,PDF 元数据里的生成时间是 10 月 29 日。2
论文首页脚注也写了两句:本文表达作者个人观点,不代表所属机构;这项研究只供学术讨论,不构成对 Google 当前或未来业务的预测、路线图或实证陈述。2
同一处脚注还交代了工具:论文在数学论证与一致性校对上有 AI 系统参与。2
所以这篇东西有两个层次,读法不同。模型那半是形式化的,可以逐条反驳;叙事那半是三个人的判断,不是 Google 的立场。
02 模型里只加了一个新零件
先看它搭的那个玩具经济,小到可以手算。2
一共 14 个人,三种角色:6 个程序员、6 个写手、2 个协调者。
程序员编程 9、写作 1;写手反过来;协调者两项都是 1。第三项是协调能力:程序员与写手各 0.75,协调者 0.97。
不参与生产的人,可以拿 1/4 的外部收入。AI 是另一种投入:能力向量任由设定,副本按算力成本 1 无限租用。
第一个量叫能力。它由两项技能的均值取调和平均,替代弹性 1/2。2
调和平均的意思是短板定产出:一个程序员单干,强项 9 被写作的 1 拖成 1.8。
第二个量叫协调,写成一个参数。它的作用只有一个:决定企业每多一个人,人均产出是往上走还是往下掉。
严格说,进规模函数的是产出对规模的尾部指数;在论文用的那个 CES 例子里(两种技能的替代弹性固定为 1/2),这个指数恰好等于企业的平均协调能力。
所以下文提到的 0.97 与 1.60,量的是同一个刻度:前者是两个人类协调者的值,后者是论文在 supercooperative 那一档给 AI 设的协调值。
论文里最要紧的一句话很朴素:给定企业的成员构成,能力的变化不改变最优规模,协调才改变。2
这句话就是整篇文章的分水岭。过去所有「AI 超越人类专家」的榜单,测的都是第一个量;而企业能长多大,由第二个量决定。
原文把这一点压缩成一句:单个 AI 智能体是错误的经济对象。1
03 三个可以自己复算的结果
先把玩具经济里的算术走一遍,因为后面那些大结论全靠它撑着。
只有程序员时,六个人合成一家企业,人均 5.0;各自单干,人均 3.6。
能力 1.8 是标量,产出要靠价格换算,两个数并不冲突。2
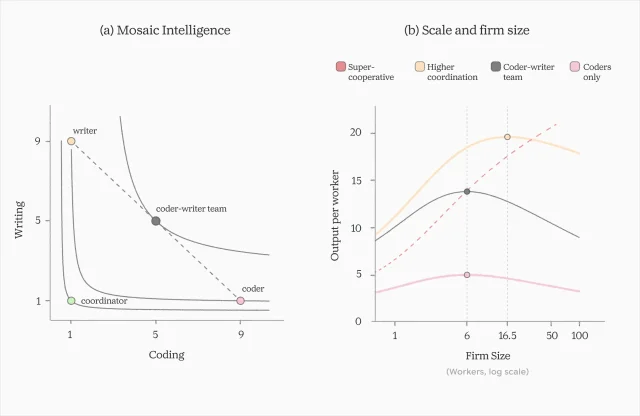
如果把程序员加倍到十二个,均衡不是并成一家:分成两家各六人,合计 59.5;并成一家十二人,合计 57.2。协调摩擦吃掉了分工收益。
加入写手之后,互补配对把团队能力从 1.8 抬到 5.0,人均工资从 1.49 涨到 4.13(再往后加入协调者,专家的工资是 4.15)。2
程序员一行代码没多写,工资接近三倍。多出来的那部分,来自组织。
最后加两个协调者。最优规模从 6 变成 7,人均产出 13.0;协调者拿到 2.41,接近外部选项的十倍,也高于程序员与写手。2
而同一个协调者单干,只值 0.70:按任何单项技能榜单排名,她是这个经济里最弱的工人。
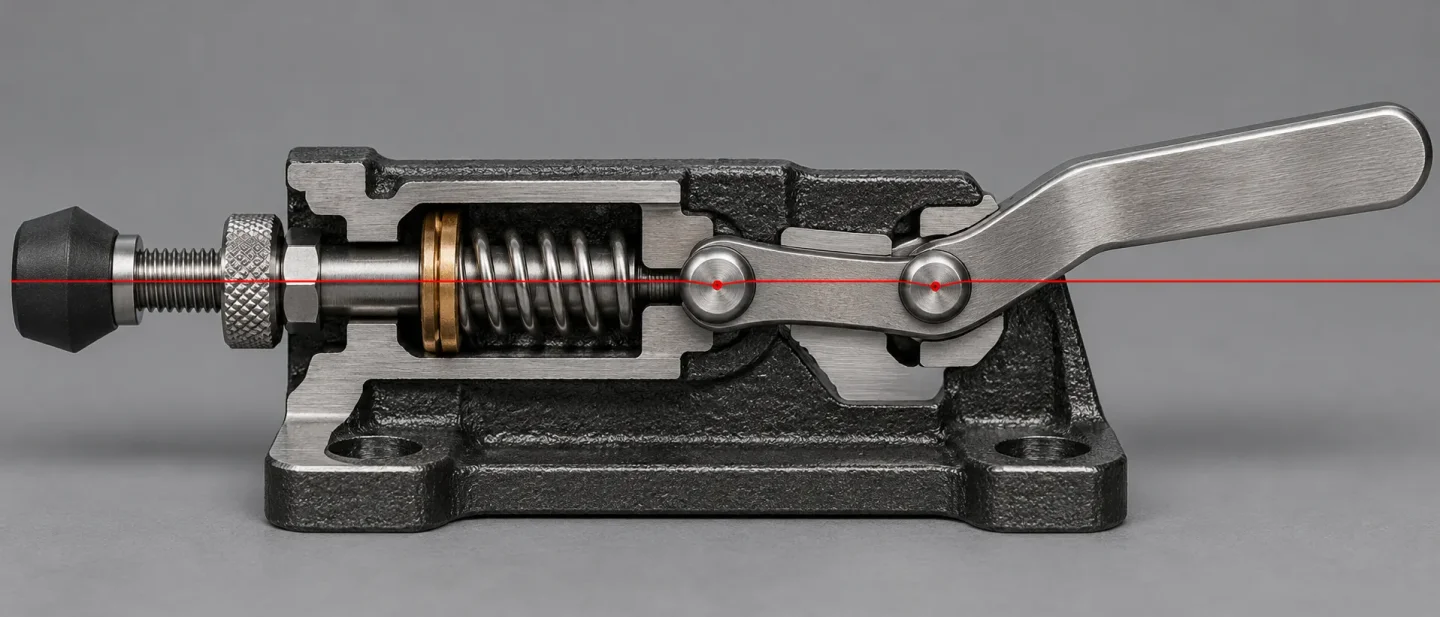
协调者贵,因为她拧的是那个决定斜率的旋钮。
04 那条线在 1 上,而 1 恰好是教科书的假设
四种「能力体制」听起来像四个阶段,其实是两个参数各取两段的四个格子。而格里最关键的那条边界,正好落在经济学最常用的那个假设上。
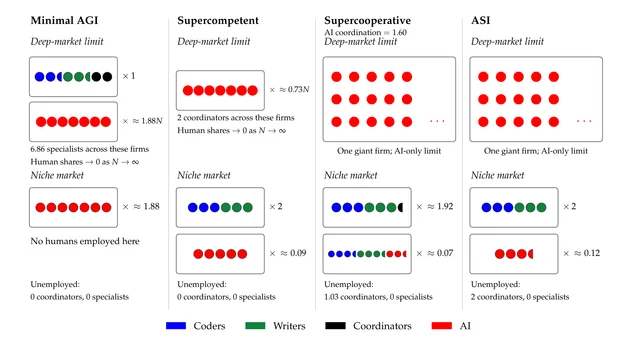
横轴是能力:AI 是否超过最好的那个人(示例里是 9)。纵轴是协调:AI 的协调参数是否超过 1。2
能力在人类包络之内、协调不到 1,是 minimal AGI;能力超过所有人、协调仍不到 1,是 supercompetent。
协调越过 1、能力没超过所有人,是 supercooperative;两样都越过,是 ASI。
1 这个数不是随手取的刻度,它是三种规模回报的分界。2
低于 1,加人带来摩擦,企业规模有上界——这就是科斯问过的那个问题:既然企业能省成本,为什么不是一家企业干完所有事。
恰好等于 1,人均产出随规模上升,但只逼近一个有限的天花板(示例里是能力乘以 e 的 7/4 次方),永远取不到;企业规模失去有限的最优解。
严格大于 1,人均产出随规模无界增长,科斯的上界作废。
论文专门提醒:在 1 这个点上,人均产出封顶、企业规模没有有限的最优解;这与严格大于 1 必须分开处理。2
这一层还带来一个不太被注意的推论:教科书里的任务模型,是这个模型在 1 上的特例。
论文第 7.1 节的标题就叫「把任务模型嵌套进来」,第一句是:在规模报酬不变下做最优任务分配,可以还原出任务经济。2
附录 C 把理由说得更直白:在规模报酬不变的世界里,企业的边界不影响经济效率,因为合并企业可以让工人和机器保留原来的任务分配,产出不会更低。2
换句话说,那些预测「AI 会平滑地改变工资、不会突然改变市场结构」的标准模型,前提就是站在 1 这个点上。2
而博客里那个「突然跳变」,有一个必须交代的限定。2
论文在讨论那张工资跳变的图时自己写明:黑线上的跳变描述的是大市场极限,它不构成有限市场里存在跳变的证明。
附录里还有一句同类的话:数值记录不构成有限市场均衡收敛到这些配置的证明。
| 体制 | 能力条件(示例) | 协调条件 | 企业规模 | 工资方向 | 就业 |
|---|---|---|---|---|---|
| minimal AGI | 人类能力均值到 9 之间 | 人类均值协调到 1 之间 | 有上界:纯 AI 企业约 7 个副本,人类企业约 7 人 | 专家 4.15→2.90,协调者 2.41→1.30 | 14 人全在深度市场,无失业 |
| supercompetent | 超过 9 | 不超过 1 | 仍约 7 个副本,人数可能缩减 | 专家 0.394,协调者 0.476 | 无失业,专家转去利基市场 |
| supercooperative | 不超过 9 | 超过 1 | 无界,一家企业吃掉深度市场 | 专家 0.414,协调者 0.250 | 1.03 个协调者失业 |
| ASI | 超过 9 | 超过 1 | 无界,利基市场也被 AI 企业接管 | 专家 0.269,协调者 0.250 | 2 个协调者失业 |
表里四行都取自配套论文 Table 4(第 105 页)与第 10–11 页的体制配置;工资与就业是模型算出的均衡值,不是观测。2
05 今天站在门槛的哪一侧,只有一个数
论文第 52 页有一句,是全篇唯一把今天放到门槛某一侧的话:多智能体一起干活时,产出对团队规模的弹性落在 0.48 到 0.68 之间,而门槛是 1。2
这个数不是论文自己测的。它引的是 Toby Ord 在 9 月 21 日发的一篇博客,标题叫《Swarm Scaling》,标注「8 分钟阅读」。4
Ord 也没有做实验。
他把 OpenAI 7 月 9 日 GPT-5.6 发布页上的三张图拿来:横轴是总 token,纵轴是分数,各有 1 个、4 个、16 个智能体的曲线。
在这些曲线上取同 token 预算的点,斜率比就是弹性。
三个榜给出三个数。
BrowseComp 0.68,90% 区间 0.63 到 0.76。
SEC-Bench Pro 0.57,0.52 到 0.61。
Terminal-Bench 0.48,0.40 到 0.57。4
他把这个弹性写作 λ。
他自己的说明是:这三个 λ 由 Claude Opus 5 跑「更仔细的回归」得出;智能体是同构复制品;Terminal-Bench 那档只测到 4 个。4
把弹性换成日常话:取中间那个 0.57,团队从 1 个加到 2 个,产出只多 48%,人均掉两成六;取 0.48,只多 39%,人均掉三成。
值得记一笔的是同一个数在两边被读成相反的意思。
论文用它说:协调远在门槛之下,所以经济安静。2
Ord 自己的落点是:这个 λ 与经济学对人类团队的估计、与智能爆炸模型的默认值几乎一致,他原本指望 AI 的 λ 更低、爆炸更不可能,「但看来并非如此」。4
同一个 0.48 到 0.68,一边说还差得远,一边说已经够快。差别不在数,在拿它跟什么比:跟 1 比是距离,跟人类团队比是齐平。
论文对这个估计有一句自我限定,藏在脚注 38:这套算法没算团队提速的价值,所以很可能低估了 AI 团队的经济价值。2
而它没有说的另一半是:这个数只覆盖三个检索与编码类榜、同构智能体、最多 16 个副本。4
另有一份基准,论文没有引,但正好在测同一件事。
CooperBench 给两个智能体各派一个功能:单独都能做,合并会冲突;只有两边测试都过才算成功。652 个任务,来自 12 个真实开源库。5
结果是协作之后普遍掉 20 个百分点上下。
GPT-5 从 48.31% 掉到 27.95%,Claude Sonnet 4.5 从 47.1% 掉到 25.9%。
Gemini 3 Flash 从 48.6% 掉到 26.2%。5
论文作者给的归因分三类:期待不一致 42%、承诺不一致 32%、沟通失败 26%。5
所以「测组织的基准」不是空想,是已经有人在做的题目。它们现在测的是两个智能体,还不是一家公司。
06 人被挡在外面,不是因为不够强
这套模型里最不舒服的一条是:人类被挤出大企业,不是因为能力输给机器,而是因为会把平均协调拉下来。
脚注 21 特意声明,协调这道门槛是绝对刻度,不要求 AI 比最会协调的人更会协调。2
示例经济把这句话算得很清楚。两个人类协调者的协调能力是 0.97,全人类平均 0.781,AI 到 1.60 就已经算 supercooperative。2
机制不是「人太弱」,是平均值的算术。把 0.97 的人塞进一群协调 1.60 的智能体里,企业平均协调被拉低,而规模越大,这个拉低越贵。2
论文那张图(Figure 26)写得很直白:人类雇主消失,人类工资掉到外部选项;而且市场越大,跌得越陡。2
Table 4 里能看到工资的走向。supercompetent 那一档,协调者 0.476,比专家的 0.394 还高。
到 supercooperative,协调者正好掉到 0.25——就是外部选项;专家还有 0.414。2
到了 ASI,协调者的就业人数是 0。她在上一档比专家更值钱,在下一档最先出局。
这里要补一句克制的:0.97 与 0.781 都是作者设定的示例值,不是谁测出来的。整套机制成立与否,取决于真实的人类协调值,而那个数现在没人测。
07 博客里最亮的那个数字,论文里没有
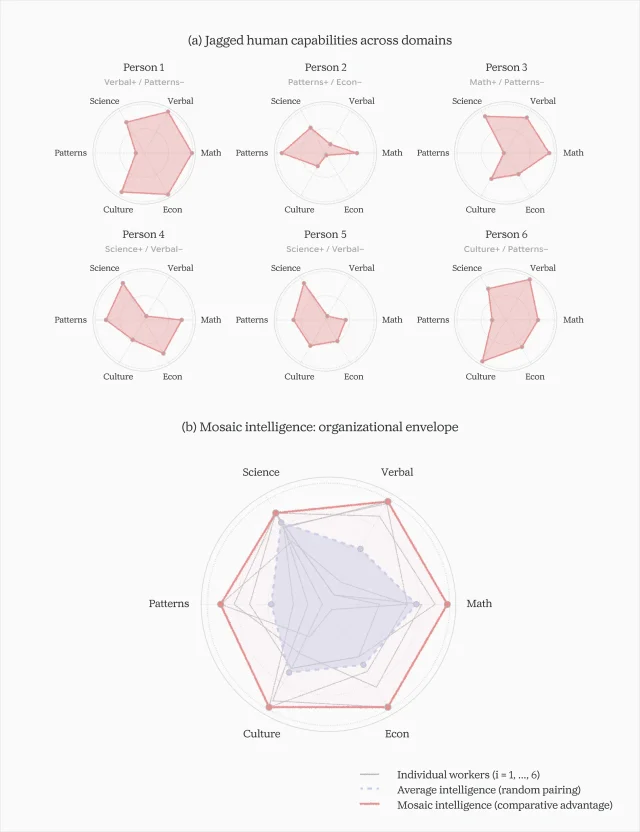
博客正文有一处看起来像实验的结果:给 100 个人做了六个领域的测验,图上展示其中六位;按互补配对组队,表现比随机配对高 32%。配套论文里找不到它。
我按关键词检索了论文全文,包括参考文献:没有「100 人」的测验,没有六个领域的问卷,没有 32%,也没有任何被试、实验或田野数据。2
论文里那张 Figure 1 不是这六个人。它是理论上的能力等值线,横轴编程、纵轴写作,标出程序员、写手、协调者三个位置。2
这不影响主论证。模型的结论靠的是九个命题,不靠那个 32%。
但它说明了这篇的分量在哪:在模型上,不在数据上。
08 证据链上的六处拼缝
「能力已经超过专家、协调还远没到」这句话,是论文第 7.2 节的全部经验基础。逐条回到原始文件之后,几处数字是把不同口径拼在一起的。
先看能力那一侧。
GDPval 那句「44 个职业、前沿模型打平或胜出 48% 到 71%」,是两个数拼起来的。
下界 47.6% 来自论文本身:Claude Opus 4.1,220 个任务的金标子集,按交付物评比。6
上界 70.9% 来自 OpenAI 2025 年 12 月 11 日的 GPT-5.2 发布页,口径按任务计。7
Mercor 那句「67% 掉到 24%」也是两批不同的任务。
67% 出自 APEX:四个岗位、每岗 100 例,GPT-5 拿下 67.0%。8
24% 出自 APEX-Agents:三个岗位、480 例,最高分是 Gemini 3 Flash,而且这批里没有医学岗。9
两个模型、两批任务都不一样,一个「掉」字读不出因果。
METR 那句「2 小时冲刺是人类的 4 倍、32 到 48 小时的项目只有一半」,跨了两个基准。
4 倍出自 RE-Bench,每环境 2 小时总预算。10
「一半」出自 PaperBench:21.0% 是 20 篇全量,41.4% 是 3 篇子集的人类基线。11
同子集比较是 26.6% 对 41.4%,约六成五,不是一半。
再看协调那一侧。
论文把「错误放大 17.2 倍」与「41% 到 87% 的工作流失败」(原文如此,Cemri 那篇给的是 41% 到 86.7%)写进同一个括号引注。
往前查:17.2 倍只出现在 Kim 等人的论文里,是 trace 级、独立架构相对单智能体基线的放大。12
41% 到 86.7% 只出现在 Cemri 等人的论文里,是七个开源多智能体框架的失败率;Yang 等人那篇两个数都不提供。13
论文开头讲四种体制那一段(第 9 页)其实把这两个数分别归给了 Cemri 与 Kim;拼在同一个括号里的,只有第 52 页这一处。
劳动市场那一侧也有两处。
「时间节省只有 3% 到 7% 传导到工资」:这是工人自己估的感知分解,同一篇论文的因果估计是收入与工时的精确零效应,可排除 2% 以上的变动。14
「起薪下降 4.2%」:4.2% 是初级岗位平均工资的降幅,起薪本身的降幅是 10.76%。15
这些是引用层面的拼接,不是结论层面的编造。但它们决定了一件事:能力那一侧是三处把不同口径接在一起,协调那一侧是一次归因并置,劳动市场那两个数一个把感知当传导、一个把平均当起薪。整套经验基础里,只有那一个博客插值,是把今天放到门槛某一侧的。
09 同行说的「协调」,不是同一个层级
这个词最近很热,但四个人用的是四个层级。混着读,就会把这篇当成又一份「AI 要来了」的预测。
Dario Amodei 的《We Must Pace the Frontier》里,协调指的是公司和公司之间、国家和国家之间:常驻的第三方评估者、同业标准、跨国协议。
他要的节奏是慢一点,理由写在原文里——以更有节制的节奏工作,可以把运营做得远为出色。16
这篇论文里的协调,是企业内部智能体之间的传递损耗:交接口径、上下文、谁检查谁。
OpenAI 那篇内部观察给的是这一层的实测。
研究组织里每 1 个「人类工作日」对应 3.1 个「智能体工作日」;过去半年,成功的 4 到 8 小时任务里,过半需要至少一次人工介入。17
这正是这篇论文判断的经验侧写:活儿被大量分身干了,收口还得靠人。
OpenAI 十月底那篇《The future of the firm》问的是另一个问题:AI 放在组织图的哪一格——脚下、身边、还是夹在中间。18
这篇问的是:这一格的加入,会不会把组织的规模函数改形。
Yann LeCun 的落点又在别处。他把岗位被替代看成常态,把补偿划给财政与社会政策,2024 年 1 月那条帖写得很干脆。19
这几个说法不冲突,因为它们量的不是同一个东西。而它们之中,只有 DeepMind 这一篇把「协调」写成了可以取值的参数,于是也成了唯一能被证伪的那个。
10 三十万次浏览,四条评论
发布面本身也是一条信息:这篇在 X 上不算冷,在技术社区里不算热。
Imas 的帖子拿到约 3,700 个赞、30 万次浏览,正文以一段 20 秒视频收尾。20
他在帖里点了两条要点:要更紧地追踪智能体的协调能力;AI 的影响会先出现在工资上,后出现在市场结构与就业上。20
Legg 把这篇与同日另一篇打包推,499 个赞。3
Hassabis 只转,不加一个字,6,000 多次浏览。21
媒体侧只有一条快讯:MTS 的报道,18,000 多次浏览。22
Hacker News 上,这条帖子 15 分、4 条评论。唯一的实质反对来自用户 bob1029:「协调是一种税,你不该去追它。」23
这句话其实戳到了模型的软处。税是可以省的,能力是只能等的;如果协调更像前者,「等它跨过 1」就不会自然发生。
11 该盯什么
论文结尾没有给时间表,给了四条测量建议。这比预测有用。
第一条:固定每份副本的算力,看产出怎么随副本数增长;跨模型代际测同一条曲线。这正是 Ord 那个估计缺的东西。2
第二条:企业层面同时记工资支出与算力支出,看两者比例怎么变。2
第三条:记企业规模分布的截面,判断是「很多瘦公司」还是「少数巨公司」。2
第四条:用雇主—雇员面板,看不同技能画像的人往哪类企业里流。这条是用来把「技术效应」与「重组效应」分开的。2
读者一侧,三个信号按先后排。
最近的是协调类基准:CooperBench 这种双智能体基准有没有出现跨代跃升,比任何单项能力榜单都更能预示结构变化。5
其次是工资结构:起薪与初级岗的价格先动,总量后动。15
最后才是企业规模分布。
有一处必须说清:论文把「工资先动、结构后动」当成模型的含义,没有给出支持这个时序的实证。2
而我查到的当前证据是两种都有:Humlum 与 Vestergaard 用丹麦的行政数据做的那份,在收入与工时上是精确零效应,变化发生在任务与职业结构里;另一份测到初级工资与起薪下降,就业却没有可检测的变化。14
两种都能装进这个模型——重组项本来就可正可负。只是「先工资后结构」这句话,现在还是推论,不是发现。
回到那篇论文本身。它最值钱的地方,是把一句人人都说的话——「AI 强不等于经济会变」——拆成了两个可以分别观察的量;而它给出的那个决定性读数,眼下只有一个博客里的插值。
一份把门槛写得这么清楚的论文,最该被追问的不是「会不会」,而是「怎么测」。
References
- 1The Economics of Intelligence · DeepMind Institute
institute.deepmind.com
- 2Organizing Intelligence · Imas, Koh, Legg
storage.googleapis.com
- 3
- 4Swarm Scaling · Toby Ord
tobyord.com
- 5CooperBench · Khatua et al.
arxiv.org
- 6GDPval · Patwardhan et al.
arxiv.org
- 7Introducing GPT-5.2 · OpenAI
openai.com
- 8
- 9
- 10RE-Bench · Wijk et al.
arxiv.org
- 11PaperBench · Starace et al.
arxiv.org
- 12
- 13
- 14
- 15
- 16We Must Pace the Frontier · Dario Amodei
darioamodei.com
- 17Research acceleration · OpenAI
openai.com
- 18The future of the firm · OpenAI
openai.com
- 19
- 20
- 21
- 22
- 23Hacker News 讨论 · item 50299212
news.ycombinator.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.