AI 早报|2026年8月21日:模型路由、智能体防护与科学就绪度成焦点
Ramp Router、英国 NCSC、香港运输署与两项研究共同显示,AI 正从模型能力竞争进入路由、权限、公共流程和现实就绪度的细分管理。
本期覆盖北京时间 2026 年 8 月 20 日 07:30 至 8 月 21 日 07:30。
这个窗口的共同信号不是又一个模型分数,而是 AI 部署链条开始被拆成可管理的部件:Ramp 把模型选择做成路由层;英国国家网络安全中心(NCSC)把网络权限、日志和停机能力列为智能体部署前提;香港运输署把大语言模型接入牌照审核和交通控制;两项研究则分别提醒,科研基准的成熟度和单次实验结果都不能直接等同于现实就绪。
五条速览
| 主线 | 事件 | 一句话结论 |
|---|---|---|
| 公司/模型基础设施 | Ramp 发布 Router | 一个 API 可以在多个模型之间按成本、延迟、质量和可靠性路由请求,但数据保留仍需单独配置。 |
| 监管/治理 | 英国 NCSC 发布智能体 AI 网络风险建议 | NCSC 把沙箱、最小权限、可观测性和紧急停机列为临时部署建议,但这不是新法律。 |
| 公共部署 | 香港运输署公布 AI 效能提升项目 | OCR 已进入部分牌照服务,大语言模型审批项目仍在筹备,九成自动审批是目标而不是结果。 |
| 研究/生物 AI | 欧盟 JRC 分析 480 个生物 AI 模型 | 蛋白质模型的科研成熟度较高,但数据、验证、治理和真实部署就绪度仍落后。 |
| 研究/粒子物理 | ATLAS 更新双希格斯产生分析 | Transformer 分析把非共振双希格斯搜索推进到更高灵敏度,但结果仍不足以证明超出标准模型的新物理。 |
1. Ramp 发布 Router:模型选择开始变成独立的成本控制层
一句话结论:Ramp 的 Router 用一个 API 在多个模型之间按质量、延迟、成本和可靠性做请求级路由,但它并没有自动解决数据治理问题。
关键事实
- Ramp 的官方公告标注为 2026 年 8 月 19 日,但页面没有给出时区;TechCrunch 报道将启动描述为当地 8 月 19 日晚,并在北京时间 8 月 21 日 00:46 发布报道,因此本文把它纳入本期窗口。Router 是一个统一入口,开发者可以在不重写应用的情况下评估和切换模型。产品提供 Flex tier、Shadow models 和基于自定义基准的 Benchmark Routing,还能记录模型、供应商、服务层级、token、延迟、成本与回退尝试。
- Ramp 的官方页面称,Router 已经用于自身生产流量,并使自身 AI 成本下降 30%;这个数字是公司自述的内部结果,不是独立测量的行业平均值。TechCrunch 的报道显示,产品当时仅向美国用户开放,服务在 2026 年底前免费,但用户仍需承担模型推理费用,并获得 26 美元额度。两页对公开范围的表述不同,本文不把「全球可用」作为已证实事实。
- Router 的隐私声明允许账户配置为不保留输入和输出,但这不等于上游模型提供商也实行零数据保留。被标记为可能违反服务条款或法律的内容,即使关闭内容存储,Ramp 仍可能为调查保留最长 30 天;提供商的保存期限还取决于模型、访问路径和账户设置。Router 隐私声明明确写出了这个边界。
为什么重要
模型路由把「选哪个模型」从一次性的工程选择变成了持续的运营策略。企业接下来需要比较的,不只是 token 单价,还包括质量门槛、回退规则、延迟、日志和数据流向;Router 能提供前四类观测,但用户仍要分别核对 Ramp 和各模型提供商的保留政策。
2. 英国 NCSC 给智能体部署划红线:沙箱、日志和停机能力不能缺席
一句话结论:英国 NCSC 发布的是一份面向系统设计者和运营者的临时实务建议:智能体的自主程度越高,组织就越需要把访问范围、人工监督和应急停机做成技术控制。
关键事实
- NCSC 的原始文章于 2026 年 8 月 20 日发布。NCSC 说,正式指导仍在制定中,这篇文章是基于现有研究的 interim practical advice,不是新的法律或强制合规规则。
- NCSC 建议组织先确定智能体需要多大自主权,再识别提示词、工具、网络、计算资源、凭证和数据可能造成的「爆炸半径」。模型自身的安全机制只能作为基础层,不能替代应用侧的额外防护。
- 对高风险任务,NCSC 建议使用隔离或受控的沙箱,默认拒绝网络流量、通过 allowlist 放行必要连接,并限制智能体的凭证权限和有效期。NCSC 还建议把智能体活动纳入安全运营,记录并保护代理轨迹、沙箱访问日志和网络流量,使活动可归因、可审计。
- NCSC 把人工监督分为 human-in-the-loop、human-on-the-loop 和 human-out-of-the-loop 三种形态,并建议高风险场景保留人工监督与技术控制的组合。组织还应保留能随时「pull the plug」的紧急停机能力。
为什么重要
这份建议把智能体的风险从「模型会不会拒答」转移到「它能访问什么、谁能发现异常、谁能及时停止」。对于准备把智能体接入生产系统的团队,沙箱边界、短时凭证、不可篡改日志和停机流程比一段更长的系统提示词更接近实际安全底线。
3. 香港运输署公布 AI 项目:九成自动审批仍是目标,不是结果
一句话结论:香港运输署已经在部分牌照服务使用 OCR 核对文件,并计划把大语言模型用于更多申请的自动识别、比对和核实;官方公布的审批比例与时长是项目目标,不能写成已经达成的成效。
关键事实
- 香港运输署在 2026 年 8 月 20 日 12:16 发布官方新闻公报。公报称,车辆牌照续领、驾驶执照、国际驾驶许可证和跨境驾驶计划牌证等部分服务已经使用 OCR 核对网上申请文件。
- 运输署正在筹备于 2026 年底推出「牌照申请审批易」。该项目计划使用大语言模型自动辨识、比对和核实车辆牌照续领,以及「港车北上」「粤车南下」申请文件。运输署的目标是把网上续领车辆牌照的自动审批比例提高到超过 90%,把最长 10 个工作天的审批时间缩短到 1 个工作天;跨境驾驶牌证的 AI 自动批核比例目标超过 50%。
- 公报还披露,汀九桥南行线的智慧公路先导计划使用 AI 识别交通事故,官方称识别时间缩短近九成;实时交通灯号调节系统计划逐步扩展到全港约 50 个合适路口,铜锣湾项目预计在 2027 年第一季推行。上述数字分别属于官方目标、试点描述和后续计划,统计口径并不相同。
为什么重要
公共服务部署同时给出了系统边界和可量化指标,但指标仍需要上线后的独立评估来证明。读者判断这类消息时,应把「已经使用的 OCR」「年底筹备的大语言模型项目」「官方预期的审批比例」分开,不把规划数字当成真实世界效果。
4. 欧盟 JRC 分析 480 个生物 AI 模型:科研成熟不等于能部署
一句话结论:欧盟联合研究中心(JRC)的新报告显示,生物 AI 在蛋白质结构、功能注释和分子设计方面已经形成较成熟的科研能力,但数据、计算、验证和治理仍让现实部署停在较低到中等就绪度。
关键事实
- JRC 在 2026 年 8 月 20 日发布基于 480 个生物 AI 模型的报告介绍,原始报告为《Artificial Intelligence for Biology: Capabilities, Readiness, and Policy Implications》。报告覆盖 DNA、RNA 和蛋白质相关模型。
- 报告认为,蛋白质模型在结构预测、功能注释和分子设计方面最成熟;单细胞生物学模型则受到数据有限、来源多样和标准化不足的限制。AlphaFold、ESM3 等模型在科研基准上表现突出,但报告指出,受调查模型尚未完成综合的现实就绪度评估。
- JRC 将这种差距概括为「成熟度悖论」:模型可能在科学任务上表现良好,却仍缺少临床或工业部署所需的数据质量、基础设施、验证、协作和监管路径。报告还指出,公开模型可能带来病原体设计和毒素工程等生物安全风险。
- 报告建议欧盟支持单细胞和多模态方向,改善生物数据基础设施,建设面向公共产品的欧洲生物 AI 基础模型,并建立同时衡量科学成熟度和技术就绪度的评估框架。
为什么重要
这份报告为「模型很强,为什么还不能直接用」提供了具体拆解。对于医疗、药物和生命科学场景,基准分数只回答了能力问题;数据来源、可复现性、临床相关验证和生物安全控制才决定系统是否接近可部署。
来源:欧盟联合研究中心新闻页;JRC 原始报告。
5. ATLAS 更新双希格斯分析:AI 提高灵敏度,但没有证明新物理
一句话结论:ATLAS 的新分析用 Transformer 取代上一版分析中的提升决策树来区分信号与背景,结果达到更高灵敏度,但观测结果仍与标准模型相容。
关键事实
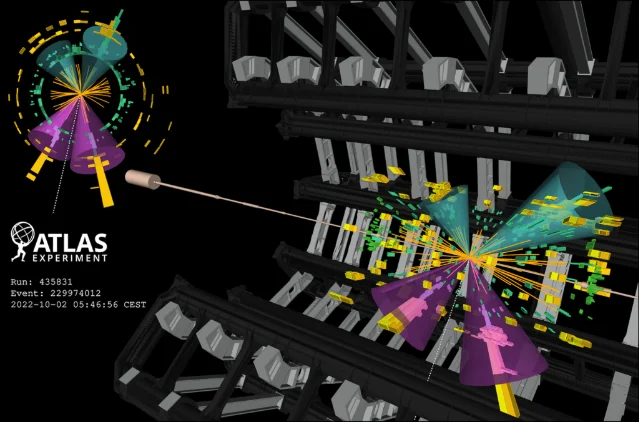
- 密歇根大学在北京时间 8 月 21 日 03:14 发布研究新闻,介绍了 ATLAS 对大型强子对撞机数据中双希格斯玻色子产生事件的分析。对应的arXiv 预印本首次提交于 2026 年 7 月 29 日,研究使用了 196 fb⁻¹、质心能量为 13 TeV 和 13.6 TeV 的数据。
- 论文正文显示,分析采用基于 Transformer 的多变量策略,把事件分类为背景、标准模型双希格斯和其他信号类别;该方法替代了上一版分析使用的提升决策树。研究新闻稿称,这项分析达到了该过程目前最高的灵敏度。
- 相对于「没有双希格斯产生」的背景假设,观测显著性为 2.6 个标准差,预期显著性为 1.2 个标准差;相对于标准模型预测,偏离为 1.65 个标准差。测得的双希格斯信号强度为 μHH = 2.6⁺¹·⁴₋¹·⁰,论文认为该结果与标准模型预期一致。
- 论文原文没有把所用方法称为图神经网络(GNN),而是明确写作 Transformer-based 多变量分析。该区分很重要:研究新闻中出现「AI」并不意味着可以把具体架构写成另一种模型。
为什么重要
这项研究展示了 AI 在科学仪器数据分析中的真实价值:它可以帮助研究者从高能碰撞背景中筛选更有信息量的事件,但统计显著性仍决定结论强度。2.6 个标准差不是发现新粒子的门槛,1.65 个标准差的结果也不能支持「标准模型已被推翻」的说法;同时,arXiv 页面仍将这项工作标为预印本,读者需要保留未同行评审的证据边界。
跨条目判断
五条消息共同指向同一条落地路径:AI 系统先要解决「请求发给哪个模型」,再要解决「模型能访问什么、谁能观察和停止它」,最后才是「它在真实领域是否已经准备好」。Ramp 的路由器和香港运输署的项目说明了产品与公共服务正在把 AI 接入现有流程;NCSC 的建议、JRC 的报告和 ATLAS 的结果则分别给出了安全、部署就绪度和科学证据的边界。
今天值得继续跟进的不是单个模型名称,而是三类可核对的细节:路由策略是否降低了每次成功任务的实际成本,生产系统是否具备最小权限与可回溯日志,科研或公共服务项目是否把目标数字转化成独立评估。公司自述、政府目标、临时指导和预印本结果,仍然需要按各自的证据等级阅读。
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.