用 20 种语言重写 SQLite:COBOL 72.1%,把 COBOL 迁到别的语言 97.9%
OpenAI 10 月 19 日放出两个自建评测:让模型用 20 种语言从零实现 SQLite 3.40.1,以及把 COBOL 迁到 C++、Java、Kotlin、Python、Rust;这篇拆开分数怎么算、两个方向为什么一边难一边易,以及仓库里缺了什么。

OpenAI 在 10 月 19 日发了一篇发布稿,标题是《Advancing coding in low-resource programming languages》。1 稿子给了两组数,方向正好相反。
第一组,GPT-6 Astra 在 20 种编程语言上的平均测试通过率 87.4%,上一代 GPT-5.6 Sol 是 26.8%。1 第二组,把 COBOL 程序迁到别的语言,GPT-6.1 Sol 在低推理档通过 86.6%,更高一档 97.9%。1
同一份材料里,COBOL 在第一个评测里是 20 种语言中唯一低于 83% 的,72.1%。1
官方对「低资源」的定义是:可供模型学习的代码与文档比 Python、JavaScript 少。1
把 87.4 里的那个 72.1 与迁移的 97.9 放在一起,指向一个具体问题:往低资源语言里写,与从低资源语言里搬出来,眼下是两件难度完全不同的事。
先让模型从零写出一个数据库
MultiLangBench 的任务是让模型在一种指定语言里,从零实现 SQLite 3.40.1。2
判分在出题方一侧完成。2 真 SQLite 3.40.1 拿着
validation_query 在模型产出的数据库上跑一遍,输出字符串与 expected_output 完全一致,这一条才算过。2 崩溃、结果不符、超过 60 秒,都记失败。2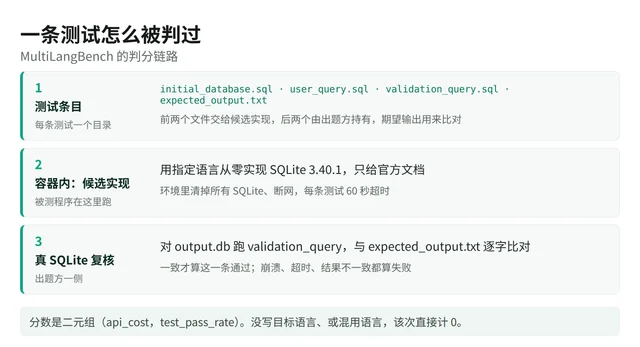
按 MultiLangBench 仓库 README 的判分流程自制。左栏是每条测试的四个文件,中栏是被测程序的运行条件,右栏是出题方用真 SQLite 复核;60 秒超时与「没写目标语言计 0」两条写在 README 里。
分数是一个二元组(api_cost,test_pass_rate),成本与通过率并列,一起构成分数。2 这一点值得记住:Luna 拿 40.3% 用了每样本 0.77 美元,Astra 拿 87.4% 的成本没有公布;两个读数要成对看,单看通过率会漏掉一半信息。
87.4 的形状:19 种在 88 附近,一种停在 72
官方点名的四种语言各有两代读数:COBOL 从 10.9% 到 72.1%,OCaml 从 25.6% 到 85.8%,Fortran 从 21.4% 到 83.5%,Visual Basic 从 27.5% 到 89.4%。1
四个涨幅分别是 61.2、60.2、62.1、61.9 个百分点,落在 60 到 62 这个很窄的区间里。1 四种语言的结构差别很大,提升幅度却几乎相同;这个形态符合通用能力抬升,公开的分项只有四种,判断到此为止。
官方同时给了两句话:Astra 在 19 种语言上超过 83%,COBOL 最难,停在 72%。1 按 87.4 与 COBOL 的 72.1 反推,其余 19 种语言的均值约 88.2%。
于是 87.4 由两半拼成:19 种语言挤在 88 附近,COBOL 一种把均值往下拽了十几分。
便宜那一档的情况不一样。GPT-6 Luna 平均 40.3%,每样本估计成本 0.77 美元,GPT-5.6 Sol 是 3.48 美元,官方说低约 78%。1 四种语言它也都涨了,COBOL 从 10.9% 到 17.1%。1
Luna 真正解决的是其余语言上「够用就行」的那一档:OCaml 34.1%、Fortran 31.4%、Visual Basic 41.6%。1 COBOL 仍然停在低位。
Astra 的每样本成本没有公布。1 成本与通过率这条曲线因此只有两个点,高端那个点缺横坐标;想算多一分通过率要花多少钱,算不出来。
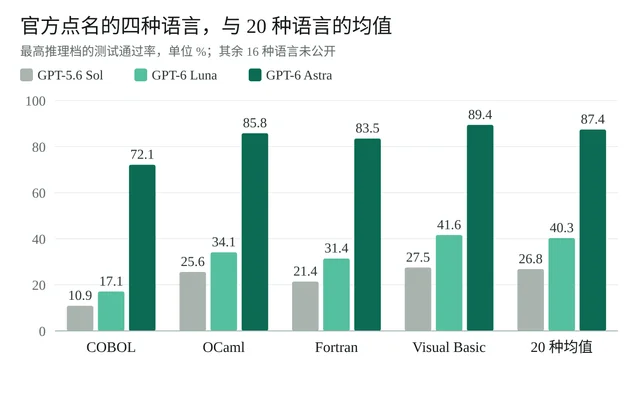
数据取自 2026-10-19 发布稿,自制。柱子是最高推理档的通过率;其余 16 种语言的分项没有公开,图上也没有画按均值反推出来的 88.2。
换个方向,同一门语言从最弱变成接近满分
COBOL 迁移评测走的是反方向:把现有程序迁到 C++、Java、Kotlin、Python 或 Rust,保持行为不变。1
判据是一套隐藏测试,要求可观测输出逐字节一致;一个程序的所有测试全过,才算迁移成功。1
IBM 那篇 COBOL 介绍把「大精度定点十进制」列在语言长处里,也回答了它为什么被大量金融机构采用。3 同一篇给的占比是:在线银行系统超过 40%,线下信用卡交易 80%,ATM 交易 95%,每天撑起 30 亿美元以上的交易。3
两个评测的输出方向完全相反。MultiLangBench 要求把代码写进目标语言,COBOL 是被写的那一端;迁移评测要求把代码从 COBOL 里读出来、落到主流语言,COBOL 只是被读的那一端。12
数字顺着这个方向排开:写进去的 COBOL 是 20 种里唯一低于 83% 的,写出来的迁移是 86.6% 到 97.9%。
两边为什么会分开,材料没有做分解实验。能观察到的是两个成本项:写出 COBOL 要自建编译与构建链路、对付固定格式的列位置,可借用的脚手架极少;读出 COBOL 只需理解语义,落地那一侧是有大量训练语料的主流语言。这是我的推断,官方把语言熟练度与长周期工程组织混在了同一个分数里。
官方也写了边界:这类行为保持能力对维护老系统的团队有用,上生产仍然需要专家评审,并按业务规则与依赖测试。1
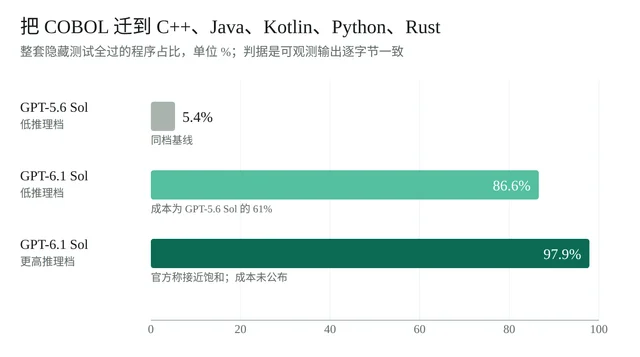
数据取自发布稿的 COBOL 迁移评测,自制。低推理档的成本比较对象是 GPT-5.6 Sol 的同档读数;更高推理档的绝对成本官方没有给。
仓库里有的和没有的
MultiLangBench 的测试套件与脚本开源在 GitHub,Apache-2.0。2 三个脚本各做一件事:用 apsw 3.40.1 重建初始库并写下期望输出,核对目录名(三段内容的 sha256)与内容是否对应,把环境里的 SQLite 清干净。2
跑全量 23,939 条很贵,仓库建议只跑
00、01、02 开头的 272 条;跑全量也可以,但要注明。2 发布稿没写 87.4% 用的是哪一套。这是整批数字里最难补的一处:272 条与 23,939 条的难度分布不一样。发布稿说仓库里同时放了每种语言的结果。1 我把它克隆下来看过,根目录只有 README、LICENSE、requirements 与
scripts、tests,逐语言结果不在其中,20 种语言的完整清单也没有公开。2 除官方点名的四种,另外 16 种的读数无从核对。迁移评测的开源程度更低:没有测试集、没有 harness、没有配套论文,程序数量与覆盖范围都没有公开。1 97.9% 目前只能引用,无法复核。
两套评测里出现的模型全是 OpenAI 自家的四款:GPT-5.6 Sol、GPT-6 Astra、GPT-6 Luna、GPT-6.1 Sol。1 这些数证明的是族内进步;至于自家该选哪一家,这份材料回答不了。
几条可以带走的读法
| 读数 | 能怎么用 | 前提 |
|---|---|---|
| 20 语言均值 87.4% | 说明模型在多种语言上从零写大程序的能力整体抬升 | 只有 4 种语言的分项公开 1 |
| COBOL 72.1% | 判断「让模型新写 COBOL」的可行性 | 单任务(整台 SQLite 引擎),语言熟练度与工程组织混在一个数里 2 |
| 迁移 86.6%–97.9% | 论证先把「迁出」列为试点 | 程序级全过率,隐藏测试,程序数未公开 1 |
| 每样本 0.77 美元对 3.48 美元 | 在便宜档与高端档之间分层选型 | Astra 的成本缺失,曲线少一个端点 1 |
第一件事,把「迁出」与「新写」分开评估。同一门语言,两个方向的读数是 72.1% 与 97.9%,把它们当成同一个能力的两个侧面,选型就会错位。
第二件事,把验收条件写成可观测输出逐字节一致。迁移评测从 5.4% 到 86.6% 是在这条判据下发生的;换成「能编译、能跑起来」,这些数字全部失效。
第三件事,自己复现时先跑 272 条那条子集,把断网与清空 SQLite 一起写进 harness。这两条决定了 87.4 里有没有「包一层真 SQLite」的水分。
手里有 COBOL 系统的团队,现在可以挑一个模块试迁移。要新写 COBOL 的场景,这批证据还撑不起来。
References
- 1
- 2openai/MultiLangBench
github.com
- 3What Is COBOL?
ibm.com
- 4NOAA repository
repository.library.noaa.gov
- 5NRC computer codes
nrc.gov
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.