美国联邦公报的搜索下拉里,曾经有两个 Qwen 选项
路透社发现美国联邦公报网站的高级检索页曾把两个阿里巴巴 Qwen 模型列为可选检索模式、并在周三撤下;这篇说清被部署的到底是哪个模型、三种风险判断卡在哪一环,以及公开规则里还缺什么。

路透社驻华盛顿记者 Courtney Rozen 在 2026 年 9 月 17 日发出的这篇稿子,写的是美国联邦公报(Federal Register)网站上的一栏检索选项。1
这个由美国国家档案与文件署(National Archives and Records Administration)运营的网站,一度把阿里巴巴 Qwen 模型驱动的一种检索方式与其他选项并列,供用户查找拟议中的联邦法规、浏览公众意见。1
周三,也就是 9 月 16 日,这个选项被撤下。撤下的时间点与社交媒体上出现相关帖子的时间大致同步,路透社的依据是它自己核对的截图,以及一份存档的网站源码。1
这些选项在页面上具体是什么样子,中文报道里还很少见。它们位于高级检索页的「Search Mode」一栏,与 Semantic、Keyword Only 并列在同一组单选按钮里。2
这篇稿子值得单独读的地方也在这里。一个由美国联邦政府自己运营、每天发布联邦法规的网站,页面上出现了中国公司训练的模型;它在 9 月 16 日消失,留在公开记录里的,是几张截图和一份被归档的源码。
至于它什么时候上线的,路透社说并不清楚。1
这篇报道写了什么
路透社把这条稿子的落点放在一个对照上:一个美国政府网站使用了中国公司的 AI 模型,而联邦调查局上周刚指控这家模型的开发者阿里巴巴「恶意」抄袭美国竞争对手 Anthropic 的技术。1
FBI 周四拒绝就此置评;美国国家档案与文件署与白宫都没有回应路透社的置评请求。1
路透社说,这件事出现在一场全球范围内对 AI 安全的重新评估之中,也出现在美国国内关于「监管护栏是必需还是拖累竞争力」的争论之中。1 有 AI 专家认为,联邦公报网站上使用这个中国工具可能没有带来国家安全风险;但它引出一个问题:美国联邦政府在对待中国 AI 模型上的表态,和它自己的做法是不是对得上。1
信息技术与创新基金会(ITIF)主席 Daniel Castro 看到的是落差:中美两国正在激烈争夺更强的 AI 模型,而一个美国机构选用了中国制造的模型。1 他给出的评价是「It's one of the most insane things I've ever seen」。1
乔治城法学院教授 Anupam Chander 说,使用 Qwen 似乎没有带来即时的网络安全风险,不过这一点取决于这个模型是怎么训练的。他说,联邦公报网站上的内容本来就是公开的,所以这个模型处理的并不是敏感的政府信息。1
参议院情报委员会副主席、民主党人 Mark Warner 在一份声明里说,风险取决于美国的数据有没有离开政府的安全边界、有没有在阿里巴巴控制的系统上被处理。1
关于被部署的模型本身,路透社给了一段背景:Qwen 是开放权重模型,系统的关键部分公开可得;开发者可以下载并针对具体用途修改,成本通常低于 Anthropic 与 OpenAI 这类公司的闭源模型。1 安全专家说,开放权重模型可以跑在企业自己的 IT 基础设施上,让组织对敏感数据有更大的控制权。1
这篇稿子还提到,今年 4 月,美国众议院中国问题特别委员会与国土安全委员会曾致函 Airbnb;Airbnb 也在使用 Qwen,而这封信要求它提供使用细节,属于一项针对「把中国 AI 工具整合进美国人使用的平台所造成国家安全风险」的调查。1
下拉框里的两个 Qwen 是什么
「用了中国模型」这句话,落到页面上是两个具体的名字。
9 月 16 日,科技媒体 OfficeChai 拍下了联邦公报高级检索页的「Search Mode」一栏,五个选项依次是:Semantic(默认选中)、Hybrid Qwen3:0.6B(512D, Recursive Splitting, Distilled, Prefixed)、Keyword Only、Neural msmarco-distilbert-base-tas-b、Qwen3:0.6B。2 同一张截图上方写着,站内共有 1,008,641 份文件。2
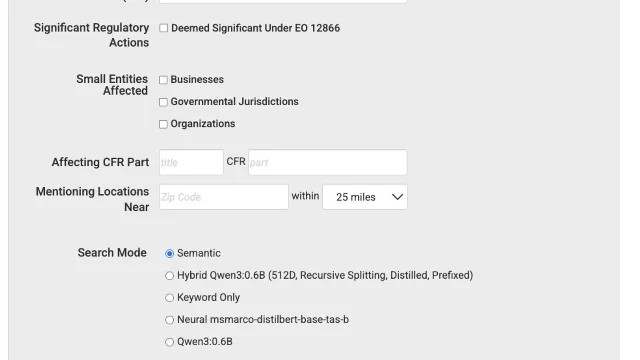
Qwen3:0.6B 是阿里巴巴 Qwen 团队发布的一个小型开放权重模型,参数规模不到 10 亿,采用 Apache 2.0 许可证。2 它在这一栏里做的工作,是把查询与文档做向量化后排序。这样的模型跑在本地,用来给检索结果排先后。2
这一点决定了风险讨论的形状。权重一旦公开,任何开发者都能下载下来放进自己的项目,不必与阿里巴巴发生任何交易。2
第二天,也就是 9 月 17 日,OfficeChai 再次打开同一页:五个选项只剩两个,Keyword Only 与 Semantic,Semantic 是默认项;Neural 与两个 Qwen 模式都被删掉,页面上没有任何变更说明。4 联邦公报自己的「Recent Site Updates」栏目里,最新三条都是 2024 年的内容,与检索模式无关。5
| 检索模式 | 它是什么 | 撤下前 | 撤下后 |
|---|---|---|---|
| Semantic | 默认选项 | 默认选中 | 仍是默认项 24 |
| Hybrid Qwen3:0.6B(512D, Recursive Splitting, Distilled, Prefixed) | 阿里巴巴 Qwen3:0.6B 的混合检索变体 | 可供选择 | 已删除 24 |
| Qwen3:0.6B | 阿里巴巴发布的开放权重小模型,Apache 2.0 许可证,参数不到 10 亿 | 可供选择 | 已删除 24 |
| Neural msmarco-distilbert-base-tas-b | 基于 msmarco-distilbert-base 的神经检索模型 | 可供选择 | 已删除 24 |
| Keyword Only | 纯关键词检索 | 可供选择 | 仍可选择 24 |
风险落在哪一环
三位具名表态者给出了三种判断。把他们的依据并排放,分歧落在一个具体问题上:数据有没有离开政府的安全边界。
| 谁 | 身份 | 他的判断 | 依据与缺口 |
|---|---|---|---|
| Daniel Castro | 信息技术与创新基金会(ITIF)主席 | 一个美国机构选用中国制造的模型,与两国争夺更强模型的激烈程度之间出现了落差 | 他给出的是常识层面的判断,依据停在竞争落差这一点上 1 |
| Anupam Chander | 乔治城法学院教授 | 使用 Qwen 似乎没有带来即时的网络安全风险 | 依据是联邦公报的内容本来已经公开、模型处理的并非敏感政府信息;他同时留了一个条件,结论取决于这个模型是怎么训练的 1 |
| Mark Warner | 美国参议院情报委员会副主席(民主党) | 风险取决于美国数据有没有离开政府的安全边界、有没有在阿里巴巴控制的系统上被处理 | 他就本次部署本身给出的是一套判断标准 1 |
三位表态者的分歧落在同一个变量上:数据往哪里走。 Castro 看的是政治与竞争逻辑:一个被美国官员描述为在「工业级」抄袭的开发者,其模型出现在联邦政府的公共检索页上。13 Chander 与 Warner 都把条件放在数据流向上——Chander 指出这一页处理的材料本来就公开,Warner 给出的是一个更普遍的标准。1
这个标准指向的正是开放权重那一层。权重被下载到本地、在自有机房或政府自有的基础设施上运行时,用户的输入不必送到阿里巴巴控制的系统;调用远端 API 时,输入会经过第三方。12 联邦公报实际采用的是哪一种方式、这套检索跑在谁的机器上,路透社这篇稿子都没有交代。1 这一点归入下面的待核实一栏。
三份文本,三种动作对象
把这次部署放回公开的联邦规则里,能看到几份文件,以及它们各自的动作对象。
今年 4 月 29 日,美国众议院国土安全委员会与中国问题特别委员会联名致函 Airbnb 首席执行官 Brian Chesky,信里写明两个委员会正在联合调查「把中华人民共和国开发的人工智能模型整合进美国用户、企业和关键行业日益依赖的面向消费者平台、企业系统与服务运营所造成的日益严重的国家安全风险」。6
这封信把 Airbnb 在客服业务中使用阿里巴巴 Qwen 的做法列为调查对象,并引用该公司自己的公开说法:它选择 Qwen 的理由是「快而便宜」。6 信里列出三类风险,其中第三类正对今天这件事:当一家公司通过远端 API 访问模型、把模型放在自己控制的基础设施之外时,敏感的提示词、元数据与其他输入可能被送到企业无法直接控制的第三方系统上处理。6
信里还转引了白宫科技政策办公室 2026 年 4 月 23 日的一份备忘录,该备忘录把中国的蒸馏活动定性为「蓄意的、工业规模的行动」。6
这封信要的是说明。 它由两个委员会签发,发给一家企业,要求对方提供使用细节。6
立法一侧同样停在半路。「No DeepSeek on Government Devices Act」(H.R. 1121)2025 年 2 月 7 日提出,要求白宫管理与预算办公室制定标准与指引,禁止行政机构使用 DeepSeek;截至 2026 年 9 月 17 日,这项议案的进度仍停留在「提出」,有 32 位共同提案人。7 2025 年 6 月,国会又提出了目标更宽的一项两党议案,要把中国的人工智能系统挡在联邦机构之外。8
原文直引
"It's one of the most insane things I've ever seen."
Daniel Castro,信息技术与创新基金会(ITIF)主席,路透社 2026 年 9 月 17 日。1
"China-based AI companies are engaging in aggressive, malicious and targeted distillation activities at an industrial scale."
美国执法与情报官员的声明,路透社 2026 年 9 月 8 日引述。3
"There is nothing innovative about systematically extracting and copying the innovations of American industry, and there is nothing open about supposedly open models that are derived from acts of malicious exploitation."
白宫科技政策办公室备忘录,2026 年 4 月 23 日;众议院两个委员会 4 月 29 日致 Airbnb 函转引。6
Anupam Chander 与 Mark Warner 的表态在路透社原文里是间接引述,本篇照此转述,不加引号。1
把这批说法拆成四层
| 层次 | 内容 | 依据 |
|---|---|---|
| 媒体措辞 | 路透社把这条稿子写成「一个美国政府网站使用了联邦调查局说是抄袭了 Anthropic 的那家中国公司的 AI 模型」 | 路透社 1 |
| 官方与当事人自述 | 联邦调查局周四拒绝置评;美国国家档案与文件署与白宫都没有回应置评请求;阿里巴巴方面在这篇报道里没有出现回应 | 路透社 1 |
| 可核到的公开记录 | 9 月 16 日的页面截图,五个检索模式里含两个 Qwen;次日同一页只剩两个模式;站点更新栏目没有对应公告;4 月 29 日众议院致 Airbnb 的问询函;H.R. 1121 停留在提出阶段 | OfficeChai 24、联邦公报站点更新页 5、众议院函 6、GovTrack 7 |
| 仍待核实 | 这个检索工具什么时候上线、由谁部署;为什么在周三被撤下;检索跑在谁的机器上、数据有没有离开政府的边界;Qwen3:0.6B 这个版本是怎么训练出来的 | 路透社 1、OfficeChai 4 |
References
- 1
- 2
- 3
- 4
- 5Federal Register :: Reader Aids :: Recent Site Updates
federalregister.gov
- 6Letter to Airbnb CEO Brian Chesky, April 29, 2026
homeland.house.gov
- 7
- 8
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.