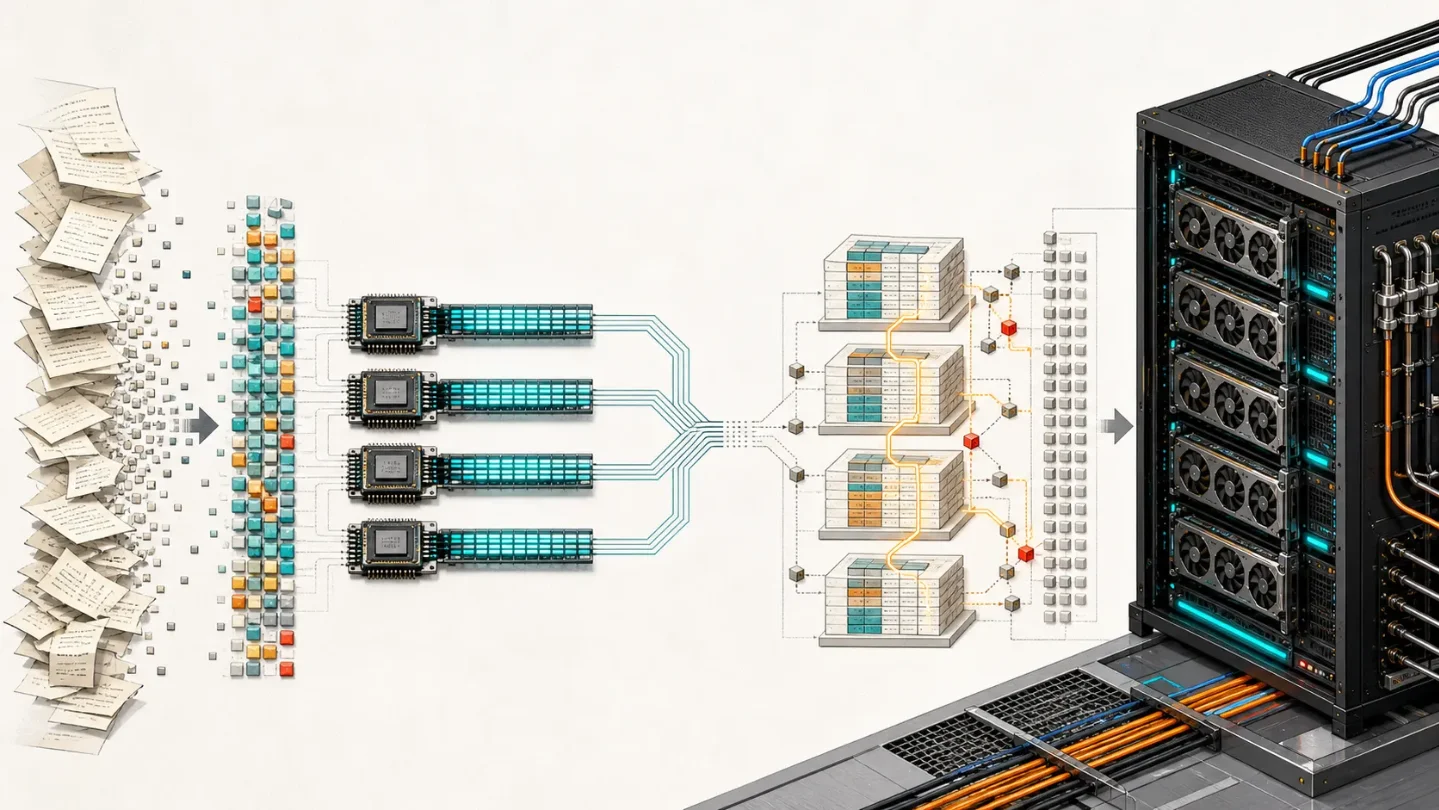
从 1000 倍 tokenization 到 GPU 机架,AI 热潮正在暴露系统账单
从 GigaToken、SIMD、Postgres、真实 text-to-SQL 与二手 GPU 集群的讨论出发,拆解 AI 性能与可靠性如何被数据路径、存储语义和运维能力共同决定。

先看结论
模型发布页总在讲参数、上下文和推理速度,今天的 Hacker News 热榜却把视线推回了更低的一层:文本怎样变成 token,数据怎样排进内存,SQL 面对的是不是干净的表,数据库能不能从故障中恢复,以及一座 GPU 集群离开原团队后还剩多少价值。
这五条帖子并不共享一个产品。它们共同说明,AI 系统的性能和可靠性很少由模型单独决定。真正拖慢链路的,往往是数据进入模型之前的预处理、热循环里的数据布局、企业数据仓库多年积累的语义混乱,以及云端硬件背后没人写进合同的运行知识。
以下是 2026 年 7 月 23 日 08:00(UTC+8)左右抓取的 Hacker News front page 快照。分数、评论数和排序会继续变化;GPU 集群的原文发表于 5 月 5 日,但它在本次抓取时重新出现在热榜,因此本文把它作为当前讨论信号,而不是当天新发新闻。
| 帖子 | 抓取时热度 | 作者与原文事实 | 评论区分歧 |
|---|---|---|---|
| GigaToken:约 1000 倍更快的语言模型分词 | 第 3 位,331 分 / 63 条评论 | marcelroed,背景未公开;项目把分词吞吐做到 GB/s 级,兼容路径会牺牲部分速度 | 训练前处理和 TTFT 是否值得优化,取决于具体链路 |
| Everyone Should Know SIMD | 第 10 位,208 分 / 66 条评论 | Mitchell Hashimoto;文章用 Ghostty 终端的循环解释向量化 | 手写 SIMD 不是按钮,数据布局和编译器能力更关键 |
| The startup's Postgres survival guide | 第 16 位,298 分 / 163 条评论 | Alexander Belanger,Hatchet 联合创始人;文章来自两年的 Postgres 运维经验 | pgBackRest、RDS、EBS 和告警策略各有代价 |
| Any text-to-SQL benchmark should address difficulties of real-world data stores | 第 12 位,23 分 / 4 条评论 | Michael Stonebraker 与 Peter Baile Chen;文章比较公开 benchmark 与真实仓库 | 语义层能否解决歧义,还是仍需熟悉 SQL 的人复核 |
| Nobody knows what a used GPU cluster is worth | 第 14 位,151 分 / 134 条评论 | Meg McNulty,背景未公开;原文讨论 GPU 抵押融资和二手价值 | 芯片价格、供电和运维团队共同决定资产价值 |
1. GigaToken:模型调用之前,文本已经在排队
GigaToken 的仓库标题很激进:比 Hugging Face tokenizers 快约 1000 倍,并且可以作为 drop-in replacement。仓库给出的基准是在 11.9 GB 的
owt_train.txt 上,用双路 AMD EPYC 9565、共 144 个核心测试。GPT-2 tokenizer 的吞吐是 24.53 GB/s,而 Hugging Face tokenizers 是 24.8 MB/s,仓库表格给出的差距是 989 倍。Apple M4 Max 的一组结果甚至给出 1,268 倍差距。1这个数字不能直接翻译成「所有 AI 应用都会快 1000 倍」。仓库自己区分了两条路径:兼容 Hugging Face 或 tiktoken 的模式更容易接入,但为了输出完全一致会付出性能代价;最快的 GigaToken API 直接从文件读取数据,减少 Python 数据结构传递和调度开销。也就是说,差距里包含了接口边界、数据来源和并行方式,不只是某个 tokenizer 函数的速度。
HN 帖子作者
marcelroed 把用途说得更具体:他主要在预训练实验中调整数据混合、过滤和处理方式,分词会处理数天、由大量 CPU 参与的大规模数据;在推理侧,分词通常发生在 KV-cache 查询之前,因此长 system prompt 可能让 tokenization 进入首 token 延迟。作者在评论里给出了一组 8B Qwen3、单张 B200 的初步 TTFT 结果,输入长度从 2,048 到 32,768 token 时,平均延迟降幅约为 5.5% 到 8.4%,并明确说还需要更多测试。2评论区的反方没有否认项目的价值,而是追问它到底位于哪条瓶颈上。有人认为普通推理的总耗时里,tokenization 占比很小;有人指出,训练数据本来就会预先 tokenize,分词速度更像数据管线的节流阀。还有人提议先用原始文本 hash 查询缓存,再并行分词。作者和其他评论者则解释,开源推理系统的 prefix cache 通常按 token chunk 建树,需要先知道 token boundary 才能判断命中范围。2
这条帖子的意义不在于一个漂亮的倍数,而在于它把「模型速度」拆成了几段:数据准备、token 边界、缓存查询、Python 与 Rust 之间的搬运,以及 GPU 真正开始计算的时刻。一个模型换了更快的硬件,如果输入仍在前处理队列里,用户感受到的首 token 延迟并不会按宣传页的比例下降。
2. SIMD:快的不是指令,而是数据排法
Mitchell Hashimoto 的文章从一个很朴素的循环开始:逐个检查字节、字符或数组值。SIMD 让 CPU 一条指令同时处理多个值,文章用 Zig 演示了五步流程:准备向量常量,按向量宽度读取数据,执行并行比较,归并结果,再处理无法填满一个向量的尾部。作者在 Ghostty 终端的一个实际循环上测到,理想情况下 ARM NEON 可处理 4 路、AVX2 可处理 8 路、AVX-512 可处理 16 路;端到端结果在一台 AVX2 Intel 台式机上约为 5 倍。3
文章的可取之处是没有把 SIMD 写成编译器黑魔法。它明确提醒,数据量只有几个或几十个字节时,向量化没有意义;循环里有早退、分支或复杂的内存访问时,收益也会消失。SIMD 适合长而规整的热路径,前提是你真的在反复处理足够多的数据。
HN 评论把这个前提又往前推了一步。有人说最好的优化往往需要把 Array of Structs 改成 Struct of Arrays,让同类数据连续排列,改善缓存局部性和分支行为;也有人提醒,编译器常常已经能处理简单循环,先检查自动向量化结果,再决定是否手写。手工把标量代码改成 SIMD,可能反过来破坏数据结构这个应用层契约。4
这和 GigaToken 的关系很直接。模型推理链里每一层都在处理批量数据,但每层对「批量」的定义不同:tokenizer 按字符和词表工作,KV-cache 按 token chunk 工作,CPU 热循环按向量宽度工作,GPU kernel 又有自己的内存合并规则。性能优化不是在某一处按下加速键,而是让相邻的几层使用相容的数据形状。
3. Postgres:默认配置不会替你负责恢复
Hatchet 的 Postgres 指南来自两年的生产运维经验。Alexander Belanger 是 Hatchet 联合创始人,他从 schema、查询、索引和事务讲起,继续写到连接管理、query planner、批量写入、autovacuum、分区和大表迁移。文章有一句很实际:部署之后,schema 是最难改变的部分,所以应该先根据真实读写模式迭代,而不是把理论上的规范化当成唯一答案。5
指南讨论的不是数据库能不能跑,而是它在变忙之后怎样不突然垮掉。长事务会拖住锁,给大表直接
CREATE INDEX 可能阻塞写入,默认 autovacuum 可能让膨胀问题拖到很晚才暴露。文章把这些问题放进查询、schema 和部署流程里,而不是只给一串孤立的 SQL 技巧。5163 条评论把讨论拉到了恢复现场。有人提醒,AWS 关于 XID wraparound 的邮件很可能在假期被漏掉,关键告警应该接入 pager;多位评论者推荐 pgBackRest,因为它支持 WAL 归档、时间点恢复和块级增量备份。另一派认为,小规模业务用
pg_dump 加对象存储已经足够,是否需要 RDS、HA 和副本,必须看数据丢失的业务成本。关于 EBS 是不是错误选择,评论区也没有共识,有人强调低延迟直连盘,有人指出 AWS 自己的 RDS 也在使用 EBS。6Postgres 这条线说明,所谓性能问题常常不是单条查询的速度,而是数据在错误恢复路径上花了多少时间。数据库不只是存储层,也是备份、告警、迁移和团队值班制度的集合。把它交给云厂商,并不会自动消除这些选择,只是把一部分选择换成了价格和服务边界。
4. Text-to-SQL:干净 benchmark 离真实仓库很远
ACM 的文章由 Michael Stonebraker 和 Peter Baile Chen 撰写。Stonebraker 是 MIT 计算机科学教授,Chen 是 MIT CSAIL 博士生。文章拿 Spider、BIRD-SQL 和 Spider 2.0 的高分与真实数据仓库作对照,指出公开 benchmark 往往没有覆盖四个麻烦:数据可能已经进入训练语料,企业 schema 会随业务变化而腐化,表和字段含有大量组织内部的特殊语义,真实查询也常常包含多个 join。7
作者团队用多个真实数据仓库构造 Beaver benchmark。其中一个 Oracle 仓库有 1,400 多张表,查询来自真实日志,再由真实用户协助把 SQL 改写成自然语言问题。文章称,纯 LLM 在这个 benchmark 上的准确率为 0;加上 RAG、prompt engineering 和 agentic AI 后进入 10% 以上;如果把正确的
FROM 表和多表 JOIN 提示给模型,准确率才上到 30% 以上。这个落差直接改变了产品判断:公开 benchmark 的 90% 级别分数,不代表企业仓库里能安全回答业务问题。7HN 评论里有一条很典型的反方经验:团队先重建数据仓库,再用 dbt model、YAML 和语义层承载指标定义,系统表现会比文章里「纯 LLM 几乎为零」的结果更好。另一条评论则提醒,业务用户没有人复核生成的 SQL 时,漏掉过滤条件、误解收入定义,或者把一个语法正确但语义错误的答案带进会议,才是更危险的部分。8
Text-to-SQL 的瓶颈因此不是「模型是否懂 SQL」。它需要知道一家公司如何定义收入、哪些表已经废弃、哪个字段只是历史遗留,以及用户的问题是否缺少关键限定。语义层可以减少歧义,但不能替人确认问题本身问的是什么。
5. 二手 GPU:硬件的价格里还藏着一支团队
Meg McNulty 的文章讨论一个很具体的融资问题:如果以 GPU 为抵押的 AI 基础设施贷款违约,贷款人接手的到底是什么。文章称,大型集群的价值取决于配置、运行状态,以及熟悉系统细节的运维团队是否仍在。它把价值分成账面价值、清算价值和持续经营价值,后者尤其依赖交接是否顺利。9
原文还列出了几组不稳定的参照:有的公司按 4 年折旧,有的按 6 年;H100 租赁价格从 2024 年初约 8 美元每小时降到 2025 年 10 月的 1.70 美元,之后又在 2026 年 3 月回到 2.35 美元。文章的判断是,GPU 还没有成熟的期货市场、残值曲线和标准化的维护记录,贷款定价只能给这种不透明性加上风险溢价。9
HN 讨论把「运维团队是资产的一部分」这件事说得更生活化。有人估算家庭部署 H100 时还要面对空载耗电、满载功耗和普通住宅的电路上限;也有人认为,集群的运行知识可以通过监控、自动化和更好的交接文档固化下来。关于合同中的回购和处置权,评论则争论这究竟是降低二手市场不确定性的机制,还是把风险转给了购买者。10
这条材料和前四条放在一起,呈现出同一个硬问题:系统的真实价值包含大量没有出现在 API 或规格表里的运行状态。GPU 的温度曲线、数据库的恢复演练、schema 的历史语义、tokenizer 的输入路径,都会在故障或扩容时变成成本。
今天的信号:性能是整条数据路径的账
今天热榜里的五个瓶颈,可以按数据从进入系统到产生结果的顺序排开:
- 输入阶段。 GigaToken 说明 tokenization 可能卡住训练数据准备,也可能进入首 token 延迟,但它的收益必须按完整调用链测量。
- 计算阶段。 SIMD 说明指令级并行依赖数据布局、访问模式和尾部处理,代码改短并不等于路径变快。
- 存储阶段。 Postgres 说明吞吐、锁、备份和恢复不能拆开看,默认设置只是一种起点。
- 语义阶段。 Text-to-SQL 说明模型面对的是组织的历史数据和含糊问题,benchmark 分数不能替代 schema 治理和人工复核。
- 资产阶段。 GPU 集群说明算力的价格还包含供电、故障处理、调度经验和团队交接,芯片本身不是完整的生产能力。
这不是说模型层不重要,而是模型越强,外围系统越难继续用近似值糊过去。输入要有真实的 token 计数,热路径要有数据布局,仓库要有可解释的 schema,数据库要做恢复演练,集群要把运维经验写下来。否则,宣传页上的吞吐只是局部数字,真正的账单会在系统边缘出现。
References
- 1GigaToken GitHub 仓库
github.com
- 2Hacker News:GigaToken 讨论
news.ycombinator.com
- 3Everyone Should Know SIMD
mitchellh.com
- 4Hacker News:Everyone Should Know SIMD 讨论
news.ycombinator.com
- 5The startup's Postgres survival guide
hatchet.run
- 6Hacker News:The startup's Postgres survival guide 讨论
news.ycombinator.com
- 7If You Think You Can Do Real-World Text-to-SQL
cacm.acm.org
- 8
- 9Nobody knows what a used GPU cluster is worth
ciphertalk.substack.com
- 10Hacker News:Nobody knows what a used GPU cluster is worth 讨论
news.ycombinator.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.