Claude 自主找到一类新酶系统:重跑 10 次,那个重复阵列再没被发现
解读 Anthropic 2026 年 9 月 23 日发布的生命科学早期结果:约 950 个 Claude 会话跑了 21.5 小时,从 19 亿个蛋白簇里找出一类带 CRISPR 式重复阵列的新酶系统 ART,本文拆开哪些部分已经站得住、哪些还只停在序列层面。

2026 年 9 月 23 日,Anthropic 在官网 Science 栏目发了一篇短文,标题是《Claude discovers a novel enzyme system with CRISPR-like repeats》,同日放出一份 40 页的预印本《Autonomous AI agents discover reverse transcriptases with tandem repeat arrays》,六位作者全部署名 Anthropic12。短文说,公司今年春天成立的生命科学研究组写了一段提示词,让 Claude 去一批 DNA 序列里搜寻新的逆转录酶;约 950 个 agent 跑了 21 小时后,其中一个报出了一个此前无人描述过的酶系统,团队把它命名为 array-associated reverse transcriptases,缩写 ART1。
这句话可以拆成四问。ART 是不是真的新?它有没有真的被表达?找到它这件事有多少是模型自己完成的?这套流程还能不能重来?预印本把这四问的答案都摆了出来,强度差别很大。
ART 是什么:一串等距重复,加一个以前没人写过的搭档
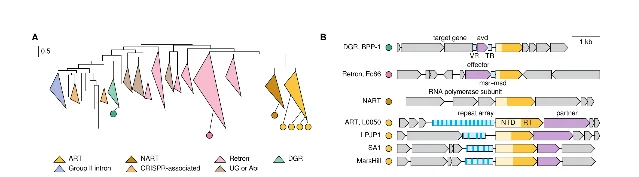
逆转录酶(reverse transcriptase,RT)把 RNA 抄成 DNA,是 cDNA 合成到基因组工程这一整条产业链的底层工具。在细菌和噬菌体的基因组里,RT 常常与一个搭档蛋白、以及一段非编码 RNA 共处同一个位点,三者协同工作——逆转录子(retron)就是这样的抗噬菌体系统,RT 把一段专属的 ncRNA 抄成单链 DNA,再由搭档蛋白执行防御2。
Claude 报出的 ART 主要出现在巨型噬菌体(jumbo phage,基因组特别大的一类噬菌体)里,由三样东西构成:一个 RT,一个紧挨它下游的搭档基因,以及 RT 上游一长串等距排列的重复序列2。那个 RT 本身以前就被识别过。Anthropic 的判断是,Claude 头一个指出了这个系统的定义性特征:与它关联的非编码重复阵列,以及那个功能不明的附属蛋白1。
这个判断有外部依据。MarsHill 噬菌体那份基因组报道已经写出了这个 RT,还推测过它上游有一段非编码 RNA,重复序列和搭档基因两样都没有提到3。也就是说,这一次多出来的,是那条阵列和那个搭档。
团队随后在交互式会话里把家族定义做扎实。在培养的巨型噬菌体和预测的病毒片段里,他们找到 95 个独立 RT 簇(90% 同一性),其中 28 个在 RT 上游带可检出的重复阵列2。阵列长 0.3 到 4.1 kb,含 3 到 21 个拷贝;重复单元 15 到 49 nt,核心约 15 nt 呈回文;单元之间的间隔 120 到 220 nt,彼此没有关联。
这些数字只有和 CRISPR 阵列对照着看才显出分量。CRISPR 的重复近乎一致、边界锐利,间隔只有约 30 nt,还会在近缘菌株之间整段进出;ART 的间隔在近缘噬菌体之间保持原有顺序,分化速率与 RT 基因相当,阵列附近也找不到任何 cas 基因。所以这是一类新的非编码重复元件,落到 CRISPR 的家谱之外2。
RT 本身也有一处反常。它的 N 端比一般 RT 长约 180 个残基,而多数 RT 不超过 50;这一段是全家族变异最大的区域,却每个成员都有。催化用的 YxDD 基序在全部 93 个能覆盖到的成员里都保留了下来2。和它同支的姊妹家族 NART 也有长 N 端,但 17 个可评估位点里,一个带阵列的都没有,也都不编码 ART 型搭档。
阵列真的被转录,这是目前最硬的一层
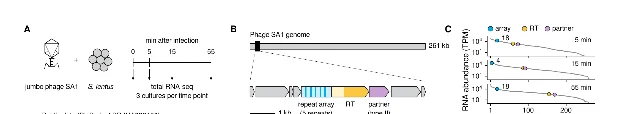
家族定义是序列层面的,表达证据才是能上实验台的那一层。团队让一个 Claude Science 会话去找更多线索4,这个会话自己检索并取回了一份公开数据:Zhang 等人 2022 年对巨型噬菌体 SA1 感染 Staphylococcus lentus 的转录组时间序列,样本点在感染后 0、5、15、55 分钟5。
结果很直白。阵列来源的 RNA 在三个时间点都高丰度,15 分钟时最多占到噬菌体 RNA 的 8%,丰度排名第 4;5 分钟和 55 分钟都是第 18。同一个位点上,阵列 RNA 明显高过 RT 和搭档基因的转录本2。
阵列内部的转录本还会切成更短的片段,片段边界在不同重复之间可以复现。为了把这一步从噬菌体背景下拆出来,团队把 SA1 的 ART 系统放到大肠杆菌的质粒上,做了原生位点和异源启动子两种构建,小 RNA 测序同样看到离散的短 RNA,形状与感染时一致;折叠预测把重复序列放成碱基配对的双链柄,说明重复本身就带一段短的反向重复2。
搭档那一侧也查清了。ART 家族 RT 旁边几乎只出现三个互不相关的蛋白家族,团队据此把 ART 分成三型:I 型出现在 95 个位点中的 59 个,蛋白约 600 个残基,带两个串联的 GNAT 样折叠;II 型限于 Staphylococcus 噬菌体那一支,约 270 个残基,全螺旋;III 型只有一个环境亚支,约 170 个残基。三者在序列和预测结构上都找不到相似性,说明 ART 家族 RT 与互不相关的搭档配对发生过不止一次。预测的 I、II 型同源搭档复合物收敛到中等置信度,界面打分 ipTM 约 0.6,落点是 RT 的 N 端延伸与搭档之间2。
把这些拼起来,团队给出的假设是:ART 与逆转录子共享三个组件——非编码 RNA、RT、专属搭档,区别在数量,逆转录子带一条 RNA,ART 带一整排。逆转录子里,RT 与它生成的 msDNA 把效应蛋白扣在失活复合物中,直到噬菌体感染或 msDNA 受损才释放出来杀死细胞;ART 可能是每个单元 RNA 各自组装一套复合物,一个酶加一个效应蛋白,给出若干只差在 RNA 上的复合物,而 RNA 之间的差别正好可以用来响应不同的触发条件2。
21.5 小时里,人和模型各做了什么
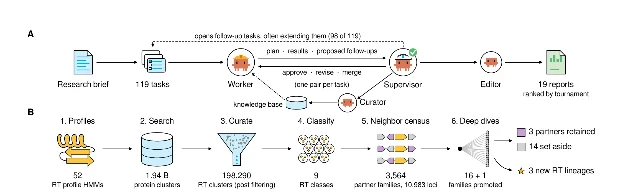
这套编制有四类角色,都跑在 Claude Code 里:worker 提出分析计划并执行,supervisor 审阅计划与结果,curator 把发现写进共享知识库,editor 复核报告。supervisor 可以依据过程中的观察开新任务,所以整场 campaign 会随发现自行延伸;任务队列空了才结束,最后以书面报告交给人类审阅2。
人定下的只有开头那一段研究简报:让 agent 从新的搭档基因关联入手去找 RT 系统。整场 campaign 共 119 个任务,其中 98 个是 agent 自己在过程中开出来的;949 个会话、76.9 个 agent 小时、2.156 亿 token,墙钟时间 21.5 小时,其间没有人工干预2。
ART 是那条自我延伸的支线上长出来的。agent 先选中一个候选,理由是与巨型噬菌体的非病毒体 RNA 聚合酶 β 样亚基共现;随后一个 worker 判定这是基因顺序造成的伪关联,把那个基因排除掉,同时顺手开了一个跟进任务去单独研究这个 RT。因为逆转录子的 RT 要配一段上游编码的 ncRNA 工作,supervisor 让下一个 worker 去查这些 RT 的 5′ 侧翼。带聚合酶基因的那些 RT,上游非编码区只有中位 27 bp,短到装不下 RNA;它们的近亲却有中位 940 bp。
worker 把近亲的上游序列直接读进了上下文,然后写下这句话:这段侧翼「is spectacular: I can see by eye a tandem repeat array」——CATGTGTATCGCATGT / CATGTGTTTCGCATGT 反复出现,间隔 100 到 180 bp,「that's a CRISPR-like or msDNA-like repeat array?!」2
这段过程可以核。任务简报和总简报里都没有出现过「重复」或「阵列」;识别之前的两次取回都是没有注释的裸序列,识别与它们之间没有任何工具调用;整场会话没有跑过任何现成的重复序列查找工具;worker 写下的那个重复模式,在它取回的那段 2,900 nt 序列的两条链上都用最多 1 个错配重现得出来2。
产出要按比例看。邻域普查里反复出现的 3,564 个蛋白家族中,46 个通过三条事先设好的筛选(其中 13 个是预先指定为对照的已知搭档),worker 复核注释后提升 16 个,跟进任务再提升第 17 个。17 个候选搭档家族里,最终只有 3 个被确认为此前未报道的 RT 关联,其余 14 个被驳回或搁置,理由是注释假象、已有系统的部件、或者只是邻里常客。除此之外,worker 还标出 3 条新的 RT 谱系。campaign 一共出了 19 份报告,ART 那份在 342 局两两评比里排第 32。
边界也在材料里写着。campaign 之后的所有工作——家族定义、阵列特征、RNA 分析、搭档分类、结构预测——都在交互式 Claude Science 会话里完成,由论文作者主导,Claude 写并运行代码;实验室里的全部工作由人类科学家完成,场地只做 BSL-1 与 BSL-2 级别的研究,不接触能感染人的病原体1。
重跑十次,阵列一次都没再出现
团队把同一套 campaign 又跑了十次。几乎每次走完普查的 campaign 都采到了 ART 位点,其中两次还有 worker 把它当跟进题目研究过;但没有任何一次把 RT 上游的 DNA 读进上下文,阵列一次都没被发现2。作者给的解释是,RT 蛋白的搜索空间太大,加上这套编制本身的行为不确定。
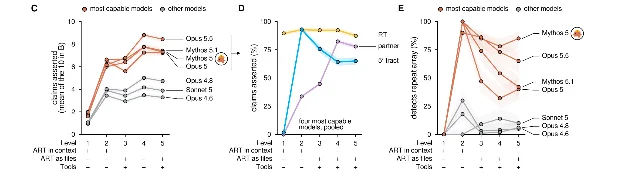
于是他们做了一套固定输入的基准,把「能不能认出阵列」这件事单独拿出来测。五档输入的差别在于信息形态:第 1、2 档把 ART 放在上下文里、不给工具,分别只给两条 RT 蛋白序列、只给两个位点当文本;第 3 到 5 档把 ART 当文件、配上分析工具,依次再加全部 96 个位点、再加预测结构、再加文献与网络。模型独自作业,报告由裁判模型按十条预先拟定的特征逐条打分。每个模型每档 100 次尝试2。
七款 Claude 模型分成两档。Opus 5.5、Mythos 5.1、Mythos 5 与 Opus 5 明显高出一截,Opus 4.6、Opus 4.8 与 Sonnet 5 落在后面。当初那轮 campaign 跑在 Mythos 5 上。
最值得记下来的是三个部件受影响的方向不一样。RT 只给两条蛋白序列就能被准确描述;搭档基因是给的工具和信息越多描述得越好;阵列反过来走,只把位点放在上下文里时,四个高能力模型至少 90% 的尝试描述正确,换成文件加工具后最低掉到 32%(Opus 5,第 4 档)2。
团队成员回头去看 transcript 里到底读了多少 DNA,才把这条曲线解释清楚:带文件时,39% 的尝试从头到尾没有读过一段连续 200 nt 以上的 DNA,也就看不到超过一个重复单元。只要读过 200 nt 以上,这几款模型认出阵列的比例就高出 16 到 32 个百分点。把读进上下文的 DNA 长度分档,四款高能力模型合并的识别率从 29% 升到最高 76%,Mythos 5 单独最高到 96%2。
所以,决定识别率的是模型有没有把原始 DNA 读进上下文,与工具编排的多少关系不大。
模型内部有两个信号在读到重复时会亮起
机制那一层,团队用了两个只在生物序列上训练的基因组语言模型当基线:Evo 2 从左往右预测下一个碱基,gLM2 双向预测被遮住的碱基2。在 L0050 那段侧翼上,两者的似然曲线都高置信地标出了重复;把每个拷贝的核苷酸原地打乱,信号随即消失。gLM2 双向读,连第一个拷贝都预测到了;Evo 2 只读前文,前两个拷贝预测得很差,沿阵列往后才变好2。
接着他们把当初那次发现会话的 transcript 重新过了一遍 Mythos 5,用稀疏字典把它在某一层上的活动分解成一个个可读的信号。选信号的办法值得注意:在查看 L0050 之前,先用人工合成的重复序列——在计算机生成的随机序列里植入重复——筛出 12 个候选,条件是它在第三个及以后的拷贝上的响应高于每个拷贝被打乱的孪生序列;最终展示的两个,是看过 L0050 之后从这 12 个里挑出来的2。
两个信号的形状不同。阵列之前都静默;repeat-signal 2 在第一个拷贝处只是微弱响应,从第三个拷贝起稳定下来,活动基本限制在重复单元和紧接其后的那个核苷酸上;repeat-signal 1 在第三个拷贝达到峰值后衰减,活动散落在各拷贝与侧翼上。对照是原地打乱每一个拷贝:repeat-signal 1 在 14 个里有 12 个被静默,repeat-signal 2 全部 14 个被静默2。
这条证据能推到哪一步,材料自己划了线。这两个信号对重复起反应,触发条件与碱基组成无关:把重复植进随机字母数字串,它们同样有反应。可以成立的表述是,模型内部存在对重复有反应的信号,而这个反应之后紧跟着出现了把它命名为「串联重复阵列」的自然语言推理。
还没回答的部分,和三处口径差
功能是空的。预印本写明:没有证明这个 RT 有活性,也没有证明那些单元 RNA 是它的底物;RT 与搭档是否互作,以及这个系统对噬菌体有什么用,目前都还不知道。结构全部来自预测,同源搭档复合物的界面置信度只有中等2。判定「认出阵列」的那个基准,裁判是自家模型,十条特征也由作者自己拟定。预印本尚未经过同行评议,正文里没有给出代码或数据的公开地址。
新闻稿和预印本之间还有三处口径需要留意:
| 项目 | 新闻稿的说法 | 预印本的说法 |
|---|---|---|
| 规模 | 约 950 个 agent、2.1 亿 token、21 小时 | 949 个会话、2.156 亿 token、21.5 小时墙钟 |
| 候选 | 收敛到 20 个最有希望的候选 | 17 个候选搭档家族,最终 19 份报告 |
| 阵列的位置 | 出现在一个长得很怪的 RT 的基因旁边 | 是在那些 RT 的近亲上游读到的 |
把这件事放进同一批材料里看,还有一处对照。预印本自己提到,类似的 ncRNA 阵列最近也在另一类无关的 UG27 RT 旁边被发现过,工具是一个为挖掘非编码元件专门打造的基因组语言模型,作者由此判断这种架构在自然界出现过不止一次6。两件事的对象同类,路线不同:上一次靠的是专用模型,这一次靠的是通用模型直接读 DNA。
外部的谨慎评价也一并放在这里。CRISPR 基因编辑的先驱之一、MIT 与 Broad 研究所的 Feng Zhang 在看过预印本之后说,这是「an exciting example of how AI agents can contribute to biological discovery」,RNA 重复阵列与逆转录酶的关联「is genuinely intriguing and merits further investigation」1。
现在成立的部分是清楚的:一类以前没人写下来的酶系统定义、一层来自公开感染数据的表达证据、一个关于模型为什么能看见的机制说明,以及一个作者自己测出来的失败模式——把分析打包成文件和工具交给模型,反而让它少读了原始序列。要等的是功能表征:这个系统做什么、酶有没有活性、那排 RNA 是不是它的底物,全都空着。
References
- 1
- 2Autonomous AI agents discover reverse transcriptases with tandem repeat arrays
www-cdn.anthropic.com
- 3
- 4Claude Science
claude.com
- 5
- 6
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.