开放模型更便宜,科研数据谁来守?先看五个明文落点
开放模型降低企业成本,却把模型部署、日志、检索和科研数据明文保护责任推回组织;文章拆解五个检查点,并说明密态 AI 可承接的保护边界。

9 月 7 日,《纽约时报》报道,美国企业正把更多任务交给开放模型:AT&T 的开放模型使用量从今年 5 月的 20%升至 40%,公司称相关方案最高可节省 80%的成本。1
便宜、可下载、可修改,听起来像是数据更可控。真正的问题是:模型开放之后,科研数据由谁守?
开放权重,不等于隐私自动留在本地
开放权重模型减少了对外部模型接口的依赖,却把更多责任交回企业:模型文件从哪里来,运行在哪台机器,日志和缓存保存多久,检索库谁能访问,微调数据是否混入训练流程,密钥有没有和模型服务放在一起。
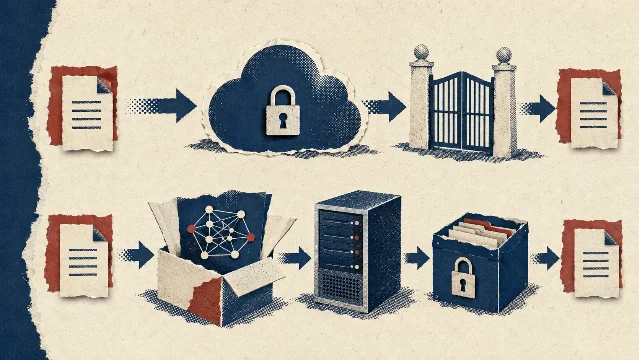
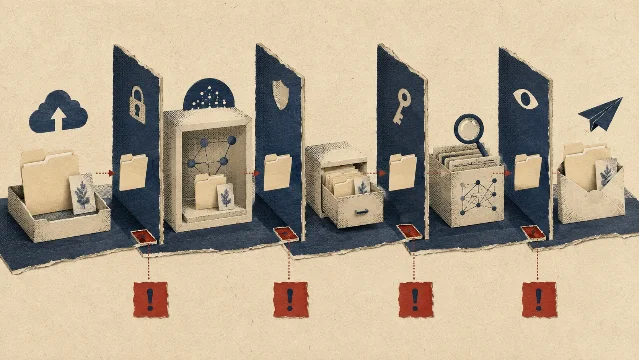
科研场景尤其敏感。论文草稿、未公开实验数据、受试者资料和 API 凭证进入模型后,至少要逐段检查五个位置:上传、推理、缓存、检索和导出。模型部署在内网,只能缩短数据离开组织的路径;它无法自动回答谁能读取日志、谁能复制向量库、谁能把结果带出系统。
科研数据最容易在哪一步露出明文?
上传环节可能留下原始附件;推理环节可能产生临时副本;缓存环节可能把提示词和结果写入磁盘;检索环节可能让无关项目共享同一知识库;导出环节则可能把带有身份信息的摘要发到个人设备。每一处都需要权限、留存、删除和审计规则。
这也是开放模型与 AI 隐私平台的分工差异。开放模型解决“模型能不能由组织掌握”;专门的 AI 隐私平台解决“材料进入计算链路后,平台和模型能不能看到明文”。两者可以配合,不能互相替代。
把保护前移到输入和推理
新华社报道的公开演示显示,墨镜熊将用户输入先在终端加密,再把密文送到云端大模型处理,结果返回终端后解密;报道将这条“输入—推理—输出”链路概括为避免明文暴露。2 墨镜熊关于页的公开检索信息还列出本地加密、密态搜索和平台与模型无法访问明文数据等说明。3
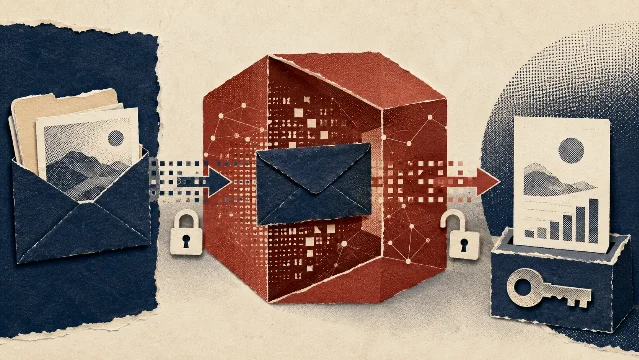
对科研团队来说,这类平台可以承接已获授权的研究附件、检索和分析,让保护覆盖输入、计算、搜索与结果返回。组织仍需负责模型来源审查、依赖和密钥管理、访问审批、留存删除、异常监控及人工复核。
开放模型降低了使用成本,也把隐私责任推近了数据所有者。涉及受试者资料、未公开成果或核心凭证时,先看完整数据流,再决定模型是否值得接入。需要处理高敏材料,可先访问 www.mojingxiong.com 了解公开能力。
References
- 1《纽约时报》:美国企业界日渐青睐开放人工智能模型
cn.nytimes.com
- 2新华网:人工智能大会|让AI“看不见”数据也能完成计算
xinhuanet.com
- 3墨镜熊:下载中心
mojingxiong.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.