AI 全景情报 0807:AMD 收购 Taalas,Terafab 押注 168 亿美元,推理竞争下沉到系统
8月6日至7日,AMD收购Taalas、Tesla与SpaceX启动168亿美元Terafab、Mirendil锁定超1亿美元Google Cloud算力协议,Google Cloud和DeepSeek则把竞争推进到数据查询与人形机器人执行层。
先看结论
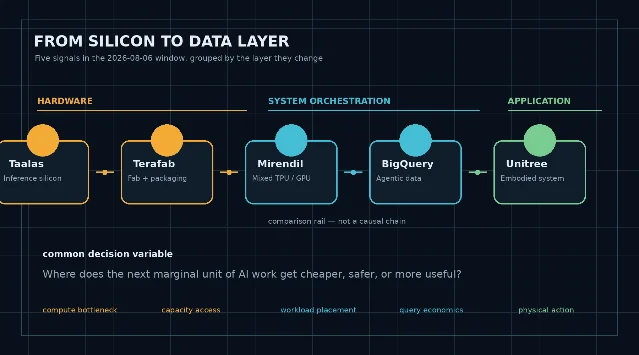
本期覆盖 2026 年 8 月 6 日 08:00 至 8 月 7 日 08:00(Asia/Shanghai)。五条新增信号没有共同的发布方,却把同一个问题推到了台前:AI 的下一笔预算,正在从「买一张更快的卡」变成「把推理芯片、封装产能、异构集群、数据查询和物理执行一起算账」。
AMD 收购 Taalas,买的是专用推理硅片;Tesla 与 SpaceX 为 Terafab 宣布首期投入 168 亿美元,押的是制造、封装和测试一体化;Mirendil 用一份超过 1 亿美元的多年协议锁定 Google TPU、NVIDIA GPU 和托管训练集群;Google Cloud 则把 BigQuery 的查询优化做成面向 Agent 工作负载的自动系统。DeepSeek 投资 Unitree 的上海 IPO,并共同开发人形机器人模型,则把模型公司的资本进一步推向物理世界。
给 AI 从业者的判断很直接:未来评估供应商、产品和投资标的时,至少要拆开四个字段——单位任务成本、可用算力、数据层延迟、物理动作可靠性。下面五条消息分别落在这四个字段上;它们之间不构成因果链,但可以放进同一张交付表。
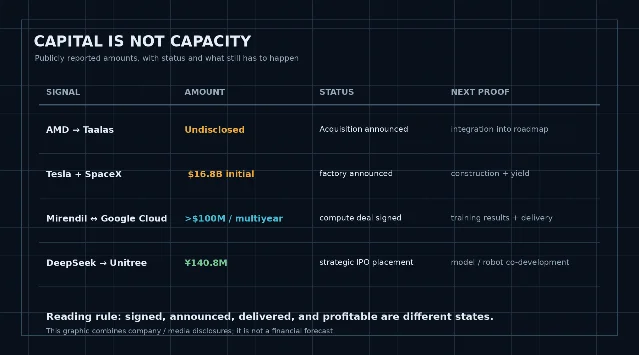
| 条目 | 已确认的变化 | 对从业者的直接含义 | 下一步看什么 |
|---|---|---|---|
| AMD 收购 Taalas | 交易金额未披露;Taalas 的专用硅片瞄准推理中的计算和内存瓶颈,并将并入 AMD 加速器路线图。1 | 推理性能要同时看芯片、内存和软件栈,不能只看峰值算力。 | 集成路线、样片、基准测试和客户验证。 |
| Terafab | Tesla 与 SpaceX 宣布在德州 Grimes County 建设芯片工厂,初始投入 168 亿美元,规划制造、封装和测试。2 | 巨额资本承诺不等于当年可用的 GPU 或推理容量。 | 开工、设备、良率、产出节奏和功耗/用水约束。 |
| Mirendil × Google Cloud | 多年协议价值超过 1 亿美元,覆盖 Google TPU、NVIDIA GPU 和托管训练集群。3 | 云采购的比较单位从单芯片价格转向异构工作负载调度。 | 算力是否按期交付,以及不同芯片上的训练效率。 |
| BigQuery 自动优化 | Google Cloud 发布 History-Based Optimizations、Advanced runtime 和 Fluid Scaling,并给出多组「最高」性能/成本改善数据。4 | Agent 的成本还包括检索、查询和数据搬运,不能只算模型 token。 | 自己的查询是否属于 eligible workload,成本和延迟能否复现。 |
| DeepSeek × Unitree | DeepSeek 投资 1.408 亿元人民币,获得 Unitree 战略配售中的 933,399 股,并同意共同开发人形机器人 AI 模型。5 | 模型能力开始和机械、运动控制、物理数据的获取绑定。 | 联合模型、数据采集和真实环境成功率,而不是只看投资公告。 |
1. AMD 收购 Taalas:专用推理芯片变成路线图资产
AMD 8 月 6 日表示将收购多伦多芯片初创公司 Taalas,金额未披露。Reuters 报道称,Taalas 开发的是面向 AI 推理的专用硅片,目标是减少计算和内存瓶颈;AMD 计划把它的技术和工程团队纳入加速器路线图,并基于 Instinct GPU 开发系统级方案。1
这笔交易的重要性不在收购金额,而在买方是谁、买的是什么。AMD 已经有通用加速器,仍然愿意把一家专门处理推理瓶颈的团队收进来,说明实时、高并发部署的约束不只来自模型规模,也来自内存移动、数据布局、编译器和系统整合。
这里不能把新闻写成「AMD 已经拿到更快的推理芯片」。当前能确认的只有收购计划和技术方向,芯片何时完成、是否量产、性能提升多少,均未在报道中披露。对投资人而言,交易价格和后续收入都还不能估算;对采购团队而言,纸面 TOPS 也还不能替代每任务 token 成本、显存占用和可用容量。
这对 AI 从业者意味着什么:
- 工程师要把模型、内存、互连、编译栈和功耗放进同一份推理基准,而不是只比较 GPU 峰值。
- 产品经理要先识别自己的瓶颈是计算、内存、网络还是并发调度,再判断专用芯片是否真的有价值。
- 投资人下一步应看 Taalas 技术何时进入样片、客户验证或 AMD 产品路线,而不是把一次收购公告当成商业结果。
2. Terafab:168 亿美元先买制造能力,暂时还不是算力供给
Tesla 与 SpaceX 宣布在德州 Grimes County 建设 Terafab,初始投资 168 亿美元。TechCrunch 报道称,项目规划超过 1 亿平方英尺制造空间,至少雇用 3,000 人;SpaceX 的计划包括在同一地点完成先进逻辑与内存器件的制造、封装和测试,并生产面向 Optimus、Cybercab 的边缘/推理芯片,以及服务太空数据中心的高功率芯片。2
这是一项垂直整合计划:Tesla 的机器人和自动驾驶需要边缘推理,SpaceX 的太空数据中心需要高功率计算,工厂则试图把制造、封装和测试放在一处。它解决的是供应速度、定制化和系统协同的问题,不是单纯扩大云端 GPU 租赁池。
但 168 亿美元是初始投入,不是已上线容量。工厂能否按期建设,采用什么工艺,设备何时到位,良率怎样,最终每年能出多少芯片,都还没有在这次公告里得到验证。地方政府的税收优惠和居民对透明度的担忧,也说明这类项目的约束不只有资金,还有土地、能源、水和许可。6
这对 AI 从业者意味着什么:
采购团队不应把供应商的工厂投资额直接填进下一年度算力计划。要把「宣布」「开工」「设备进场」「稳定量产」「客户可用」设成不同状态,并分别记录预计时间、区域、功耗和 SLA。对芯片投资,Terafab 的后续验证点不是宣传中的建筑面积,而是可重复的芯片产出和真实工作负载性能。
3. Mirendil × Google Cloud:异构算力采购进入长期合同
Mirendil 与 Google Cloud 签署多年合作协议,价值超过 1 亿美元。TechCrunch 报道称,协议为 Mirendil 提供 Google TPU、NVIDIA GPU 和托管训练集群,用于其「自我改进 AI」研究;金额和合作内容来自 Mirendil CEO 对 TechCrunch 的说明。3
「自我改进 AI」在这篇报道中指能够反复改进自身知识和表现的系统,是 Mirendil 的公司目标,不是已经被独立验证的产品能力。对这条消息更有用的部分,是它把 TPU、NVIDIA GPU 和托管训练集群放在同一份采购里。创始团队的判断是,不同工作负载可以匹配不同芯片,从而降低训练和客户使用成本;这是公司对技术路线的解释,不是第三方 benchmark。3
这会改变 AI 基础设施的比较方法。过去常问「哪张卡更快」,现在更该问:训练任务能否在多种加速器之间切分?数据、编译和调度开销是多少?云厂商能否按承诺交付托管集群?如果答案不清楚,低价芯片并不一定带来低成本训练。
这对 AI 从业者意味着什么:
工程团队可以把代表性任务拆成预训练、微调、评测和在线推理四类,分别测 TPU、GPU 和软件栈的总成本;产品和采购团队要把交付容量、迁移成本、锁定期限和退出条件写进合同;投资人则应把「签了超过 1 亿美元协议」与「模型已产生收入」分开看。
4. Google Cloud:BigQuery 开始替 Agent 工作负载自己调优
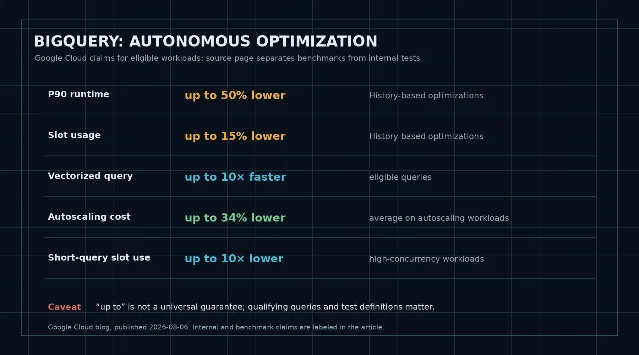
Google Cloud 8 月 6 日发布 BigQuery 性能优化说明,提出 History-Based Optimizations、Advanced runtime 和 Fluid Scaling。History-Based Optimizations 会根据历史查询结果自动采用有效优化,遇到回归或失败时回退;官方还称,某企业客户的 P90 执行时间最多下降 50%,slot usage 最多下降 15%。4
文章还给出一组更激进的上限值:符合条件的查询使用增强向量化后最高可快 10 倍,slot time 最多减少 40%;高并发短查询的 slot usage 最高下降 10 倍;自动扩缩容工作负载的平均成本最高下降 34%。Google Cloud 同时说明,这些数字分别来自符合条件的查询、行业标准 benchmark 或内部测试,不能当成所有客户的统一保证。4
这条更新与模型发布无关,却直接碰到 Agent 的单位任务成本。一个企业 Agent 每次回答可能要反复查表、过滤、聚合和读取开放格式数据;如果查询计划、shuffle 和扩缩容都需要人工调参,模型降价也可能被数据层开销吃掉。Google Cloud 把自动优化、Iceberg 等开放表格式支持和按 slot-seconds 计费放在同一篇文章里,实际是在争夺 Agent 的数据执行层。4
这对 AI 从业者意味着什么:
不要只拿官方的「最高」数字做采购依据。先用自己的查询记录确认 workload 是否符合条件,再看 P95/P99 延迟、slot 使用、数据格式、回退机制和账单变化。对 Agent 产品,检索链路应和模型调用一样有可观测的成本字段;否则你只能知道回答贵,却不知道贵在 token、查询还是数据搬运。
5. DeepSeek 投资 Unitree:模型资本开始购买物理数据路径
据 Reuters 援引交易所文件,DeepSeek 投资 Unitree 1.408 亿元人民币,获得 933,399 股 Unitree 股票,约占上海 IPO 战略配售股份的 2.31%;双方同意共同开发用于人形机器人的 AI 模型。Unitree 的能力边界包括机械工程、运动控制和具身智能,DeepSeek 提供模型能力,合作目标是让机器人更好地理解陌生环境并把指令转成动作。5
这里要分清两个比例:2.31% 是战略配售中分配股份的比例,不是 Reuters 报道所说的 Unitree 全部股权比例。投资金额也不能证明联合模型已经完成,更不能证明人形机器人已经解决泛化和可靠控制。
这笔交易值得看的地方,是模型公司把资本放到了物理数据和执行链上。人形机器人缺的往往不是一句更自然的指令,而是跨环境数据、动作控制、仿真到现实的迁移和失败后的恢复。模型与机器人厂商绑定,可能让数据采集和模型调优更靠近同一条工程闭环;能否成立,要等真实任务结果来验证。
这对 AI 从业者意味着什么:
做具身智能产品,要同时问四件事:训练数据从哪里来,动作是否可回放,失败由谁接管,真实环境中的成功率如何统计。做投资判断时,则应把 IPO 战略配售、联合开发协议、产品交付和商业收入分开记录,不能把资本关系当成技术成果。
风口判断:比较单位从「模型」转向「工作负载结果」
五条信号的共同点不是某家公司即将赢,而是竞争的计量单位正在变细:
- 芯片层:AMD 收购 Taalas,追问的是推理中的计算与内存瓶颈。
- 产能层:Terafab 把制造、封装和测试放进一个项目,追问的是芯片能否按期、按良率交付。
- 集群层:Mirendil 同时采购 TPU、GPU 和托管集群,追问的是工作负载能否匹配到合适的加速器。
- 数据层:BigQuery 自动优化查询,追问的是 Agent 的检索和数据处理成本能否被持续压低。
- 执行层:DeepSeek 与 Unitree 共同开发机器人模型,追问的是模型输出能否稳定变成物理动作。
这不是「算力越多,AI 就越强」的简单故事。算力资本只有在产能、软件、数据和动作结果都能被验收时,才会变成可交付的产品。未来 1—2 个季度,最值得跟踪的不是这些公告的 headline 金额,而是五个结果:Taalas 是否出现样片或产品整合,Terafab 是否进入可验证的建设节点,Mirendil 是否拿到并跑通异构集群,BigQuery 的优化是否在真实 Agent 查询中降低账单,Unitree 的联合模型是否改善真实任务成功率。
工程师现在就可以做一件事:把「每百万 token 多少钱」改成「每个完成任务多少钱」,并把 GPU 时间、内存、查询、网络、人工接管和失败重试都算进去。这个账本比下一个模型榜单,更接近 AI 生意真正会在哪里发生。
References
- 1
- 2
- 3
- 4BigQuery Performance Optimizations
cloud.google.com
- 5
- 6
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.