细胞的全预测模型:一笔 18 亿美元的账单,和一条只写给商业出资方的独占期
Biohub 把细胞预测模型的计划抬到 18 亿美元:政府侧出的是既有装置与既有数据,三家 AI 公司出 3 亿美元;本期逐段核对这笔钱的构成,并交代「开放数据」对商业出资方留的那段独占期。

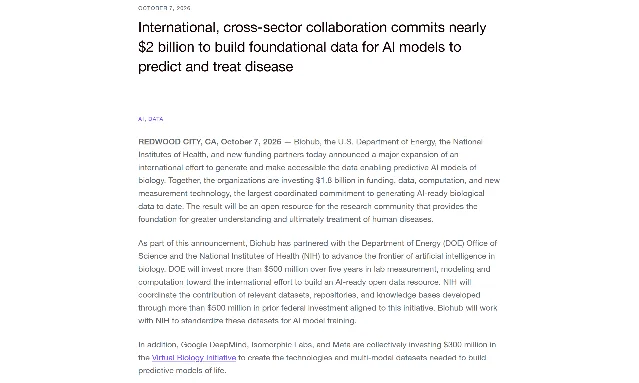
北京时间 10 月 7 日 21 点整,Biohub 在官网挂出一份稿子:细胞数据计划「虚拟生物学倡议」(Virtual Biology Initiative)的规模,从这家机构四个月前独自锚定的 5 亿美元,扩成四方合计 18 亿美元。同一天,美国能源部与国立卫生研究院各自发出官方稿,宣布三方已经签下谅解备忘录。Biohub 是 Chan Zuckerberg Initiative 旗下的非营利生物医学研究机构。123
三个小时后,Google DeepMind 与 Isomorphic Labs 的创办人、Alphabet 首席科学家 Demis Hassabis 转发了 Isomorphic Labs 的那条帖,写下:「The most important thing we can apply AI to is improving medicine and human health」——我们能拿 AI 做的最重要的事,是改善医学和人类健康。4
这 18 亿里,NIH 那一部分是把已经花过的联邦投入归集起来,不是新拨款;Google DeepMind、Isomorphic Labs 与 Meta 三家合计 3 亿美元,且没有拆分。而官方稿里那个「开放」,对商业出资方留了一段独占期。
稿子的第一段就把账目说完了:这些机构合起来投的是「funding, data, computation, and new measurement technology」,五项加总写成了 18 亿美元——这个数字是四类投入的合计价值,不全是现金。1
Loading content card…
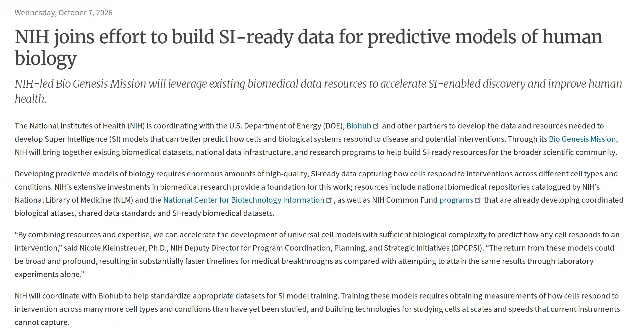
能源部那份稿子比 Biohub 挂得更早,标题写着「DOE, NIH, and Biohub Partner to Build Foundational Data for Predictive Biological Super Intelligence Models」,第一句就是三方签了一份谅解备忘录。2 国立卫生研究院的稿子同日挂着,副题写明这个院牵头的「Bio Genesis Mission」要用既有的生物医学数据。5
01 钱的构成:哪一部分是新钱
把 18 亿拆开是四段,而四段的性质并不一样。
最大的一段来自能源部:五年逾 5 亿美元,投向细胞研究的数据采集、分析、实验室测量与成像、建模和计算。2
第二段来自 NIH。Biohub 的稿子把这一段的性质写成「prior federal investment」——NIH 拿出来的是已经花掉的联邦投入所产出的数据集、仓储和知识库;NIH 自己那份稿则把动作写得很窄:「NIH will coordinate with Biohub to help standardize appropriate datasets for SI model training.」15
第三段是三家 AI 公司:Google DeepMind、Isomorphic Labs 和 Meta 合计 3 亿美元,用来做「the technologies and multi-modal datasets needed to build predictive models of life」。1 官方只给了合计数,三家的份额没有公开。
第四段是发起方自己。Biohub 四月为这个倡议锚定的 5 亿美元没有变:其中 4 亿用于内部开发测量技术,1 亿用于资助外部协调性的数据生成。3
四段里,属于这次新承诺的现金是能源部的逾 5 亿与三家 AI 公司的 3 亿;NIH 那 5 亿早已花过,Biohub 那 5 亿四个月前就写下了。所以「从 5 亿到 18 亿」描述的是这份计划的账面规模,「新承诺约 8 亿」才是这一天的增量。
时间线上的前四条消息挨得很紧:21 点整,Biohub 的稿子与通稿平台上的同稿;21 点 05 分,路透社发出报道;21 点 06 分,Biohub 官方账号单独发帖重复那 3 亿;21 点 09 分,Isomorphic Labs 宣布自己以创始成员身份加入。这四条之间的间隔都在 10 分钟以内。Hassabis 的转发在 23 点 53 分才出现。1467
02 为什么先把钱花在数据上
这笔钱的第一去向是数据本身。理由写在同一批文件里:蛋白和基因组都有各自的基础数据设施,细胞没有对等的那一套。
Biohub 共同创始人 Priscilla Chan 在 4 月的一篇文章里把缺口讲得最直白:蛋白有 Protein Data Bank,基因组有 NCBI 的序列库,细胞没有对应的东西,而「the vast majority of cellular activity has never been observed or measured」——绝大多数细胞活动从来没有被观测或测量过。8
第二条理由来自 Arc Institute——四月第一批加入这个倡议的研究机构之一。它的 State 模型页写明:观测再多也不够,「Even with observational data from millions of cells, a virtual cell model cannot zero in on causal effects」;而扰动数据「can capture the same interaction with a single measurement」——要判断两个基因之间的直接关系,观测可能要「tens of thousands」次,扰动一次测量就能拿到。9
NIH 那份稿子把同一件事写成了对仪器的要求:训练这些模型需要的测量,覆盖的细胞类型与条件「many more…than have yet been studied」,还需要「technologies for studying cells at scales and speeds that current instruments cannot capture」。5
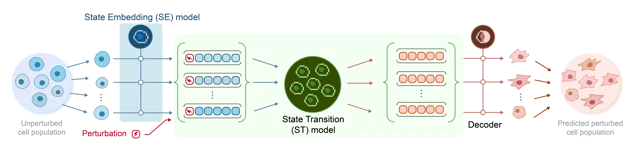
把现有几个数据集的规模放在一起,差距能看出来。Arc 的 State 用的是近 1.7 亿个细胞的观测数据,加 1 亿个细胞的扰动数据,覆盖 70 个细胞系;这套模型按官方授权只作非商业用途。9 更早的一次基因组尺度扰动实验,覆盖了 250 万个人类细胞。10 人类细胞图谱是一个国际合作项目,也是这个倡议的参与者;到 2024 年 11 月,它汇集了 100 多个国家的成员,刻画了「more than 100 million cells from over 10,000 people」,并写明下一版目标是「up to billions of cells」。11
Biohub 首席科学官 Alex Rives 给出的差距更直接:现有细胞数据集是「hundreds of millions」量级,而一个准确的预测模型需要「billions and eventually trillions」;他把时间表也说了——第一个数据集大约一年,准确的预测模型五年内。12
从亿级到万亿级,中间隔着一到四个数量级。这就是为什么第一笔钱买的是观测,而不是算法。
03 这不是开端:它接在一条已有的国家计划上
能源部与 NIH 那两份稿,都把这件事写进了既有的国家计划,而不是写成新起点。
能源部那份写明,这份备忘录是执行「创世纪任务」的行政令的一步。2 这条线此前已经在跑:NIH 牵头的 Bio Genesis Mission 于今年 7 月启动,官方目标是「double the pace of biomedical innovation…within the next five to 10 years」。13 能源部 7 月 22 日还宣布过另一笔账:创世纪任务通过联盟拿到逾 8 亿美元的伙伴承诺,参与方包括全部 17 个国家实验室与 41 家产业、非营利和慈善组织——那是联盟此前那一轮的承诺,与十月的这份备忘录各自记账。14
能源部这次拿出来的是既有装置与算力,官方列的清单分四类:前沿算力、先进实验设施(含联合基因组研究所、环境分子科学实验室、X 射线与中子散射、冷冻电镜与冷冻电子断层扫描)、自主实验室,以及生物数据系统。2
还有一个用词差异值得记下:能源部与 NIH 两份稿统一写「Super Intelligence(SI)」,Biohub 自己的稿子写「AI」。同一件合作,在政府文本里被归进了「超智能」这套政策语汇,在机构文本里仍是人工智能。125
所以 10 月 7 日新添的那一步,是三家 AI 公司与一家慈善机构办的生物医学研究所,进入了原本由联邦实验室与联邦数据构成的那条线。
04 三家 AI 公司各摆在哪
官方稿只写了三家合计 3 亿美元,没有拆分。三家里有一家给了理由,一家给了方法,剩下那一家到现在没有出声。
Isomorphic Labs 宣布自己以创始成员身份加入,总裁 Max Jaderberg 给的理由是产能:「Generating the data to solve predictive systems biology requires scaling past the limits of what any single organization can produce today.」715 这家公司今年 5 月完成 21 亿美元的 B 轮融资,投资方包括母公司 Alphabet 与 GV。16 它的药物发现模型没有开源:《自然》今年 2 月的一篇新闻,标题与副题把这件事写成了对照——科学家赞叹这套独家模型,同时「scientists developing open-source tools are left guessing」。17
Google DeepMind 的落点是把它接回自己的方法论。负责「AI for Science」的副总裁 Pushmeet Kohli 写道:「As we learnt from AlphaFold and the Protein Data Bank, solving grand biological challenges will not be possible without high-quality open data」——AlphaFold 加公共数据库这个组合,就是它给出的先例。18 Google DeepMind 与 Biohub 这条线此前已有实物接口:Biohub 今年 5 月发布过 ESM 系列的开放模型,其中 ESM Atlas 覆盖 68 亿条蛋白序列。19 再往上一层,Alphabet 的 CEO Sundar Pichai 在 9 月把公司的四个重点方向排过一次序——健康、自然灾害与天气韧性、学习、经济机会,健康排在第一。20
一个合并的数字被三家共用,其中一家到发稿时没有解释自己为什么在这里。在一次以「开放数据」为名的合作里,这处空白值得读者自己留着。
05 「开放」的边界写在合同里
18 亿里最不显眼、也最该看清的一条,是数据公开的时间次序:商业出资方先看到这批数据,之后才对公众开放。
Rives 对路透社确认了这条安排,原话是「With commercial funders we have embargo periods where there's a period of time where the groups can work on the data, and then it becomes available as a public scientific resource.」同一篇报道里,他说政府出资那条并行推进的线,不带这类限制。独占期的时长,官方没有公布。12
这条安排与发布稿之间的落差,就在时间上。Biohub 的稿子写的是「The result will be an open resource for the research community」——一句开放资源的承诺,没有交代先后次序。1
官方对现有模型能力的判断,同样比发布稿的调门保守。发布后约七小时,Biohub 官方账号在一条帖子里写:「Models trained on available biology data show real but limited capability.」——用现有生物学数据训练出来的模型,能力是真的,但有限;接下来能打开局面的,是「measurements in living tissue across space and time」这类活体组织上的时空测量。21
「数万亿」这个目标值本身也有个口径问题。Rives 说的是「billions and eventually trillions」,官方没有说明这个数字数的是细胞数,还是细胞数乘以实验条件的数目。12
同一批数据,两种出资换来两种可见时间:商业出资方先有一段独占期,联邦资金买下的那一份随后公开。这一条没写进新闻稿,写在采访里。
06 同一件事的另一端
在 AI 与生物这条线上,今年 9 月到 10 月出现了三种不同的花法:造新的公共数据、抢救既有的稀缺数据、闭门做发现。
造新数据的是本篇开头这份计划。抢救既有数据的是 OpenAI Foundation,它 9 月 15 日宣布支持逾 1.25 亿美元,用来创建和保存生命科学领域的高质量数据集,理由是「Some datasets with enormous public value may never be created or shared because no individual institution has enough incentive or capacity to fund them.」22
闭门做发现的是 Anthropic。它 9 月 17 日开放生命科学验证程序,为专业人员提供「a refined set of safeguards more permissive for biology-related work」,高风险用途按项目授权、每六个月续期,并要求三十天数据保留以支持离线监控。23 六天后它公布了一次湿实验室结果:Claude 提出并筛选出一个与 DNA 重复序列相关的新酶系统;官方在同一页写明「the function is still unknown」,而且「All of the lab work is performed by human scientists」。24
三种花法指向的是同一笔账:模型预测的结果最终要在临床上兑现,而临床的失败率极高。AI 设计的药物里,公开进度最快的一支是英矽智能(Insilico Medicine)的 rentosertib,今年 7 月 7 日进入 III 期,适应症是特发性肺纤维化。25 约 90% 的药物会在临床阶段失败——这个数字同时挂在 Arc Institute 与 OpenAI Foundation 的页面上。922
这次发布没有宣布能力上的跳跃,各方自己给出的时间表是一年出第一份数据集、五年内出准确的模型。十月这份文件真正确定的是另一件事:同一批数据,商业出资方先看,公共资金买的那一份随后公开。
References
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13Bio Genesis Mission · NIH
nih.gov
- 14
- 15
- 16
- 17
- 18
- 19AI models · Biohub
biohub.org
- 20
- 21
- 22Public Data for Health · OpenAI Foundation(2026 年 9 月 15 日)
openaifoundation.org
- 23
- 24
- 25
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.