从 100 个枢纽的算例到洲际网络:Google 开源中程物流实例生成器 MilleMiglia
解读 Google Research 2026 年 9 月 18 日开源的 MilleMiglia:它把中程物流一直缺位的公开数据换成可复现的合成实例,而基准解与真实性验证都还没有跟上。

一票货的旅程里,中程物流通常是最长的一段,也是最缺公开数据的一段:货在区域配送中心之间移动,途中换几次车,班次固定,时间窗卡得很死。Google Research 的官方博客在 2026 年 9 月 18 日发文介绍 MilleMiglia——一个按统计分布生成中程物流实例的 C++ 程序,代码挂在 OR-Tools 组织下的仓库里,Apache-2.0 许可12。它不求解路线,生产的是“实例”——一套枢纽、线路、班次与待运货物的数据,让不同的求解器能在同一批问题上比较12。
有一条时间线值得先记住。配套论文《A Novel Instance Generator for Simulating Middle-Mile Logistics Networks》是 2024 年 6 月 30 日在第 33 届欧洲运筹学会议(EURO)上报告的会议论文,作者是 Aymane Lotfi、Matteo Petris、Thibaut Cuvelier、Bruno De Backer 与 Claudia Archetti3。仓库 2023 年 6 月 14 日建好,2026 年 9 月 12 日打上第一个版本标签 v0.0.1,发布说明只写了 Feature-complete,同一天挂出一个 72,450 字节的样例实例4。九月的博客介绍的,是这批 9 月 12 日定型的代码;方法的成型则要早两年。
这次发布的增量落在数据这一层:物流公司视为机密的网络拓扑与需求,被换成一份可以复现、可以调难度的合成实例集。判断值不值得跟进,要看的就是这一层现在的成色——实例里装了什么、合成出来的网络离真实有多远、一个没有基准解的实例库离可比较的基准还差几步。
一票货要走三辆车,难点在换车
第一公里与最后一公里是运筹学里被研究得最多的两段。一票货从起点到终点始终待在同一辆车里,问题因此落在车辆路径问题(vehicle routing problem,VRP)这一族上:带容量约束的 CVRP、带时间窗的 VRPTW、带取送与时间窗的 PDPTW,都是用 OR-Tools 这类开源工具或 Google Maps Platform 路线优化这类 API 求解的对象1。
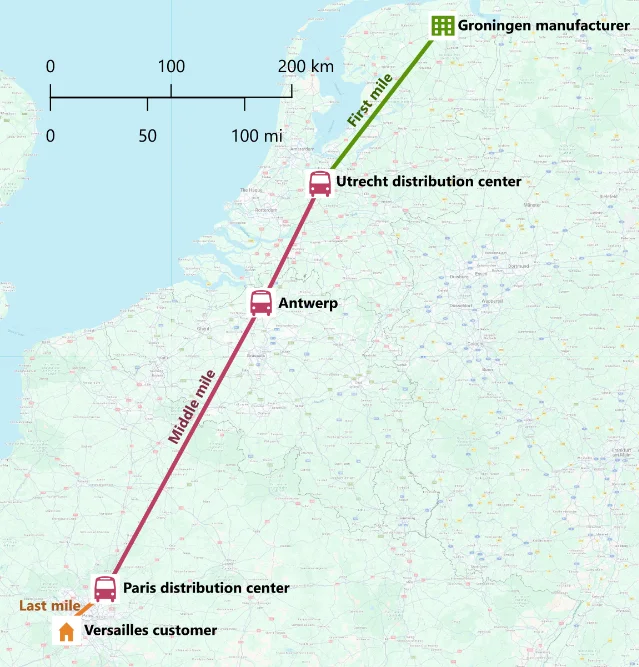
中程物流的结构不同。一票货要在多个枢纽之间接力:途中卸货、按目的地分拣、与其他货物拼车,再装上另一辆车;班次固定,货必须在时间窗内到达枢纽才接得上下一班,错过就要等下一个周期1。博客用一个例子把这条链说清楚:荷兰格罗宁根的厂商把货送到乌得勒支的区域中心,从乌得勒支转到安特卫普,再从安特卫普转到巴黎,最后交末程送到凡尔赛的客户手里。当天从安特卫普开往巴黎的那班车如果已经装满,货就在安特卫普多停一天,客户的收货时间跟着往后推1。中程这一段里程最长,在总物流开支里占比很大,也是决定货到手还新不新鲜的那一段1。
学术进展卡在数据上。物流公司把网络拓扑与需求体量当作高度敏感的机密,公开可用的高质量数据因此长期缺位,研究者难以在同一批问题上比较方法1。
发布的实例里装了什么
MilleMiglia 是一个 C++ 程序,生成的实例用 Protocol Buffers 序列化成单个文件,任何语言写的求解器都能读1。一份实例分两块:LogisticsNetwork 描述枢纽、线路、车辆与网络参数,另一块是待运的货件列表5。
线路(line)是一条按顺序停靠若干枢纽的运输线路;轮次(rotation)是这条线路上按固定时刻表发出的某个班次,每个班次带各枢纽的到达与出发时间、可用车辆数和一个固定价格5。货件(shipment)记录起点枢纽、终点枢纽、出发时间、期望到达时间,以及重量一类的维度值5。
| 样例实例(example.textproto) | 取值 | 说明 |
|---|---|---|
| 枢纽 6 | 100 个 | 只有名字,没有坐标 |
| 线路 / 轮次 / 车辆 6 | 10 条 / 42 个 / 42 辆 | 每个轮次上限 1 辆车 |
| 货件 6 | 20 票 | 重量在 1–100 的区间里采样,维度名是 weight |
| 时间跨度 6 | 一天,0–24 小时 | 文件里的日期是 2023-03-10 |
| 文件大小 6 | 72,450 字节 | 单文件 protobuf 文本格式 |
这张表里有三处细节值得动手前知道。枢纽在格式里定义了经纬度字段,生成器没有填,样例里每个枢纽只剩名字,距离矩阵与时间步长同样是空的56。每辆车的成本在数值上等于它的容量,生成代码里就是
v.set_cost(capacity) 这一行,两个本来不同的量被写成了同一个数7。每个轮次的固定价格等于该班次首末时间之差,也就是它的小时数7。成本与地理这两层目前装的是占位式的合成值:拿它训练模型可以,拿它估计某条线路的真实运费还不行。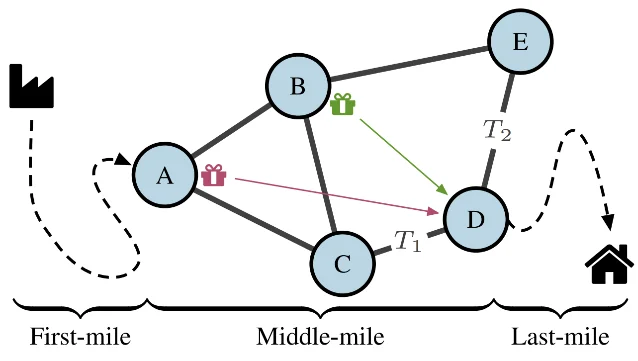
为什么要自己定一套数据格式
中程与 VRP 的差别落在决策变量上,现成求解器不能直接套用的原因也在这里。VRP 决定哪辆车按什么顺序访问哪些点;中程要决定的是每票货在时间展开后的网络上走哪条路径,而同一票货在哪个枢纽、什么时间上哪辆车,都得一起定下来1。
形式化的说法是多商品流(multi-commodity flow)建在时空图(space-time graph)上:节点是某个枢纽在某个时间区间上的状态,弧有两种,一种是车辆按时刻表在枢纽之间移动,另一种是货在枢纽里等待与分拣1。三类硬约束长在这个结构上,放松任何一条都会改变问题本身:班次固定,车辆按时刻表跑;枢纽有吞吐上限,每小时能分拣或越库的货量有限;衔接有先后,一票货先要随某个班次到达,才谈得上装到另一辆车上1。
把这三条对回公开的代码,只有两条落了地。班次固定写在轮次的到达与出发时间表里,衔接同步由时空网络和货件的出发、到达时间表达;枢纽吞吐还没有位置——Hub 消息里只有名字与坐标,没有容量字段,生成器暴露的参数里也没有任何一项管枢纽吞吐,货件的 size 注释写着与车辆和枢纽容量一起使用,而枢纽容量这个字段并不存在578。
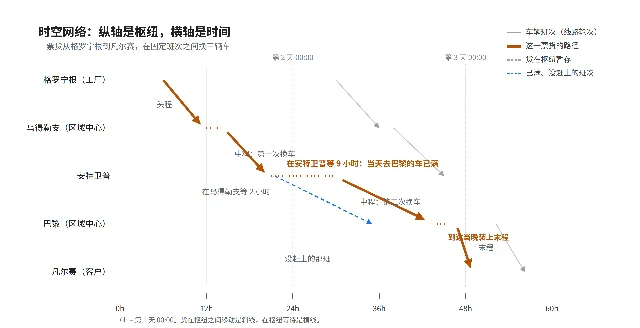
自制示意图,按论文与官方博客对多商品流模型的描述绘制。纵轴的五个枢纽取自博客那个例子,横轴 60 小时,灰线是各线路的班次,深色粗线是一票货的路径,短虚线是它在枢纽的等待。图里能看出文字不便表达的一层:班次是固定的斜线,货早到就在横线上等,接不上当天那班就要等第二天——这段等待在目标函数里直接变成交付延迟。
真实感是怎么造出来的
博客用三条分布解释生成的网络为什么像真的:枢纽按引力模型或空间聚类铺开,以反映人口与工业密度;需求按真实的体量与重量分布生成起点—终点对;轮次的结构化体现在它只连接两个主要枢纽,或者连接一个主要枢纽与它周边的小枢纽1。
代码里的做法更朴素。枢纽图用带优先连接的随机图生成(仓库 README 把它写作 Barabási–Albert 模型),从一个枢纽起步,每个新枢纽向已经出现的枢纽连若干条边,图上没有坐标;每条弧被车流选中的权重取两端枢纽的连接度之和,连接越多的枢纽车次越密27。货件的重量来自 Lomax 分布再按上下限截断;起点枢纽偏向连接度低的那些;货件路径在时空图上随机游走,每一步按剩余的最大路径长度决定要不要停下7。
这些设定都指向结构上像真的物流网络,但材料里没有出现任何一次对齐验证:没有拿某个真实运营商的网络比过拓扑分布,也没有报告生成实例与真实需求之间的拟合误差。论文摘要说这套生成器通过网络的规模与结构变化反映真实世界的复杂性,这是作者的判断,还不是测量结果3。这条边界决定了它能用来做什么:当作训练与压力测试的数据源,今天就能用;当作真实物流网络的替身去得行业结论,还缺一次验证。
做这件事的人和他们要解的问题
这批代码出自 Google Research 巴黎的运筹团队。团队成员 Thibaut Cuvelier 的研究页把这条线写得很清楚:他们把强化学习(reinforcement learning)用在组合优化上,中程物流是选定的应用域之一,围绕它产出过 NeurIPS 2023 目标条件强化学习工作坊的《Middle-Mile Logistics Through the Lens of Goal-Conditioned Reinforcement Learning》,以及 EURO 2024 上的两篇会议论文,其中一篇正是这份生成器910。
2024 年 5 月 CNRS 与 Google 联合活动上的报告给出了建模的样子:状态是一张时空图,节点是带时间的枢纽,边是带班次的卡车,货放在节点上;一次转移是一票货走一段;回报是货到达目的地11。求解用 PPO 加图神经网络(graph neural network,GNN)拟合价值函数与策略,报告对结果的描述是 GNN 拟合得不错,送达的货量明显高于线性模型11。生成器在这条线里的位置是数据层:训练学习型求解器、比较不同策略,都要求有大量可控难度的实例,这也是博客把造大数据集训练机器学习模型列为用途之一的原因13。
距离可比较的基准还差什么
博客给这套东西的定位是通往标准化基准的第一步,目标是像车辆路径问题的 CVRPLIB 那样,给中程物流一个公共实例库112。CVRPLIB 的每条实例都附带已知最好解与求解状态,不同的求解器在同一批数据上的表现因此可以横向比较12。MilleMiglia 现在给出的,是这件事的前一半。
差的几样东西,代码与博客都没有藏着:没有基准解与已知最优值,没有排行榜与评测协议,没有提交入口;专用求解器与 API 还在做,博客写的是团队正在为中程物流的运营问题开发一个专用求解器和 API;在此之上的挑战赛还停在愿望阶段1。
三处可以核对的细节适合动手前读一遍。仓库首页把合作方写成 ESSEC 与 Google OR,博客写的却是 UniBrescia 与 ENPC Paris,对应的是同一批作者当前的机构12。帮助文本与代码里的默认值有五处对不上:图密度 0.5 对 0.05、线路最大长度 10 对 4、每条线路最大轮次数 3 对 10、出货量 50 对 0、货件最大路径长度 10 对 58。帮助文本里列出的
-vehicle_rand_sample 在命令行解析里没有实现,照着帮助传参会直接报错8。今天能拿到什么
今天能拿到的,是一个可编译的生成器、一份定义实例格式的 proto 和一个 100 枢纽的样例:用 CMake 构建之后,调
-hubs_number、-nbr_lines、-shipments_number 这类参数,就能造出从几十个枢纽的玩具算例到跨洲规模的实例,重量分布、时间跨度、路径长度都可以改28。想测试自己的启发式或学习型求解器,现在有了一份不必依赖私有数据的输入。接下来要看的是三件事:专用求解器与 API 什么时候落地,有没有人拿这套实例跑出可比较的结果,生成网络的真实性有没有人补上验证。这三件事里出现任意一件,这份实例库才开始承担基准的角色。在那之前,它是一个起点清楚、材料齐全的开源项目;要不要跟进,取决于你手上的问题是不是中程物流这一类多商品流问题。
References
- 1
- 2or-tools/millemiglia
github.com
- 3
- 4or-tools/millemiglia v0.0.1
github.com
- 5millemiglia.proto
raw.githubusercontent.com
- 6example.textproto(v0.0.1 样例实例)
github.com
- 7instance_generator/InstanceGenerator.cpp
raw.githubusercontent.com
- 8main.cpp
raw.githubusercontent.com
- 9Research topics(Thibaut Cuvelier)
tcuvelier.be
- 10
- 11
- 12CVRPLIB instances
galgos.inf.puc-rio.br
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.