Google 开放论文评审助手 Deep Review:16,000 篇试点稿件,查错率只在 29 个错误上量过
Google Research 把内部评审工具 PAT 改名 Deep Review 并向全球开放,四场顶会 16,000 余篇稿件做过预投稿试点;这篇拆开四段流水线各堵哪个失败模式、三组效果读数各自的分母,以及官方这次没有量过的四项。

输入一篇论文的 PDF,输出的是一份逐条指出论证漏洞、数学错误与改进建议的报告。这套系统叫 Deep Review,Google Research 在 10 月 14 日把它对全球开放。1
它此前的名字是 Paper Assistant Tool(下称 PAT),过去一年以试点形式接进四场计算机科学会议,作者在投稿截止前自愿报名,拿到一份与正式评审完全分开的私有反馈。2
这次发布改的是可用性。每个用户每周有两次免费评审,接自己的 Gemini API key 可以提高额度并调用 Deep Review API;输入先只收 PDF 与纯文本,多文件稍后补上。1
数据政策也一并写清:上传的文档不用于训练、微调或改进 Google 模型,存放一年,只为在界面上展示给用户。1
官方给的动机是一个说法:AI 让生成变快了,验证没跟着变快。3 生成端那一边有投稿量这类硬数字,验证端那一边要看的是评审自己的一致性。
投稿量三年涨了两倍,人类评审的噪声本来就不小
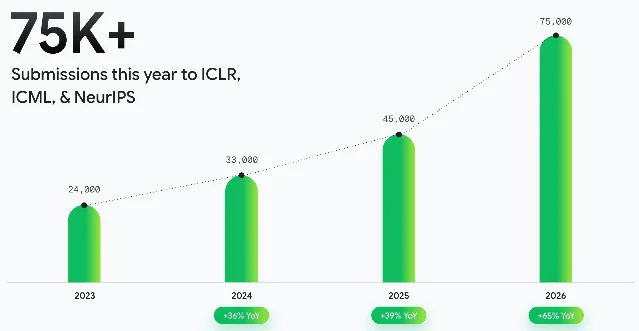
论文给了一张表:ICLR、ICML、NeurIPS 三家合计的投稿量,2023 年是 23,838 篇。两年后的 2025 年是 45,354 篇,2026 年估计 73,883 篇。2
官方博客的图取整成了 24,000 到 75,000,同比分别是 +36%、+39%、+65%。末位数是估计值,论文同时写明「不能断定这条曲线是 AI 造成的」。1
不用猜的说法也有一个:2024 年时,arXiv 上至少有 17.5% 的计算机科学摘要有 AI 生成痕迹。4
评审这一端的问题不只是量。论文引了 2021 年 NeurIPS 的一致性实验:把 10% 的投稿分给两个互相独立的评审委员会,两边的录取决定有 23% 不一致。5
那年的总录取率是 22.7%,完全随机抽签会得到 35% 的不一致率;剔除边缘稿件后降到 16%。2
这组数字说明,AI 评审不必比人类评审更准也可能有用。Deep Review 现在做的也正是这一段——检查逻辑一致性、验证数学陈述、核对事实,高阶判断留给人。1
但这条论证有一处不能照抄。两组独立的人类评审,错误互不相关;同一个 AI 系统产出的错误是相关的。论文在讨论全自动评审时自己写了这一条,理由是模型可能只持有一套集中的观点,会压低学术争论的多样性。2
四段流水线,每段堵一个失败模式
论文把设计动机写得比博客直白。最朴素的做法是把整篇论文塞进一次模型调用,问题是要验证复杂的数学断言就得生成大量思考 token,很容易超出单次调用的上下文容量。2
第二个候选做法是同一篇论文独立跑 k 次再拼起来。论文说它有两个硬伤:召回上去、精确率塌下来——每轮列十个问题、跑十轮,人要在一百条里找那一条真的;而且各次调用可能把预算花在同一批章节上,剩下的没人看。2
四段流水线就是冲这两条设计的。
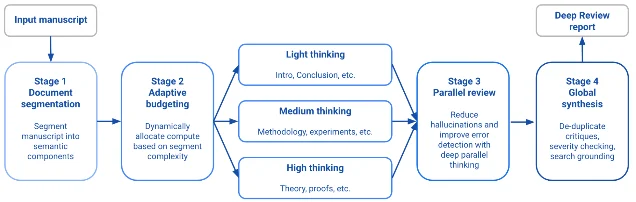
第一段分段:一个 segmenter agent 把文档切成有逻辑主题的段,段可以重叠、可以不连续,但必须覆盖全文。2
第二段分配预算:按每段的信息密度与复杂度动态给算力,密集的证明段多拿,引言与相关工作少拿。2
第三段并行深审:每个专职 agent 手里有全文作上下文,但只把推理花在自己那一段上。段内聚焦与段间交叉引用因此同时成立。2
第四段合成:一个 synthesis agent 合并各段报告,做跨段一致性检查,必要时重跑逻辑检查,最后用检索做一次落地核对,专门防幻觉。2
一个具体对照能说明前两段的差别。在一篇对偶 Banach 空间的论文上,单次调用的零样本基线接受了文中一个错误的完全收缩性断言;PAT 没有照单全收,而是构造出一个反例,指出主定理的漏洞。这篇论文的勘误记录公开在 arXiv:2405.01133。6
三组数字,三个分母
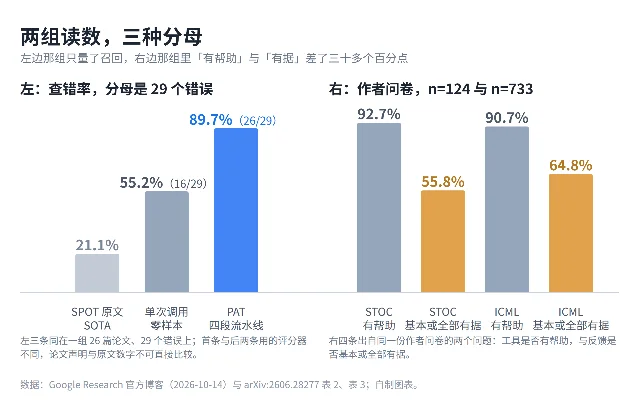
最常被引用的那个数是 89.7%,它来自 SPOT 基准。7
SPOT 汇编的是已有勘误或撤稿的论文,也就是说这个集合里每一篇都确实含有已知错误。论文再把范围收窄到数学与计算机科学的「公式 / 证明」类错误,得到 26 篇论文、29 个错误。2
同一组数据上,单次调用的零样本是 55.2%,PAT 是 89.7%。换成篇数是 16/29 对 26/29,差的 10 个错误就是全部差距。2
论文与博客都把这写成「比零样本召回率提升 34%」。这是百分点:89.7 减 55.2 等于 34.5;按相对值算是 1.63 倍。1
还有一处不能混。表里「SPOT 原文 SOTA 21.1%」与后面两行不是同一把尺子:SPOT 原文要求关键词精确匹配,本文改用能判断逻辑等价的评分器,并明确声明自己的数字与原文不可直接比较。评分由作者之一逐条人工复核。2
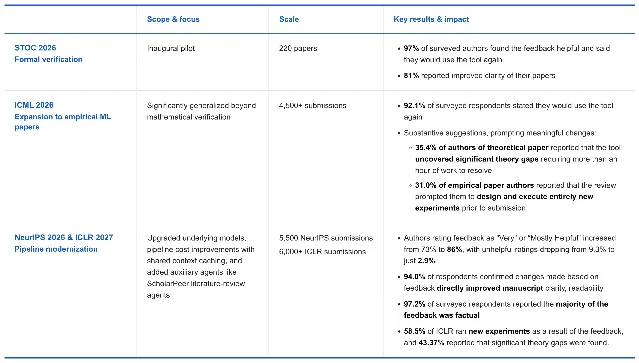
规模那一组的分母又不一样。四场会议的 16,000 余篇稿件,拆开是 STOC 220 篇、ICML 4,500 余篇、NeurIPS 5,500 篇、ICLR 6,000 余篇。1
论文正文只覆盖前两场,写的是「超过 4,700 篇」,与表里的 220 加 4,500 对得上。2
问卷那一组最小:论文表 3 的两列分别来自 STOC 的 124 份与 ICML 的 733 份问卷。2
同一份问卷里,有用和可信差了三十多个百分点
论文表 3 里最值得看的是两行挨着的数字。STOC 组 92.7%、ICML 组 90.7% 认为反馈「很有帮助或基本有帮助」。2
紧挨着的一行,认为反馈「基本或全部有据」的只有 55.8% 与 64.8%。2
这组落差对应的是论文自己点名的核心失败点——幻觉与误解。论文列出最常被反馈的三项问题:日期幻觉与知识截断、PDF 解析问题、以及因为推理失败或误解而错误地宣称某个证明是错的。2
前两项官方说已经用更好的检索工具与解析修掉;第三项论文承认「是任何基于 LLM 的系统都会有的产物」,仍在改。2
行为上的改变倒是真的。ICML 组 31% 的作者因为反馈去做了全新的实验;说工具找到了需要花一小时以上才能修掉的实质理论缺口的,STOC 组是 11.6%,ICML 组是 35.4%。2
ICML 组的理论缺口比例高出三倍,论文的归因是:ICML 不是理论会议,投稿的数学严谨度本来就更低。2
发布页的那张表还给了后两场会议的读数。认为「很有帮助或基本有帮助」的比例从 73% 升到 86%,认为没帮助的从 9.3% 降到 2.9%,97.2% 说多数反馈属实,58.5% 的 ICLR 作者因此做了新实验。1
论文还留了一条针对作者工具这个定位的反直觉副作用:AI 先把明显的问题修掉,论文会显得更完整,反而让人更难把真正强的稿子与磨得很光滑的稿子分开,评审人的负担可能因此上升。2
它被摆在四个角色里的第一格
论文给了一套四级分类,用来讨论 AI 进评审这件事。Role 1 是作者投稿前的工具,Role 2 是评审人的工具,Role 3 是 AI 生成一份完整评审供人复核(3.5 再加一个主观评分),Role 4 是全自动。2
Google 这一次留在前两格。论文的原话是,PAT 目前不产出主观评价,也不给论文排名,只找客观错误、提改进建议。2
往 Role 3 走要跨的门槛论文自己也列了。AI 评审的准确率得与人类评审比,而人类评审也有错;问责边界要划清,哪里是算法评估的终点、哪里是人的判断的起点,论文说这是开放难题。2
现实是评审端已经在用 AI,只是不说。论文引 Pangram 的检测:ICLR 2026 有 21% 的评审是完全由 AI 生成的,而这违反会议政策。11
同一节里论文举了一个反向的例子:AAAI-26 给每篇主赛道投稿生成一份明确标注的 LLM 评审。差别不在用不用,而在标不标。12
这次发布没有量过的东西
- 精确率与误报率。公开材料里唯一沾到边的是问卷那条 55.8% / 64.8%,而它问的是作者的主观感受,不是误报计数。
- 论文以外的文档类型。发布页说它能跑设计文档、演示文稿、法务与财务文件,但这几类一篇读数都没有;整套效果证据都来自数学与计算机科学的论文。1
- 所量配置与发布配置不是一回事。SPOT 那组数用的是 Gemini 3.1 Pro,试点用的是 Gemini 2.5 Deep Think 的一个高级版本;发布页说现在接入了 Gemini 4 Argon、能力高于论文里那版,但新配置没有任何公开评测。12
- Antigravity 里那个「Teamwork 深度文档评审」模式只有文档,没有评测数据。13
下一个能核的节点
要判断它到底能不能用,需要的是一个带分母的精确率,或者一批稿件的试用前后对照。目前公开材料只提供了前者缺失时的间接读数,以及后者缺失时的作者自述。
在那之前可以确认的是位置:这套系统已经跑过 16,000 余篇真实稿件,而它的查错能力只在 29 个已知错误上量过。
References
- 1Analyzing technical documents with Deep Review
research.google
- 2
- 3
- 4
- 5The NeurIPS 2021 Consistency Experiment
blog.neurips.cc
- 6A missing theorem on dual spaces
arxiv.org
- 7
- 8
- 9
- 10
- 11
- 12
- 13Teamwork Deep Document Review Pattern
antigravity.google
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.