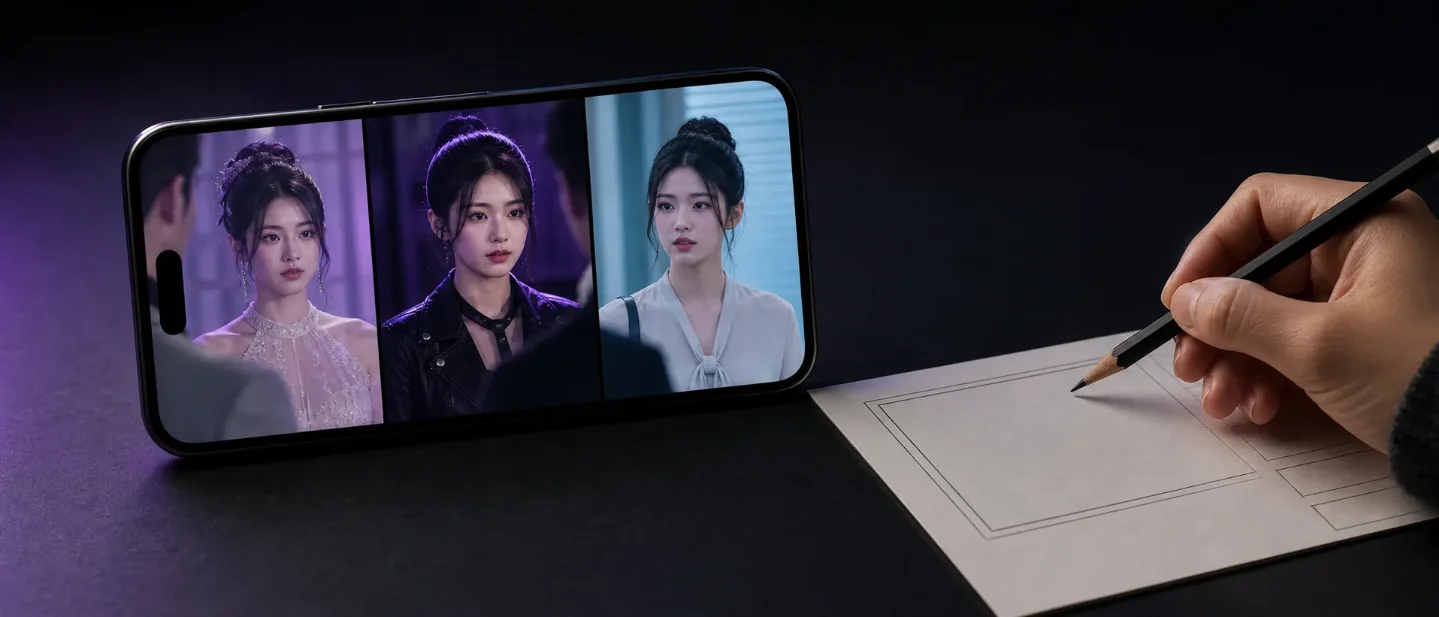
知乎第12名:AI短剧上半年冲到22万部,为何破亿率只有0.47%
核对AI短剧上半年供给、播放和制作成本数据,解释为什么产量暴增没有同步带来爆款,并梳理知乎公开回答与后续观察变量。

截至 8 月 4 日 12 点,本轮知乎热榜接口实际返回 30 条。第 12 名是「上半年 AI 短剧全网上线超二十万部,但播放破亿作品仅有千部,爆款率为啥这么低?大家都不爱看吗?」热度 156 万,页面显示回答数 111。1
这条热搜把两个问题叠在了一起:AI 是否已经把短剧做成了低成本流水线,以及当货架每天都被新内容塞满时,什么还能让观众停下来。现有数据更接近一个不太好听的答案:人没有消失,注意力先被稀释了。
22 万部,先拆成三个不同口径
DataEye《2026 上半年 AI 剧漫剧数据报告》给出的口径是:上半年全网新上线 AI 短剧超过 22.19 万部,其中播放量破亿的作品 1055 部,破亿率 0.47%;破千万作品超过 1.2 万部,破千万率约 5.8%。这里的「爆款率」不是观众喜欢程度的民调,而是报告对进入投流大盘、且 ROI 大于 1 的作品所做的行业口径。2
| 指标 | 数字 | 它能说明什么 |
|---|---|---|
| 上半年新上线 AI 短剧 | 超 22.19 万部 | 供给端已经高度拥挤 |
| 播放量破亿 | 1055 部 | 大多数作品没有进入头部注意力区间 |
| 破亿率 | 0.47% | 用严格的爆款口径看,成功是小概率事件 |
| 破千万率 | 约 5.8% | 有曝光不等于进入稳定的头部循环 |
另一个数据源给出了供给增长的时间尺度。人民网 5 月 2 日转述中国网络视听协会数据称,2026 年第一季度全行业上线微短剧约 12.8 万部,其中 AI 微短剧约 12.2 万部,占比超过 95%。这个数字描述的是季度上新结构,不等于 12.2 万部都获得了相同播放量,更不等于每部都是完整、独立、同等体量的商业项目。3
规模也没有停留在片库里。一财全球在 X 上转述《中国证券报》援引 DataEye 的说法:今年前五个月,中国 AI 生成短剧市场规模超过 220 亿元,上半年国内相关观众超过 6 亿。这个帖子是媒体对行业分析的二次转述,不是独立审计;它能说明市场已经形成,但不能证明 6 亿人都在持续观看同一类内容。4
所以,「上线很多、爆款很少」并不矛盾。生产端的计数单位是新剧目,观看端的竞争单位是有效播放、完播、付费和复看。前者可以靠自动化快速增加,后者仍然要争夺有限的时间。
AI 把哪一段成本压下来了
北京日报转载的中新经纬报道,把「AI 脸」的来源讲得很具体。制作者如果不给模型提供参考图,只输入「一个美女在咖啡厅喝咖啡」之类的提示词,模型往往会回到训练数据里最常见的大眼、高鼻梁、白皮肤模板。制作团队再用固定种子、统一表情和批量渲染保持角色前后一致,结果就是不同剧集里的主角越来越像。5
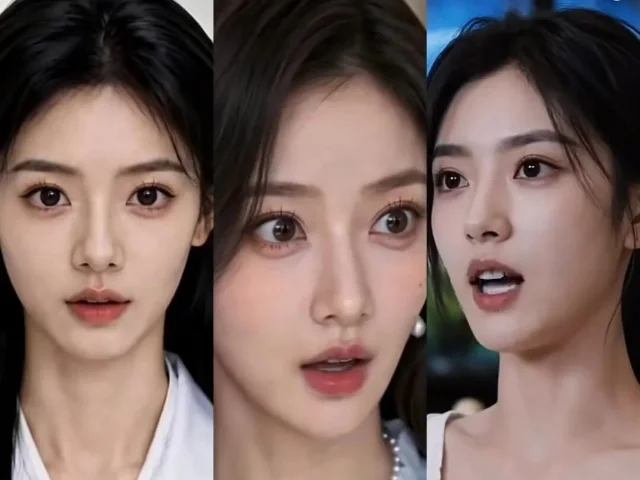
真正有辨识度的角色并不是按一下按钮就能得到。报道引述制作方介绍,差异化角色需要先做正面、侧面、全身等多角度资产,再反复检查发型、五官和动作的一致性;单张资产图合理的制作时间约为 5 到 10 分钟。视频生成本身也有成本,15 秒片段使用付费模型可能消耗十几元,VIP 通道还会更高。7
这解释了一个看似反常的选择:制作方不是不知道模板脸会引起审美疲劳,而是知道开发一套独特角色、保持长剧情中的身份稳定,会把最便宜的生产方式变成另一种项目。批量生产先解决「有没有」,差异化制作才开始解决「像不像」和「记不记得住」。
供给先爆,分发没有跟上
DataEye 旗下公众号「DataEye 短剧观察」发布的 7 月 25 日日榜,称当天 AI 剧/漫剧播放持续遇冷,没有出现日播破亿作品;当日漫剧榜首《狮城山野》日播约 9177 万,另一部新漫剧进入榜单前 17、日播超过 4000 万。同期真人短剧仍有日播 5883 万和 8693 万的作品。单日榜不能代表整个市场,但它提供了一个直观对照:AI 内容的上新量很大,头部播放并没有按同样速度抬高。8
海外也出现了相似的供给扩张。投资人 Deedy 在 X 上写道,美国娱乐类应用前 50 名里有 12 个属于 30 至 60 秒短剧应用,并称全球月活超过 2.5 亿。这个数字来自个人帖子,缺少统一统计口径,适合当作市场观察,不适合替代平台财报。9
一条 YouTube 行业解说把中国短剧的变化概括为 AI 正在进入制作流程。它适合帮助读者理解「工具怎样进入编剧、分镜和成片环节」,但视频描述没有提供可独立复算的爆款率,因此本文的数字不以它为依据。
Loading content card…
分发端的另一个信号,是纯 AI 内容开始进入更传统的播出场景。环球时报在 X 上称,一部完全由 AI 制作的短剧在中国省级卫视播出,引发关注与争议;原帖同时把信息归因于《中国青年报》等国内媒体。它证明的是播出场景正在扩张,不是这部剧已经获得长期收视,也不是 AI 短剧的普遍质量已经达标。10
知乎回答:公开可见受限版
热榜页面显示这个问题有 111 个回答,但本轮公开答案接口只返回 5 条记录,赞同数均显示为 0,返回顺序是更新时间,不是可核验的实时点赞排序。因此下面不能叫「按点赞数最高的前三条」,只能整理公开可见结果里信息量较高的三条。作者职业背景也没有从本轮字段得到确认。
- 笨蛋师傅的回答把问题归结为低质量供给过多:他提到同一小说被改出多个版本,批评模板化剧情、平台分发和脸部融合引发的版权争议,同时认为真正质量较好的作品很少,常常依靠算法推荐碰概率。这里关于具体平台行为和个案的说法属于回答者经验,不能当作已核实的行业事实。11
- 夏望繁星的回答认为爆款仍然需要投入:要么花钱买特效和演员,要么花时间磨剧本;如果 AI 只是把单部制作成本压到很低,却没有补上剧本和审美,低成本不会自动变成爆款。这个判断与行业数据相符的部分在于「成功率低」,但回答没有提供独立样本。12
- 临溪的回答更乐观,认为 AI 影像质量会继续提高,也可能改变演员和娱乐行业的生产方式。它表达了对技术趋势的支持,却没有给出播放、成本或版权证据;因此更适合作为讨论区的态度样本,而不是预测结论。13
这三条回答其实对应三种不同判断:质量问题、成本问题、行业替代问题。它们没有解决「为什么 0.47%」的统计问题,却提醒读者不要把「AI 能生成」误读成「观众愿意看完」。
接下来会怎么变
第一,竞争指标会从上新量转向有效播放和投流回报。 22 万部新内容已经说明生成不是主要瓶颈。平台更有动力把推荐、分账和投流资源给到能稳定留住观众的作品;DataEye 的日榜里,单日没有 AI 剧/漫剧破亿,正是这个筛选过程的一个切片。8
第二,AI 会更多变成制作工具,而不是作品标签。 编剧、导演、剪辑和配音仍然要决定人物动机、节奏和镜头取舍;AI 降低的是素材和试错成本,不会替团队决定哪一个冲突值得拍。未来看榜单时,单独标注「AI 制作」的传播价值可能下降,能否稳定产出有辨识度的角色和系列故事会更重要。这个判断是基于制作成本与模板脸问题的推断,不是已公布的行业政策。5
第三,脸和声音会变成更明确的版权资产。 知乎问题本身就以演员是否出售肖像权为切口;X 上也出现了制作方购买真人脸、平台允许设定授权范围的讨论,但相关帖子没有给出合同样本或司法文书。可以确认的是,角色越接近真人,授权对象、使用场景、期限和撤回机制就越不能被一句「AI 生成」带过;至于市场上具体的授权价格和案件数量,本期没有足够的一手材料确认。114
今日判断
AI 短剧不是没人看,而是生产效率已经跑在注意力效率前面。22 万部上新把单部作品的稀缺性打薄了,模板脸和重复叙事又让观众更快识别出流水线痕迹;真正稀缺的,重新变成了好故事、能记住的人物、稳定的长线制作,以及清楚的肖像和声音授权。
判断这个行业有没有走出「量大、爆款少」的阶段,不要只看下一次上新数量。更有效的观察顺序是:同一角色能否跨集保持一致、作品能否在没有大额投流时留住观众、主创是否愿意为剧本和资产持续投入,以及平台是否把授权和标识写进可执行的生产流程。
References
- 1知乎热榜问题
zhihu.com
- 2新浪新闻:AI 短剧狂潮下的「内卷」真相
news.sina.com.cn
- 3人民网:一季度上线微短剧约 12.8 万部,AI 微短剧占比超 95%
ent.people.com.cn
- 4
- 5北京日报/中新经纬:AI 短剧,为何共用一张脸?
xinwen.bjd.com.cn
- 6北京日报/中新经纬:AI 短剧,为何共用一张脸?
xinwen.bjd.com.cn
- 7北京日报/中新经纬:AI 短剧,为何共用一张脸?
xinwen.bjd.com.cn
- 8DataEye 短剧观察:7 月 25 日短剧 AI 剧日榜
mp.weixin.qq.com
- 9Deedy X:短剧应用进入美国娱乐榜
x.com
- 10
- 11知乎回答:笨蛋师傅
zhihu.com
- 12知乎回答:夏望繁星
zhihu.com
- 13知乎回答:临溪
zhihu.com
- 14X 上关于 AI 短剧购买真人脸的讨论
x.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.