E255|模型越来越强,为什么用户没感觉?再访阿里国际站总裁张阔:完整逐字稿和精华摘要
基于《硅谷101》E255 的完整音频,整理阿里国际站总裁张阔对「通用榜单接近满分、真实经营只到 61%」这一落差的完整对谈:107 个真实电商任务的基准是怎么来的、最贵的模型为什么不一定最好、以及哪些判断必须留给人,附按说话人分段的完整逐字稿。

《硅谷 101》第 255 期在 2026 年 10 月 9 日上线,主播是 Yiwen,嘉宾是阿里巴巴国际站总裁张阔。1 完整音频长 46 分 13 秒,原始入口是官方 RSS,视频版发布在硅谷 101 播客的 YouTube 频道。张阔 2011 年加入阿里巴巴,2017 年起负责阿里国际站,现在同时是阿里巴巴集团副总裁。2
本期没有商业赞助,也没有广告口播。00:00:00 到 00:01:18 是主播的引入,正片从 00:01:18 开始。
半年前的第 231 期,张阔带着刚发布的 Accio Work 来过一次。这一期他再来,要回答的是开头那句自问:很多模型的通用评测成绩已经接近满分,为什么商家在真实经营里没有感受到同样幅度的提升。
编程的渗透率已经到 99%,下一个赛道差得远
张阔给了一个自己的估计:Agent 最先解决的是写代码,这个场景的渗透率「我估计 99%」,理由是「很难看到身边有一个研发人员不用任何 AI 去写代码」,而且现在绝大多数代码应该都是 AI 产生的(约 01:51—02:03)。跟这个数字相比,第二个垂直赛道的渗透率远远小于它(约 02:03)。
他给了两组原因。编程容易,一是这项工作百分之百数字化,代码都在 GitHub 和各种代码库里,模型能广泛地学到;二是它的结果天生可验证——能不能编译过、跑出来的结果对不对,判断标准明确(约 03:06—03:24)。
换到商业场景,难度来自四个地方(约 03:24—03:46):数据更杂乱多元;本身没有一个通用流程可言;不同企业对「经营结果好还是坏」有自己的判断标准;验证不是以单次计算的,而是以天、周、月甚至年计算的,反馈闭环周期很长。
主播顺着这条线追问:上半年那些通用的办公类 Agent 出来之后,有没有试着解决这些问题。张阔的观察是赛道更热闹了——「你进到任何一个电梯间里面,现在可能看到的最多的产品就是各类的通用办公类产品」(约 04:04—04:13);而 Accio Work 的选择是守住电商这个垂直人群(约 04:17)。
从 AI 搜索到 Accio Work:一个 Agent 管多盘生意
张阔把产品的演进讲了三个阶段(约 04:42—05:57)。
第一个阶段是一年多前的 AI 搜索,相当于 Alibaba.com 的 AI Mode:买家可以用自然语言、也可以用多模态的方式描述需求。他给了一组对比数字——整体搜索涨 20%,多模态搜索涨 130%(约 04:50)。
第二个阶段是采购(Sourcing)本身向两头延展:往前是市场调研和产品 Design Pack 的设计,往后是把设计交给供应商、推进沟通、直到完成交易,他们管这一段叫 Agentic Trade,AI 驱动的交易(约 05:04—05:22)。
第三个阶段是 2026 年 4 月推出的 Accio Work,目标是让解决的问题更泛化。张阔解释这个产品的底座:它本身就长在 Alibaba.com 和 1688 上,而这两个平台背后是全球最大的供应链(约 05:45)。他举了用户画像:很大一类用户是电商商家,在阿里进货,然后到淘宝、天猫、京东、抖音上卖;在 Alibaba.com 上进货的,就到 Amazon、Shopify、eBay 这些全球平台上去卖。Accio Work 要做的是用一个一站式入口,让商家理解自己在多个平台的经营情况、管理供应链,也管理员工在日常经营里的表现(约 05:40—06:07)。
一个植物监测产品的例子
主播请张阔举一个具体例子。他在洛杉矶 CoCreate 大会上讲的商家 Edward 是这样的(约 06:25—07:46):Edward 喜欢种植物但常把花养死,于是想做一个产品,让植物自己告诉人它现在是什么状态。从有想法到把产品做出来,中间有设计包、检测设备、读取设备、成本控制、物流、海关编码、多平台上架这些环节,Accio Work 要做的是一路接过去。
主播接着问,哪些步骤仍然需要人做选择。张阔先描述了没有 Agent 时的人工流程(约 08:21—08:50):从一个关键词开始,人要知道什么样的工厂有资质做这个产品,然后维护一个 20 列的 Excel,在十几个供应商之间比较生产制造能力、当地资质、工厂水平、拿货价格、账期和物流方案,最后选出两三家,再与供应商来回沟通,「周期一般是以月计」,最后拿到一个样品。
有了 Agent 之后,他把这个周期压到「以天计」(约 08:50—09:21):Agent 先把想法拆成一个能制造出来的产品,判断这个产品需要什么能力;再从平台上的商家详情和商家自己上传的企业知识库里匹配最合适的商家;在商家允许的情况下替他去和若干商家沟通、推进,最后把报表拿回来。前面对应一个月 Excel 的工作,现在 24 小时之内能拿到结果。
这个例子里有个细节被主播注意到:产品比较复杂,所以它其实也在帮一批商家接触到他们原本不熟悉的产品。张阔补了一句供应商的原话——「没有见过这么专业的 Design Pack」,一般买家都是拿一张纸画一画就开始交流(约 09:45—09:48)。
107 个任务,和 61% 这个数
这是全场最实的一段。张阔说,为了衡量一个 Agent 到底好不好,他们自己做了一套基准(约 20:45)。动机是模型发布越来越密——「我在硅谷待一个礼拜,光个人助理就发了好几个」(约 20:51);而每次新模型发布,各家都会说自己在各个角度都更好,「非常多的榜单都已经打到 99 分了,就满分 100,就是 99 小数点之后去进步」,但他们日常使用又没有感觉到这么好(约 21:02—21:08)。
由此他给了一个判断:模型在 Coding、数学或者通用的 Agentic 能力上得分高,和它在电商领域里能完成多少工作,相关性没有那么大(约 21:12)。通用智能水平变好确实能提高通过率,但「大家没有在每一个模型发布的时候把本质的水位拉得那么大」(约 21:27—21:39)。
于是团队基于 Alibaba.com 上百万的真实经营数据、以及 Accio 里的真实问答数据,总结出 107 个任务,开源了出去,希望各家模型训练时都围绕这套开源的 Bench 做评测(约 21:39—21:54)。他说这么做也有私心:各家评测口径不一样的时候,为了把电商类工作流做好,他们还要做大量适配;现在 107 个任务加 Accio 作为统一框架,各家模型的表现就能放在一起比了(约 22:13—22:18)。
接下来是这个数:「事实上可能现在最 Frontier 的模型在我们这个 Bench 下面能够通过率就是 61% 多一点点,它想要达到及格水平现在都有点费劲。」(约 22:22—22:25)他补充说,61% 不代表这套工具不能用——这是所有人都不干预的情况下,而不是说每一项工作都完不成,因为每个任务的难度不一样(约 22:25—22:30)。团队把任务分成 L1 到 L4,越长程的任务、结果越开放,能通过的模型就越少(约 22:36—22:43)。
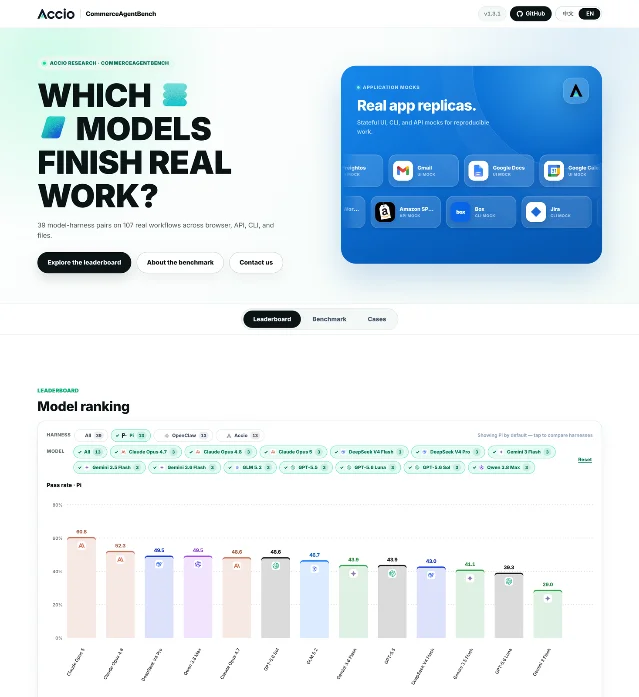
这张截图 2026 年 10 月 9 日取自基准的公开榜单页,页面顶部写着这套评测的规模:39 组「模型 × 框架」,跑 107 个横跨浏览器、API、命令行和文件操作的真实工作流。榜单把同一批模型放在三套框架上分别跑,页面默认列出 Pi 这一组,最高 60.8%;切换标签可以看到 Accio 这一组最高 66/107(61.7%),OpenClaw 这一组最高只有 51/107(47.7%)——同一个模型换个框架,分数就不一样。
107 个任务长什么样,他举了三个例子(约 24:49—26:32)。第一个是采购比价:买家向多个商家发出询价,要从大量回复里选出最合适的那个供应商,判断内容涵盖产品、生产工艺、制造、价格,还要算清到手价和物流方案;回复里还掺着几个钓鱼邮件,要把有诈的信息和有价值的信息分开,最后从工厂价格一路算到含税的到手价,「中间任何一个环节 fail 掉了,或者你算的结果是不对的,那这个任务就没完成」(约 25:36)。第二个是订船:给定交期和起止点,Agent 要在船公司的网站上真的把这条船订下来,订成功算完成,否则算失败。第三个是纠纷判定:平台上有大量 dispute,Agent 要判断买家对卖家的投诉信息是否完整、结论是赔还是不赔、以及现在需不需要更多信息才能判。
他说这类任务有一百多个,覆盖七大类(约 26:32)。107 这个数字是「此时此刻 snapshot 的数据」,下个月再问可能就更多了,因为团队会持续把更复杂的问题加进 bench,保证评测结果和真实经营结果一致(约 26:38—26:54)。他还提了一个容易被忽略的问题:模型或 Agent 迭代一段时间之后要避免腐化——原来能过的 case 后来不行了、结果更差了,这是不能接受的,所以要不停地评估,每个版本迭代时把产品再往前推(约 26:54—27:04)。
顺带,他给「商业上的 AGI」下了个可操作的定义:给定同样的预算和同样的供应链,用 Agent 经营一定比一个人去做日常操作和判断能赚到更多的钱(约 27:04—27:11)。
最贵的模型不一定是最好的选择
主播注意到了成本这一维:节目里给出的估算成本,Accio 是 3.69 美元,Codex 和 Claude Code 都在 9 美元以上,也就是另外两家的大约三分之一(约 33:56—34:07)。
张阔解释了成本怎么降下来(约 34:20—34:55)。一是路由:他们用帕累托最优的方式把不同工作分配到不同模型上,低难度的活交给小尺寸或高性价比的模型,对多模态、视频要求高的任务再路由到特定模型;批量采购模型调用本身就比个人去用便宜。二是框架和上下文:同一个模型,在他们自己的工程实践和上下文管理下,效率会比通用框架更高。
他给了个用户侧的建议:直接选 Auto 模型。Auto 就是平台替他去做帕累托最优的分配,判断每件工作该用哪个模型(约 35:11—35:17)。他也点出了对比对象的局限——Codex 和 Claude Code 本身是 Agent 与自家模型绑定,很多类似路由的工作做不了(约 35:26)。他把这跟美国市场上 Open Router、Fireworks 一类模型托管生意的流行放在一起看:越来越多模型正在变成商品(commodity),每隔一段时间就有更好的开源模型出现,这里长期有优化空间(约 35:41—35:53)。
主播问他们支持哪些底层模型,张阔的回答是「基本上你能看得到的都支持」,并补了一句:「有一些帕累托最优曲线已经完全埋在下面了,那就没有必要支持了」(约 35:53—36:01)。谈到刚发布的 GPT-6 Astra,他没有给结论,只说「你再过两天可以直接去我们 Bench 上去看 Astra 的评分」,并且要给新模型测两次再看效果(约 36:21—36:26)。他解释为什么一定要有 benchmark:没有基准就没法量化一个模型说「我这件事解决得很好」到底意味着什么,一个模型可能在 3D 或 Computer Use 上有突破,但这不代表它在通用商业里的 Agentic 能力强(约 36:31—36:56)。
Agent = 模型 × Harness × 上下文
讲到中美产品的差别,张阔给了一个自己的公式:Agent 等于 Model 乘以 Harness 乘以 Context(约 15:58)。乘法的意思是「哪一项是 0,整个公式结果就是 0」——模型要做优化,工程框架要做优化,上下文也要做优化(约 16:05)。他说自己不完全确定业界是否统一这么讲,但这是他总结出来的(约 15:59)。
落到中美差别上:工程框架和上下文两头都会有差异,因为美国要接的工具和平台跟中国不一样;上下文则跟商家自己的经营上下文、平台集成情况有关(约 16:11—16:27)。他把上下文的边界讲得很宽——你跟供应商之间的交流是上下文,商业数据是上下文,平台长期积累的垂直行业属性和趋势也是上下文;把这些数据按不同区域、不同用户的需求整理到一起,才能让 Agent 达到想要的效果(约 16:35—16:43)。
他也解释了为什么不能只等模型升级(约 19:07—19:48):模型和框架要放在一起优化,不是优化一个、另一个直接用一个通用的前沿模型就完事;现在也不是拿个通用模型简单做做微调,而是要基于一定尺寸的模型做后训练;模型、推理服务(Serving)和框架三头都要精细打磨,才能在最低成本下拿到同样的结果、把准确率提到新水准。他的结论是,竞争已经变成一个多元、全方位的竞争,「这也是让不同的垂直领域里面的这些 Agent 能够真正跑出来的原因」(约 19:59)。
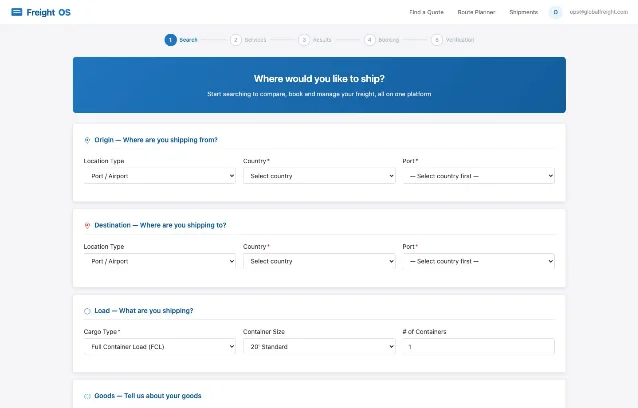
截图来自基准的官方开源仓库,是评测里用到的可复现本地副本之一,对应节目里说的「订船」任务:从起运地、目的地、货量到货物信息分五步填写,Agent 必须在这样一套有状态的界面上把流程走完、拿到预订结果,才算任务通过。这也是它和「问答式」评测最直观的区别。
哪些判断必须留给人
主播问了两个角度:哪些环节商家更愿意自己操作,以及人机分工该按什么来切。张阔的回答很直接——按环节切没有意义,「我们都会把一些一定需要人去决策的事情留给人」(约 27:50)。他给的第一个例子是支付:
比如你要去支付、去采购这批货这个按钮,一定是交给人去判断的。因为你要对于你整个的经营结果负责。(约 27:57—28:03)
他更愿意按频次来看这件事,因为他自己 2011 到 2016 年在淘宝和天猫做过商家平台,现在做 Accio Work,等于换个视角重新看商家的日常经营(约 28:24—28:47)。他列了几类现在最容易交给 AI 的活:多平台经营的账——「只有大量的流水进来,但是不代表你最后的经营是有利润」,跨平台把投入、收益、退换货拉成一张实时报表(约 29:07—29:38);多平台发品与改品,每个平台规则和受众都不同,稍微有点规模的商家乘起来就是很大的工作量(约 29:46—30:34);客服与经营复盘——谁答得对、谁答得错,2B 生意里哪些客户可能出问题、这张单子接下来最该做的判断是什么(约 30:42—31:13)。
而留给人做的判断,他举了一串(约 32:51—33:43):你把一个想法变成产品卖给谁,这个人群够不够大、愿不愿意付溢价,这是产品的品味;此时此刻你对这个市场的预测,是经营者自己的直觉;同样一笔预算,你是多投广告还是多备库存、要不要铺更多渠道但接受更薄的毛利,这是对一盘生意当下的判断。他的总结是「最终商业判断还是人去做」。
主播又追了一个更尖锐的场景:商家同时用多个 Agent,不同 Agent 给的经营建议互相冲突怎么办。张阔的回答是这很正常,核心是老板自己要有一个整体的经营目标,再拿这个目标去筛建议(约 38:46—38:56)。他给的理由是商业经营本身就是长周期的事,「这次交易就算成功了,它可能最终导致你商业失败,那它也不是一个好的交易」(约 39:00—39:10)。而且他明确说,「统一所有 Agent 的意见再给用户一个反馈」不是这个产品设计的初衷(约 39:47)。
上云、定时任务、事件响应与长程经营,是四件事
主播提到最近不少 Agent 产品开始离开用户的本地电脑、搬到云端工作,问「持续在线、持续响应」到底意味着什么。张阔先把上云和长程拆开(约 40:43—41:56)。
上云在他看来是个简单的事,也是基础需求:Accio Work 的 PC 版之后几天就有云端版,用户的本地记忆可以放到云端,换台机器也能接着操作;「今天你说你没上云,那就是你功能还没做完,这不是说大家技术上有个很大差别」(约 41:50)。
长程则是另一个概念,关键是要定义清楚在什么场景下、完成什么目标。他把商业场景里的长程拆成三类范式(约 41:00—41:31):第一类是定时任务,比如每天的店铺经营报告、每天看员工干得好不好;第二类是事件驱动,比如你去跟多个供应商沟通,AI 要基于更新的信息把沟通往前推;第三类是以季度为单位才有结果的任务,比如一整盘生意的复盘。他用一句很冲的话给「不挂」去魅:追求模型跑 7×24 小时、跑一个礼拜不挂,如果没有解决你的问题,「不挂 means nothing」(约 42:46—42:49)。
CoCreate 现场,和两个冠军商家
节目最后聊到洛杉矶的 CoCreate 大会。张阔说现场最让他惊讶的是来的人太多了,注册到场的规模超出了他的预期(约 43:19)。他提到大会上的 CoCreate Pitch 创业赛:它的形式有点像《创智赢家》(Shark Tank)一类的节目,去年英国和美国的两个冠军都是靠 Accio Work 把生意做起来的(约 43:41—43:44)。
英国冠军是 15 岁、还在上初中的 Harrison Nott,他用 Accio Work 找供应商、开发自己的产品,做的是能自动降温的毛巾一类给宠物降温的东西(约 43:48—44:06)。这位 15 岁的少年后来以 CoolTowel 拿下了 CoCreate Pitch UK 的 20 万美元大奖。3
美国冠军叫 Christian Reed,张阔说他一开始的穿着「非常工地化」,团队以为他是工人出身,后来才知道是 MIT 毕业;他做的产品是一台测量设备,从想法到找齐供应链都用 Accio Work 完成,现在的客户里有施耐德电气和 SpaceX,生意今年做到了几千万美元以上(约 44:19—44:45)。公开报道可以对上这位冠军的身份:CoCreate Pitch 2025 的美国大奖得主是 REEKON Tools 的 Christian Reed。4
张阔用这两个例子收到了本期的主旨:更多中小企业可以只靠 AI 和全球供应链的能力去做自己的生意,「你不需要一个非常大的公司,但你也可以把这个生意做得很大」(约 44:44)。他说中小企业的核心问题从来不是 AI 会不会取代工作,而是没有那么多的资源和经验,却又想把生意做大、想用上全球供应链(约 45:03—45:11)。
几处可以对上的数字
| 节目里的说法 | 公开口径 |
|---|---|
| 团队从真实业务里整理了 107 个任务,并把基准开源 | 对得上。Commerce Agent Bench(原 RealReplicaBench)由阿里国际的 Accio 团队开发维护,仓库里写明 107 个任务:53 个命令行、28 个浏览器、16 个文件、10 个 API/MCP 任务。5 |
| 数据来自 Alibaba.com 上百万的真实经营数据与 Accio 的真实问答 | 对得上。官方发布口径是数据底座来自 Accio 上 1000 万活跃中小企业用户、160 万条真实对话与 20 万条执行轨迹,最终提炼为 107 个端到端商业任务。6 |
| 最前沿模型在这套 Bench 上的通过率是 61% 多一点点 | 对得上。公开榜单上 Accio 框架一组,13 个模型里最好的是 Claude Opus 5,66/107(61.7%);另一组框架 OpenClaw 上同一批模型最好只有 51/107(47.7%)。7 |
| 同样跑完 107 个任务,Accio Work 的成本是 Codex 与 Claude Code 的三分之一 | 口径略有差别。Accio Work 官网的表述是「完成全部 107 项任务的成本比 OpenAI Codex 和 Anthropic 的 Claude Code 低超过 50%」。8 |
| 英国冠军是 15 岁、做自动降温产品的孩子 | 对得上。Harrison Nott 以 CoolTowel 拿下 CoCreate Pitch UK 的 20 万美元大奖。3 |
| 美国冠军 Christian Reed,客户里有施耐德电气和 SpaceX | 身份对得上。CoCreate Pitch 2025 的美国大奖得主是 REEKON Tools 的 Christian Reed;客户名单出自节目,本轮未找到可核对的公开出处。4 |
嘉宾的几个判断
编程渗透率 99%,商业还刚开始
- 编程是 Agent 落地的第一个场景,渗透率「我估计 99%」,绝大多数代码已经由 AI 产生;第二个垂直赛道的渗透率远远小于这个数字(约 01:51—02:03,张阔)。
- 编程之所以先跑通,是因为它百分之百数字化、结果天生可验证;商业场景数据更多元、没有通用流程、每家对结果好坏的判断不同,验证周期以天、周、月、年计(约 03:06—03:46,张阔)。
- 商业场景的 Agent「也是刚刚开始的一个状态」(约 02:44,张阔)。
榜单分数和真实经营,相关性没那么大
- 模型在 Coding、数学或通用 Agentic 能力上得分高,跟它在电商领域能完成多少工作,相关性没有那么大(约 21:12,张阔)。
- 新模型发布时各家都会说各个角度都更好,榜单已经打到 99 分,但日常用起来没有感觉到这么好(约 20:55—21:08,张阔)。
- 没有基准就没法量化「这件事解决得很好」;一个模型在 3D 或 Computer Use 上有突破,不代表它通用商业里的 Agentic 能力强(约 36:31—36:56,张阔)。
越长的任务,能通过的模型越少
- 最前沿模型在 Accio 的 Bench 下通过率 61% 多一点,「想要达到及格水平现在都有点费劲」;但 61% 指的是所有人不干预的情况,不代表工具不能用,因为任务难度分 L1 到 L4(约 22:22—22:36,张阔)。
- 任务要持续加、持续测:模型或 Agent 迭代一段时间后会腐化,原来能过的 case 后来不行,这是不能接受的,所以每个版本迭代都要重新评估(约 26:54—27:04,张阔)。
- 商业上的 AGI 可以定义:同样的预算和供应链下,用 Agent 经营一定比一个人做日常操作和判断赚得更多(约 27:04—27:11,张阔)。
最贵的模型不一定是最好选择
- 成本靠两件事降下来:按帕累托最优把工作路由到不同模型,以及在框架和上下文管理上比通用框架更高效(约 34:20—34:55,张阔)。
- 用户侧的简单建议是直接选 Auto,让平台替他做分配;Codex 和 Claude Code 这类 Agent 与自家模型绑定,很多类似路由的工作做不了(约 35:11—35:26,张阔)。
- 「必须是一个用得起的 AI 才是一个有价值的 AI」,因为这是日常经营天天要用的产品,不是解一道数学题那样用一次就完了(约 23:52—24:05,张阔)。
- 模型正在变成商品,每隔一段时间就有更好的开源模型出现,这里长期有优化空间(约 35:51,张阔)。
人管判断,AI 管重复
- 「我们都会把一些一定需要人去决策的事情留给人」;支付、采购这类按钮一定交给人,因为人要对自己的经营结果负责(约 27:50—28:03,张阔)。
- 留给人的是产品品味、市场预测,以及同样一笔预算在广告、库存、渠道与毛利之间的分配(约 33:22—33:43,张阔)。
- 多个 Agent 建议冲突很正常,老板要先有整体的经营目标再去筛;商业经营是长周期的事,一笔交易成交了也不代表它是好交易(约 38:46—39:10,张阔)。
- 「统一所有 Agent 的意见,然后给用户一个更好的反馈,这不是我们这个产品设计的初衷」(约 39:47,张阔)。
上云是基础需求,长程要定义清楚
- 上云是简单的事:「今天你说你没上云,那就是你功能还没做完」;难的是定义在什么场景下、完成什么目标的长期任务(约 41:50—41:56,张阔)。
- 商业里的长程分成三类:定时的日常经营报告、事件驱动的推进(比如与多个供应商沟通)、以季度为单位才有结果的复盘(约 41:00—41:31,张阔)。
- 追求模型跑 7×24 小时不挂没有意义:「不挂 means nothing,如果没有解决你的问题的话」(约 42:46—42:49,张阔)。
关键节点
下面的章节标题来自官方单集页。1
- 01:18|AI 同事市场:编程之外,专业工作走到了哪一步?
- 02:38|商业任务为什么比编程更难?
- 03:48|从采购搜索到日常经营,Accio Work 的任务边界如何扩展
- 06:12|商家案例:植物监测产品,从创意走到设计、供应链和销售
- 07:47|找工厂、比报价、拿样品:采购流程里,人和 AI 如何协作
- 10:13|中美 Agent 生态的差异:垂直 SaaS 与平台工具
- 11:30|AI 会替代 SaaS 吗?
- 14:11|独立站与平台电商:不同市场如何影响产品设计
- 15:16|Agent 公式:模型 × 工程框架 × 上下文
- 17:46|模型与工程联合优化,不能只等模型升级
- 20:29|107 个真实任务:无人干预条件下,最前沿模型通过率约 61%
- 24:32|报价、钓鱼邮件、订船和纠纷:怎样才算真正完成任务?
- 26:33|新版本也可能退步,评测必须持续做
- 28:55|多平台经营:有流水,不代表有利润
- 32:39|产品品味、市场判断与预算分配:老板仍要做的选择
- 33:44|多模型路由:如何为不同任务匹配能力与成本?
- 38:05|多个 Agent 建议冲突,商家该听谁的?
- 40:35|上云、定时任务、事件响应与长期经营,是不同的能力
- 43:05|CoCreate 现场:商家对 Agent 有哪些期待?
- 44:43|小企业如何借助 AI,把生意做得更大
术语
- Agent(智能体):能自己拆解任务、调用工具、把一件多步骤的活干完的程序,而不只是回答问题。张阔把它的能力拆成模型、框架、上下文三项相乘。
- Harness(工程框架):包在模型外面、让模型能真正干活的那一层工程——连接工具、管理记忆、处理用户授权、保证系统能持续运行。同一个模型配不同框架,跑出来的成绩可能差很多。
- Context(上下文):Agent 干活时能看到的全部背景信息。张阔把与供应商的对话、商业数据、平台积累的行业与趋势数据都算进去;上下文不同,同一个模型的结果也不同(约 16:11—16:43)。
- 后训练(Post-train):在通用大模型的基础上再用特定数据继续训练,让它更贴合某个场景。张阔提到他们用千问最新版本的小尺寸模型做后训练,效果已经接近前沿模型的第一梯队(约 23:19—23:23)。
- 帕累托最优(Pareto optimal):在多目标之间找不到「再改善一项而不损害另一项」的分配状态。节目里指同时看通过率与成本,把不同任务分配给不同模型,找到一个整体最优的组合(约 22:43—23:16)。
- L1—L4:团队给任务难度分的四档,L1 最浅、L4 越长程、结果越开放。越长程的任务,能通过的模型越少(约 22:36—22:43)。
- Sourcing(采购寻源):从找供应商、比价、拿样品到下单的整段流程。张阔说 Accio Work 已经向这段流程的两头延展,往前加市场调研与设计,往后接到成交。
- Agentic Trade:节目里用来指 AI 驱动的交易——Agent 替买家完成与供应商的沟通推进,直到交易落定(约 05:14—05:22)。
- 可验证(verifiable):结果能自动判定对错。编程任务天生可验证(能否编译、测试是否通过),这是它先跑通的原因之一;商业任务的结果往往要跨天、跨周才能判断(约 03:15—03:24)。
- 多模态搜索:买家不只用文字描述需求,还可以用图片等方式。张阔给出的对比是整体搜索涨 20%、多模态搜索涨 130%(约 04:50)。
- Design Pack(设计包):把一个想法整理成工厂能照着做的产品设计文件。张阔说供应商看到 Accio Work 生成的 Design Pack,反馈是「没有见过这么专业的」(约 09:45)。
- snapshot(快照):某一时刻的静态记录。张阔说 107 这个任务数是「此时此刻 snapshot 的数据」,下个月再问可能就更多了(约 26:38)。
- 路由(routing):把不同的任务分派给不同的模型。简单的活交给便宜的小模型,复杂的活交给贵的前沿模型,目的是在同样通过率下把成本压下来(约 22:20—23:16)。
- ontology(本体):企业里各种数据各自意味着什么、彼此是什么关系的整体描述。张阔用它说明 AI 进企业必须理解经营上下文,而这本身很难(约 12:27—12:37)。
几句原话
「事实上可能现在最 Frontier 的模型在我们这个 Bench 下面能够通过率就是 61% 多一点点,它想要达到及格水平现在都有点费劲。」
——张阔,谈自家基准上的成绩,约 22:22—22:25。
「它可能是做 3D 模型做的不错。也可能在一些 Computer Use 上有一些突破,但不代表它在通用商业里面的 Agentic 的能力强。」
——张阔,解释为什么一定要有商业场景的基准,约 36:54—37:03。
「所以你说它是 AGI,我现在给你打保票的肯定不是 AGI,就最终还是以最高性价比完成它的任务是第一优先级。」
——张阔,谈新模型发布时的判断标准,约 37:03—37:14。
「必须是一个用得起的 AI 才是一个有价值的 AI,因为它是一个日常经营适用的产品。」
——张阔,谈成本为什么重要,约 23:52。
「就是哪一项是 0,整个这个公式结果就是 0。」
——张阔,解释 Agent 等于模型乘以框架乘以上下文为什么是乘法,约 16:02—16:03。
「比如你要去支付、去采购这批货这个按钮,一定是交给人去判断的。因为你要对于你整个的经营结果负责。」
——张阔,谈哪些判断留给人,约 27:57—28:03。
「只有大量的流水进来,但是不代表你最后的经营是有利润。」
——张阔,谈多平台经营要看什么,约 29:10—29:23。
「不挂 means nothing,如果没有解决你的问题的话。」
——张阔,谈「上云」与「长程」不是一回事,约 42:49。
完整逐字稿(按说话人)
本稿依据官方单集页的完整音频转写,覆盖 00:00:00 到 00:46:18。为保留现场语感,口语、重复与中英混用都保留,只对明显的识别错误(人名、公司名、产品名、术语与同音错字)做了最小校正;说话人统一为「主播」(Yiwen,硅谷 101 主持人)与「张阔」(阿里巴巴国际站总裁)。时间点为该段话在音频中的起始位置。节目开头 00:00:00—00:01:18 是主播的引入,00:01:18 起进入对谈。有一处原音不清,保留原样并以〔转写异常〕标出。
主播|00:00:00 大家好,欢迎回到硅谷 101,我是 Yiwen。
主播|00:00:04 之前我们聊到了大模型的训练数据和榜单,提到每次新模型发布,各种榜单上的成绩都在刷新。
主播|00:00:12 但这种进步对于我们用户来说,很多时候并没有变成工作中的进步。
主播|00:00:17 以电商为例,从一个产品创意到把它做出来卖到全世界,中间要研究市场、找工厂、比较报价、安排物流,还要在不同平台上开店发布商品,最后算清楚这笔生意到底赚不赚钱。这些工作 AI 现在能接手多少,又会在哪一步卡住呢?
主播|00:00:43 半年前,我们请到了阿里国际站总裁张阔,聊了他们刚发布的 Accio Work。
主播|00:00:53 半年过去,Agent 产品不断更新,所以我们也再次请到他来聊聊这些变化究竟给商家的实际经营带来了多少帮助。
主播|00:01:04 张阔分享了一个观察﹚很多模型的通用评测成绩已经接近满分﹚但在真实经营中,他们并没有感受到同样幅度的提升﹚
主播|00:01:13 于是,团队从实际业务中整理了 107 个任务,测试 AI 在没有人干预的情况下,能不能把工作做完。
主播|00:01:16 下面就是我和张阔的对话。
主播|00:01:18 张阔你好。
张阔|00:01:19 你好。
主播|00:01:32 其实张阔 3 月份的时候就上过我们一次节目了,那个时候是你们春节之后刚发布 Accio Work 这个产品的时候,其实当时呢你就说 Claude Cowork 这个产品比当时特别火的 OpenClaw 更值得关注。
主播|00:01:38 现在过去了半年左右的时间,其实我们也看到市场相当于是印证了你的这样一个判断吧。
主播|00:01:48 那我觉得我们可以先聊一下 Cowork 的整体市场。
主播|00:01:52 你觉得你现在对于 Cowork AI 同事这样一个市场的整个判断是什么?
张阔|00:01:48 因为 Agent 最开始出来解决的第一个问题是 Coding。
张阔|00:01:51 我们现在认为 Coding 的市场渗透率,我估计 99%吧。
张阔|00:01:56 因为很难看得身边有一个研发人员不用任何 AI 去写代码。
张阔|00:02:00 然后现在绝大多数代码应该都是 AI 产生的。
张阔|00:02:03 如果跟这个相比,第二个垂直的赛道的渗透可能都远远小于这个数字。
张阔|00:02:09 因为 Cowork 本身偏 Work 类的产品吧,它可能完成的内容和能够给它交付的内容相对来讲还是比较有限。
张阔|00:02:18 还是一些文案类的工作,一些计算类的工作可能完成的更多吧。
张阔|00:02:22 但对于商业,尤其像电商这种要去更复杂的判断,可能更长程的任务,以及它最终的结果不是一个当下马上可以 Verifiable 的结果。
张阔|00:02:44 对于这类的场景来讲,我们觉得整个 Agent 也是刚刚开始的一个状态。
主播|00:02:46 OK,所以就是我们现在还是相当于把工程类的 Coding Agent 和非工程类的一些商务类的应用分成两块来看的。
主播|00:02:54 你觉得为什么 Coding 的任务交给 Agent 可能更加容易一点呢?相比你刚才说的比较少用的这些 Work 的场景。
张阔|00:03:06 我觉得一是本身关于 coding 的工作,它百分之百数字化的嘛,就所有的 code 在 Github 呀,或者在所有的 code base 里边,容易被 AI 更广泛的学习。
张阔|00:03:15 第二个呢,去做这个内容的 verifiable,就它是一个天然的可以 verify 的一个工作,这个到底能编译完成还是不能完成,出来的结果到底对还是不对。
张阔|00:03:24 这些事情天生比较适合现在大型模型去进行,但如果我们把它换到商业这个场景就太复杂了。
张阔|00:03:22 第一,数据可能更加多元。
张阔|00:03:25 第二个,它本身其实没有一个通用的流程可言。
张阔|00:03:29 你可能最终有一个结果,而且不同的企业对于经营的结果好跟坏的判断也有自己的差异性。
张阔|00:03:36 然后你要去做结果的验证,可能这个验证不是一个以单次去记的,可能是以一个天、一周、一月或一年去记的一个结果。
张阔|00:03:46 它整个反馈的闭环周期就是很长的。
主播|00:03:48 了解。那你觉得自从 Claude 相当于是上半年正式推出了 Cowork 这个产品之后,
主播|00:03:54 这些通用的 Cowork Agent 有没有尝试去解决你刚刚说的那些问题呢?
主播|00:03:59 这个中间有没有发生什么变化是你觉得比较值得去探讨的?
张阔|00:04:04 第一个就是这个赛道肯定更热闹了嘛。
张阔|00:04:06 中国你进到任何一个电梯间里面,你现在可能看到的最多的产品就是各类的通用办公类产品。
张阔|00:04:13 从产品的体验角度来讲吧,我觉得各家都会有一些自己的特色。
张阔|00:04:17 从 Accio Work 推出来讲,我们核心可能还是要解决电商这个垂直人群的问题。
张阔|00:04:23 就今天跟之前比,它能解决的问题肯定更繁华了。
张阔|00:04:42 如果说我们这个产品一年之前,当时核心解决的问题是一个 AI 搜索的问题。
张阔|00:04:41 相当于 Alibaba.com 的 AI Mode﹚买家可以更自然语言的方式去描述自己的需求﹚或者通过多模态的方式去表达自己的需求。
张阔|00:04:50 我们现在去看,整体搜索涨 20%,但是多模态搜索涨 130%,现在越来越多的用户去描述自己的需求跟之前有一个很大的差别。
张阔|00:05:04 第二个阶段就是 Sourcing 本身向前向后工作比以前延展的更多了,比如之前从搜索更多的是一个 query,现在向前延展的就是要做市场的调研,要做产品的 Design Pack 的设计。
张阔|00:05:14 有这个设计之后,他把这个设计交给供应商,可以跟供应商去推进整个的沟通的过程,包括最后完成交易,我们管的叫 Agentic Trade,一个 AI 驱动交易。
张阔|00:05:22 这些是我们看到一个 Agent 在 Sourcing 上面去表达的一个更完整的一路径,而且他能解决的问题跟之前比可能有一个非常大差别。
张阔|00:05:29 到新的阶段,就是今年 4 月份我们在推出 Accio Work,希望它解决的问题就可以更泛化。
张阔|00:05:45 跟电商相关的问题,我们刚才讲的 Sourcing 可能都是跟供应链相关的,因为 Accio Work 本身就基于 Alibaba.com,基于 1688,它就是全球最大的一个供应链的平台。
张阔|00:05:40 很大一类用户其实就是电商用户,他在阿里巴巴进货,可以在淘宝、天猫、京东、抖音上去卖。
张阔|00:05:46 然后在阿里巴巴.com 上去进货,那就是在全球的各个电商平台上,无论是 Amazon、Shopify、eBay 等等去销售。
张阔|00:05:53 现在 Accio Work 可以帮我们所有的用户去管理他所有的电商后台。
张阔|00:05:57 就通过一个一站式的服务去理解你整个多平台的经营情况,去管理你整个的供应链,去管理你整个企业、员工在整个日常经营里面的表现。
张阔|00:06:07 这个是现在我们看到这个 Agent 能够再进一步的泛化去解决的更多的问题。
主播|00:06:36 嗯,可不可以具体举一个例子,比如说一个跨境商家他一开始用 Accio Work 是想要解决什么样的问题,这整个流程是什么样的?
张阔|00:06:25 OK,我们这次在 CoCreate 的大会上正好讲了一个商家 Edward 的例子。
张阔|00:06:34 他原来自己喜欢种植物,但是经常把花养死,他就想创造一个产品,怎么让植物去告诉他现在他是什么状态。
张阔|00:06:40 但从有这个 idea 到把这个产品做出来,它是一个消费级的个人的电子消费产品。
张阔|00:06:46 怎么能把它这个产品做出来变成一个 Design Pack 这就可能难住很多的创业者。
张阔|00:06:54 最后这个电子产品到底用什么样的检测设备啊,到底用什么样的读取设备啊,怎么把这个成本压到最低卖的时候,
张阔|00:06:57 你可以有 Margin。Accio Work 首先帮你做 Design Pack 的设计。
张阔|00:07:10 第二,可以帮助你找到所有广州、深圳这些做电子产品最厉害的厂商帮助你制造出的一个产品。
张阔|00:07:04 然后可以帮助你去解决所有跨境领域的问题,就无论是你要订船期、你过海关的时候要什么 HS Code 去过,以及运到当地之后我们怎么去管理物流的过程。
张阔|00:07:15 然后有了之后你要产生各种各样的 social 的内容,像 Amazon 去 eBay 去 Shopify 到 TikTok 上去卖你这个产品。
张阔|00:07:44 这个过程中你要管理多个店铺,然后去管理所有的搜索内容,有的内容要符合不同的平台的不同的规则,然后可能还有不同的 pricing 的计划。
张阔|00:07:38 管理各个平台的买家给你的反馈、Feedback 等等在持续地迭代这个产品。
张阔|00:07:46 现在 Accio Work 就可以帮你把这个完整的周期在一个 Agent 里面去完成,去跨端的去管理你的整个一本生意。
主播|00:07:56 所以我理解这个过程当中,比如说你刚刚提到 sourcing,然后 sourcing 前后的这样一些步骤,我理解这个 agent 它可能会起到一些搜索和推荐的作用。
主播|00:08:07 这个中间有哪些步骤还是需要人去完成的呢?它应该还是需要商家做一些选择,知道哪个是更好的。这些东西是人和 agent 合作的这样一个步骤。
主播|00:08:11 我可以描述一下最开始如果没有 agent 的人是怎么做的?
张阔|00:08:21 就是你从 Query 一个关键词开始,你要把这个产品做出来,那你大概其实就要知道这个产品需要有什么样资质的工厂和商家能做出这个产品。
张阔|00:08:25 然后你可能要管理 Excel 这一个 Excel 可能有 20 列。
张阔|00:08:32 比如说十几个供应商之间你从它的生产制造的能力到它当地有没有制造这类产品的资质、
张阔|00:08:38 它工厂的水平、拿货的价格,包括它可以给你的账期的水平、物流的方案等等。
张阔|00:08:41 就是你最终选到两个三个你要合作的厂家。
张阔|00:08:51 这过程中省略的就是 Back and forth 跟供应商交互,周期一般是以月计,到最后你能拿到一个样品。
张阔|00:08:50 如果有 Agent,我们可以把你的周期缩短到以天计。
张阔|00:08:55 它可以帮助你把你的 Idea 首先分解成一个可以制造出来的产品,和这个产品究竟需要什么样的能力。
张阔|00:09:03 然后从 Alibaba.com 这个平台里边,包括用这些商家自己的详情里的内容,以及商家上传的自己企业知识库的内容,帮助你去匹配最合适的商家。
张阔|00:09:13 然后在你允许的情况下,它会去跟若干个商家去做沟通,去推进,拿到你最终想要的这个报表。
张阔|00:09:21 前面花一个月去维护的 Excel,现在这个 Project 可以用 AI 在 24 小时之内帮你达成一个结果。
主播|00:09:55 比如说在刚刚我们举的这个例子里面这个产品比较复杂嘛,所以它其实也有相当于是赋能这样一批商家去找到一些他们可能一开始不太熟悉的产品,这里面有更多的可能性。
张阔|00:09:45 对的,我们的供应商给我们的反馈说是没有见过这么专业的 Design Pack。
张阔|00:09:48 一般买家都是拿一张纸画一画,大致就开始去交流的。
张阔|00:09:52 依照把这个事情能把它搞清楚就要花很多精力。
张阔|00:09:55 还有很多时候就是当拿到的东西发现跟你原来想的又不太一样,
张阔|00:09:58 这是大量有 dispute 的 back and forth 的过程。
张阔|00:10:01 就是开始能把一个人的想法真的能说清楚。
张阔|00:10:04 到最终我们给你算出来一个到手价,
张阔|00:10:06 到你在零售之间的 margin 是多少,
张阔|00:10:15 能把这个信息更多的给用户去呈现出来,我觉得也能极大的去提高他们自己做生意成功的效率。
主播|00:10:13 OK,那我们刚才是简单地以 Accio Work 为例子,看了一下一个电商这个垂直领域的 Agent 这样一个用法。
主播|00:10:20 我想回到你一开始提到的通用 Cowork Agent 的这个点,你讲到国内有很多厂商在竞争这个赛道吗?
主播|00:10:28 我们最近听到比较多的就是像 WorkBuddy 这类的产品,在美国也有很多通用的 Agent。
主播|00:10:48 Meta 刚刚发了 Muse,之前 Grok Bot 也是大家评价说是一个非常好用的产品。
主播|00:10:50 能不能给我们讲一下这个市场的竞争,你觉得现在整体的格局是怎么样的,而且你现在也在美国嘛,你觉得这个中美之间有没有什么比较大的差异呢?
张阔|00:11:04 从办公的角度来讲,我觉得可能差异相对来讲小一些,当然它也有一些不同的场景,这是跟原来这两个地方本身企业的一个延续性有关,因为你比如在美国,SaaS 就是个挺大的生意。
张阔|00:11:14 然后这个 SaaS 的生意本来就是垂直化的,做 CRM 的有 SaaS,做广告类的,做律师类的,做医疗的,都有自己的垂直的成熟的 SaaS 体系。
张阔|00:11:25 这个生态在中国就不太一样,中国可能有很多平台,它有非常多垂直的整合进去的功能,所以它 AI 进来的时候,它本身也有一定的惯性的差异。
张阔|00:11:34 但是从最终要给用户去交付结果来讲,各个平台想做的事情都是一样的。
主播|00:11:30 对,其实这个市场的观察很有意思,因为你说到 SaaS 嘛,比如说我们先从美国这边来说,其实咱们上次聊的时候,相当于是美国 SaaS 恐慌情绪最严重的那样一段时间,就是有很多 sell-off,就包括说现在 AI 的能力,其实 Claude 推出 Cowork 之后呢,也有很多投资人担心说这又一次的杀死了很多 SaaS 公司。
主播|00:11:51 当时你提出的一个判断就是只要一些 SaaS 公司能把 AI 用得好,那反而 AI 可能是一个利好。
主播|00:11:58 那现在我们看到很多 SaaS 公司也没有我们想象的,那么在这个过程当中就没有办法继续生存下来。
主播|00:12:06 能不能再聊一下,比如说现在这几个月过去,你觉得 Agent 对于这些 SaaS 公司的影响,你看到他们采取了什么样的对策呢?
张阔|00:12:14 如果这个 SaaS 本身做的内容比较简单,有一些就是 AI 自动可以帮助它做的事情,可能你说它削弱了一些 SaaS 本身的能力吧,这个事也是存在的。
张阔|00:12:27 然后因为 SaaS 本身跟工作流集成的比较紧密,它对于整个企业的上下文的理解,尤其这个企业,我们觉得现在比较流行一个词是 ontology,
张阔|00:12:37 就是你就算请一个大学生来,你搞不清楚这个企业本身各个数据到底意味着什么,以这些企业最终经营的目标是什么,但其实就让一个人来去做这件事也很困难。
张阔|00:12:46 今天一方面就是 SaaS 自己也可以围绕这个角度去升级自己的产品,用更多的 AI 去推动。
张阔|00:12:53 反过来一个 AI 进到一个企业里边,它也一定要去理解到底这个企业各种数据意味着什么,这个老板到底是想基于什么东西去做优化。
张阔|00:13:03 你最后达成一个交易,不是这个交易最终只是成交了,它就能代表好还是坏。
张阔|00:13:08 这个交易到底是为了有更多的 margin 还是为了有更多的市场份额?
张阔|00:13:13 我可能 budget 的使用的方法都是不一样的,我需要库存的方法,我需要去做广告的方法,可能都是不一样。
张阔|00:13:19 这些事情其实没有办法你扔一个 AI 进到一个企业里面就能帮着完成。
张阔|00:13:44 同样的,原来的 SaaS 必须要人去推动去执行,但是它的好处是它了解很多企业的经营上下文。
张阔|00:13:48 如果你有更好的 AI 去帮助,它也可以去拿到更好的结果。
张阔|00:13:52 我觉得现在可能更多是两边一个都要互相集成的这么一个过程。
主播|00:13:46 对,其实在美国像你刚刚提到的一些垂直领域﹚法律﹚医疗﹚像 Harvey﹚Open Evidence 这样的产品其实现在做得都非常好。
主播|00:13:55 但我理解这些可能更多还是 AI Native 的 Agent 产品而不是就可能一个 SaaS 公司去转型加上 AI 来推动这样一个工作流。
主播|00:14:00 每一个时代都有这个时代的公司,一些人对于这个技术理解得更好。
张阔|00:14:11 同时对于经营的领域理解的更深,它可能速度就更快,就像移动互联网时代,有移动互联网时代的产品,到每一个有技术的转折的节点都会有一些新的公司冒出来。
主播|00:14:21 那你觉得在中国的市场,你刚刚说从平台的角度去推动,这个对于用户的需求,我们怎么理解这些产品的用户需求呢?
主播|00:14:31 你比如说美国跟中国的电商就有很大差别,如果是一个中国的企业在中国经营,它第一个想法一定不是做个独立站。
张阔|00:14:38 但是在美国你发现 Shopify 这个生意或者是独立站这个生意吧还是个挺大的生意而且还在持续经营增长
张阔|00:14:43 比如在美国 Amazon 它确实是个平台这个平台到你可能客户你自己都接触不到
张阔|00:14:50 你要把商品发到一个仓里边通过 FBA 的方式把它卖出去这很适合当地的这些目前企业经营的一个状况
张阔|00:15:01 但是如果你想要有自己的独立品牌,想要自己的独立客户,要跟所有的客户去建立关系,那可能 Shopify 就是个选择。
张阔|00:14:57 但在国内,假设淘宝和天猫,它就是基于两者之间的一个状态。
张阔|00:15:02 它既是一个平台,也可以在这里面更低成本的获客。
张阔|00:15:05 同时在这个平台里面也集成了大量的电商类的工具。
张阔|00:15:09 其实最终它给客户交付的这些价值项是一样的,只不过它表达的形态在不同的地方是不一样的,仅此而已。
主播|00:15:32 那基于这个区别,你们 Accio 有发布国内和海外不同的版本吗?
张阔|00:15:34 AI 这个产品很有意思。
张阔|00:15:27 就是它的第一天就是 Global 天生的没有语言问题。
张阔|00:15:32 就是你在各个地方可能你要解决的不同的用户的交互的问题是大同小异的。
张阔|00:15:38 第二呢,从客户交互的角度来讲,它交互的门槛肯定比之前大部分降低了。
张阔|00:15:43 就是虽然它里边有一部分 GUI 的属性,但是大部分用户在交互的时候是 LUI 的方式。
张阔|00:15:54 我把我这个工作描述清楚了,我就可以把这个工作交付给你。
张阔|00:15:58 但是它需要做的差别是什么呢?我们说 Agent 有一个公式,就是 Agent 等于
张阔|00:15:53 Model 乘以 Harness 乘以 Context
张阔|00:15:57 不知道业界是不统一这么说
张阔|00:15:59 但我自己总结可能是这个样子
主播|00:16:01 为什么是乘法
张阔|00:16:02 就是哪一项是 0
张阔|00:16:03 整个这个公式结果就是 0
张阔|00:16:05 就是你既要在 Model 上做优化,同时也要在 Harness 上做优化,也需要在 Context 上做优化。
张阔|00:16:11 美国跟中国肯定在 Harness 和 Context 上会有差别,因为你需要美国接的工具,接的平台跟中国的工具跟平台是有差别的。
张阔|00:16:19 然后 Context 呢,就是跟你自己日常的经营的上下文有关系,跟你平台集成的情况有关系,你比如如果在 alibaba.com 或 1688 里边,
张阔|00:16:27 你跟供应商之间的交流也是你的 Context 一部分,就是 Conversation 也是 Context 一部分,你这个商业的数据也是 Context 一部分。
张阔|00:16:35 平台长时间积累这些数据,我们去看到的一些垂直的行业的属性、趋势等等可能也是 Context 一部分。
张阔|00:16:43 我们就要把这些所有的数据基于不同的区域、不同的用户的需求整理在一起,才能更好地去达到 Agent 想要的效果和水平。
张阔|00:17:01 所以我们开始做,其实最早做的是海外用户。
张阔|00:16:59 现在用的可能更多的是中国的用户。
张阔|00:17:02 从供给侧,从 Enterprise 版本来讲中国的企业很多。
张阔|00:17:08 从个人用户或者买家或者一个电商的经营的视角来讲,可能国外的用户用的最多。
张阔|00:17:10 这跟以前还是有挺大差别的。
张阔|00:17:15 以前国内有 1688,跨境的有阿里巴巴.com,我们做了 20 几年,这还是两个平台。
张阔|00:17:26 但是 Accio 从第一天起它就可以作为一个全球的平台产品。
主播|00:17:19 这个非常有意思,可能是 AI Agent 时代一个新的产品设计范式吧,就是你说第一天我们就可以做一个全球化的产品,你觉得这可以适用于所有的 Agent 产品吗?
张阔|00:17:29 如果需求本身是接近的,因为电商本身我们认为这个最大工业数是比较接近的,那这个事情应该是成立的。
张阔|00:17:58 如果需求本身在各地就有非常大的差异,流程有非常大的差异,环境有非常大的差异,可能还是有很多需要在每个区域里面去重做的部分。
主播|00:18:02 你们推出这个产品也有一段时间了,在你刚才提到的这三个方面,Model、Harness 和 Context 里面,有哪个部分是你们持续投入的时间或者精力更多的吗?还是这三个部分你觉得都是一样重要的?
张阔|00:18:06 此时此刻我觉得可能是齐头并进的。
张阔|00:18:10 最开始大家可能做在 Harness 上会花的精力比较多,
张阔|00:18:17 因为你要连接不同的 Tools 、要管理你自己的 Memory 、要做好用户的授权等等,
张阔|00:18:21 这一整套的工程的事情你是保证你这套系统能够持续运行的。
张阔|00:18:24 做电商天生可能就是一个长程任务,
张阔|00:18:32 它是要连续几个月不停地去执行跟经营,你能不断地优化得到结果的。所以在 Harness 上本身就要花非常多的精力。
张阔|00:18:32 然后我们在 Context 上天生就是有优势的,本身我们就积累了 20 多年,至少做电商,还是做跨境电商,还是做 Sourcing 和采购,这里边有大量的可能跟每天沟通相关的信息,当然也有大量的行业属性,有大量平台的趋势属性,这些信息都可以进来让你得到更好的结果。
张阔|00:19:07 现在我们在 Model 上其实也花非常多的时间,因为 Model 跟 Harness 这两个我们发现是要在一起去优化,不是你只优化一个,另一个你就直接可以去用一个通用的 Frontier 模型就能完成了。而且现在对于 Model 大家的竞争肯定都更深入了。
张阔|00:19:15 也不是说用一个通用模型,我们简单的做做 FT 就行了,可能都是要基于一个一定尺寸的模型去做后训练。
张阔|00:19:22 同时在 Model、在 Serving 和在 Harness 这三个上面都要去做非常精细的打磨,你才能拿到一个模型最好的效果。
张阔|00:19:29 只要能同时让它的产出的结果效率最高,你可以用最低成本去达到一样的结果。
张阔|00:19:36 同时你要让你的 cache 率,你要让你整个模型的产出的结果的准确率,达到一个新的水准。
张阔|00:19:42 它肯定是在训练和在 serve 和在 harness 上要同时去做优化的,不是你只是简单的优化一件事。
张阔|00:19:48 比如现在我觉得至少在这个角度来讲,可能竞争更加是一个多元化的全方位的竞争了。
张阔|00:19:59 这也是让不同的垂直领域里面的这些 Agent 能够真正跑出来的原因。
张阔|00:20:04 因为它不是一个通用模型,再加上你给的一些简单的 prompt 就能产出结果。
主播|00:19:57 对,其实这也是一个很好的过渡,因为你说到模型,然后还有 Context 这两个点,我觉得可能就对应了相当于是通用模型和垂直领域的模型,这两个不太一样的发展方向吧。
主播|00:20:08 因为我们上次聊的时候呢,其实我们也有问到当现在底层模型能力越来越强的时候,我们为什么还能在垂直 Agent 身上看到机会呢?
主播|00:20:32 你们当时就提到说你们来做这个产品有 20 多年的优势,包括有信息、数据的准确性。
主播|00:20:26 可以形成一个比较有效的强化学习机制吗?
主播|00:20:36 我想现在再把这个问题抛给你,你觉得近半年来模型也有那么大的进步,你觉得这些优势它的作用是更明显了,还是它有什么变化呢?
张阔|00:20:40 第一个呢,我们对这个事本身的理解也是持续有迭代的。
张阔|00:20:45 就是为了去衡量这个 Agent 好不好,我们甚至做了一个自己的 bench。
张阔|00:20:53 因为现在模型发布的时间比我们上次聊的时候可能频次更快了嘛。
张阔|00:20:51 估计我在硅谷这待一个礼拜,光个人助理就发了好几个。
张阔|00:20:55 但是呢,我们自己日常经营下来就发现,当一个模型说它出来了,它都会说各个角度都更好。
张阔|00:21:02 甚至非常多的榜单都已经打到 99 分了,就满分 100,就是 99 小数点之后去进步。
张阔|00:21:08 但我们自己在日常去使用的时候又没有感觉到像说的这么好。
张阔|00:21:12 所以我们后来就觉得,我们自己不断实践里面去发现,比如 Coding 在数学或者在通用的叫 Agentic 的能力上得分比较高,和你在电商领域里面能完成更多的工作,这个事情其实没有那么大相关性。
张阔|00:21:27 你的通用智能水平变好,确实能让你在完成一些工作的通过率更高,但是从我们整体的感觉上来讲,大家没有在每一个模型发布的时候把本质的水位拉得那么大。
张阔|00:21:39 所以我们就基于我们的上百万的在 alibaba.com 里边的真实经营的数据,包括 Accio 里边的真实的这些问答数据,我们大概总结了 107 个 Task。
张阔|00:21:48 这 107 个 Task 现在是开源的,我们也希望所有的模型在训练的时候可以围绕开源的 Bench 去做自己的评测。
张阔|00:22:18 这样我们每次出来我们也可以借点大家的光,不然的话大家评测的内容就都不一样,就发现这个模型计量我们还要做非常大的适配,才能让电商类的 Workflow 可以做得更好。
张阔|00:22:13 找这 107 个 Task 再加上 Accio 作为一个统一的 Harness,我们就可以去评测各个模型在 Bench 下面它的表现。
张阔|00:22:22 事实上可能现在最 Frontier 的模型在我们这个 Bench 下面能够通过率就是 61% 多一点点,它想要达到及格水平现在都有点费劲。
张阔|00:22:25 但是它就不代表说 61 就是这个工具不能用。
张阔|00:22:30 61 是说全部人不干预的情况下也不能完成,但每个工作的难度是不一样的。
张阔|00:22:36 我们把它分成 L1 到 L4,就是越长程,可能它的最终的结果就是越开放性的。
张阔|00:22:39 这时候能通过的这个模型可能就更少一些。
张阔|00:22:43 我们把所有这些模型放在一起,就形成一个新的帕累托最优的曲线。
张阔|00:22:46 就是我们希望给用户优化的是什么呢?
张阔|00:22:54 就不是说模型升级了,于是大家都跑最贵的模型,然后去完成最简单的事情。
张阔|00:23:01 就一定是你其实有非常多的低成本的模型,尤其是中国我们出非常多的模型,就是非常高价比的模型。
张阔|00:23:05 当然也有一些 Frontier 的模型解决一些复杂和困难的问题。
张阔|00:23:20 由 Accio Work 这个产品本身帮你去路由不同的问题到不同的模型上,同时基于我们自己 Harness 能力和 Context 能力,即使是同样模型,我们也可以拿到更好的结果。
张阔|00:23:16 这是我们在实现过程中不停地在尝试的问题。
张阔|00:23:19 比如我们用千问最新的版本的小尺寸模型做 Post-train,
张阔|00:23:23 它能拿到的效果已经非常接近 Frontier 的 Top 的模型。
张阔|00:23:27 这样大量的这些简单的工作,
张阔|00:23:30 我们其实就可以路由到一些小尺寸模型,
张阔|00:23:32 更快的时间去拿结果,同时更高效率。
张阔|00:23:34 因为现在商家侧,我们的一个感受是,
张阔|00:23:52 必须是一个用得起的 AI 才是一个有价值的 AI,因为它是一个日常经营适用的产品。
张阔|00:23:51 它不是一个我为了解一个数学难题,一次性我就用一下这个产品,之后就不用管了,其实跟这个还是有很大差异的。
张阔|00:24:05 所以在同样的任务的情况下,107 个任务把它都跑完,这个情况下,Accio Work 跟 Codex 跟 Claude Code,我们就换一个角度去比 Agent,完成同样的通过率上的任务,Accio Work 的成本是三分之一。
张阔|00:24:14 我们可以不断地把它降到更低,让更多的人可以更大规模地把他的工作交付给 AI。这是我们想去优化的目的。
主播|00:24:14 对,这个非常好,因为我们经常聊到开源模型,然后 Token 经济学嘛,我们经常听到的一个观点就是,现在企业在有选择的使用模型,就包括像刚才你说的,把不同的任务交给不同的模型,达到最终降低成本的一个目的。
主播|00:24:47 我觉得你们现在这个例子也是非常好的证明了这一点。
主播|00:24:50 能不能具体来讲一下你们做的 Benchmark?
主播|00:24:55 你说到 107 个任务,能不能给我描述一下是什么类型的任务?
主播|00:24:56 这都是具体的电商任务是吧?
张阔|00:24:49 是的,举几个例子吧,有的是跟电商相关的,有的是跟平台相关的,但都是日常过程中我们可能经常会交过碰到的。
张阔|00:25:01 你比如说从一个买家去给商家发 Quotation,这个买家要从大量的商家回复的 Quotation 里边去选择最合适的一个供应商是谁?
张阔|00:25:14 这个内容本身含非常多的信息,除了你要回复你对它的产品,你的生产工艺、制造、价格以外,可能还需要包括产品到手价是多少,给你提供的物流的解决方案是什么。
张阔|00:25:19 然后在这个 quotation 的回复里边,我们还可能给它去掺杂几个钓鱼邮件。
张阔|00:25:31 我们要把一些有诈的信息识别出来,把一些有价值的信息把它识别出来,最后把从生产侧的工厂的价格到含税的到手价格。
张阔|00:25:31 每一个把它算得很清楚,要选出最后一个正确答案是什么,就是这是一个 task。
张阔|00:25:36 在中间,你可能任何一个环节 fail 掉了,或者你算的结果是不对的,那这个 task 又没完成。
张阔|00:25:42 第二个,你比如说要去订一艘船,给定的交期到起止点,到点是什么,然后你要在船公司的网站上能够 book 到这个船。
张阔|00:25:51 如果 book 成功了,那就算你这个工作完成了,否则的话就算 fail。
张阔|00:25:56 平台有大量的 dispute。
张阔|00:25:58 这个 dispute 你是要最终判断基于现在比如买家对于卖家的投诉或者是对于供应商这个投诉
张阔|00:26:05 他现在提供的信息是不是完整。
张阔|00:26:08 就你的结论是不是赔或者不赔是对还是不对。
张阔|00:26:12 是要判断现在需不需要更多的信息来去做最终的判断。
张阔|00:26:16 就这些都是日常工作中你可以看到的有的是监测你最终计算结果的。
张阔|00:26:28 有的是要监测你是不是能执行成功。
张阔|00:26:29 有的就是监测你对于这个商业的判断,它现在是个开环问题,其实还是个闭环问题,能有结论的问题。
张阔|00:26:32 就类似这样的问题,我们大概有 100 多个涵盖七大类。
张阔|00:26:38 然后 107 是此时此刻 snapshot 的数据,你下个月再问,可能就比这个多了。
张阔|00:26:54 因为我们也是持续地把更多的更复杂的问题加到这个 bench 里边,去保证整个模型的测试是跟真正的日常经营的结果是相同的。
张阔|00:27:02 而且因为经常我们这个模型迭代或者 Agent 迭代一段时间之后要避免腐化。
张阔|00:26:53 你做一段时间你发现原来 case 就不行了或者结果更差了。这是一个不能接受的结果。
张阔|00:26:58 所以不停地就要去评估,我们每一个版本迭代的时候这个产品其实可以再向前去推进。
张阔|00:27:04 就如果我们说广义的 AGI 怎么定义不一定有定论。
张阔|00:27:08 我觉得我们这个商业上的 AGI 是好定义的。
张阔|00:27:11 就是你用 Agent 的产品经营,当然给定一定的边界,就是你的 Budget、你的供应链是一样的情况下,Agent 一定比一个人去做日常的这些操作和判断能赚到更多的钱,那就是商业领域里面的 AGI。
主播|00:27:26 很有意思,这个就是整个电商的一整套的商业环节其实都是有覆盖。
张阔|00:27:31 没错。
主播|00:27:31 你刚刚提到的 7 个大类,有的是 Sourcing,有的是 Dispute 嘛,其实这些能力就可以说是不太一样的能力吧。
主播|00:27:40 你觉得在真实的场景中,就有没有哪些环节是对于商家来说更困难需要 Agent 去完成的,有哪些环节可能是商家更愿意个人操作的?
张阔|00:27:50 我觉得可能不会这么分。
张阔|00:27:52 我们都会把一些比如说一定需要去人做决策的事情留给人。
张阔|00:27:57 比如你要去支付、去采购这批货这个按钮,一定是交给人去判断的。
张阔|00:28:03 因为你要对于你整个的经营结果负责,那就是所有这些 terms 帮你生成了之后,
张阔|00:28:08 你要去确定要不要做这笔采购,这肯定是人要去做的事情。
张阔|00:28:24 因为最近做了非常多的电商的商家访谈,因为 Accio 在国内也可以解决 B2C 的商家日常的经营的问题。
张阔|00:28:24 因为最近做了非常多的电商的商家访谈,因为 Accio 在国内也可以解决 B2C 的商家日常的经营的问题。
张阔|00:28:32 因为我的工作前六年,2011 到 2016 都是在淘系,就是淘宝和天猫去做商家的平台,包括开放平台、工具等等。
张阔|00:28:36 因为那个时候对于整个商家的后台的经营还是比较清晰的。
张阔|00:28:47 我们做 Accio Work 这个产品之后,我就站在另外一个视角去看,它到底要怎么用 AI 的产品去做日常经营。
张阔|00:28:44 有发现非常有意思的事就是,我们当时觉得这个产品已经做的比较极致,包括让商家怎么去看数据,怎么去看客服的体系,怎么去做日常的客服经营。
张阔|00:28:55 但今天有了更强大的 AI 的能力之后,你会发现大家去看问题的方法和去经营的方法还是有非常多的不一样的视角和方式,一定是比以前做生意做得更灵活了。
张阔|00:29:07 比如这个 Use Case 第一个就是多平台经营。
张阔|00:29:10 现在你要问国内的商家,可能大部分是多平台经营,抖音电商、淘系电商、京东、多多等等。现在到底哪个平台今天挣到钱了?只有大量的流水进来,但是不代表你最后的经营是有利润。
张阔|00:29:23 这个问题本身其实就要跨多个平台的数据去看,投入的情况、收益的情况、退换货的情况,就给你形成一个完整的报表。
张阔|00:29:32 就以前可能一个人要拿到这个问题,多个平台去来回切换整理 Excel,最终你还不一定算对。
张阔|00:29:38 但我觉得现在 AI 去解决这个问题应该非常容易,你任何时间节点都可以给一个你自己跨平台的实时经营的结论。
张阔|00:29:46 第二大类就是发布商品。其实很多平台、很多商家要经营多个平台,然后每个平台它的规则多多少少都有点差别。
张阔|00:29:55 然后每个平台因为它的受众和它自己的媒体形式有差异,你发布的内容又多多少少有点差别。
张阔|00:30:02 稍微有一点规模的商家,乘起来就是一个非常大的工作量。
张阔|00:30:22 发布一个产品,全都更新一遍,就是很大的事情。这个事儿现在交给 AI 就非常方便。
张阔|00:30:21 你有一个新品在多个平台上发布,或者说你对于一类商品都有一个统一的 update,就是到一定的时间了,你要做大促、打折这些操作等等。
张阔|00:30:25 就这些事情 AI 的 repetitive 的 work 当做完了之后给你一个判断。
张阔|00:30:34 你可以选择放到草稿箱里再把它发布掉,或者你直接给它授权让它去发布掉,它来告诉你一个经营结果,它肯定是比人的效率和精确性要高的。
张阔|00:30:42 再比如说,任何一个大一点的店可能都有客服经营的要求,当一个客户进来问问题,你怎么回答?
张阔|00:30:50 以前大家开经营会,一条一条拿出来看,谁答的是对的,谁答的是错的,当然你可以举一些转化数据去给出评论。
张阔|00:30:59 现在 AI 很容易的事情就是马上把你所有的这些经营的结果分析一遍,告诉你什么人什么样的回答是个更好的方式。
张阔|00:31:02 对于 2B 来讲,哪些客户现在可能出现了问题?
张阔|00:31:08 就是你这个交易本来可以进来的好好的,但中间可能出了什么问题,这个单子可能要黄了。
张阔|00:31:13 会给你一些提前的预警,或者告诉你这个单子接下来最重要要做出的判断是什么等等。
张阔|00:31:23 就这些事情原来要大量的人去做复盘,然后对于业务的主管要求很高,对于业务员要求很高的时间,现在 AI 一定是可以比原来做的更好。
主播|00:31:33 其实 AI 能力的增强,因为你刚刚也提到它让大家的工作方式变得更加灵活,你觉得商家的预期会不会也变得更高或者更加的复杂?
张阔|00:31:53 一定是这样,每次你做一个产品,大家都会去提一个更高的要求,我可以从一个数据来去表达,因为我们每天会去分析 Accio Work 里边,刚才我们就说有七大类,那七大类里边呢,每一大类还都有从 L1 到 L4 的难度的任务。
张阔|00:31:50 就从发布的第一天到今天我们去做一个今天的截图,就会发现呢,任务的难度都是不断的从简单的一直推到复杂的。
张阔|00:32:00 就开始大家可能都是 L 一级的任务,我去问一些问题,你能给我答案,就挺好的。
张阔|00:32:05 慢慢地就开始我要交给你一些任务,你把这个任务帮我做完,后来变成我交给你一些更复杂的任务,你来去帮我做完,到我要交给你一些跟经营最终判断相关的任务,你要帮我去做完。
张阔|00:32:52 商家侧一定是每一段时间会去 push 你这个产品,要去帮他解决一个更复杂的问题,交给这个产品更多的任务,让他自己去重复的执行,让这个店铺里面更多的经营的数据可以交给这个 AI,让他帮助去做判断,但是最终还是要人去做一些最重要的判断。
张阔|00:32:36 我们核心讲的还是说越来越多的重复性的工作交给 AI。
张阔|00:32:38 我觉得这个是对于电商本身的一个进步的表现。
主播|00:32:45 你刚提到最后一个下单的动作肯定是要交给人做的判断,还有什么你觉得是比较重要的判断?
张阔|00:32:51 那太多了。假设说我们说现在 AI 能帮助人做非常多的重复性工作了。
张阔|00:32:55 你有一个 idea,最后你要把这个 idea 变成一个产品卖给更多的人。
张阔|00:33:22 你解这个问题面对的客户群体是不是一个对你设计这个产品感兴趣的客户群体,并且他的基础足够大,愿意支付足够多的溢价,这些事情都是要人去做判断,这个产品的 Taste 都是人去做判断。你此时此刻对这个市场的预测和判断,这也是一个人本身经营的一个直觉,就是同样一个 Budget。
张阔|00:33:33 你是希望更多的广告、更少的库存,还是更多的库存,我要铺更多的渠道,但我要有更大的 Margin,这都是大家对于你这一盘生意目前经营的一个判断。
张阔|00:33:43 这些事情我觉得现在还是要人去按这个按钮,AI 可以帮助做大量的市场的分析、调研、竞对的判断等等,但是最终商业判断还是人去做。
主播|00:33:48 我想再回到我们提到的 107 个电商任务和 Benchmark 。
主播|00:33:51 因为你刚才提到这个数字就是成本的降低。
主播|00:33:56 用 Accio 的估算成本是 3.69 美元,我看到是你们给到的一个数字。
主播|00:34:04 然后 Codex 和 Claude Code 都是在 9 美元以上,所以 Accio 的成本是另外两家的三分之一。
主播|00:34:07 这个成本具体包括什么,能不能给我们讲一下?
主播|00:34:11 你觉得在这个过程当中为什么 Accio 的成本会更低呢?
张阔|00:34:20 为什么更低我觉得比较好理解,因为我们本身就是用帕累托最优的模式去路由所有的工作到不同的模型上。
张阔|00:34:29 比如低难度的工作相对来讲比较简单,我们用小尺寸的或者用高性价比的模型就能完成,我们肯定最大程度的帮商家节省成本。
张阔|00:34:35 有一些模型对多模态的要求比较强,对于整个视频的要求比较强,你可能就要路由到一些特定的成本上。
张阔|00:34:41 核心它的优势就是你集约采购,你比个人去用这个模型的成本肯定还是便宜一些。
张阔|00:34:49 同时,同样的模型情况下,我们在不同的 Harness 的工程的实践和对于 Context 的管理上,
张阔|00:34:51 要比你用一个通用模型的效率会更高一些。
张阔|00:34:55 以这些方向都是我们能够帮助用户去节约成本。
张阔|00:34:56 为什么我对这个事很关心呢?
张阔|00:34:59 因为经常去看商家侧的反馈,会觉得贵。
张阔|00:35:02 有的时候可能是对于一个特定 task 觉得贵。
张阔|00:35:08 有的时候呢,他就是我就固定选择一个模型,比如我就用最贵的模型解决所有的问题,他觉得这个事情贵。
张阔|00:35:11 我们给客户的建议都是你可以直接选到 Auto 模型。
张阔|00:35:17 Auto 就是我们可以帮助你去帕累托最优去优化你所有的工作,到底应该用什么样的模型去完成。
张阔|00:35:26 当然对比 Codex 跟 Claude Code,因为它自己本身是 Agent 跟自己的模型去做绑定的,有很多的类似路由这些工作它可能是没有办法做的。
张阔|00:35:30 这也是你从美国这个市场能看得出来,就是美国有一大类的生意,
张阔|00:35:41 非常受欢迎的就是类似 Open Router 类似 Fireworks 它就有 hosting 大量的模型,帮你去优化每一个模型解决什么样的工作跟任务。
张阔|00:35:51 现在越来越多的模型成为 commodity,每一段时间都有一个更好的开源模型去出现,其实也是至少在一个相当长的时间节点里面,我们觉得是有非常大的优化空间的一件事。
主播|00:35:53 你们现在支持哪些底层模型?
张阔|00:35:55 基本上你能看得到的都支持。
张阔|00:36:01 当然了,就是有一些帕累托最优曲线已经完全埋在下面了,那就没有必要支持了。
主播|00:36:01 对对对,因为我们现在聊的时候,GPT-6 Astra 这个模型刚刚发布嘛,大家也在讨论它减少 Token 的成本,包括说是一个能力更强的模型。
主播|00:36:11 你觉得这样的模型的发布,因为你们测试用的是 Codex 和 Claude Code 嘛,你觉得在 Astra 之后,这会对你们造成什么影响吗?
张阔|00:36:21 我觉得你再过两天可以直接去我们 Bench 上去看 Astra 的评分。
张阔|00:36:26 我觉得再给他们测两次去看一看这个效果到底是好还是不好。
张阔|00:36:31 因为之前经常就会有这种问题,但这个问题一旦没有一个 Benchmark,
张阔|00:36:35 就是你不能量化它说好还是不好。
张阔|00:36:38 然后它发一个模型就是我这个事情解决的很好,
张阔|00:36:41 然后就说那它所有的事情都可以解决的好。
张阔|00:36:42 其实这两个事不是一个相关性的事情,
张阔|00:36:54 他可能是做 3D 模型做的不错。
张阔|00:36:56 也可能在一些 Computer Use 上有一些突破,但不代表它在通用商业里面的 Agentic 的能力强。
张阔|00:37:03 所以你说它是 AGI,我现在给你打保票的肯定不是 AGI,就最终还是以最高性价比完成它的任务是第一优先级。
张阔|00:37:14 等我们发布了,我觉得你可以直接去网站上看一下它的评测结果,因为所有的 Frontier 的模型,我们有一个统一的 Benchmark 去跑,我觉得这个评估可能更公允一些。
主播|00:37:16 对,所以这也体现出了 Benchmark 的重要性。
主播|00:37:24 这个其实也是现在的一个趋势,就是我们越来越需要专业领域的 Benchmark,这也就是为什么数据公司现在非常火嘛。
主播|00:37:28 每一家模型公司也都需要这些具体的数据去进行训练。
主播|00:37:34 其实又回到了我们刚才说的通用的 Agent 和垂直领域的 Agent 的一个区别。
主播|00:37:46 那你觉得反过来说,对于一个垂直产品,因为其实我们都有非常具体的流程,这个会不会因为流程过于的固定,写的太死,限制了一些模型本来能够做到的事情?
张阔|00:37:56 我觉得不会去固定这些流程吧。我们现在核心的一个标准还是先要固定一下红线是什么,什么事情肯定是不能做的,但是路线肯定不是定死的。
张阔|00:38:05 你希望完成一个任务,只要你能把这个目标说清楚,一定是不断优化这个流程,或者不断优化这个操作,不断地逼近你想要的这个目标。
主播|00:38:10 现在别的电商其实也有在发类似的 Agent 产品。
主播|00:38:19 对于一个商家来说,如果他在用多个 Agent 的时候出现了冲突,Agent 给他的建议不一样,这种情况应该怎么样去处理呢?
张阔|00:38:27 比如在美国为例,像各个垂直的电商和一些平台电商也都有一些 Agent。
张阔|00:38:26 然后这些 Agent 我觉得做的也挺好的。
张阔|00:38:28 我觉得可能 Accio Work 跟他们的差异呢,更多的是 Accio Work 还是希望站在商家自己的一本账的角度,帮他去整体做优化。
张阔|00:38:37 各个平台应该怎么去做投入啊,怎么去做经营。
张阔|00:38:40 这个从定位上来讲,我觉得这个产品跟其他的围绕着某一个平台去做优化的定位还是有差别的。
张阔|00:38:46 第二个就是不同的 Agent 给你不同的建议,这非常正常。
张阔|00:38:51 核心还是说作为一个老板你要有一个整体的经营的目标是什么。
张阔|00:38:56 然后基于这个大的经营的目标下,去看 Agent 给你本身的建议是不是合理的。
张阔|00:39:00 因为从我们自己的视角上来讲,商业经营还是一个非常长周期的过程,甚至不是以一次交易成功和失败为目的。
张阔|00:39:10 这次交易就算成功了,它可能最终导致你商业失败,那它也不是一个好的交易。
张阔|00:39:15 就算同一笔钱,它的花法可能有非常大的差别。
张阔|00:39:19 各个平台有它自己的建议,你从你自己经营最终想要,以毛利为结果,还是以规模为结果,以速度为结果,你有自己核心的判断。
张阔|00:39:47 就这个事情没有办法有一个统一 Agent 的,统一一下所有 Agent 的意见,然后给用户一个更好的反馈,这不是我们这个产品设计的初衷。
主播|00:39:41 对,所以其实这还是回到人的决策,而且从你们厂商的角度来看,这是你们不希望 Agent 去代替的。
张阔|00:39:47 最终的经营判断一定是这个人,最终对于这个产品本身的品位,这肯定是跟这个人相关的。
张阔|00:39:51 这个也是最终这个产品走向市场是不是能成功的关键。
张阔|00:39:57 我觉得 AI 能够帮助他完成非常多的原来重复性工作把它解放出来的部分。
张阔|00:40:04 但最终对于商品的判断,对于这个问题是个大问题还是小问题的判断,和对于商业上的节奏的判断,这一定是人要去做的。
主播|00:40:11 嗯,很有意思。那最后我也想聊一下 Agent 的最近的一些设计上的变化哈。
主播|00:40:17 因为你们也把 Accio Work 描述成是 24 小时在线的相当于是业务团队嘛。
主播|00:40:27 我们其实也看到最近有很多 Agent 的产品开始脱离用户的本地电脑,然后在云端工作,比如说像 Grok Bot 这样的产品,然后 WorkBuddy 也有云端的模式。
主播|00:40:35 我其实蛮想聊一下云上业务的设计理念的,就是这个所谓的持续在线、持续响应,具体来说它到底意味着什么呢?
张阔|00:40:43 我觉得这可能是两个概念,因为上云是个简单的事儿,就是 Accio Work 它可能 PC 版的之后的几天就开始有云端了。
张阔|00:40:57 从客户的需求来讲,我有很多本地的 memory,我希望放在云端,这样我可以换台机器,也可以在这操作。
张阔|00:40:51 长程是另外一个概念,就是你所谓这个长程是多长程,就是你让 AI 去解哥德巴赫的猜想,推了俩月,这也叫长程吗?就是一直不停的推演这是个长程。
张阔|00:41:00 但是从商业角度来讲,我们可能把它也分成几个不一样的任务,你比如说每天你都要进行店铺经营,每天你都要看公司里面这些员工他的工作做得好还是不好。
张阔|00:41:11 它就是个定时任务,每天定时的要给你出这个报告。
张阔|00:41:14 第二个可能是跟事件驱动相关的任务,比如你是一个买家,你去找供应商去下单,那你跟多个供应商去沟通的过程,
张阔|00:41:23 那就是 AI 要基于这些更新的信息去帮助你进一步推动沟通的结果。
张阔|00:41:28 然后还有一些任务,它可能是一个季度时候会有结果。
张阔|00:41:31 你整个经营你这盘生意,最终你这个产品是赚了钱了,还没赚到钱了,过程中你可能有非常多的要去复盘的东西,但是你去经营这一个生意本身,这也是个非常长程的任务,我觉得这几个东西之间还是有比较大差异的,就是上云,我觉得这是一个 Basic 需求。
张阔|00:41:50 就是 Agent 今天你说你没上云,那就是你功能还没做完,我只能说,这不是说大家技术上有个很大差别。
张阔|00:41:56 但是你说你要做一个长程任务,核心还是要定义在什么场景下,需要完成什么目标的一个长程任务。
张阔|00:42:02 就是要在电商领域里边,我就是我刚才去定义这几个范式吧,这都是我们现在就已经去支持的比较好的范式。
张阔|00:42:24 现在 Agent 已经可以有完成长程任务的能力了。
张阔|00:42:27 对,因为商业经营本身就是长程。
张阔|00:42:20 对于每一个员工你给他设计的 OKR,他不论交易工作做完了还是没有。
张阔|00:42:27 对于每一个商业 case 比如每一次沟通他都要去交易这个销售或者这个客服他回答的问题是对的还是不对的。
张阔|00:42:34 然后这个用户对于这个客服的回答他到底是对于商品本身的一个建议还是对于这个服务的建议。
张阔|00:42:39 还是对于整个售后的建议,它都是可以不断地去完成你整个商业去经营的过程。
张阔|00:42:46 为这个事情施我们实际打磨的方向,而不是说我就追求这个模型能跑 7 到 24 小时,跑一个礼拜,然后它不挂。
张阔|00:42:49 不挂 means nothing,如果没有解决你的问题的话。
张阔|00:43:19 对,非常好。最后就是这次您在洛杉矶开 CoCreate,我相信也有非常多的商家来到现场,你觉得有什么是从你和这些商家对话当中是让你觉得比较惊讶的吗?他们对于 Agent 的用法呀,或者他们对于 Accio Work 这些功能的期待?
张阔|00:43:27 其实这次最惊讶的事情就是来的人太多了。我们可能最终估计注册到场的有〔转写异常〕人。在 Agent 的教育上肯定还是比较领先的。就是大家或多或少一定是对于产品理念本身是接受和理解的。
张阔|00:43:31 而且我们现在有非常多的客户基于这个产品已经创造了自己的商业,并且在这个基础上已经把自己的商业进一步的放大。
张阔|00:43:41 其实每年我们 CoCreate 都有个项目叫 CoCreate Pitch。
张阔|00:43:44 有点像 Shark Tank 类似赢在美国赢在中国这种节目。
张阔|00:43:48 去年我们一个英国冠军一个美国冠军,英国冠军是个 15 岁的小孩,上初中。
张阔|00:43:54 他大概用 Accio Work 去找供应商去发掘自己的新的产品,
张阔|00:43:59 他做的是一个类似帮助你去制冷的、可以自动帮你降温的毛巾,自动帮宠物去降温的产品。
张阔|00:44:23 基于 Accio Work 去找这些 idea 已经形成了一个系列,大概现在一年的销售额有 100 万英镑左右,我们觉得是个不错的结果了。
张阔|00:44:19 去年在美国的这个创业成功的冠军叫 Christian Reed,
张阔|00:44:24 开始穿着的时候非常工地化,我们以为是一个工人出身,
张阔|00:44:29 后来发现还是 MIT 毕业,他做的产品就是去做一个非常酷炫的测量设备,
张阔|00:44:33 然后这个测量设备也是从他的 idea 的创业到整个找供应链,
张阔|00:44:35 都是基于 alibaba.com、基于 Accio Work。
张阔|00:44:45 现在他的客户也包括施耐德电器、包括 SpaceX 呀,这都是他的客户,他的生意今年大概也做到几千万美金以上了。
张阔|00:44:53 就是我们现在看到呢
张阔|00:44:44 更多的中小企业基于 AI 基于全球供应链的能力去做自己的生意,你不需要一个非常大的公司,但你也可以把这个生意做得很大。
张阔|00:44:55 我们也是希望 AI 进一步的降低门槛,因为全球中小企业可能还是各个区域的经济的主力,就业的主力。
张阔|00:45:03 然后原来他们核心的问题其实不是在 AI 取不取代工作的问题,原来它的问题就是没有那么多的资源,没有那么多的经验。
张阔|00:45:11 但是它又想把生意做大,又想利用全球供应链。
张阔|00:45:32 今天我们正好有 AI 和整个有阿里巴巴.com、有阿里巴巴这个能力,可以帮助更多的中小企业去实现这个梦想。
张阔|00:45:34 从一个 idea 开始。
张阔|00:45:26 一直到这个 idea 本身去创造一个更大的商业价值。
张阔|00:45:31 我觉得这件事是 AI 能够帮助更多的中小企业实现自我价值的一个更大的放大期。
主播|00:45:34 对,我觉得这也是咱们结束的非常好的一个点。
主播|00:45:36 谢谢,欢迎再来我们节目。
张阔|00:45:37 好,谢谢,谢谢。
主播|00:45:43 好了,以上就是我们这期播客的全部内容了。
主播|00:45:52 国内的听众可以通过小宇宙、苹果播客、网易云音乐、喜马拉雅、QQ 音乐、蜻蜓 FM、荔枝 FM 来关注我们。
主播|00:46:00 海外的听众可以通过苹果播客和 Spotify,或者在 YouTube 上搜索硅谷 101 播客来关注我们。
主播|00:46:10 我们部分的文字稿还会收录在《硅谷 101》的微信公众号上。
主播|00:46:15 谢谢大家,我们下次再见啦!
References
- 1官方单集页:E255|模型越来越强,为什么用户没感觉?再访阿里国际站总裁张阔
sv101.fireside.fm
- 2
- 3
- 4
- 5GitHub:Accio-org/CommerceAgentBench
github.com
- 6钛媒体:Accio开源首个真实电商Agent基准测试
tmtpost.com
- 7Commerce Agent Bench 公开榜单
commerce-agent-bench.site.accio.ai
- 8Accio Work 官网
accio.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.