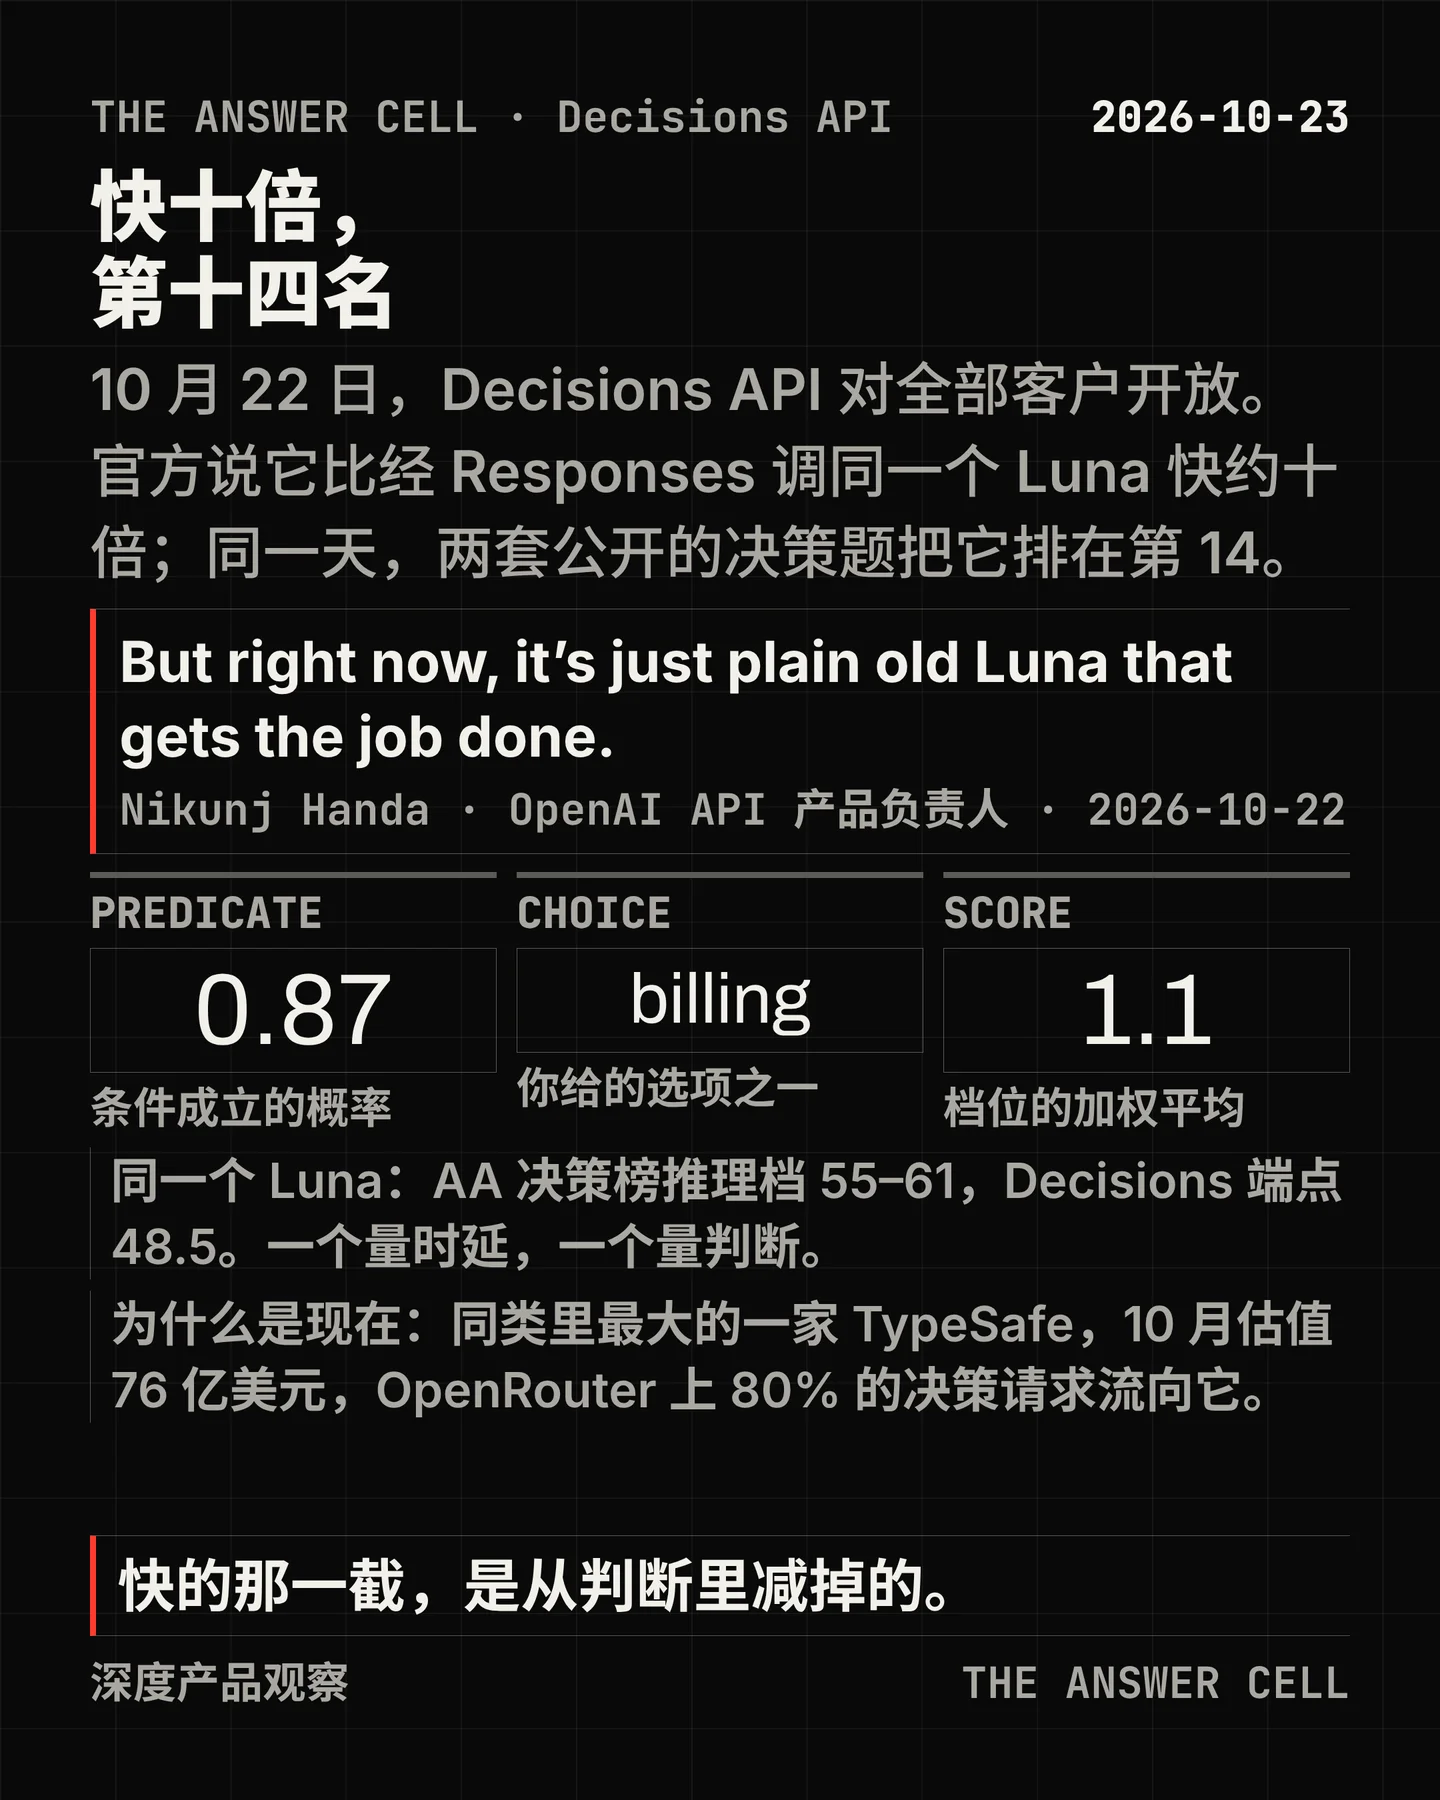

10 月 22 日,OpenAI 把 Decisions API 开放给全部客户。这是一个只回答「有界问题」的端点:你先列出允许的答案,它只给你一个值。1
这两个数字量的是两件事:一个量时延,一个量判断。
十倍,是对它自己另一个界面说的
官方的原句是「up to 10x faster than GPT‑6 Luna through the Responses API」。1 开发者文档换了个说法:「about 10x faster than the Responses API」。4 两处的参照物都是 OpenAI 自己的另一个端点。
官方没有给这个数字配测法。发布页、开发者指南、接口参考、模型页、变更日志里都查不到 p50 或 p95,也没有题目、区域、并发这类条件。4
能查到的毫秒数来自三处,互相对不上。TechCrunch 引 OpenAI 的 API 产品负责人 Nikunj Handa:从一到三秒降到 100、120、180 毫秒。5 客户侧,Sierra 自报「under 280 ms p95」,Speak 的首席技术官说从 1.4 秒降到 0.13 秒。1
目前能查到的唯一一次第三方对照测试,发生在 9 月 29 日,也就是公测之前。媒体 Every 的评测里,计算机任务文本回放,Decisions 平均 230 毫秒,Jev 500 毫秒;到了会话分类这一项,Jev 的中位数是 161 毫秒,Decisions 是 309 毫秒。6 同一个测试,两项一比,快的方向和慢的方向都有。
到 23 日凌晨,第三方还没有发布自己对新端点的复现。所以「十倍」目前是厂商口径,量的是同一个模型换一个端点之后的差别。
一条请求被改成了什么
端点只有一个:
POST /v1/decisions,模型也只有一个:gpt-6-luna。4 请求被切成三块——模型、共享证据(input)、问题清单(questions)。一块证据最多挂 400 个问题,比公测时的 200 个翻了一倍。4每个问题只能落在三种形状之一,返回的字段是定死的:
predicate返回probability,0 到 1 之间,表示条件成立的可能性;choice返回你给的那个值,另附每个选项的probability与一个confidence;score返回档位的概率加权平均,可以是小数。官方示例里三档概率是 0.1 / 0.7 / 0.2,算出score1.1、confidence0.55。4
形状定死之后,模型不必先写出一段话再让人去解析,它直接在给定的空间里给出一个点。十倍主要来自这里:被减掉的是生成那一段。
官方把边界也写在同一页上:要按你自己的 JSON schema 产出对象,比如抽字段或写解释,用 Responses 的 Structured Outputs;要模型发起工具调用,用 function calling。4 换句话说,说明这一层要另找接口。
还有一条容易漏掉的限制:有依赖的决策不能塞进同一批。官方写的是「send separate requests」——先判 A,再拿 A 的结果去判 B,就要多走一趟往返。4
账单上被划掉的只有一行
Decisions 的输入价是每百万 token 0.10 美元,缓存读 0.01 美元,输出不收钱。1 把它和价目表放在一起看:
gpt-6-luna 的输入价本来就是 0.10 美元、缓存输入 0.01 美元、输出 0.50 美元。7 单价一分没降,降的是那一行输出。输出那一行在账里占多少?算一笔常见的活:一段一万 token 的证据,要问 20 个判断。
旧办法是 20 次调用,每次把一万 token 的证据重新发一遍,共 20 万输入 token,计 0.0200 美元;每次输出 40 token,共 800 token,计 0.0004 美元。合计 0.0204 美元。
新办法是一次请求:一万 token 证据只读一遍,20 个问题一起问,计 0.0010 美元,输出不收。两者相差 20.4 倍。
在旧账里,输出只占 2%。这笔钱来自那十九遍重复的证据,也就是「一次读、问很多个」。反过来也成立:如果你的场景本来就是一次调用问一个问题,省下的只有输出那一行,也就是几个百分点。
缓存是第二个杠杆,门槛写在文档里:可复用前缀至少 1,024 token 才进缓存,问题本身不计入。4 写入按 1.25 倍输入价收,30 分钟档 0.125 美元、12 小时档 0.25 美元;区域处理与长上下文另乘系数。7
三个第一,落在两家公司
Artificial Analysis 的决策榜这一版是 v1.0,四项各占 25%:500 道私有题、513 道 HLE 多选题、3,423 个 When2Call 任务、835 行 WildGuardTest。它只给 16 个决策模型排位。2 AIM 的 System One Index 是 v1.2,把分类题、浏览器任务与偏见测试折算成 z 分数,59 个模型混排。3
两榜第一都是 Liquid 在 10 月 15 日发的 d1-ultra:AA 65.25,AIM 60。8 AA 第二是 Baseten 旗下 Base Labs 用 Qwen3.5 微调、开源的 elephant(9B),64.69。9
TechCrunch 写 Jev「seventh and third」、OpenAI 的决策模型「eighth and fourteenth」。5 前一组与两榜吻合;后一组里,第 8 在两张榜上都对不上——两榜都是第 14,第 8 恰好是 OpenRouter 决策模型用量榜上这个端点的位置。
第三个榜就是用量。10 月 12 日那一周,OpenRouter 上 Jev 1.13 有 9.48 亿次请求、1.14 有 3.16 亿次,TypeSafe 一家占去当周决策请求的 80%;OpenAI 的决策模型是 2,180 万次,排第 8,占 1.8%。10
AA 的同一套题也跑通用模型:Claude Opus 5.5 得 79.0,GPT-6.1 Sol 得 70.9,而决策模型里最高的只有 65.25。2 这一类卖的是速度与价钱。
校准是没买下来的那部分
决定这条端点能不能用的,是那个数准不准。官方把这件事留给了使用者:「Use labeled examples from your application to set thresholds」,阈值按你自己的假阳性与假阴性的代价来定。4
公开数据里有一次针对底座 Luna 的独立实测。10 月 1 日,博主 Anthus 用 3,600 道 ProofWriter 推理题打
gpt-6-luna,在 2,672 个置信度 ≥99% 的回答里,只有 68% 是对的;期望校准误差 0.32,而同一批题上 Jev 是 0.04。推理深度到第 5 步时,AUROC 掉到 0.51,等于抛硬币。12这个测试有三处要打折扣:时间是公测之前,打的是底座而不是这个端点,作者自己也写明「It isn't the Decisions API itself」。12 但它说明的问题不会因为端点换代就消失——概率标定的好坏,决定阈值能不能用。
同一件事还有两个旁证。InfoWorld 引 HFS Research 的说法:0.8 这个数的含义不能从一个模型搬到另一个模型,阈值要逐家重标。13 一位 Hacker News 用户在同一套题上分别跑 Jev 与 Luna,Jev 花了 0.0192 美元,Luna 花了 0.06 美元。14
所以这条端点真正卖给你的,是把判断变成可计数的东西;那个 0.87 可不可信,要你自己标出来。
什么时候不该用它
三种情况,官方文档自己就排除了:要按你的 schema 产出对象、要写解释,用 Structured Outputs;要模型请求工具,用 function calling;决策之间有依赖,另发请求。4
第四种是输出形态。Handa 说客户希望这条端点也能用图作为输出,目前还不行。5
第五种是题本身太难。Anthus 那批题到了五步推理就退化,说明「有界答案」和「难推理」是两件事,压成一个是会掉分的。
该怎么用
第一,先挑一个每天都发生很多次的判断,看它能不能只答一个值。压得进三种形状的,才轮得到这条端点。
第二,按「证据 × 问题」算钱,不要按调用次数算。一次请求最多 400 问,前缀满 1,024 token 才进缓存;有依赖的判断要另算一趟往返,那趟也要时间。
第三,把校准当成上线前的必做项。官方叫你自己标样本,公开实测里同一个 Luna 的「99%」只对了 68%;两个公开榜的前排都是别家,这一家两个榜都排第 14;榜也替代不了你自己的题。
能确定与不能确定的
能确定的是:开放时间是 10 月 22 日;版本线是 9 月 29 日开发者日的有限预览、10 月 6 日公测、10 月 22 日正式可用;1516 价格是输入 0.10 美元、缓存读 0.01 美元、输出不收;一条请求最多 400 个问题;两套公开题集都把它排在第 14。
不能确定的有几块。官方没有公布 p50 或 p95,也没有公布「十倍」的测法,所以这个数字没法复算;第三方唯一的对照测试停在预览期,量到的差是两倍上下,还有一项更慢。Decisions 端点为什么在 AA 上比普通 Luna 的非推理档还低(48.49 对 49.59),官方没有解释。AIM 的榜单在 10 月中旬连续加过模型,TechCrunch 引的位次与今天抓到的读数对不上,只能记为时点差异。
/v1/decisions 的并发上限、超时、专属速率限制,官方文档里都还没有。价目表上也找不到 Decisions 这一行——它挂在 gpt-6-luna 名下,只靠指南里那句「output tokens are not charged」与模型行区分。References
- 1
- 2Artificial Analysis Decision Index
artificialanalysis.ai
- 3AIM System One Index
aimultiple.com
- 4Decisions 开发者指南
developers.openai.com
- 5OpenAI makes its Jev competitor widely available
techcrunch.com
- 6Vibe Check: OpenAI DevDay 2026
every.to
- 7Pricing
developers.openai.com
- 8
- 9
- 10Decision Model Rankings · OpenRouter
openrouter.ai
- 11TypeSafe · Models
docs.typesafe.ai
- 12
- 13
- 14HN 评论 49985423
news.ycombinator.com
- 15DevDay 2026 recap
openai.com
- 16API changelog
developers.openai.com
Comments