Qwen-Planner-Agent 拿到 77.05%:CARE 修掉的那处归一化,与 10M 历史下的记忆层
解读阿里通义 MAI 团队 2026 年 9 月 24 日发布的技术报告 Qwen-Planner-Agent:77.05% 的 MobilePA-Bench 榜首站在同团队自建的基准上,报告里更经得起搬用的是两处机制——CARE 用分母下限修掉组内归一化吃掉效率权重的问题,输出长度降 32.5%;持久记忆 Harness 在 BEAM-10M 上把四对配对均值从 23.42% 抬到 61.66%。

2026 年 9 月 24 日,阿里通义 MAI 团队在 arXiv 发布技术报告《Qwen-Planner-Agent: A Closed-Loop AI-for-AI Framework for Real-World Mobile Planner Agents》,署名单位为 Alibaba Token Hub1。摘要页列了 26 位作者,正文的 Contributors 一节把署名分成三档,监制组是 Feida Zhu、Yiran Zhong 与 Steven Hoi12。
这份报告交付的是一套完整的智能体系统,由一个训练过的规划模型(Planner Model)和一层把模型接到部署环境上的 Harness 组成,合起来叫 Qwen-Planner-Agent2。两个版本都建在 Qwen 主干上,规模分别是 35B-A3B 与 27B2。
结果是一串数字。在该团队自建的 MobilePA-Bench 上,27B 版本拿到 77.05% 的总分,高于 GPT-6 Astra 的 76.84% 与 Claude Opus 5 的 75.71%2。报告按输出 token 单价估算的成本是每 1000 个任务 2.41 美元,它给出的其他被评模型区间是 3.06 到 67.76 美元2。官方站点与代码仓库同时上线,仓库里放的是站点源码与技术报告,没有训练代码、没有模型权重,也没有声明许可34。
77.05% 这个数站在同团队自建的基准上,领先第二名 0.21 个百分点。这份报告里更值得拿走的是另外两处机制:训练这一侧的 CARE,与部署这一侧的长历史记忆。
77.05% 站在什么上面
MobilePA-Bench 是该团队自己八月放出的基准。它在 8 月 24 日提交、25 日更新到 v2,包含 1700 多个可执行任务、212 个移动工具和 13 个功能域;任务跑在一个维护着在线应用数据库的沙箱里,完成与否由工具调用、终态变化或智能体行为来核验5。这份基准的作者名单与本文高度重叠,Steven Hoi、Yiran Zhong、Feida Zhu 等人两边都在15。
领先幅度也要看清楚。77.05 对 76.84 是 0.21 个百分点(换算值);同一个 27B,相对它自己的 Qwen 基线从 67.22% 升到 77.05%,这段是 9.83 个百分点2。能力这一列里,Skills 86.25% 与 Tool Use 77.79% 是全部被评对象中的最高值,Memory 74.76% 居其后,Sub-agent 59.55% 是它的短板2。
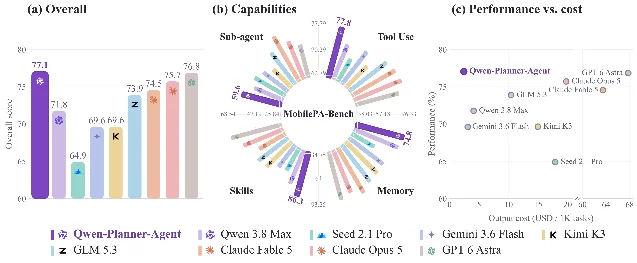
成本数字有明确的范围。2.41 美元由每个任务的平均输出 token 乘上对应的输出单价估出,报告写明它不覆盖输入 token、外部工具费用、设备执行开销与额外的 Harness 处理2;官方站点还注明成本轴上 22 到 60 美元那一段被省略3。这些闭源模型是在哪套 Harness 条件下计分的,报告没有说明。
榜首这一条的强度因此有限。报告里更能说明问题的是它自己的配对读数——同一批参数,前后各测一次。
同一批参数,两套读数
报告在实验一节开头把两个名字分开:Qwen-Planner-Model 指训练后的检查点单独跑,Qwen-Planner-Agent 指同一批参数带上 Harness2。表 1 里同一个模型因此出现两行,两行之差就是 Harness 的贡献。
27B 从 71.90% 到 77.05%,涨 5.15 个百分点;35B-A3B 从 64.79% 到 69.91%,涨 5.12 个百分点2。分项看,27B 的 Tool Use 由 72.79% 升到 77.79%,Memory 由 70.74% 升到 74.76%,Skills 由 79.25% 升到 86.25%,Sub-agent 由 55.06% 升到 59.55%;35B-A3B 那一档的 Sub-agent 停在 52.81%,报告写明它没有变化2。
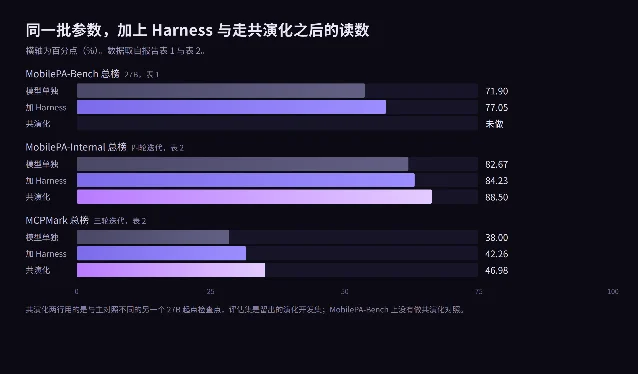
这个方法本身可以抄。要把「模型变好了」与「脚手架变好了」分开,只需在同一个检查点上做一次前后配对。
CARE 修的是哪一处归一化
训练这一侧的核心是 CARE(Competence-Aware Reward-and-Advantage Engineering)。它面对的做法是组相对策略优化:每个任务采一组 G 条轨迹,由任务专属的规则验证器或评分模型打出 0 或 1,组内成功率 s̄ 就是这条流水线的能力信号2。
CARE 的第一半按 s̄ 把奖励分成三档。成功率低的组做进程塑形,加一项已验证进展的奖励;中等成功率的组做结果巩固,只用成功与否;接近满分的组做效率精修,减去一项归一化后的执行成本2。两个阈值满足 0≤p_low<p_high<1,同一批训练里不同的组可以处在不同档2。
第二半才是这处改动的关键。标准的组相对做法把奖励减去组内均值,再除以组内标准差。对一组已经全部成功的轨迹来说,成功率的方差是零,它与效率项的协方差也是零,奖励的标准差于是只剩 λ_eff·σ_e;标准化之后效率权重在极限里被约掉,优势近似等于负的 (e_i−ē)/σ_e2。论文给了一个具体情形:λ_eff 取 0.1 时,全成功的组仍然拿到接近单位尺度的优势,与结果参半的组同量级,训练因此可能把轨迹压得过短2。
另一条现成的路是把每个奖励分量各自标准化,例如 GDPO 的做法6。报告指出这样会改变分量在原奖励里的权重,甚至改变轨迹排序,于是改用分母下限:在效率精修档,把归一化分母取为 σ_R 与 σ_anchor 中的较大者,σ_anchor = √(p_high(1−p_high))2。各分量在原始奖励里的相对权重因此保留下来,小的效率差别不再被放大。
结果在图 6。同一套训练配置下,完整 CARE 的平均准确率与 Vanilla RL 相当,在最终共同绘制的步上平均输出长度低 32.5%;拿掉优势校准的版本输出更短,准确率却在同一段区间里明显更低2。
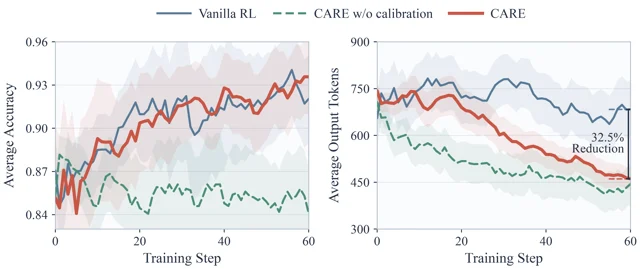
那套阈值与权重会随训练调整。每 N 次策略更新,一个有界的 LLM 控制器根据近期训练统计与留出开发集的成绩,重新给出 λ_prog、λ_eff、p_low、p_high 四个参数,并在接下来 N 步里保持固定2。报告只给出这几个符号及其取值范围,没有公布具体取值。
这一半可以搬走。任何用组内归一化、又想给执行成本加压力的智能体训练,都会撞上「已经全成功的组里成本权重被标准化吃掉」这一步,而分母下限是这处问题的一个现成解法,在别的智能体场景里也能直接用。
闭环改了多少,离自动化还有多远
报告把自己的开发流程写成三阶段闭环。Data 阶段用智能体造任务、收轨迹、按能力缺口重做采样,每次数据发布之前有人工复核;Training 阶段先做规划导向的冷启动,再在混合环境里跑在线强化学习,CARE 在这里生效;Harness 阶段管 Skill 与记忆的装配,并把执行证据回灌2。三类运行环境各有取舍:程序化沙箱可复现、吞吐高,但只覆盖已实现的工具;LLM 模拟能补长尾场景,回复却可能与先前的动作或状态矛盾,轨迹需要逐任务校验;真机反馈最接近现实,代价是成本高、并行差、重置难2。
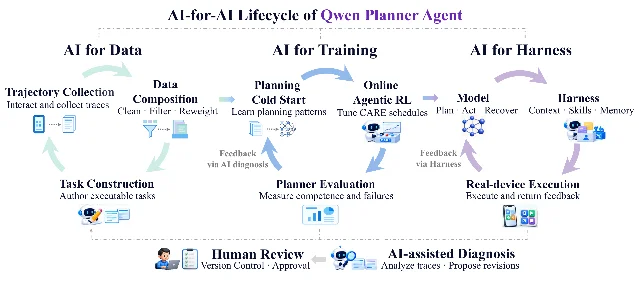
共演化是这套闭环里最接近自动的一环。它的目标函数同时包含策略参数与 Harness 的指令配置,实现上交替进行:先在一套固定指令下用强化学习更新策略,再用留出开发集的反馈让一个 LLM 编辑器修订指令,下一轮用新指令继续训练2。
表 2 给了两组读数。MobilePA-Internal 上,模型单独 82.67%、只加 Harness 84.23%、共演化四轮后 88.50%;MCPMark 上依次是 38.00%、42.26%、46.98%2。后一项值得单独看:从模型单独到共演化是 8.98 个百分点,其中只加 Harness 拿到 4.26 个百分点,剩下的来自指令的逐轮修订2。
作者自己给这个结论划了界。共演化实验用的是另一个 27B 起点检查点,反馈来自留出的演化开发集,报告写明它不构成独立的最终测试集,演化任务与其轨迹也不进入训练2。模型在服务期间参数固定,更新要经人工复核与版本管理;减少数据精修、训练调整与 Harness 更新中的人工介入,被列入后续工作2。报告把这一环称为「一条开发路径」,持续的自主共演化在它那里仍是待验证的目标2。
长历史:信息放在参数里还是参数外面
报告里复用价值最高的一组对照在记忆评测上。同一批检查点跑两遍:一遍把问题与全部交互历史直接塞进上下文,超出 1M 或 256K 的预算就从最早的历史开始截断;另一遍交给 Harness 里的持久记忆,由它处理完整历史、再取回与当前任务相关的证据2。
历史短的时候,两条路差不多。LoCoMo 上四对配对模型的均值从 93.90% 变到 94.12%,LongMemEval 从 91.65% 变到 92.24%,BEAM-100K 从 71.12% 变到 72.05%,报告说若干单对还出现了小幅倒退2。
历史一长,距离就出来了。同一批配对在 BEAM-500K 上是 42.18% 对 68.29%,BEAM-1M 是 40.41% 对 70.27%,BEAM-10M 是 23.42% 对 61.66%2。直接塞进上下文这一侧,单模型最好成绩在 BEAM-1M 是 54.84%(Claude Opus 5),到了 BEAM-10M 没有任何模型超过 25.64%2。
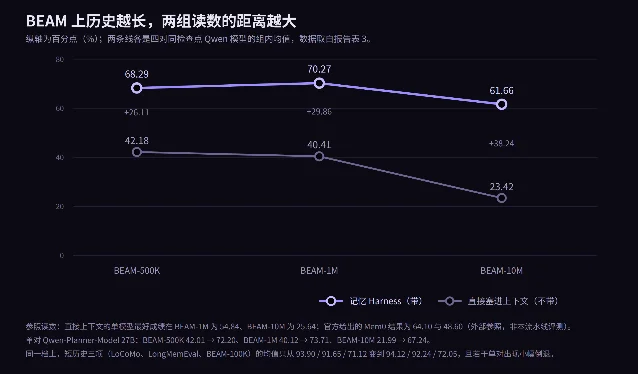
报告自己的表里还有一个反例。Qwen 基线 27B 加上 Harness,BEAM-1M 拿到 73.97%,略高于训练过的 Qwen-Planner-Agent 27B 的 73.71%2。在这一档上,把信息挪到参数外面比继续训练这套参数更管用。官方另列了 Mem0 的外部结果作参照,同一档是 64.10% 与 48.60%2。
记忆本身按用途分开存。一份精简的用户模型放稳定偏好与行为要求,情景记忆放观察与对话证据,长期记忆放已确认的事实与结论,前瞻记忆放带触发条件、范围、到期与完成状态的未来意图,另有一类只记录维护过程的复核记录2。每条记忆挂在来源元数据与原始证据上;被召回过的材料会被打标,避免重复检索抬高它的分量;新证据与旧条目冲突时,旧条目被显式标记为被取代2。
定性一节给了一条短例子,说明这套记忆在实际任务里怎么起作用。用户的行程里本来有深圳和广州,而已有一个监控在盯深圳,系统于是只新建广州那一条,保留原有监控,也不理会早已作废的北京价格阈值2。
代价与边界
通用能力上,训练有得有失。27B 在七项智能体基准里升了五项,Claw-Eval 从 82.48% 退到 79.58%,SWE-Multilingual 从 76.65% 退到 74.89%2。通用三项小幅回落:MMLU-Redux 从 88.73% 到 88.67%,C-Eval 从 89.74% 到 89.30%,IFEval 从 91.68% 到 91.13%,三项均值 90.05% 到 89.70%2。35B-A3B 那一档升了六项。报告据此判断,这条训练配方强化了非移动场景的智能体能力,同时大体保住了通用能力。
成本口径的缺口在输入侧更要紧。这套系统的运转依赖 Harness 对上下文与记忆的反复装配和检索,这些开销都落在输入侧,而 2.41 美元那一项只算输出 token2。
评测集的性质也要看。MobilePA-Internal 是团队内部构建的集合,共演化的反馈集是留出的开发集;记忆评测的植入、聚合与判分由他们自己的流水线完成,只有 Mem0 那一栏注明是外部结果2。隐私一节写的是应当如何——记忆分私有与共享、共享前要脱敏、要支持查看与删除——而报告同时说明,当前实现用的是服务级认证令牌,用户级访问控制依赖上游可信服务2。
形态上,这是一份 arXiv 预印本加一个官方站点,未经同行评审,仓库里也没有代码与权重14。完整报告收在仓库里的技术报告 PDF,公式、附录与实验设置的细节都在那里。要判断这些数字换个场景还成不成立,只能等外部复现。
可以带走的三件事
第一件是分母下限。它在报告里处理的是一个通用问题,写法很短:效率精修档把归一化分母取 max(σ_R, σ_anchor),σ_anchor = √(p_high(1−p_high))。它适合那些已经把成本惩罚加进组内相对训练、又发现模型把轨迹压得过短的团队2。
第二件是同检查点的配对评测。报告用同一批参数前后各测一次,把 Harness 的贡献与模型训练分开;同样的做法放到长历史任务上,就能看出外壳与训练各自值多少2。
第三件是长历史信息的位置。报告的证据指向外部受治理的记忆:这条路要到 BEAM-500K 以上才明显划算,短历史上收益在一个百分点上下,个别单对还会退步2。要把记忆做成产品,就得照着它的治理顺序走:先定来源与信任级别,再合并重复与矛盾,旧条目被新证据取代时留下记录2。
值得继续跟的信号是代码与权重什么时候放出来。在那之前,能自己先动手的是 CARE 的那两个式子、同检查点配对评测的做法,以及记忆 Harness 在长历史上那组跨度对照4。
References
- 1
- 2
- 3Qwen-Planner-Agent 官方站点
tongyi-mai.github.io
- 4Tongyi-MAI/Qwen-Planner-Agent 仓库
github.com
- 5
- 6
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.