华为开源盘古 2.0 预训练、SFT 与 RL 代码:Apache-2.0,能直接跑的配置只到 92B 档
华为把 openPangu-2.0 的预训练、SFT 与后训练 RL 代码整套放到昇腾开源社区,两个仓库都按 Apache-2.0 授权;但仓库里能直接跑起来的配置只到 92B 档,505B Pro 的预训练配方没有一并放出。

华为在 6 月开发者大会上说过要陆续开源的组件,9 月 28 日又放出了两块:openPangu-2.0 的预训练与 SFT 代码,以及后训练 RL 代码,两个仓库都按 Apache-2.0 授权。1权重部分此前已经分批放出:6 月 30 日的 openPangu-2.0-Flash(92B)与 7 月 31 日的 openPangu-2.0-Pro(505B)。23代码上库比公告更早:训练仓的初始提交写在北京时间 9 月 24 日 22:51,RL 仓的初始提交写在 9 月 27 日 16:50,9 月 28 日 10:22 提交上库。45
先说结论
- 这次放出的是两条训练链路。
openPangu-2.0-Training覆盖从零预训练、基于已有 checkpoint 的继续训练与 SFT;openPangu-2.0-RL是后训练用的强化学习框架,以开源项目 VERL 作为编排内核。67 - 代码与权重的许可分开。 两个代码仓都是 Apache-2.0;模型权重按 OPENPANGU MODEL LICENSE AGREEMENT VERSION 2.0 授权,要在商业产品里用权重,看的是后面这一份。78
- 能直接跑的配置只到 92B 档。 训练仓的 Model Zoo 只有两份配置,92B/6B 与一份 17.36B/1.75B 的样例;RL 仓的端到端示例目录是
pangu92b。67 - 门槛在硬件与软件栈。 训练仓写明配套 CANN 8.5.1、PyTorch 2.9.0、torch_npu 2.9.0、Python 3.11.x、triton-ascend 3.2.1,这套组合面向昇腾 NPU;RL 侧还要容器镜像、Ray 集群与 Ansible 部署脚本。67
- 只想用模型的话可以跳过这两个仓库。 权重在 Hugging Face、ModelScope 与 GitCode 都能下载,华为云 MaaS 的预置服务也可以直接调,模型名就是
openpangu-2.0-pro。91011 - 评测目前只有华为自测。 官方给出 Pro 的 Thinking 与 Non-Thinking 两档分数,对照对象只有 openPangu 自家变体;Artificial Analysis 的开源模型对比页与 OpenRouter 的模型目录至今没有盘古条目。81213
快速核对
| 项目 | 内容 | 来源 |
|---|---|---|
| 发布时间 | 2026 年 9 月 28 日宣布开源;训练仓初始提交为北京时间 9 月 24 日 22:51,RL 仓初始提交写在 9 月 27 日 16:50、9 月 28 日 10:22 上库 | IT 之家 、训练仓提交记录 、RL 仓提交记录 |
| 发布方 | 华为,开源品牌为开源盘古 openPangu | 训练仓 |
| 本次开源内容 | 预训练与 SFT 代码(openPangu-2.0-Training)、后训练 RL 代码(openPangu-2.0-RL) | 训练仓 、RL 仓 |
| 许可 | 代码仓 Apache-2.0;模型权重为 OPENPANGU MODEL LICENSE AGREEMENT VERSION 2.0 | RL 仓 、openPangu-2.0-Pro 模型卡 |
| 模型规格 | Pro 约 505B 总参数 / 约 18B 激活,Flash 92B / 6B,均为 MoE,512K 上下文,约 34T tokens 训练数据 | openPangu-2.0-Pro 模型卡 |
| 软件依赖 | CANN 8.5.1、PyTorch 2.9.0、torch_npu 2.9.0、Python 3.11.x、triton-ascend 3.2.1 | 训练仓 |
| 可跑规模 | 训练仓只提供 92B/6B 与 17.36B/1.75B 两档配置;RL 仓端到端示例为 pangu92b | 训练仓 、RL 仓 |
| 可用范围 | 权重在 Hugging Face、ModelScope、GitCode;推理走 openPangu-2.0-Infer(omni-infer);华为云 MaaS 预置服务 openpangu-2.0-pro 仅西南-贵阳一区域 | Hugging Face 、ModelScope 、华为云 MaaS |
| 价格 | 华为云 MaaS 按 token 计费,Pro 输入 ¥3.2、输出 ¥14.5(≥32K 时 ¥4.8 / ¥17.6),Flash 输入 ¥0.8、输出 ¥1.6,单位元/百万 tokens,两档都不支持忙闲时价 | 华为云 MaaS 计费 |
| 要不要动手 | 没有昇腾集群的组织,把这两个仓库当官方参考实现来读即可;要把模型接进产品,走权重或华为云 MaaS | 训练仓 |
这一批是怎么凑齐的
| 时间 | 放出的内容 | 来源 |
|---|---|---|
| 6 月 30 日 | openPangu-2.0-Flash(92B/6B)的权重、基础推理代码与训推算子 | 华为公告 |
| 7 月 31 日 | openPangu-2.0-Pro(505B/18B)的权重、基础推理代码与技术报告 | 华为公告 |
| 9 月 24 日 22:51 | openPangu-2.0-Training 初始提交,预训练与 SFT 代码 | 提交记录 |
| 9 月 27 日 16:50(9 月 28 日 10:22 上库) | openPangu-2.0-RL 初始提交,后训练 RL 代码 | 提交记录 |
| 9 月 28 日 | 华为宣布这批代码正式开源上线 | IT 之家 |
两个仓库分别给了什么
训练仓:预训练与 SFT 放在同一个入口下
openPangu-2.0-Training 自称是面向大规模基础模型训练的统一框架,覆盖语言模型、视觉语言模型与多模态模型三条线,把预训练与 SFT 收在同一个启动入口
launch.py 下。6预训练一侧支持从零训练、基于已有 checkpoint 的持续训练与长上下文训练;SFT 一侧支持指令数据、多轮对话数据与领域数据微调,以及参数高效微调与多任务训练。6框架层面对外列出的能力包括数据、张量、流水线、上下文与专家五个维度的并行,激活检查点与分布式 checkpoint,以及高可用训练里的容灾恢复、断点续训与弹性训练。6代码按
PanGu/ 包组织,其中 ops/ 目录放的是 NPU 自定义算子与融合算子,high_availability/ 目录放的是容灾与断点续训。6RL 仓:以 VERL 为内核,不给 VERL 开分支
openPangu-2.0-RL 以开源的 VERL 作为训练编排内核,在昇腾集群上做 Actor、Rollout、Reward 的协同训练,面向 openPangu 的 GSPO 与 GRPO 后训练。7官方给了两个典型场景:数学推理走单轮 rollout,模型一次生成完整思维链与答案,由规则奖励核对正确性与格式;面向推理的代码生成(Code-for-Reasoning)走多轮 rollout,模型在解题过程中调用 Python 解释器写代码并执行,再依据执行结果继续推理。7
接入方式是运行时补丁:设置
VERL_USE_EXTERNAL_MODULES=omni_rl.patches 注入,仓库不 Fork VERL 主线。7相对 VERL 的改动集中在两处,一处是多轮 Agent、工具、奖励与数据流,另一处是算法与昇腾侧的优化,包括 Prefill 与 Decode 分离、张量压缩与路由重放。7三个工程细节会直接影响能不能跑起来。训练数据支持 JSONL、JSON 与 Parquet,多机时所有节点的数据路径必须一致;镜像必须先带
--recurse-submodules 拉全子模块再构建,否则 third_party 里的依赖不完整;仓库自带的安全说明要求训练作业放在隔离网络里,理由是 Ray Dashboard 与对象存储这类集群内服务没有内建认证,而 Code-for-Reasoning 的 Python 解释器会执行模型生成的代码,默认放在独立子进程并带超时保护。7能跑到多大
训练仓的 Model Zoo 一共两份配置,这就是它给出的可跑范围。6
| 配置名 | 参数(总 / 激活) | 架构 | 上下文长度 |
|---|---|---|---|
moe_92B_A6B | 92B / 6B | MoE | 512K |
sample | 17.36B / 1.75B | MoE | 4K |
仓库描述里写着这套框架适配百亿至万亿参数规模的模型,
moe_92B_A6B 这一档对应的是 Flash 版的 92B/6B。15本次给到的可跑配置停在 92B 与 17.36B 两档,505B 那档的预训练配方没有随这次一起放出来。现在开源的这套模型长什么样
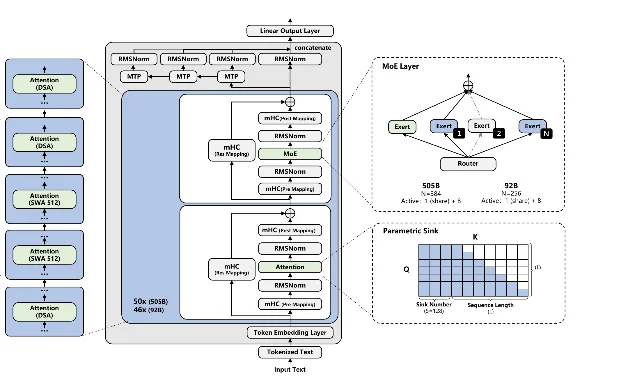
openPangu-2.0-Pro 是基于昇腾 NPU 训练的 MoE 语言模型,约 505B 总参数、每 token 激活约 18B,支持 512K 上下文,训练数据约 34T tokens。8架构上做了四处改动:注意力沿用 MLA,并改成 DSA 与 SWA 的分层混合结构、层配比 1:2,SWA 层负责局部窗口建模,DSA 层做稀疏全局聚合;残差连接换成 4 支流 mHC;解码侧挂 3 头 MTP,一次多预测 3 个 token;训练用 Muon 优化器。8
后训练分三步走:先做统一的 SFT,再按推理、通用、Agent、代码四个方向并行训练 RL 专家,各专家用隔离的数据与奖励避免互相干扰,最后用多专家在线蒸馏把能力合回一个模型。16报告提到训练侧用了 CloudMatrix 384 超节点,并把张量、上下文与专家并行约束在超节点内,以减少跨节点通信。16
推理侧的性能数字在报告第 6.6 节,测试条件是昇腾 A3 节点与真实数据。16
| 部署形态 | 模型 | 输入 + 输出长度 | TPOT | 每 NPU 吞吐 |
|---|---|---|---|---|
| 单节点超低延迟 | Flash | 128K + 1K | 5.63 ms | — |
| 单节点超低延迟 | Pro | 128K + 1K | 9.55 ms | — |
| PD 分离(Flash 1P1D、Pro 2P1D) | Flash | 128K + 8K | 13.0 ms | 1,846 tokens/s |
| PD 分离(Flash 1P1D、Pro 2P1D) | Pro | 128K + 8K | 18.1 ms | 1,326 tokens/s |
华为自己的评测
| 评测集 | 指标 | Pro Thinking | Pro Non-Thinking |
|---|---|---|---|
| IFEval | Prompt Strict | 94.5 | 90.4 |
| SimpleQA Verified | Acc | 34.9 | 27.1 |
| AIME 2026 | Avg@16 | 95.4 | 87.3 |
| GPQA-Diamond | Avg@4 | 87.9 | 81.1 |
| HLE | Acc | 27.1 | 9.0 |
| TAU2-Bench | Avg@3 | 81.1 | 71.6 |
| GDPVal | Acc | 74.9 | 51.2 |
| LiveCodeBench V6 | Avg@3 | 85.7 | 74.5 |
| SWE-bench Verified | Avg@3 | 68.5 | 66.8 |
读这张表有两处口径要留意。技术报告里的完整版(Table 5)把 Flash 与 Pro 的四个档位并排放在一起,加粗标出的是「openPangu-2.0 各变体里最好」的那一格,表里没有其他厂商的模型作为对照;GDPVal 一项注明是在 GDPVal-AA v2 脚手架下做的内部评测。16报告另外注明 SWE-bench Verified 用的是 OpenHands 脚手架。16
第三方这边目前是空的。Artificial Analysis 的开源模型对比页里没有盘古系列,OpenRouter 的模型目录里也搜不到盘古条目,所以这套模型没有可对照的独立智能指数或每任务成本。1213
只想用模型,不碰训练
华为云 MaaS 已经把
openpangu-2.0-pro 做成预置服务,开通后在西南-贵阳一区域用 OpenAI 兼容接口调用,端点是 https://api.modelarts-maas.com/v2/chat/completions。11自己部署的话,权重在 Hugging Face 的 openpangu 组织、ModelScope 与 GitCode 都有,官方给的推理框架是 omni-infer,部署说明写在 openPangu-2.0-Infer 仓库里。8910华为云 MaaS 按 token 计费,单位是元/百万 tokens。17
| 模型 | 上下文 | 缓存命中输入 | 输入 | 输出 |
|---|---|---|---|---|
| openPangu-2.0-Pro | <32K | ¥0.8 | ¥3.2 | ¥14.5 |
| openPangu-2.0-Pro | ≥32K | ¥1.2 | ¥4.8 | ¥17.6 |
| openPangu-2.0-Flash | — | ¥0.2 | ¥0.8 | ¥1.6 |
两档都不支持忙闲时计价,也就是说没有时段折扣。17
该不该试:三条能自己核对的判断
- 手上有昇腾集群、又要做后训练,这是目前唯一一份官方给的 openPangu GSPO/GRPO 参考实现。 仓库把怎么在昇腾上接 VERL、怎么组织多轮 rollout、规则奖励怎么接这几步写成了可跑脚本,端到端示例就在
pangu92b目录里。7 - 想复现 505B 的预训练,先确认手上有没有对应的配置。 这次给出的两档配置是 92B/6B 与 17.36B/1.75B,按 505B 那份配方走要自己补 YAML,这一版没有给出可直接运行的对应配置。6
- 只想把模型接进产品,这两个仓库与你的接入路径无关。 权重可以直接下载部署,华为云 MaaS 也能直接调用,训练代码在这里的价值是让你看清官方怎么做预训练与后训练对齐。911
还没有的数字
- 第三方独立评测。 Artificial Analysis 的开源模型对比页与 OpenRouter 的模型目录都没有盘古条目,所以本频道的「benchmark 表现」一栏目前只有华为自测的 Thinking 与 Non-Thinking 分数。1213
- 505B 档的可跑预训练配置。 训练仓的 Model Zoo 停在 92B/6B 与 17.36B/1.75B。6
- Flash 的完整分数对照。 模型卡只列了 Pro 的两档;Flash 的四档分数在技术报告的 Table 5 里,要下载 PDF 才能看到。816
- 仓库级的发布说明。 两个仓库各自只有一次初始提交,没有 tag 与变更日志,随代码放出的材料里也没有写复现训练需要的算力规模。45
References
- 1
- 2920 亿参数,华为 openPangu-2.0-Flash 模型正式开源上线
ithome.com
- 3
- 4openPangu-2.0-Training 提交记录
gitcode.com
- 5openPangu-2.0-RL 提交记录
gitcode.com
- 6openPangu-2.0-Training 仓库
ai.gitcode.com
- 7openPangu-2.0-RL 仓库
ai.gitcode.com
- 8openPangu-2.0-Pro 模型卡
ai.gitcode.com
- 9openpangu 组织页
huggingface.co
- 10openPangu-2.0-Pro(ModelScope)
modelscope.cn
- 11快速体验 openPangu-2.0-Pro 模型
support.huaweicloud.com
- 12Artificial Analysis 开源模型对比
artificialanalysis.ai
- 13OpenRouter 模型目录
openrouter.ai
- 14openPangu-2.0-Training(AtomGit 镜像)
atomgit.com
- 15openPangu-2.0-RL(AtomGit 镜像)
atomgit.com
- 16openPangu-2.0 技术报告
huggingface.co
- 17文本生成模型计费
support.huaweicloud.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.