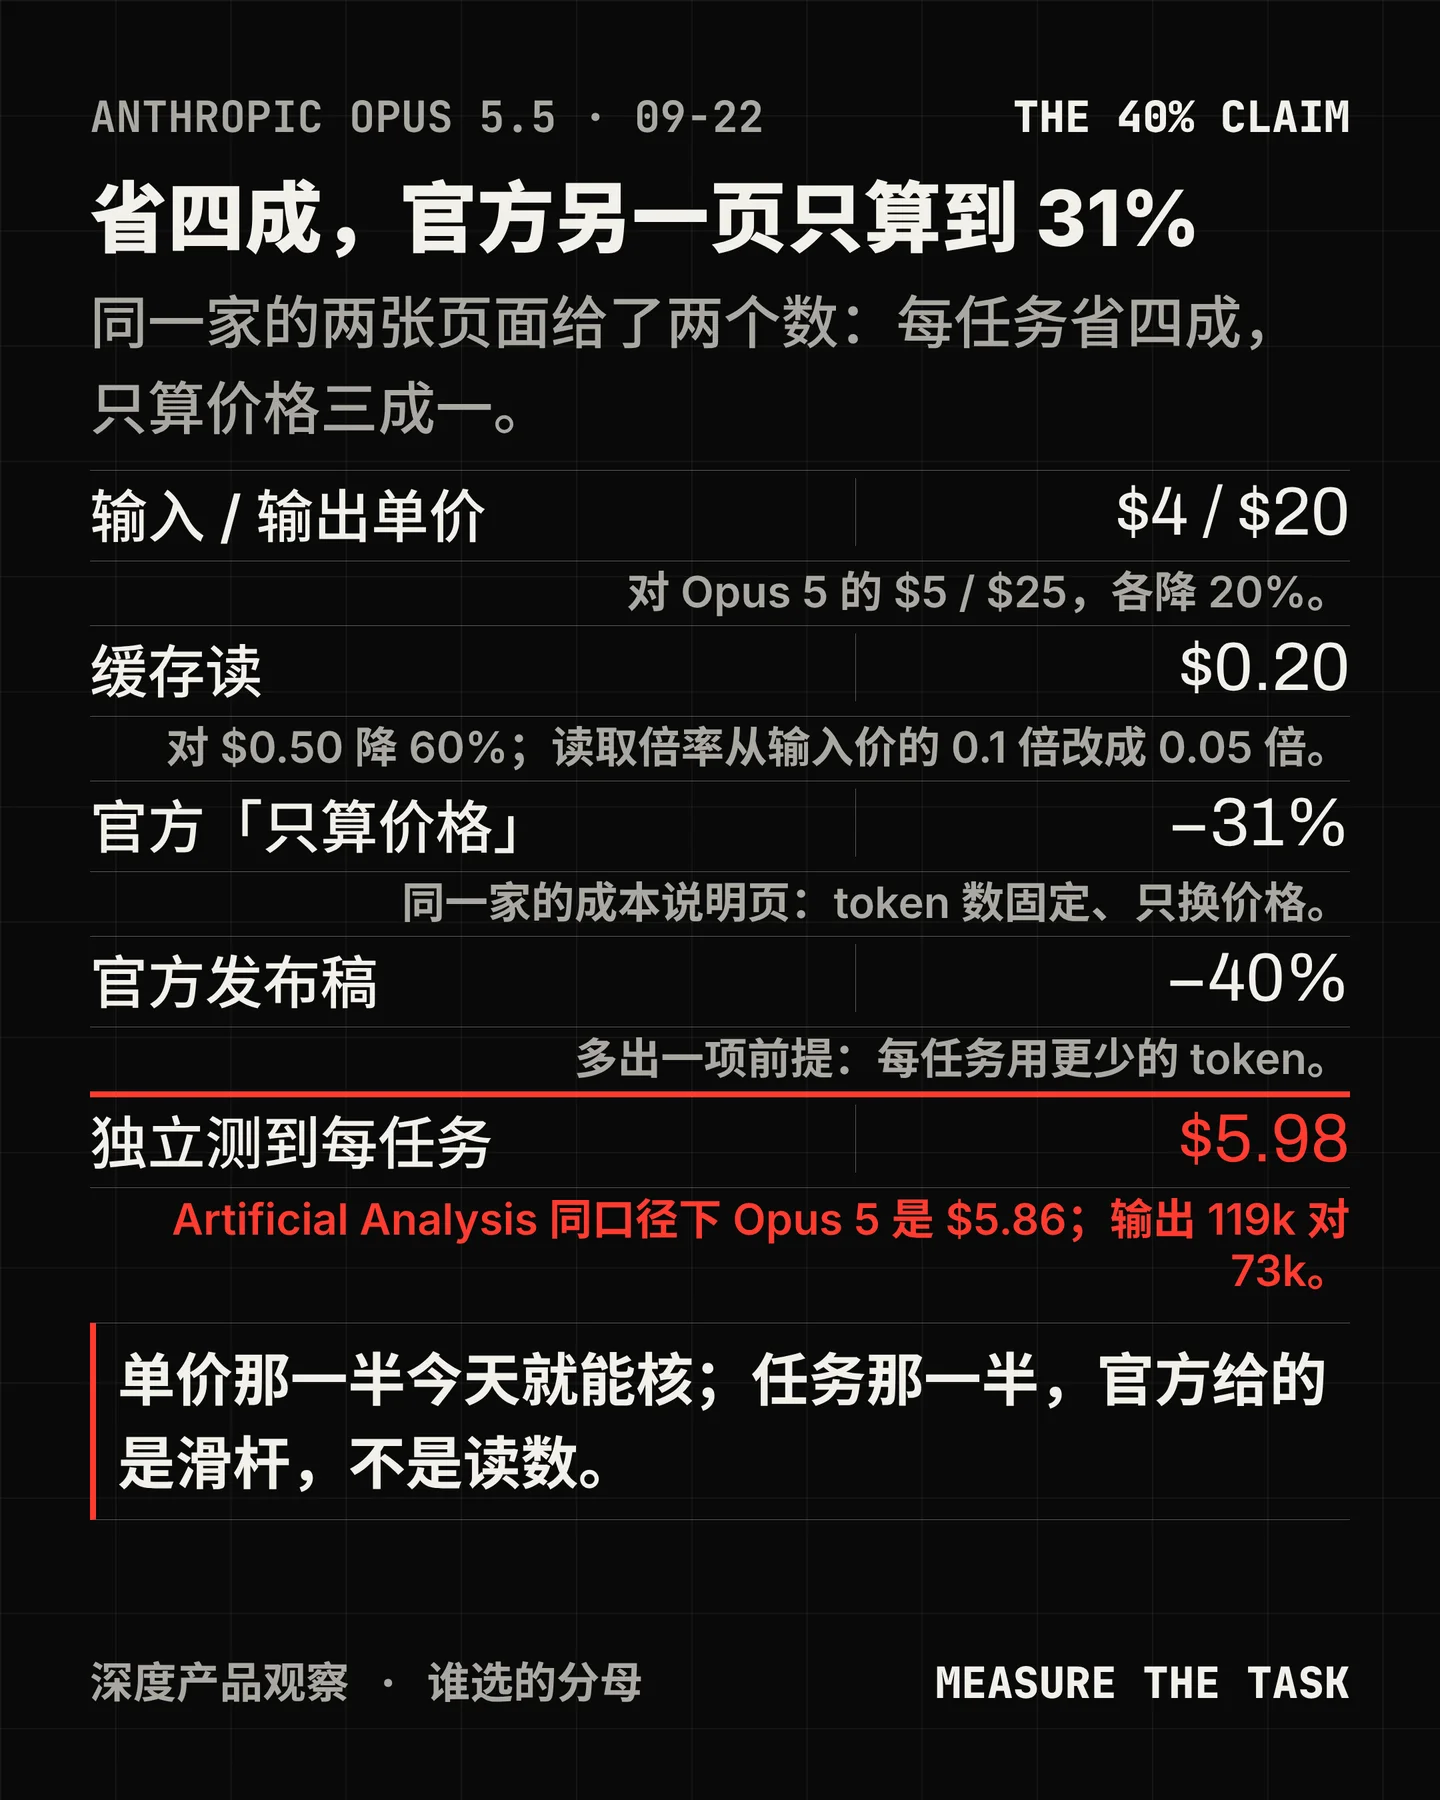

2026 年 9 月 22 日,Anthropic 发布了 Claude Opus 5.5,并把它标成「新的 Claude 5.5 家族的第一个模型」。发布稿在同一天给出两件事:能力上接近更大的 Fable 5.1,价格上比上一代 Opus 5 更便宜。价格这一半可以逐项对着价目表核——输入从每百万 token 5 美元降到 4 美元,输出从 25 降到 20,缓存读从 0.50 降到 0.20。能力那一半要读者自己判断,因为发布方在同一份材料里还写了别的话。12
40% 是一个加法,不是一个读数。发布稿的原句是「Our tests show that at default settings it will cost 40% less than Opus 5 on typical workloads」;它在另一处把机制说清楚了:「It costs less per token than Opus 5 and uses fewer tokens per task, which nets out to a 40% drop in costs.」也就是说,40% 由两个条件相加:每个 token 更便宜,加上每任务用更少的 token。这两个条件的证据强度不同。前一个能对着价目表逐项核,输入输出各降 20%、缓存读降 60%、缓存读的倍率从输入价的 0.1 倍改成 0.05 倍;后一个在发布稿里只有一句话。12
同一家网站在同一天还发了一篇讲成本的文章,那篇把第二个条件做成了一个滑杆。这篇《What a task costs on Opus 5.5》说得很坦白:「Two things changed: the price, and how much work the model does.」它先把两件事拆开——固定 token 数、只换价格时,「Priced that way, the session costs about 31% less」;然后告诉读者怎么把第二件事加回来:「The last slider is your assumption about how much less work Opus 5.5 does on your tasks. Leave it at 0% for the price change alone.」文章还提醒,Opus 5.5 因为总是先想再答,可能在一道题上花更多 token,「measure it on your own work」「No single number holds for every codebase」。同一家公司,一份材料给 40%,另一份在同一个语境里给 31%、并把剩下的 9 个点标成读者的假设。13
在一处把每任务成本算出来的独立测量里,这个假设的方向是反的。Artificial Analysis 把这套测试跑完,同一口径下算出 Opus 5.5 的每任务成本是 5.98 美元,而它测 Opus 5 得到 5.86 美元——没有下降。它同时报出输出 token 量:Opus 5.5 每任务约 119k,Opus 5 约 73k,前者是后者的 1.63 倍。the-decoder 把这件事写成一句更短的话:「Lower token prices keep its cost per task in line with Opus 5, but not cheaper.」这里要说清口径:每任务成本取决于跑的是哪套题、token 怎么混、用哪个思考档位;5.98 与 5.86 都是那一家在自家测试集上的计算结果,不是你的负载。但在所有能公开核到的数字里,它是唯一一个把「每任务」算出来的。456
为什么会反过来,系统卡自己给了一句提示。它在解释为什么一批旧评测不再有信息量时写道,模型之间的分数差异「are largely saturated, and minor differences in score are primarily derived from behavioral differences between the models (such as a tendency to be verbose) and how these interact with the grader rubrics, rather than from true differences in capability」。爱不爱多说,是会改变账单的:多出来的 token 全部按输出计价,输出序列里也包含思考。输出单价降了两成,任务上的用量涨了六成,两个方向相乘,省下的那部分就不一定留在账单上——而这正是官方成本文章里那根滑杆要读者自己填的一格。37
发布方那张评测表里,有两行它并不领先。发布稿列了九个基准,其中 Terminal-Bench-Science 0.1 上 Opus 5.5 是 58.7%、GPT-6 Astra 是 64.6%;AutomationBench 上 Opus 5.5 是 40.0%、Astra 是 41.4%。这两行各自带着一个必须一起读的注脚。AutomationBench 由 Zapier 跑并公布,Opus 5.5 的分数来自 Zapier 早于发布的自测,而 Zapier 那一侧没有回退模型,保障拦下的请求被直接判为失败;Terminal-Bench-Science 的 Astra 数字是 OpenAI 自己报的。发布稿在同一页还说:「at these levels of capability we've found that benchmark margins have become a less reliable guide to real-world differences」——基准差距越来越不能当作现实差异的可靠指引。这句话只在发布稿里;系统卡给的是另一个更硬的版本——那些自动化任务的结果「are no longer a significant component of our RSP and FCF capability threshold determinations. As such, we have not run these automated evaluations for Claude Opus 5.5」。178
发布前的外部测试是真的,但它没有变成一份可读的报告。发布稿写:「It was tested before release by external evaluators, including Frontier Design and METR.」两家都没有对外单独发文。METR 的工作以内嵌摘要的形式出现在系统卡里:10 个工作日的 API 访问、5 个任务,结论是「acceleration from this model would be slightly higher than for Fable 5.1, but that this model is unlikely to be able to fully automate AI R&D」。Frontier Design 的部分是一场桌面推演——7 个两人小组为沙眼衣原体设计噬菌体疗法,每组 16 小时——专家汇总后可行性高 23%、综合分高 11%,报告里没有任何模型之间的对比分数。系统卡同时写明,这次评测「The majority of evaluations of Claude Opus 5.5 were run in-house at Anthropic」。外部参与是事实,外部可读的结论不是。17910
还有一件和价格无关、但决定实测分数的事:被拦截的请求会被改路由。因为 Opus 5.5 在网络与生物上的能力接近更大的 Mythos 5.1,它带着一套分类器和回退机制:命中网络类内容的请求回退到 Opus 4.8,与生物以及前沿 LLM 开发相关的请求回退到 Opus 5,常规武器与防蒸馏两类没有回退。这套回退在自家应用里自动生效,在 API 上要开发者主动开启。它对使用者是可见的——界面会提示本次会话被保障标记、改由 Opus 4.8 回答——但比例只在第三方那里有过数字:Vals AI 把回退计为失败之后,Terminal-Bench 2.1 从 87.64% 降到 79.77%,SRE Bench 的 262 道题里有 217 道(82.8%)是回退完成的,分数从 33.59% 掉到 5.34%。The New Stack 把这件事写成给做 agent 的人看的一句话:一个发往 Opus 5.5 的请求,可能由 Opus 4.8 或 Opus 5 处理。发布稿没有给被拦下的比例。7111213
把几处独立读数并排放,结论取决于你问的是哪个问题。问「它是不是更强的模型」:Artificial Analysis 的智力指数给 Opus 5.5 58,高于 Fable 5.1 的 53 与 Opus 5 的 51,在那套口径下它是第一名;问「它在具体工作上是不是更好」:Vals AI 的全套跑测把它排在第 4,落后 Fable 5.1,也落后 Opus 5,弱项集中在法律与医学类任务;问「同样的活要花多少钱」:个人维护的 KillSwitch-Bench 上它得 58.9%,低于 Opus 5 的 66.8%,但每题成本从 1.49 美元降到 0.32 美元、耗时从 8 分 31 秒降到 1 分 51 秒;CodeRabbit 把它接进代码审查流水线后报告,抓到的缺陷集合与原来的生产基线不同,精确率略降,token 用量高出 49% 到 60%。三个问题三个答案,而且没有一个是错的。4141516
这一天本身也有一个值得记下的细节。Artificial Analysis 的模型页在 16:50 UTC 被首次存档,那时价目还没填进去,页面把模型描述成「well priced」;到 18:02 UTC 存档时价格已填成 4 美元与 20 美元,同一句话改成了「somewhat expensive」。指数版本没有换版,分数没有变,变的只有那个空着的价格格。它说明一件小事:一份评测页给出的「贵不贵」,取决于读数的那一刻它读到了什么。417
谁需要据此改手边的东西。按 token 单价做预算、又按任务量做验收的团队。你们的账单会按价目表下降,任务成本会不会下降取决于自己那批任务的形状;如果那批任务是长链路的 agent 调用,被分类器改路由的比例会决定自测分数与官方分数之间的距离。做合规或评审的人还要多一层:回退是可见的,但比例没有官方数字,而「实际由哪个模型作答」在一些行业里是必须能写清楚的事。714
落到动作,有五件事这周就能定。第一,按每任务成本选型,不要按 token 单价——官方自己的成本文章也是这么教的。第二,把被回退的请求记进评测,并且计为失败:SRE Bench 那道题的落差是 33.59% 与 5.34%。第三,缓存读单独算,倍率从 0.1 倍改到 0.05 倍,省多少取决于你们自己的缓存命中率,不取决于价目表。第四,引用能力宣称时要带基准名、思考档位与 harness:同一件工作上,官方给 66.4%、一家独立机构 61.62%、另一家 59.6%,三者的题集与跑法并不相同。第五,把榜单的状态也写进材料——多个榜在发布当天并没有收录这个型号,未收录不等于表现差,但它意味着你不能拿它们当验收依据。3414
References
- 1Introducing Claude Opus 5.5
anthropic.com
- 2Claude 定价页
docs.claude.com
- 3What a task costs on Opus 5.5
claude.com
- 4Claude Opus 5.5 — Artificial Analysis
artificialanalysis.ai
- 5Claude Opus 5 — Artificial Analysis
artificialanalysis.ai
- 6the-decoder
the-decoder.com
- 7Claude Opus 5.5 System Card
anthropic.com
- 8Zapier AutomationBench
zapier.com
- 9METR — Updates
metr.org
- 10Frontier Design — Responsible AI
imaginefrontier.com
- 11Claude Opus 5.5 — Vals AI
vals.ai
- 12The New Stack
thenewstack.io
- 13The Verge
theverge.com
- 14Claude Opus 5.5 — Vals AI
vals.ai
- 15KillSwitch-Bench
bench.killswitch-lang.org
- 16CodeRabbit 评测
coderabbit.ai
- 17OpenRouter — Claude Opus 5.5
openrouter.ai
Comments